
学習したモデルが何を見て予測しているのかを説明したいとき、特徴量ごとの重要度を図にして、上位の列を報告することがあります。図に順番が出ると、それが「本当に効いている順」に見えてきます。
ところが、その順番が合っているかどうかを手元で確かめる方法はありません。実データには「正解の重要度」が付いていないからです。効いていないはずの列が上位に来ても、モデルが関係を学びきれていないのか、重要度を計算する側がずれているのかを切り分けられません。
この記事で扱うのはSHAPです。予測値を特徴量ごとの取り分に分けて、どの列がどれだけ予測を押し上げ、あるいは押し下げたかを示す手法で、beeswarm図やbar図の並び順はこの取り分の平均から作られます。ここで分けているのはモデルの予測への寄与であって、現実の目的変数を生み出した要因や因果関係ではありません。
そこで、真の重要度を式で計算できる合成データを自分で作り、SHAPの出力を1件ずつ答え合わせしました。測ったのは全体のずれだけではありません。モデルが真の構造を再現できていない分と、説明の計算がモデル自身の寄与を再現できていない分を、別々に測っています。この2つを分けない採点では、SHAPを評価したつもりで、主にモデルの当てはまりを評価していることになりかねません。
結論を先に: 順番はよく当たり、ゼロの列にも配分が残る
- 真の重要度に差がある条件なら、SHAPの並び順は当たる。木モデル4種とも、効いている6列の順序がデータを作り直した10回すべてで正解と一致。
- ただし、効果がまったくない列にも重要度が付く。XGBoostで全体の4.1%。
- 学習データを250件から8,000件へ増やして縮んだのは、モデル側のずれだけ。正解までの距離が0.314から0.103へ(0が完全一致)。
- 説明の計算に由来するずれのほうには、件数を増やしても明確な変化を確認できず。
- 列どうしが強く相関すると順番が崩れる。相関0.99では、効果ゼロの列が効いている2列を追い越した例が10回中3回。
- 比較の基準に使う背景データは、生の配列を渡すと件数を指定しても100件に切り詰められる。書き方1行の違い。
- 適用条件: 10列の合成データ(回帰)に対するXGBoost・LightGBM・CatBoost・ランダムフォレスト・Ridge、shap 0.51.0。深層モデル・画像・テキストは未検証。
この記事の前提知識と、出てくる言葉
この記事は「重要度が当たっているか」を数字で採点します。読むのに要るのは、予測モデルを一度学習した経験だけです。SHAPを触ったことがなくても、数式が読めなくても進めます。採点に使う言葉だけ、先に決めておきます。
- SHAP / Shapley値: 予測値と基準値の差を、各特徴量の取り分として分ける考え方です。SHAPはこれを機械学習モデルに当てはめ、1件の予測ごとに列ごとの取り分を出します。
- 大域の重要度と局所の説明: 多数の予測をまとめた特徴量の並びが大域の重要度(beeswarmやbarの図)、ある1件の予測の内訳が局所の説明(waterfallの図)です。全体では上位でも、個々の予測では寄与が小さいことがあるため、別々に採点します。
- 説明器(TreeExplainer / KernelExplainer): SHAP値を計算する部品です。前者は木モデル専用の速い計算、後者はどんなモデルにも使える汎用の計算です。
- 背景データ: 予測の基準を作り、「その特徴量が分からない状態」を計算するための比較用データです。選び方や件数が変わると、SHAP値も変わり得ます。
- 介入と条件付き: 「その列が分からない」状態の作り方が2通りあり、それぞれ別の正解を与えます。この記事は介入(他の列を気にせず全体の分布から引く)を主の正解に採りました。理由ともう一方の答えは後半で扱います。
- 順位相関: 2つの並び順がどれだけ一致するかを−1から1で表す指標です。1なら同じ順序、0付近なら順序の対応が弱く、−1なら逆順です。
- 決定係数(R²): 予測が正解の変動をどれだけ再現したかを見る指標です。ここではノイズを除いた真の関数と比べ、1に近いほど再現できています。
真の答えが分かるデータを自作して、SHAPを採点した
自作した合成データには特徴量が10列あります。x0からx5までの6列だけが目的変数へ影響し、残るx6からx9の4列は真の効果が厳密にゼロです。効き方も揃えていません。値に比例して効く列のほか、大きくなると効果が頭打ちになる列、別の列との組み合わせで初めて効く列を混ぜました。
この生成規則なら、各事例・各特徴量の真のSHAP値を式で求められます。つまり、SHAPが出した数字を1件ずつ答え合わせできます。実データではできない採点です。
基本の条件では4,000件で学習し、学習に使っていないテストデータの先頭100件を説明しました。モデルはXGBoost・LightGBM・CatBoost・ランダムフォレストの木モデル4種と、直線的な関係を学ぶRidge回帰です。ここへ、学習データの量、特徴量どうしの相関、背景データの件数、説明器の種類という4つの条件を重ねています。
同じ条件は、データの乱数の種(シード)を変えて10回ずつ回し、その平均を載せました。一部の条件だけ5回です。
ずれを3つの距離に分けて測る
採点しただけでは、ずれの出どころが分かりません。そこで次の3つの量を並べて測りました。
- 全体のずれ: 実際に手に入る説明と、真のSHAP値との距離。
- モデル側の距離: そのモデル自身の厳密なSHAP値と、真のSHAP値との距離。モデルが真の構造をどれだけ再現できていないかを表します。
- 説明器側の距離: 実際に手に入る説明と、そのモデル自身の厳密なSHAP値との距離。説明の計算と設定だけで生じる差です。
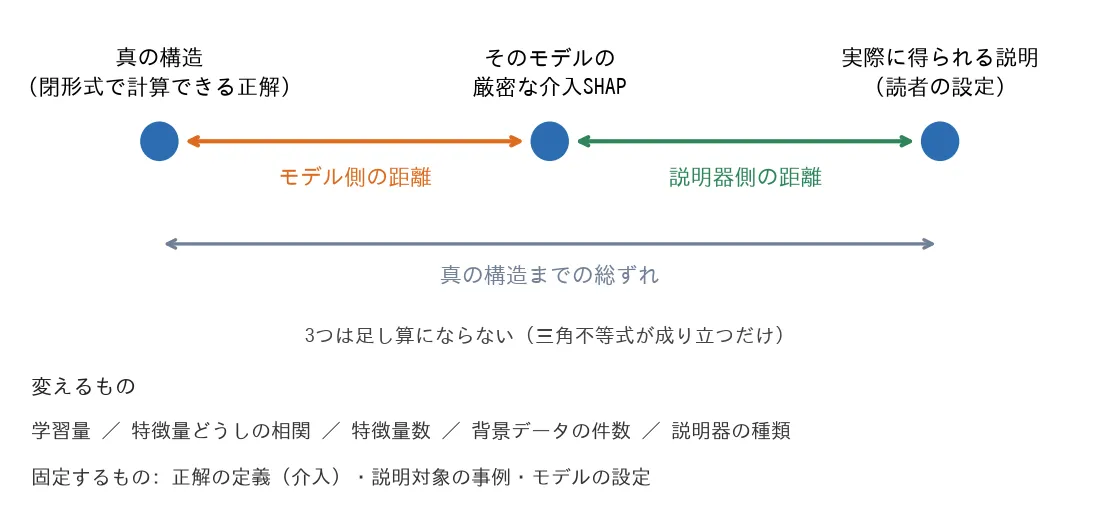
分けて測るのは、直し方が違うからです。モデル側が大きいならデータやモデルを見直す話になり、説明器側が大きいなら説明の設定を見直す話になります。この2つを混ぜたまま「SHAPが当たっていない」と言っても、次に何をすればよいかが決まりません。
重要度に開きがあれば、木モデルは効いている6列の順番を当てた
まずは当たっていた側の話です。真の重要度に十分な開きがある条件では、SHAPが並べた順番はそのまま正解でした。木モデル4種とも、効いている6列の順序がシード10本すべてで真の順序と一致しています。
実務に引き直すと言えるのは、この合成データで重要度に開きがある条件なら、beeswarm図の上位の大まかな順序は正解に近い、というところまでです。僅差の特徴量や別のデータにも同じ精度を期待できる、という結果ではありません。上位から何番目までが実在の要因かも保証されません。
| モデル | 当てはまり(R²) | 全体のずれ | モデル側 | 説明器側 | 大域の順位相関 | 効果ゼロ列への配分 |
|---|---|---|---|---|---|---|
| XGBoost | 0.976 | 0.166 | 0.124 | 0.108 | 1.00 | 0.041 |
| LightGBM | 0.976 | 0.167 | 0.125 | 0.109 | 1.00 | 0.042 |
| CatBoost | 0.990 | 0.141 | 0.087 | 0.110 | 1.00 | 0.023 |
| ランダムフォレスト | 0.951 | 0.215 | 0.185 | 0.106 | 1.00 | 0.013 |
| Ridge(線形) | 0.856 | 0.392 | 0.377 | 0.103 | 0.73 | 0.016 |
| 参考: 全列に同じ値を返す説明 | ─ | ─ | ─ | ─ | 0.00 | 0.40 |
| 参考: 行内で並べ替えた説明 | ─ | ─ | ─ | ─ | −0.54〜0.54 | 0.37〜0.44 |
比較に使ったのは、背景データ100件を渡して介入の流儀で計算する説明器です。表の下2行は床の目安として置きました。全列に同じ値を返す説明と、正解を行内で並べ替えた説明を同じ指標で採点したもので、中身のない説明でもこれくらいの値は出てしまいます。上の行がこの床から十分離れていなければ、当たったとは言えません。
上位6件が効いている列で占められた割合も測っていて、木モデル4種のうち3種は全シードで1.00でした。ランダムフォレストだけ10本中1本で効果ゼロの列が上位6件に入り、平均0.98です。順序そのものが合っていても、6番目の座を効果ゼロの列に取られることがあります。
1件ごとの説明でも大きくは崩れません。個別事例の順位相関は0.86から0.92、寄与の向き(プラスかマイナスか)の一致率は0.95から0.98でした。全体の並びだけでなく、個々の予測の内訳もおおむね正解の側を向いています。
気になるのは効果ゼロの列です。真の重要度が厳密に0の4列に、XGBoostでは全体の4.1%が配分されました。0にはなりません。もっとも、意味のない説明が返す水準は0.40なので、およそ10分の1です。SHAPが「この列は無関係」と言い切ってくれるわけではない、という読み方になります。
個別の予測でも、効果ゼロの列が上位3件に紛れ込んだ事例が100件中1.4件(XGBoost)ありました。別の合成データで測ったTreeSHAPの2モード比較でも同様で、結果と無関係な3列にLightGBMのSHAPが合計8.7〜9.3%を配っています。
線形のRidgeだけ様子が違います。真の関数には交互作用(2つの列の組み合わせで効く項)が入っていて、線形モデルではそれを表現できません。そのため当てはまりがR² 0.856で頭打ちになり、大域の順位相関も0.73まで落ちました。並び順の上限を決めているのは、説明の計算ではなくモデルの表現力です。モデルが真の関係を再現できていなければ、SHAPの順番もそこまでしか当たりません。
上の表は、真の重要度に十分な開きがある条件のものです。互いに僅差になる難しい条件でも測っていて、そこではXGBoostの大域の順位相関が10本のシードで0.83から1.00に散りました。常に1.00とはいきません。ただしこの2条件は、重要度の間隔と一緒に、交互作用が予測に占める割合も動いています。「間隔を狭めた効果」としては読めません。
同じ僅差の条件で、他の重要度も並べてみました。モデル内蔵の重要度(XGBoostのtotal_gain)は −0.43 から 0.20 に散ります。Permutation Importance(列の値を混ぜて予測性能の落ち方を見る手法)は −0.54 から 0.26 でした。どちらも負に振れていて、真の並びと逆向きになったシードがあります。同じ向きを保ったのは平均絶対SHAP値だけです。
ただし内蔵の重要度は分割の利得、Permutation Importanceは損失の増加を測っていて、平均絶対SHAP値とは推定している量そのものが違います。順位が一致しなかったことを「誤り」とは読めません。Permutation Importance そのものが相関でどう動くかは、Permutation Importanceは相関する特徴量でどう変わる?で別に測っています。
学習データを増やして縮んだのは、モデル側のずれだけだった
学習量を増やせば説明全体が一緒に正解へ近づく。そう見込んでいましたが、外れました。学習データの件数だけを変えて3つの距離を追うと、縮むのはモデル側だけで、説明器側はほとんど動きません。
表はXGBoostの結果で、LightGBMでも同じ傾向が出ています。
| 訓練件数 | 当てはまり(R²) | 全体のずれ | モデル側 | 説明器側 |
|---|---|---|---|---|
| 250 | 0.873 | 0.322 | 0.314 | 0.065 |
| 500 | 0.915 | 0.273 | 0.251 | 0.108 |
| 1,000 | 0.946 | 0.217 | 0.189 | 0.107 |
| 2,000 | 0.965 | 0.189 | 0.152 | 0.105 |
| 4,000 | 0.976 | 0.166 | 0.124 | 0.108 |
| 8,000 | 0.984 | 0.131 | 0.103 | 0.075 |
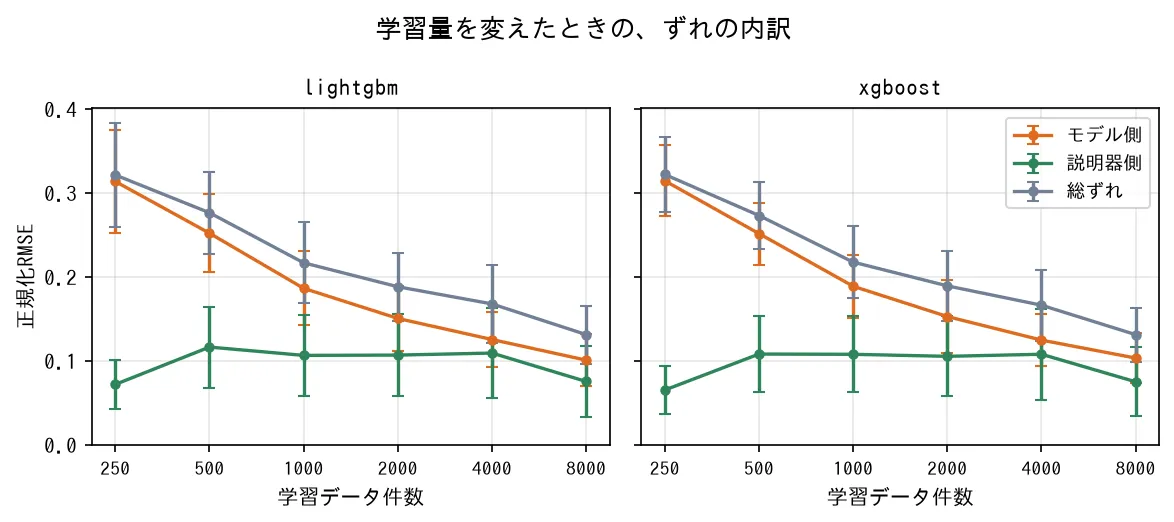
モデル由来のずれを表すモデル側の距離は0.314から0.103へ縮み、8,000件との差を確認できました。一方、説明の計算と設定に由来する説明器側の距離は0.065から0.108の間を動くだけで、8,000件との明確な差を確認できていません。R²が0.98に達したモデルでも、説明器側は0.075残りました。この距離が小さくなったのは、後の節で扱う背景データの件数を増やした条件のほうです。
縮むのが片方だけなので、2つの差は件数が増えるほど詰まります。ただし点推定そのものは、どの件数でもモデル側が上のままで、順序が入れ替わったわけではありません。どこから大小を区別できなくなるかは、後半の「採点の細かい決め方」に置きました。
データを増やしてもほとんど縮まないモデル側の距離もあります。Ridgeでは250件の0.395に対し、8,000件でも0.376でした。真の関数に含めた交互作用を線形モデルでは表現できないため、学習量だけでは埋まりません。当てはまりが頭打ちなら、SHAPの設定より先にモデルが関係を表現できるかを見直すことになります。裏を返せば、データ量を増やす対策と説明の設定を直す対策は別物で、片方を直してももう片方は残ります。
相関0.99では、効果ゼロの列が効いている列を追い越した
次は、効果ゼロのx6と最強の駆動要因x0を相関させ、その強さを変えました。ここも事前の予想が外れた側です。
数値は同じくXGBoostです。
| x0とx6の相関 | 効果ゼロ4列への配分 | 全体のずれ | 相関なしとの比較 |
|---|---|---|---|
| 0.0 | 0.041 | 0.166 | (基準) |
| 0.5 | 0.042 | 0.166 | 明確な差を確認できなかった |
| 0.9 | 0.043 | 0.166 | 明確な差を確認できなかった |
| 0.99 | 0.071 | 0.194 | 差を確認できた |
事前の予想と異なり、相関0.5と0.9では効果ゼロ列への配分が相関なしとほぼ並び、明確な差を確認できませんでした。動くのは表の最下行だけです。0.99になって初めて配分が増え、全体のずれも広がりました。LightGBMでも同じ動きです。測った水準は離れているため、「0.99が境界」とは判断できず、0.9と0.99の間でいつ変化するかは未検証です。
広がったずれの出どころも分かれています。モデル側は0.124から0.169へ広がり(差を確認できました)、説明器側は0.108から0.101で広がっていません。このモデル側の広がりは、「学習が足りない」という話とは別物です。x0とx6がほぼ同じ値しか取らなくなると、その2つが食い違う組み合わせのデータが存在しなくなります。介入の正解はそこでもモデルを評価するので、モデルが到達しない領域で真の関数を同定できていない分が入ってきます。
順位の入れ替わりは、はっきり見えました。あるシードのXGBoostでは、相関0.99で効果ゼロのx6の平均絶対SHAP値が0.258です。同じ条件で有効なx4は0.220、x5は0.133でした。真の効果がゼロの列が、有効な2列を追い越して上位に並んだことになります。相関なしの同じシードではx6は0.065です。2列とも追い越したのは10シード中3本、x5だけを上回った場合まで含めると9本でした。
beeswarmの上から順に読んでいたら、この列を「効いている」と報告してしまいます。個別説明でも同じことが起きていて、効果ゼロの列が上位3件に入った事例は、相関なしの1.4%に対して相関0.99では8%でした。
ただし、これを「SHAPの誤り」と書くのは正確ではありません。条件付きの流儀を正解に採れば、x6の真の重要度はゼロではなくなります。x6はx0とほぼ同じ値を持っていて、x0の情報を実際に運んでいるからです。起きているのは「正解の定義が2つあり、相関が強いとその2つが大きく離れる」ことであって、どちらかが間違っているのではありません。実務で必要なのは、上位に来た列と強く相関する別の列がないかを確かめる手順のほうです。
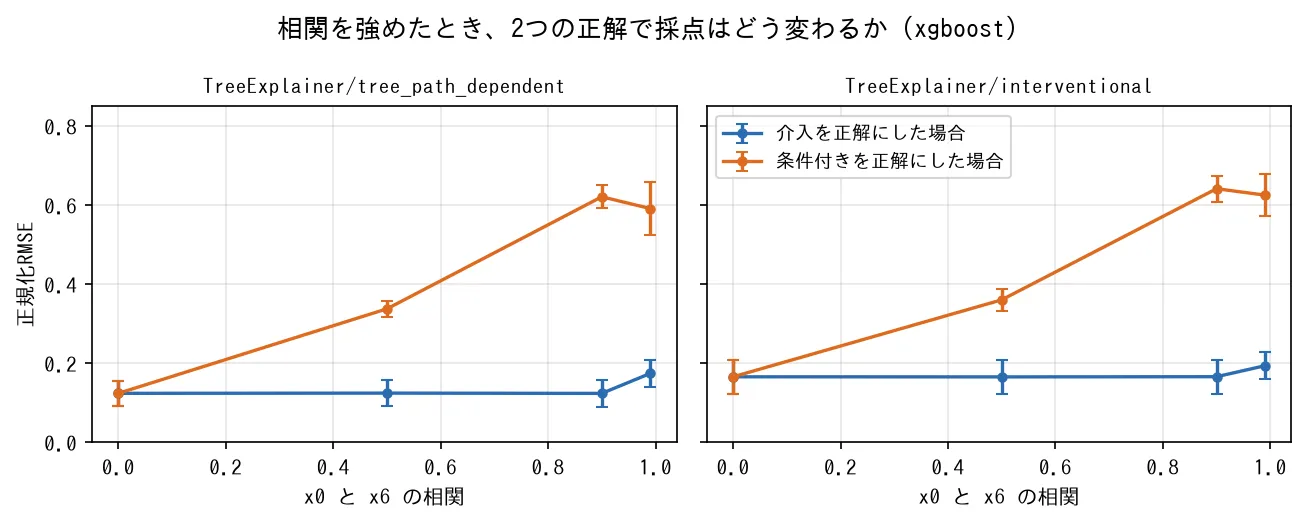
同じ説明でも、どちらを正解に採るかで採点は変わります。介入を正解にすると、0.99でわずかに広がるほかはほぼ横ばいです。条件付きを正解にすると、相関0.9までで大きく離れます。
背景データは、指定した件数のまま使われるとは限らない
説明器側の距離は、背景データの件数で動きます。そしてここには、コードの書き方1行で踏む落とし穴があります。
先に実務向けの答えを書きます。背景データは shap.maskers.Independent(X, max_samples=N) で件数を明示し、explainer.data.shape[0] で実際の件数を表示させておくのが安全です。生の配列を渡した場合、指定した件数はそのまま使われません。
| 背景データの件数 | 説明器側の距離(XGBoost) | 説明器側の距離(LightGBM) |
|---|---|---|
| 50 | 0.093 | 0.094 |
| 100 | 0.076 | 0.078 |
| 250 | 0.051 | 0.051 |
| 500 | 0.054 | 0.055 |
| 1,000 | 0.034 | 0.035 |
| 2,000 | 0.035 | 0.035 |
| 4,000 | 0.027 | 0.027 |
大づかみに言えば、背景を増やすほど説明器側の距離は縮みます。250件と500件、1,000件と2,000件はほぼ並んでいるので、細かな凹凸は読まないでください。ここはシード5本の条件なので、差の判定は行っていません。
落とし穴はここからです。TreeExplainer(model, data=X) のように生の配列を渡すと、shapは背景を既定で100件にサブサンプルします。実際に使われた件数を毎回記録したところ、250件・500件・1,000件・2,000件・4,000件のどれを渡しても実効件数は100でした(5本のシードと2モデルのすべてで一致)。4,000件を渡したつもりで実効100件なら、説明器側の距離は100件相当の水準にとどまったままです。この間引きはTreeSHAPの2モード比較でも同じで、そちらでは200件渡した背景データが実効100件になっていました。
既定に足をすくわれる場所はもう1つあります。KernelExplainerの l1_reg の既定は、寄与の小さい列を選別して落とします。特徴量20列の条件でこれを外すと、真のSHAP値と符号が一致した割合が上がりました。XGBoostでは0.861から0.926へ、Ridgeでは0.678から0.795へ。厳密な介入SHAPでの値はそれぞれ0.936と0.805です。20列の条件では、既定のままの出力が厳密な値から離れました(10列の条件では差が出ていません。シード5本の参考値で、列数の効果と既定の効果は分けられていません)。列数の多いデータでKernelExplainerを使うなら、l1_reg=False でも一度計算し、結論が変わらないか見比べておくのが安全です。
背景データを渡さないと、そもそも別のものを計算しに行きます。TreeExplainer(model) とだけ書いたときの既定は tree_path_dependent です。介入の基準からの距離は0.028(XGBoost、相関なし)でした。この0.028が表すのは誤りの大きさではなく、向かっている先が違うぶんが混じった距離です。基準そのもののゆらぎと同じ桁でもあるので、これより細かい差は読めません(ゆらぎの実測値は後半の折りたたみに置きました)。介入の値が欲しいなら背景データを明示し、既定のまま出した図に「介入SHAP」というラベルを付けないことです。
実データでは、純粋な乱数列より下位に並ぶ特徴量があった
ここまでは合成データの話です。手元の実データには正解がないので、同じ採点はできません。代わりにできるのは、真の効果がゼロだと設計上わかっている列を混ぜて、その列がどこに並ぶかを見ることです。
PMLBのadultとmagicに、そうした列を2本注入しました。1本は目的変数と無関係な標準正規の乱数列、もう1本は元の列と相関0.9のコピー列です。コピー列は元列とノイズだけから作っているので、元列で条件づければ目的変数への追加情報を持ちません。
| データ | 注入後の列数 | 乱数列の配分 | 乱数列の順位 | コピー列の配分 | コピー列の順位 | コピー元列の配分 |
|---|---|---|---|---|---|---|
| adult | 16 | 0.042 | 9〜11位 | 0.057 | 6〜10位 | 0.145 |
| magic | 12 | 0.021 | 11〜12位 | 0.031 | 7〜11位 | 0.233 |
XGBoostに介入の説明器を当て、シード5本で測った値です(判定は行いません)。magicでは乱数列がほぼ最下位に落ち着きました。一方のadultでは、目的変数と何の関係もない乱数列が16列中9位から11位に入り、5列から7列がそれより下に並びました。その下にある列を「モデルが見ている特徴量」として報告するのは、少なくとも心もとない話です。
コピー列はもっと目立ちます。adultのコピー元はage、注入前の重要度1位だった列です。そこから作ったコピー列が6位から10位に入りました。元の列を見ていれば何も足していない列が、その位置に並びます。実データで「これも効いている」と読んだ列の中に、この種の重複が混ざっている余地は残ります。
なお、ここの数値は前の節までの合成データの数値と直接は比べられません(回帰と二値分類の違いで、正規化の分母も別です。詳しくは記事末の適用範囲と限界にまとめました)。
計算が止まった原因は、木の閾値をfloat32に丸める実装だった
この実データの回は、一度失敗しています。shapが Additivity check failed in TreeExplainer! という例外を投げ、magicのすべてのシードが取れずに止まりました。SHAP値の合計は予測値と一致するはずなので、shapは計算のたびにそこを検査しています。その検査を通りませんでした。
対処だけ先に書いておきます。この例外が出ても、データやモデルが壊れているとは限りません。check_additivity=False で黙らせる前に、何件がどれだけ外れているのかを自分で測るのが先です。
順に切り分けました。まず、外れているのは説明対象100件のうち1件だけで、モデルの出力そのものと、shap内部が持っている予測は完全に一致していました。ずれているのはSHAP値の合計の側です。次に木を1本ずつ足していくと、300本のうち3本でずれが跳ねました。3本とも、その事例がたどった道筋に「ある列を閾値 2.0700000000000007 で分ける」分岐があり、その列の値はちょうど2.07でした。
最後に、値を境界の周りで少しずつ動かしてみました。予測はfloat64の閾値 2.0700000000000007 で枝が切り替わるのに対し、SHAP値の合計はそれをfloat32に丸めた 2.069999933242798 で切り替わります。2つの閾値の隙間(2.07ちょうどを含みます)に値が入ると、予測とSHAP値が木の別の行き先を指すことになります。shap 0.51.0 の介入版TreeSHAPは、分岐をたどるときに閾値を単精度へ落とした値を使い、予測側は倍精度のまま比較しているためです。単精度は32ビット、倍精度は64ビットの小数表現で、単精度のほうが表せる桁が少なくなります。分岐が1つだけの最小のモデルでも同じ現象を再現でき、丸めが下がる場合と上がる場合でずれる向きが逆になることも確かめました。
実際に起きた頻度は、60条件のうち6条件、説明100件あたり0件から2件です。magicは小数2桁の観測値を持っていて、LightGBMの閾値が隣接値の中点としてこの隙間に入りました。adultは整数の特徴量が多く、閾値が .5 の位置に来るので当たりません。データやモデルの性質というより、値と閾値の距離が単精度の分解能を下回るかどうかで決まります。
対処として、shapの既定の検査を止め、学習器そのものの出力と突き合わせる自前の監査に置き換えました。判定の許容範囲はshapと同じままで、超えた件数と大きさを毎回記録しています。黙って check_additivity=False にしなかったのは、何がどれだけ外れたか残らなくなるからです。
そのうえで、外れた事例を除いた場合の集計も出しました。順位は全ケースで不変で、外れた事例を含めても除いても、ここまでの結論は動きません(除いたときの数値は後半の折りたたみにあります)。
SHAPの重要度を報告する前に確認する5つのこと
-
まず予測性能。ここが不十分なら順位の話に進まない テストデータで予測性能を確認します。この記事では250件から4,000件へ増やすと正解までのずれが0.322から0.166へ縮みましたが、真の関数に対するR²は実データでは計算できません。予測性能が不十分なモデルの上位特徴量を、現実の「本当の要因」として扱わないことが最初の歯止めになります。
-
学習量を段階的に増やし、上位が入れ替わるかを見る 利用できる学習データを増やしながら、SHAP上位の入れ替わりを追います。順位が大きく動くなら、説明の設定だけでなく、モデルがまだ安定した関係を学べていない可能性があります。当てはまりが頭打ちなら、データを増やすより、モデルが必要な非線形性や交互作用を表現できるかを見直すほうが先です。
-
上位の列と強く相関する別の列を探す 見つかったら、どちらを残しても予測や順位が保たれるかを確かめます。相関0.99では効果ゼロ列が有効な2列を追い越しましたが、0.9との間の境界は測っていません。特定の相関係数を安全基準にせず、重複した情報へ寄与が分かれる可能性を検討します。
-
背景データの実効件数を必ず表示させる
shap.maskers.Independent(X, max_samples=N)で件数を明示し、explainer.data.shape[0]で実際の件数を確認します。生の配列を渡した実験では、250件以上を指定しても100件に切り詰められました。背景を増やすほど距離はおおむね縮みましたが、計算量との兼ね合いがあるため、複数の件数で上位順位が安定するかも見ておきます。 -
乱数列を1本混ぜて、基準線を作る 目的変数と独立な乱数列を追加して学習し、その列の順位を複数シードで測ります。乱数列より下位の特徴量は、説明対象から外す候補として扱えます。adultでは16列中5列から7列が乱数列より下位でしたが、この順位は絶対的な正解ではないため、乱数列の作り直しによる変動も併記します。
採点の細かい決め方と、正解に採った流儀
ここから先は、結果を自分で検算したい読者向けの細部です。
「正解」は1つに決まらない
正解には流儀が2つあります。この記事は介入の流儀を主の正解に採りました。欠けた列を全体の分布から引いてくる考え方で、真の関数が加法的なら相関があっても式が閉じるからです。
一方で、条件付きの流儀を採ると答えが変わります。x0とx6を相関させた条件では、x6の真の効果はゼロなのに、条件付きの正解ではx6にゼロでない値が付きます。他の列を踏まえてよいなら、x6はx0の情報を持っているからです。どちらが正しいかにこの記事は答えません。介入を採らなかった側を「誤り」とも呼びません。「SHAPは正しいのか」という問いに一意の答えが無いのは、まずこの前提のせいです。
似た方向の日本語記事にSHAPで因果関係を説明できる?があります。あちらの問いは「SHAP値を因果効果として読めるか」で、この記事の問いは「そのモデル・その真の関数に対する寄与の配分として当たっているか」です。混同しやすいのですが、測っているものが違います。
3つの距離の正確な意味
中間に置いた「そのモデル自身の厳密なSHAP値」は、訓練データとは独立に引いた4,000件を背景にした介入SHAPです。この3つは足し算になりません。三角不等式が成り立つだけなので、「分解」ではなく「3つの距離」と呼びます。
背景データを渡さずに TreeExplainer(model) と書いたときの既定(tree_path_dependent)は、介入とは別の推定対象に向かいます。この設定については距離を出しますが、それは誤りの大きさではなく「介入の基準からどれだけ離れているか」なので、名前を分けて扱います。
生成規則と評価指標
正規分布に従うノイズの標準偏差は1.0に固定しました。評価では、大域の順位、上位6列に有効な列が入る割合、効果ゼロの4列へ配分された重要度、個別事例の順位と寄与の向きを見ています。
正解までの距離には、正規化した二乗平均平方根誤差(RMSE)を使いました。大きな食い違いを二乗によって重く数え、データ条件ごとの正解のばらつきで割った値で、0なら完全一致です。寄与の向きは、ほぼゼロの値で判定が不安定にならないよう、真のSHAP値の絶対値が大きい半分だけを対象にしました。
モデル側と説明器側の大小が、どこから区別できなくなるか
学習量を変えた条件では、2つの距離の差が件数とともに詰まります。2,000件までは「モデル側の方が大きい」ことを確認できたのに、4,000件と8,000件では2つの大小を区別できなくなりました。点推定の順序が入れ替わったわけではありません。
なお、2,000件という切れ目は判定のぎりぎりに乗っています。同じ比較をLightGBMで見ると2,000件では明確な差を確認できていないので、境目の件数そのものは持ち帰らないでください。
数値の来歴と、差の書き分け
数値はすべて、実際に実行して保存したログを集計したものです。合成データの各条件はデータ生成シード10本(一部は5本)で回し、その平均を載せています。シードによるばらつきを考慮しても残った差だけを「差を確認できた」、区別できなかった差を「明確な差を確認できなかった」と表記しました。後者は「差がない」という意味ではありません。書き分けの考え方はデータリークの罠5パターンとそろえ、5シードの条件では差を判定せず、測定値だけを示します。
読み飛ばし可: 正解の検算・判定規則・取得来歴
- 真のSHAP値の式は、全連合(2の10乗=1,024通り)を数え上げてモンテカルロで期待値を取る別経路と突き合わせて確かめました。介入・条件付きのどちらも一致し、残った差は、条件付きについて標本数を振ったところ単調に縮みました(介入側では標本数を振っていません)。
- 採点する関数そのものも対照で確かめています。正解を正解で採点すると全指標が満点、行内で並べ替えた説明や全列に同じ値を返す説明では床の値に落ちます。上位6件の再現率は無意味な説明でもちょうど0.60(6/10)を返すので、0.5を基準にしてはいけません。
- 差の判定は、同じシードで対応を取った差分をつくり、その平均の絶対値が標準誤差の2倍を超えるかどうかで決めています。シード10本の条件にだけ適用し、事後に別の統計手法は足していません。
- 中間基準の厳密性は、同じ背景データを与えたKernelExplainerとの一致で確認しました。特徴量10列では全連合を数え上げるため、両者の食い違いは本実行の全条件で最大1.5e-4でした。
- 中間基準そのものにも標本のゆらぎがあります。独立に引き直した基準どうしの距離は0.011から0.016で、これが説明器側の距離の分解能の床になります。
tree_path_dependentの0.028はこの床と同じ桁です。 - 単精度の閾値境界で加法性の検査を外れた事例を除いて集計し直すと、効果ゼロ列への配分の割合が動くのは4桁目でした(最大で0.0256から0.0251)。順位は全ケースで不変、厳密な介入SHAPとの距離の変化も最大0.00085です。
- 実データはPMLBのadultとmagicを、コミット
7c1f4bdc固定のURLから取得しました。数値は原則として小数第3位までに丸めています。
この結果が当てはまる範囲と、言えないこと
- 採点したのは合成データです。真の構造は「加法項と2次の積1組、ガウス分布の特徴量」に限られ、3次以上の交互作用・非ガウス分布・カテゴリ変数・欠測は含みません。ここで測った内訳がそのまま一般の実データに移ると主張はできません。
- 「正解」は推定対象の選択に依存します。介入と条件付きで真のSHAP値そのものが変わり、相関の強い列ではその差が大きく開きます。両方を計算して並べましたが、どちらが正しいかには答えていません。
- 深層モデル・画像・テキストは対象外です(GPUの無い環境なので DeepExplainer / GradientExplainer は未検証)。
- 実データではモデル側の距離を測れません。測ったのは注入列への配分と説明器側の距離だけです。実データ側は二値分類(log-odds空間)で正規化の分母も違うため、合成側の数値と直接は比べられません。
- 注入したコピー列の「効果ゼロ」は、元の列で条件づけたときに追加情報がゼロという意味です。単独で見れば目的変数と相関します。
- ハイパーパラメータは全モデル固定です。よく調整したモデルなら結果が変わるかは測っていません。
- モデル内蔵の重要度とPermutation Importanceの並置は大域の順位についてだけ行いました。効果ゼロ列への配分の水準は、単位の違うものをそれぞれ合計1に正規化した割合なので、手法をまたいで比べていません。
- 重要度が僅差になる条件と開きがある条件は、間隔だけでなく交互作用が予測に占める割合も一緒に動いています。2条件の差を「間隔を狭めた効果」として読むことはできません。
- 背景データの件数、特徴量20列、実データの3条件はシード5本です。測定値は示しますが、差の判定はしていません。
手元のモデルを乱数列で点検するコード
次のコードは、乱数列を1本混ぜた点検に、背景データの実効件数の表示と、SHAP値の合計が予測値に戻るかを調べる加法性監査をまとめたものです。scikit-learn付属のデータでそのまま動きます。
"""目的変数と無関係な乱数列を1本混ぜて、SHAPの重要度を点検する。"""
import numpy as np
import shap
from lightgbm import LGBMClassifier
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split

SEED = 42
rng = np.random.default_rng(SEED)

data = load_breast_cancer()
X, y = data.data, data.target
names = list(data.feature_names)

# 目的変数と無関係な乱数列を1本足す(この列の真の重要度は0とわかっている)
X = np.column_stack([X, rng.standard_normal(len(X))])
names.append("noise")

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=SEED
)

model = LGBMClassifier(n_estimators=300, max_depth=5, learning_rate=0.1,
                       random_state=SEED, verbose=-1)
model.fit(X_train, y_train)

# 背景データは maskers.Independent で明示する
# 生の配列を data= に渡すと、件数を指定しても既定の100件に切り詰められる
background = shap.maskers.Independent(X_train, max_samples=1000)
explainer = shap.TreeExplainer(model, data=background,
                              feature_perturbation="interventional")
print("実際に使われた背景データの件数:", explainer.data.shape[0])

# shapの既定の検査は、単精度の閾値境界に当たると例外を投げて止まる
# 止めずに、SHAP値の合計と学習器の生の出力を自分で突き合わせて記録する
sv = explainer.shap_values(X_test, check_additivity=False)
if isinstance(sv, list):            # 二値分類は陽性クラス側を取る
    sv = sv[1] if len(sv) == 2 else sv[0]
sv = np.asarray(sv)
if sv.ndim == 3:
    sv = sv[..., 1] if sv.shape[2] == 2 else sv[..., 0]

raw = model.predict(X_test, raw_score=True)
gap = np.abs(sv.sum(axis=1) + np.ravel(explainer.expected_value)[-1] - raw)
tol = 1e-2 + 1e-2 * np.abs(raw)     # shapの既定の検査と同じ許容範囲(行ごと)
print(f"加法性の逸脱: {int((gap > tol).sum())}件 / {len(raw)}件"
      f"(最大 {gap.max():.4f})")

# 大域の重要度=事例をまたいだ |SHAP値| の平均
importance = np.abs(sv).mean(axis=0)
order = np.argsort(-importance)
noise_rank = int(np.where(order == len(names) - 1)[0][0]) + 1

print(f"ノイズ列の順位: {noise_rank} / {len(names)}")
print(f"ノイズ列の配分割合: {importance[-1] / importance.sum():.4f}")
print("ノイズ列より下位の特徴量(解釈の対象から外す候補):")
for j in order[noise_rank:]:
print(f" {names[j]}: {importance[j]:.4f}")実行手順: 上のコードを shap_noise_check.py として保存し、必要なライブラリを入れて実行します。
pip install shap==0.51.0 lightgbm==4.7.0 scikit-learn==1.9.0 numpy==2.4.6
python shap_noise_check.py
load_breast_cancer の行を自分のデータに差し替えれば、そのまま手元のモデルで点検できます。回帰なら LGBMClassifier を LGBMRegressor に、model.predict(X_test, raw_score=True) を model.predict(X_test) に置き換え、train_test_split の stratify=y を外してください。多クラス分類はこのコードの対象外です。乱数のシードを何本か変えて回すと、ノイズ列の順位がどれくらいぶれるかも分かります。
「加法性の逸脱」は0件にならないことがあります。連続値の列が多いデータでは珍しくなく、この記事で書いた単精度の境界がその典型です。出ても壊れたわけではないので、件数と最大値を控えたうえで、その事例を外すと重要度の順位が動くかどうかを確かめてください。この記事の実データでは動きませんでした。
まとめ
「SHAPの特徴量重要度は正しいのか」への答えは、条件つきの「おおむね正しい」でした。真の重要度に開きがあり、モデルがよく当たっている木モデルなら、上位の並び順はそのまま正解と一致します。崩れるのは、モデルが関係を表現しきれていないときと、上位の列が別の列と強く相関しているときです。
見込みが外れたのは2か所です。学習データを増やしても説明の計算に由来するずれには明確な変化が出ず、相関を0.9まで強めてもほとんど何も起きませんでした。効いたのは背景データの件数と、相関0.99という極端な水準のほうです。
自分が同じ立場に置かれたら、順番は予測性能の確認、背景データの実効件数の確認、上位に来た列と強く相関する列の洗い出し、そして乱数列を混ぜた点検です。前の3つを外していると、あとの議論がまるごとずれます。そのうえで、乱数列より下位を機械的に捨てるのではなく、複数シードで順位が安定するかを確認し、解釈対象から外す候補として扱ってください。
残っているのは、相関0.9と0.99の間で何が起きるのかと、同じ挙動が深層モデルや画像・テキストでも見られるかどうかです。どちらもこの記事では測っていません。
解釈ではなく評価の側で自分を騙さない話は、ターゲットエンコーディングのリークを実測とデータリークの罠5パターンにあります。ノイズ列を使った点検の前例は特徴量エンジニアリングの効果を実測、学習に使うライブラリ選びはGBDT3種を実測比較をどうぞ。