
手元で測った精度は悪くないのに、本番のデータへ向けると当たらない。機械学習でよくあるこの落差の原因の一つが、答え合わせに使うはずのデータの情報が、モデルを作る側へ先に流れ込んでいることです。これをデータリークと呼びます。
流れ込む経路は一つではありません。特徴量の作り方、データの分け方、前処理の順序、件数の偏りをならす処理。どれもコードはエラーを出さずに動きます。動いたうえで手元のスコアだけが良くなるので、気づく手がかりが残りません。
手元での自己採点には交差検証を使います。交差検証(CVと略します)は、データを5組に分け、4組で学習して残る1組で採点する、を交代で繰り返して平均する手順です。分けた1組ずつをfoldと呼び、この記事では採点側に回ったfoldへ何が漏れるかを追います。
そこで代表的な5つの経路を合成データにわざと作り込み、誤った実装で回した交差検証のスコアが、学習にも採点にも一度も使っていない評価専用データの成績よりどれだけ高く出るかを測りました。この差を、以降は盛れ幅と呼びます。
先に結論: 盛れたのは5つ中4つ、最大は分割前のSMOTE
- 合成データに作り込んだ5パターン中4つで、誤った実装の交差検証スコアが評価専用データの成績より高く出た
- 最大は分割前のSMOTE(少数側のデータを人工的に水増しする処理)で、盛れ幅+0.240。ただし採点対象が水増し後のデータへ入れ替わっており、他の4つと同じ土俵の値ではない
- よく警告される標準化・欠損値補完の順序ミスは、今回のLightGBM・学習プール5,000件・欠損率15%では差を確認できず(-0.004)
- 盛れ幅の大小は、パターンごとにこちらが決めた強度設定で決まる。リーク危険度の順位としては読めない
- 点検の始点は、目的変数の情報が評価側へ直接入る経路(分割前のリサンプリングと、目的変数から作った特徴量)
盛れ幅は「自己採点 − 評価専用データ」の差
前提として要るのは、データを学習用と評価用に分けるという発想だけです。あとは、意味がぶれると結果を読み違える言葉を先に決めておきます。
スコアはすべてROC-AUCで測っています。分類の当たり具合を表す指標で、1に近いほど陽性を上位に並べられており、当てずっぽうなら0.5付近になります。
実力の基準にしたのが独立ホールドアウトです。学習にも交差検証にも使わず、評価だけのために取り分けたデータで、本番相当の成績の代わりに使います。盛れ幅が正なら、手元の交差検証が実力より高く見えている状態です。
分類器はLightGBM(決定木を積み重ねる勾配ブースティングのライブラリ)で、設定は既定のままにしています。
判定の言葉づかいも決めておきます。偶然のばらつきや、複数の比較を重ねることで差が出やすくなる影響を割り引いてもなお残った差だけを「差を確認できた」と書きます。割り引くと消えてしまう差は「明確な差を確認できなかった」と書き、これは「差がない(同じ)」という意味ではありません。
5つのリークを合成データに作り込んだ
作り込んだのは、次の5つの経路です。
- ①ターゲットリーク: 目的変数から計算した列を、そのまま特徴量として学習に残す
- ②時間的リーク: 時系列データを、時間順を無視してランダムに分割する
- ③グループ/重複リーク: 同じ実体から出た重複行が、学習側と評価側へ散る
- ④標準化・欠損補完リーク: 分割前の全データで標準化と欠損値補完を当てる
- ⑤リサンプリングリーク: 分割前の全データにSMOTEをかけて均衡化する
データはパターンごとに合成しました。①③④⑤はscikit-learnのmake_classificationで作った学習プール5,000件と独立ホールドアウト1,000件、②時間的リークだけは隣接時刻が強く相関する時系列を2,000件と400件で作っています。実データを使わなかったのは、盛れ幅の原因を切り分けたかったからです。リークだけを狙って作り込める合成データなら、他の要因が混ざりません。
測り方は5パターンとも同じで、「誤った実装のCV」「正しい実装のCV」「独立ホールドアウト」の3つを取って引き算します。各パターンを20データシード×5foldで回した平均です。
ここで出る数値は合成データの中の値で、実務での危険度そのものではありません。測っていない範囲は記事末の適用範囲と限界にまとめました。なお、最初に作った合成データは易しすぎると判断して生成条件を作り直しています。その経緯は後半の詳しい検証条件に置きました。
5パターン中4つで、交差検証が本番相当より高く出た
同じ手順で5つを並べると、④の標準化・欠損補完を除く4つで盛れ幅が正になりました。つまり、交差検証の数字だけを見ている限り、これらの経路では実力を過大に受け取ります。
一方で、この並びを危険度のランキングとして読むことはできません。盛れ幅の大きさはこちらが決めた強度設定で動くので、実務へ持ち出せるのは「どの工程で盛れが出るか」という向きのほうです。
○は偶然や比較数を割り引いても差が残ったパターン、―は厳しめの基準では差が残らなかったパターンです。
| パターン | 盛れ幅平均 | 差の確認 |
|---|---|---|
| ①ターゲットリーク | +0.129 | ○ |
| ②時間的リーク | +0.067 | ○ |
| ③グループ/重複リーク | +0.059 | ○ |
| ④標準化・欠損補完リーク | -0.004 | ― |
| ⑤リサンプリングリーク | +0.240 | ○ |
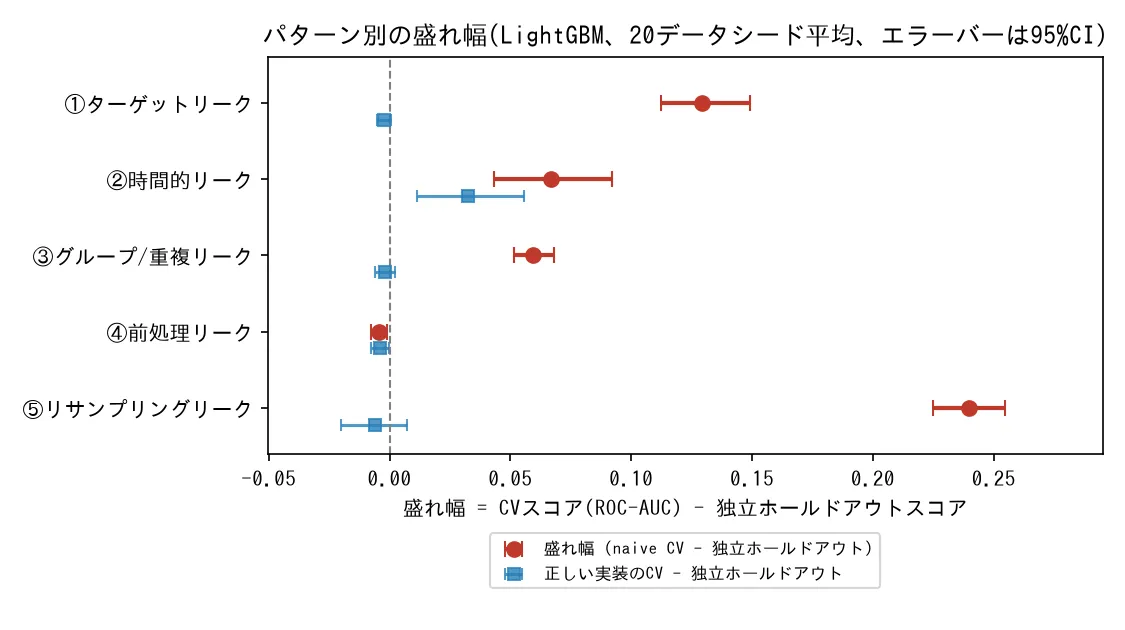
図1のエラーバーは95%信頼区間で、20個の乱数シードから求めた推定のばらつきです。求め方は後半の詳しい検証条件にまとめました。
ここから、1パターンずつ中身を見ていきます。
分割前SMOTEは+0.24。評価foldに学習側から作った点が混ざった(⑤リサンプリングリーク)
SMOTEの合成点は、近傍にある実データの情報を写し取って作られます。分割してからかければ合成点は学習側に閉じますが、分割前にかけると、元になった実データと合成点が別々のfoldへ散ります。評価側に、学習側を写した点が並ぶわけです。
直し方ははっきりしていて、SMOTEを分割の内側へ移すだけです。
| 実装 | CV平均(ROC-AUC) | 独立ホールドアウトAUC | 盛れ幅 |
|---|---|---|---|
| naive(分割前にSMOTE) | 0.909 | 0.670 | +0.240 |
| correct(fold内でSMOTE) | 0.663 | 0.670 | -0.006 |
SMOTEをfold内(imblearn.Pipeline の中)へ移すと盛れ幅は-0.006まで戻り、盛れは消えました。fold内での適用に imblearn.Pipeline が要るのは、scikit-learnの Pipeline がリサンプリングを扱えないからです。
ただし、この値だけは採点対象そのものが他と違います。誤った実装では、SMOTEで均衡化したあとのデータをそのまま5分割するので、検証foldに並ぶ少数クラスの多くは補間で作られた合成点です。他のパターンが実データの行で採点しているのに対し、ここだけ採点する集団が入れ替わっています。+0.240には、漏れの効果と、採点対象の分布が変わった効果の両方が混ざっていると読んでください。
少数クラス比率も、狙いの10%に対し実測平均で約18%でした。データ生成時に加えたラベルノイズがクラス比を薄めるためで、この比率での結果です。
目的変数由来の特徴量が残っていると+0.13盛れる(①ターゲットリーク)
目的変数から計算した特徴量、いわゆるリーク列を残したまま回すと、CVは本番相当より+0.129高く出ました。この列は本番では真のラベルが未知になるため、評価時には学習プールの平均値で定数埋めしています。
| 実装 | CV平均(ROC-AUC) | 独立ホールドアウトAUC | 盛れ幅 |
|---|---|---|---|
| naive(リーク列を含む) | 0.951 | 0.822 | +0.129 |
| correct(リーク列を除外) | 0.835 | 0.837 | -0.002 |
このパターンだけ、naiveとcorrectで最終モデルの構成(リーク列を含む/含まない)が違うので、独立ホールドアウトAUCもnaive(0.822)とcorrect(0.837)で別の値になります。correctの盛れ幅は-0.002で、盛れは見られませんでした。
直し方は、目的変数から計算した列を学習データから除くことです。推論の時点で手に入らない値は、学習でも使えません。
見落としやすいのは、一目でリーク列と分からない場合です。集計特徴量やラグ特徴量は、作り込むほどうっかり未来の答えを混ぜやすくなります。集計値やフラグが目的変数を含んで作られていないか、特徴量の作成コードまで遡って確認するのが確実です。
代表例が、カテゴリをカテゴリごとの目的変数平均で置き換えるターゲットエンコーディングです。全データ平均とout-of-fold実装を比べた検証では、目的変数と無関係な乱数カテゴリでも、条件によって交差検証AUCが0.795まで上がりました。
リーク列に頼ったモデルは自信満々に外す(①の具体例)
盛れ幅は平均の話なので、1件ずつの予測がどう狂うのかも見ておきます。独立ホールドアウトの中で、誤った実装の絶対誤差から正しい実装の絶対誤差を引いた差が最大だったサンプルを、機械的に上位2件抽出しました(目視選定ではありません)。
事例1は真のラベルが0(陰性)のサンプルです。naiveは予測確率0.780とかなりの自信で陽性側に外した一方、correctは0.198で正しく陰性側に置きました。事例2は真のラベルが1(陽性)で、naiveは0.210とこちらも自信を持って陰性側に外し、correctは0.733で正解でした。
naiveモデルは学習時にリーク列へ強く依存しています。そのリーク列が定数で埋められる本番相当の場面では依存の当てが外れ、自信度の高い誤答を出しやすくなります。correctモデルは元々リーク列を使っていないので、同じサンプルでの挙動はリーク列の有無に左右されません。
時系列はランダム分割で+0.07盛れ、TimeSeriesSplitでも+0.03残った(②時間的リーク)
自己相関とコンセプトドリフトを含む時系列データを合成し、ランダム分割でCVを回すと盛れ幅は+0.067でした。隣接時刻が強く相関するデータを行単位でランダムに配ると、ほとんど同じ時点の行が学習側と評価側の両方に並びます。
| 実装 | CV平均(ROC-AUC) | 独立ホールドアウトAUC | 盛れ幅 |
|---|---|---|---|
| naive(ランダム分割) | 0.834 | 0.767 | +0.067 |
| correct(TimeSeriesSplit) | 0.799 | 0.767 | +0.033 |
20データシードすべてで、naiveのfold平均CVがcorrectのfold平均CVを上回りました。方向は一貫しています。
ただ、目を引くのは正しい側です。時間順に分割する TimeSeriesSplit に変えても、独立ホールドアウトとの差が+0.033残りました。時間順のCVと将来データの評価は、正しく分けても完全には一致しないということです。
この残差の原因は今回は切り分けていません。候補は少なくとも2つあります。1つは、TimeSeriesSplitの各foldが最終モデルより少ない学習データで訓練されることです。もう1つは、独立ホールドアウトが学習プールの終端よりさらに未来のブロックにあり、ドリフトの影響をより強く受けている可能性です。どちらが主因かは分かりません。
複製行が別foldに混ざると+0.06盛れる(③グループ/重複リーク)
学習プールの30%の行に、微小ノイズ付きの複製行を加えます。そのうえでStratifiedKFoldでCVを回すと盛れ幅は+0.059でした。
| 実装 | CV平均(ROC-AUC) | 独立ホールドアウトAUC | 盛れ幅 |
|---|---|---|---|
| naive(StratifiedKFold) | 0.896 | 0.836 | +0.059 |
| correct(GroupKFold) | 0.834 | 0.836 | -0.002 |
作り込んだ複製ペア(元行と複製行の組)のうち、片方が学習側・もう片方が評価側に分かれた割合は、naive(StratifiedKFold)で平均79.7%、correct(GroupKFold)では全20データシードで0%でした。同一顧客や同一センサーのように由来が同じ行が複数あるデータでは、グループを意識せず分割すると、ほぼ同じ情報が学習側と評価側の両方に漏れます。
対処は GroupKFold でグループ単位に分けることです。同一顧客・同一センサー・重複レコードのように、行をまたいで同じ実体を指すIDをグループとして渡します。IDが無いなら、まず何が重複の単位なのかを決めるところからです。
標準化・欠損値補完の順序ミスはLightGBMではほとんど盛れず(④標準化・欠損補完リーク)
ここだけ、盛れませんでした。StandardScalerとSimpleImputer(平均値補完)を分割前の全データにfitしても、盛れ幅は-0.004です。5パターンで唯一、厳しめの基準では差が残らなかったパターンでした。
| 実装 | CV平均(ROC-AUC) | 独立ホールドアウトAUC | 盛れ幅 |
|---|---|---|---|
| naive(分割前にfit) | 0.825 | 0.830 | -0.004 |
| correct(fold内でfit) | 0.826 | 0.830 | -0.004 |
符号がむしろ逆で、naiveの方がcorrectよりわずかに低いくらいです。リークが効いていれば期待される「naiveが高く出る」向きとは逆でした。副次的に回したロジスティック回帰でも、naive・correctともに-0.008で、盛れは見られませんでした。
この「順序ミスなのに盛れない」結果は、条件を変えれば別の答えになりえます。前処理を交差検証の前に当てた場合を4種類で測り直した検証では、列数の多いデータでの特徴選択が平均0.027、分割前のSMOTEは木モデルで0.1を超えました。標準化と欠損補完については、そちらでも差を確認できていません。
なぜ盛れないのでしょうか。処理を「スケーラだけ」「欠損補完だけ」「両方(主実験と同条件)」の3つに分けて、LightGBMだけで追加検証しました。
| 条件 | 内容 | naive-correct差 | 差の確認 |
|---|---|---|---|
| scaler_only | 欠損のない完全なデータにStandardScalerのみ | -0.0008 | 差は残ったが符号は逆 |
| imputer_only | 欠損率15%のデータにSimpleImputer(平均値補完)のみ | -0.0003 | 差は残らなかった |
| both | 欠損率15%のデータに両方(主実験と同条件) | -0.0004 | 差は残らなかった |
StandardScalerは各特徴量への単調な線形変換で、LightGBMのような木ベースモデルの分割閾値や分割順序を原理的に変えません。だからscaler_onlyの差はサンプルサイズによらず出ないはずで、実測でも差はほぼ0(しかも符号が逆)でこれと合います。
一方SimpleImputerは埋め値そのものが変わるので、理論上はリークの経路になりえます。ただしimputer_onlyでも差は残らず、今回のサンプルサイズ(n=5000)・欠損率(15%)では確認できませんでした。標準化・欠損補完の順序ミスが原理的に無害だ、という話ではありません。サンプルが小さい・欠損が多いほど強まりうる効果が、今回の範囲では検出限界に届かなかった、という限定付きの結論です。
そのうえで実装は、Pipeline に StandardScaler や SimpleImputer を入れ、CVのfold内でfitさせる形にします。今回は差が出ませんでしたが、手間はほとんど変わりません。
点検は目的変数が評価foldへ入る経路から始める
最初に開くのは、SMOTEなどのリサンプリングを呼んでいる行と、目的変数から作った列の生成コードです。この2つだけは、交差検証の外側に出ていないかを行単位で確かめます。
次に、分割単位を見ます。時系列なら時間順、同じ顧客やセンサーから複数行が出るならグループ単位で分けます。行をランダムに配る前に、「本番では何を未知として予測するのか」を決める必要があります。
標準化や欠損補完もPipelineへ入れます。今回のLightGBMでは差を確認できませんでしたが、これは手順を省いてよいという結果ではありません。検証foldの情報を前処理が見ない形へそろえたうえで、独立ホールドアウトとの差を確かめます。
学習と評価の分離が正しくても、本番へ流れてくるデータが学習時と同じとは限りません。推論の前に入力の異常を見つける仕組みは、panderaで入力データを検証した記事で扱っています。
詳しい検証条件: 強度設定・シード・生成のやり直し
リークの強さは、こちらが決めた設定で決まります。5パターンの設定は次のとおりです。
- ①ターゲットリーク: 目的変数から作ったリーク列を「3×目的変数+標準偏差1.5の雑音」で生成し、学習データに残す
- ②時間的リーク: 隣接時刻の相関を0.85にした時系列を、時間順を無視してランダム分割する
- ③グループ/重複リーク: 学習プールの30%の行に、微小ノイズ付きの複製行を足す
- ④標準化・欠損補完リーク: 欠損率15%のデータに、分割前の全データで
StandardScalerとSimpleImputerをfitする - ⑤リサンプリングリーク: 少数クラス10%を狙った不均衡データに、分割前にSMOTEをかけて完全に均衡化する
評価指標は盛れ幅(ROC-AUCで測った、誤った実装のCV − 独立ホールドアウト)です。分類器はLightGBM(既定設定、乱数はseedに連動)とパターンごとの生成条件に固定し、各パターンを20データシード(42〜61)×5foldで回しました。
②時間的リークだけは make_classification を使わず、AR(1)で隣接時刻を相関させた特徴量に、係数がゆっくり回転するドリフトを重ねて作りました。⑤リサンプリングリークは、weights=[0.9, 0.1] で少数クラスを1割に寄せたデータへSMOTEをかけています。
リーク以外の差を測らないよう、生成と分割を直した
最初につまずいたのは、素の合成データが易しすぎたことです。make_classification の既定の分離度のままでは、基準スコア(独立ホールドアウトのROC-AUC)が天井近くに張り付き、リークを仕込んでも押し上げる余地が残らないと判断しました。④の前処理リークを単独で試したときに気づいた点です。
ただし、この判断のもとにした探索の実行ログは保存しておらず、そのときの基準スコアや盛れ幅を数値としては出せません。生成条件を難しくした設定に変え、同じ条件を5パターン全部に流用しています。最終的にこの設定で回した①③④⑤の基準スコア(LightGBMの独立ホールドアウトAUC)は、実測で0.67〜0.84でした。なお①③については、その難易度が①③にとって適切かを個別に確かめてはいません(天井効果は指標に共通する性質なので原理から外挿しました)。
もう1点は、分割の作り方です。学習プールと独立ホールドアウトは、make_classification の1回の呼び出しから行方向に切り分けています。random_state を変えて2回呼ぶと、クラスタ中心や係数構造そのものが変わってしまい、同じ分布からの新しいサンプルになりません。それに気づかないまま測ると、リークの有無ではなく分布の違いを測ることになります。この点は、後半の再現コードにもコメントとして入れてあります。
読み飛ばし可:統計の手順と、全パターンの判定・補助指標
独立単位はdata_seed(20個、42〜61)です。fold間の非独立性を避けるため、まずseed内で5foldの平均を取り、20個のseed平均値を独立サンプルとして扱っています。平均・95%信頼区間はブートストラップ(1万回、seed=42)で算出しました。この信頼区間は、評価に使ったサンプルに対する推定の不確実性を表します。
5パターンの盛れ幅は同時に5つの仮説を検定する形になり、比較の組み合わせが多いほど偶然でも差が出やすくなります。この記事はその影響を割り引くBonferroni補正(α=0.05/5)を主報告の基準にし、より緩いHolm法も併せて算出しました。数値は丸めて表記しています(盛れ幅は小数第3位、前処理リークのアブレーションのように値が小さい場合は小数第4位)。本記事のすべての数値は、実際に実行して保存した計測ログを集計したものです。
盛れ幅(naive実装のCV − 独立ホールドアウト、LightGBM)の判定一覧です。
| パターン | 分類器 | 盛れ幅平均 | 95%CI | Bonferroni判定 | Holm判定 |
|---|---|---|---|---|---|
| target_leak | lightgbm | 0.129 | [0.112, 0.149] | 差あり | 差あり |
| temporal_leak | lightgbm | 0.067 | [0.043, 0.092] | 差あり | 差あり |
| group_leak | lightgbm | 0.059 | [0.051, 0.068] | 差あり | 差あり |
| preprocessing_leak | lightgbm | -0.004 | [-0.008, -0.001] | 差なし | 差あり |
| resampling_leak | lightgbm | 0.240 | [0.225, 0.255] | 差あり | 差あり |
| preprocessing_leak | logistic_regression | -0.008 | [-0.016, 0.000] | 参考(補正対象外) | 参考(補正対象外) |
多重比較の補正はLightGBM×naiveの5パターンを家族として適用しています。ロジスティック回帰は家族に含めていない参考値です(点推定-0.008・CIが0を含み、補正前のα=0.05でも差は出ません)。
補助指標として、正しい実装のCV − 独立ホールドアウトの差(LightGBM)も算出しています。
| パターン | 差の平均 | 95%CI |
|---|---|---|
| target_leak | -0.002 | [-0.005, 0.001] |
| temporal_leak | 0.033 | [0.012, 0.055] |
| group_leak | -0.002 | [-0.006, 0.002] |
| preprocessing_leak | -0.004 | [-0.0077, -0.0004] |
| resampling_leak | -0.006 | [-0.020, 0.007] |
④のアブレーション(LightGBM)のnaive-correct差と95%CIは次のとおりです。
| 条件 | 差の平均 | 95%CI |
|---|---|---|
| scaler_only | -0.0008 | [-0.0016, -0.0001](0を除外するが符号は逆) |
| imputer_only | -0.0003 | [-0.0010, 0.0004](0を含む) |
| both | -0.0004 | [-0.0013, 0.0006](0を含む) |
Bonferroni補正はα=0.05を比較数(5)で割った基準(α=0.01)で棄却を判定し、Holm法は各比較のp値を小さい順に並べて順に緩い基準を当てます。preprocessing_leak(lightgbm)はp値が0.011で、Bonferroni基準(0.01)にわずかに届かず「差なし」、Holm法の該当ステップではぎりぎり「差あり」になります。点推定が-0.004と小さく符号も逆であることを踏まえ、本文では保守的なBonferroni基準に基づき「明確な差を確認できなかった」と記述しています。
適用範囲と限界
- 合成データによる検証で、実データでの外的妥当性は測っていません。
- 測ったのはROC-AUCで見た盛れ幅だけです。合成点の生成品質など、ほかの指標では測っていません。
- ④が対象にしたのは
StandardScalerとSimpleImputerの2つだけです。特徴選択やカテゴリのエンコーディングも一般には前処理と呼ばれますが、今回は測っていません。「前処理は盛れない」と一般化できる結果ではありません。 - 盛れ幅の大きさは、パターンごとに独立に決めた強度設定(リーク列の雑音、複製率、少数クラス比率、欠損率、時系列の相関)に依存します。加えてパターン間で基準AUC(独立ホールドアウトのROC-AUC)は0.67〜0.84とばらついています。盛れ幅の絶対値は、リーク危険度の順位として一般化できません。
- ⑤の誤った実装だけ、CVの採点対象がSMOTE適用後のデータです。他の4パターンは実データの行で採点しており、+0.240は他の4つと同じ土俵の値ではありません。
- ①③の生成条件は、天井効果を避けるために難しくした設定を流用したものです。天井効果は指標に共通する性質なので、①③向けにその難易度が適切かは原理から判断しており、個別には確認していません(①③の盛れ幅の値自体は実測です)。難易度を決めるときの探索の実行ログは保存していません。
- ⑤の少数クラス比率は、狙いの10%に対し実測平均で約18%でした。
- ④のアブレーションはLightGBMのみで行っており、線形モデルでの機序切り分けはしていません。今回のサンプルサイズ・欠損率で差を検出できなかっただけで、より小さいサンプルやより高い欠損率では違う結果になりえます。
手元のパイプラインで同じ引き算をするコード
データ生成はこの形です。基準AUCを天井から引き離す設定と、学習プールと独立ホールドアウトを1回の呼び出しから切り分ける処理が入っています。
import numpy as np
from sklearn.datasets import make_classification

# 基準AUCを天井から引き離す設定。既定のままだと基準AUCが天井近くに張り付き、
# リークを足してもスコアが伸びる余地が残らない
BASE_KWARGS = dict(n_informative=3, n_redundant=2, n_clusters_per_class=1,
                   class_sep=0.2, flip_y=0.2)


def gen_pool_and_holdout(seed, n_train=5000, n_holdout=1000, weights=None):
    # 1回の呼び出しから行方向に切り分ける。random_stateを変えて2回呼ぶと
    # クラスタ中心や係数構造そのものが変わり、同一分布の新規サンプルにならない
    X, y = make_classification(
        n_samples=n_train + n_holdout, n_features=20,
        weights=weights, random_state=seed, **BASE_KWARGS)
    return X[:n_train], y[:n_train], X[n_train:], y[n_train:]


# ①ターゲットリーク: 目的変数から直接作った列を学習データに残す
def add_target_leak_column(y, seed, effect=3.0, noise_std=1.5):
    rng = np.random.default_rng(seed + 200_000)
    return effect * y + rng.normal(0, noise_std, size=len(y))


# ③グループ/重複リーク: 3割の行に、微小ノイズを載せた複製行を足す
def inject_group_duplicates(X, y, seed, dup_fraction=0.3, noise_scale=0.01):
    rng = np.random.default_rng(seed + 300_000)
    idx = rng.choice(len(y), size=int(round(dup_fraction * len(y))), replace=False)
    X_dup = X[idx] + rng.normal(0, noise_scale, size=(len(idx), X.shape[1])) * X.std(axis=0)
    group_id = np.concatenate([np.arange(len(y)), idx])  # 複製行は複製元と同じID
    return np.vstack([X, X_dup]), np.concatenate([y, y[idx]]), group_id


# ④標準化・欠損補完リーク: 先頭8列に15%のランダム欠損を空ける
def inject_missing(X, seed, rate=0.15, n_cols=8):
    X = X.copy()
    rng = np.random.default_rng(seed + 400_000)
    X[:, :n_cols] = np.where(rng.random((len(X), n_cols)) < rate, np.nan, X[:, :n_cols])
    return X
盛れ幅を測る側は、いちばん盛れ幅の大きかった⑤リサンプリングリークを例にすると次のコードです。上の生成コードに続けて貼ると、1データシード分の盛れ幅が誤った実装・正しい実装の2つ分返ります。
from imblearn.over_sampling import SMOTE
from imblearn.pipeline import Pipeline as ImbPipeline
from lightgbm import LGBMClassifier
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import StratifiedKFold


def make_lgbm(seed):
    return LGBMClassifier(random_state=seed, n_jobs=4, verbosity=-1)


def measure_gap_resampling(seed=42, n_splits=5):
    # 学習プールと独立ホールドアウトは上の gen_pool_and_holdout で作る
    X, y, X_holdout, y_holdout = gen_pool_and_holdout(
        seed, n_train=5000, n_holdout=1000, weights=[0.9, 0.1])
    skf = StratifiedKFold(n_splits=n_splits, shuffle=True, random_state=seed)

    # 誤った実装: 分割前の全データにSMOTEをかけてから分割する
    X_res, y_res = SMOTE(random_state=seed).fit_resample(X, y)
    naive = []
    for tr, va in skf.split(X_res, y_res):
        clf = make_lgbm(seed)
        clf.fit(X_res[tr], y_res[tr])
        naive.append(roc_auc_score(y_res[va], clf.predict_proba(X_res[va])[:, 1]))

    # 正しい実装: SMOTEをfoldの内側に入れ、各foldの学習データだけで合成する
    correct = []
    for tr, va in skf.split(X, y):
        pipe = ImbPipeline([("smote", SMOTE(random_state=seed)),
                            ("clf", make_lgbm(seed))])
        pipe.fit(X[tr], y[tr])
        correct.append(roc_auc_score(y[va], pipe.predict_proba(X[va])[:, 1]))

    # 独立ホールドアウト: 学習プール全体で1本学習し、SMOTE未適用の新規データで評価
    final_pipe = ImbPipeline([("smote", SMOTE(random_state=seed)),
                              ("clf", make_lgbm(seed))])
    final_pipe.fit(X, y)
    true_oos = roc_auc_score(y_holdout, final_pipe.predict_proba(X_holdout)[:, 1])

    # 盛れ幅 = CV平均 - 独立ホールドアウト
    return np.mean(naive) - true_oos, np.mean(correct) - true_oos
これをシード42〜61の20回分繰り返し、シードごとの値を独立サンプルとして集計したものが+0.240です。残る4パターンも、SMOTEの箇所をそれぞれのリーク(リーク列・時間順を無視した分割・複製行・分割前の前処理fit)に差し替えた同じ形で測っています。
自分のパイプラインで確かめるなら、gen_pool_and_holdout を手元のデータの読み込みへ差し替え、SMOTEの箇所を自分の前処理に置き換えてください。誤った実装と正しい実装で盛れ幅がどれだけ開くかは、同じ引き算で測れます。
まとめ: 覚えるのは数値ではなく経路
5パターンを同じモデルで測ると、CVの崩れ方は一様ではありませんでした。目的変数の情報が評価foldへ直接入る経路では明確に高くなり、標準化・欠損補完の順序ミスは今回のLightGBMでは差を確認できません。
自分が実務でパイプラインを組むなら、この数値の大小を覚えるのではなく、評価用のfoldの情報を学習側の処理が見ていないかを工程ごとに確かめます。強度設定を変えれば数値は動きますが、経路の見つけ方は変わりません。
評価が実態からずれる経路は、リークだけではありません。目的変数の作り方でも起きます。解約予測で打ち切りの扱いを比べた検証では、追跡が終わった時点で解約を確認できていない人を未解約として扱うと、解約率を系統的に低く見積もりました。
分からないままなのは、標準化・欠損補完がより小さいデータや高い欠損率でどう変わるかと、TimeSeriesSplitでも独立ホールドアウトとの差が残った理由です。ここは今回の実験から原因を決められません。