
同じモデルに同じ行を渡して説明をやり直したら、上位に並ぶ特徴の顔ぶれが前回と違っていた。1行ぶんの予測について、どの特徴がどれだけ効いたかを出すLIMEを使っていると、こういう場面に出会うことがあります。
モデルは学習し直していません。入力も同じ行です。
LIMEは説明したい行の周りにデータ点を作り、元のモデルから予測値を集めたあと、近い点ほど重く扱って局所的な線形モデルを当てはめます。点の生成には乱数を使うので、同じ入力でも結果が揺れる余地は残ります。
では、揺れたときにどこを見ればよいのでしょうか。手を入れられるのは、近傍の広さを決めるkernel_widthと、作る点の数を決めるnum_samplesの2つです。幅を狭めれば説明はより局所的になり、点を増やせば結果は安定しそうに見えます。ただ、この2つの効果は分けて確かめないと、どちらが効いたのか判断できません。
そこで学習済みモデルと説明対象の40行を固定したまま、LIME側の設定だけを動かして測りました。SHAPとLIMEの結果が食い違う話はSHAPとLIMEで重要特徴が違う理由で扱っています。この記事が見るのは、LIME単体の設定です。
先に結論: 崩れたのは近傍を4分の1に狭めたときだけ
- 既定幅とそれより広い設定では、乱数シードを変えても上位3特徴が動かない。シード3組・40行のすべてで一致
- 崩れるのは既定の4分の1まで狭めたとき。設定は同じで乱数シードだけ変えた再実行でも、上位3の一致率は平均0.3350
- 既定の半分幅では8割台を保つ。0.5倍と0.25倍の間で急に落ちる段差型で、幅に比例して悪化するわけではない
- サンプル数を500から2,000へ4倍にしても、4分の1幅の一致率は0.4000まで。近傍の狭さはサンプル数で補えない
- 測ったのは、連続値の離散化を切った合成データ10特徴とLightGBMの1構成。LIME既定の離散化オンは未検証
近傍の広さは、指定しなければ特徴量の本数で決まる
kernel_widthは、説明対象からどれだけ離れた点まで重く扱うかを決める値です。指定しなければ、特徴量の本数から計算した既定値が入ります。今回のように10特徴なら2.3717でした。
もう一方のnum_samplesは、1行を説明するために作る点の数です。既定より増やせば線形近似に使える点は増えますが、点をどこに置くかはkernel_widthとは別の話になります。
一致率は2種類を出しました。ひとつは再現性で、設定をまったく変えず乱数シードだけ変えて2回実行し、上位3特徴の顔ぶれと第1位が揃うかを見た値です。もうひとつは設定への感度で、「既定幅・2,000サンプル」を参照設定と決め、そこからどれだけ離れるかを同じ物差しで測りました。
上位3の重なりにはJaccard係数を使います。2回の実行に共通する特徴の数を、両方を合わせた特徴の数で割った値で、3本とも同じなら1、まったく重ならなければ0です。
この2つは性質が違うので、別々に集計しました。再現性が低ければ、同じ入力に同じ答えを返せていないということ。設定への感度は、設定を変えたときに説明の中身がどれだけ動くかを表します。
近傍幅5水準とサンプル数2水準をシード3組で比べた
学習済みモデルと説明対象の40行は全条件で共通です。動かしたのは、既定値に対する近傍幅の倍率(0.25・0.5・1.0・2.0・4.0)と、サンプル数(500と2,000)だけ。この10通りを、乱数シード3組で回しました。
実験前に見込んでいたのは、設定を少し変えるだけで上位特徴が入れ替わり、同じ設定でも再実行でぶれる、という結果です。この見込みが当たったのは、既定より狭めた条件だけでした。
データの中身と集計の手順は、後半の「詳しい検証条件」に置きました。
既定のままなら、シードを変えても上位3本は動かなかった
既定幅とそれより広い設定では、乱数シードを変えても説明の顔ぶれが変わりませんでした。倍率1.0以上の6条件すべてで、上位3特徴はシード3組・40行の全部で一致しています。
実務に引き直すと、説明が揺れたときに最初に見るのは点の数ではなく、kernel_widthが既定から動いていないかどうかになります。以下が、近傍の広さとサンプル数を変えた結果です。倍率は既定値2.3717に対する比率を表します。
| 倍率 | 幅 | サンプル数 | 上位3一致(平均/最小) | 第1位一致(平均/最小) | 参照との上位3一致 | 参照との第1位一致 |
|---|---|---|---|---|---|---|
| 0.25 | 0.5929 | 500 | 0.3350 / 0.3225 | 0.2917 / 0.2250 | 0.3525 | 0.200 |
| 0.25 | 0.5929 | 2000 | 0.4000 / 0.3300 | 0.3333 / 0.3250 | 0.3950 | 0.450 |
| 0.50 | 1.1859 | 500 | 0.8125 / 0.7850 | 0.9000 / 0.8250 | 0.8100 | 0.875 |
| 0.50 | 1.1859 | 2000 | 0.8917 / 0.8875 | 0.9750 / 0.9500 | 0.9125 | 0.950 |
| 1.00 | 2.3717 | 500 | 1.0000 / 1.0000 | 0.9917 / 0.9750 | 1.0000 | 1.000 |
| 1.00 | 2.3717 | 2000 | 1.0000 / 1.0000 | 1.0000 / 1.0000 | 1.0000 | 1.000 |
| 2.00 | 4.7434 | 500 | 1.0000 / 1.0000 | 1.0000 / 1.0000 | 1.0000 | 1.000 |
| 2.00 | 4.7434 | 2000 | 1.0000 / 1.0000 | 1.0000 / 1.0000 | 1.0000 | 1.000 |
| 4.00 | 9.4868 | 500 | 1.0000 / 1.0000 | 1.0000 / 1.0000 | 1.0000 | 1.000 |
| 4.00 | 9.4868 | 2000 | 1.0000 / 1.0000 | 1.0000 / 1.0000 | 1.0000 | 1.000 |
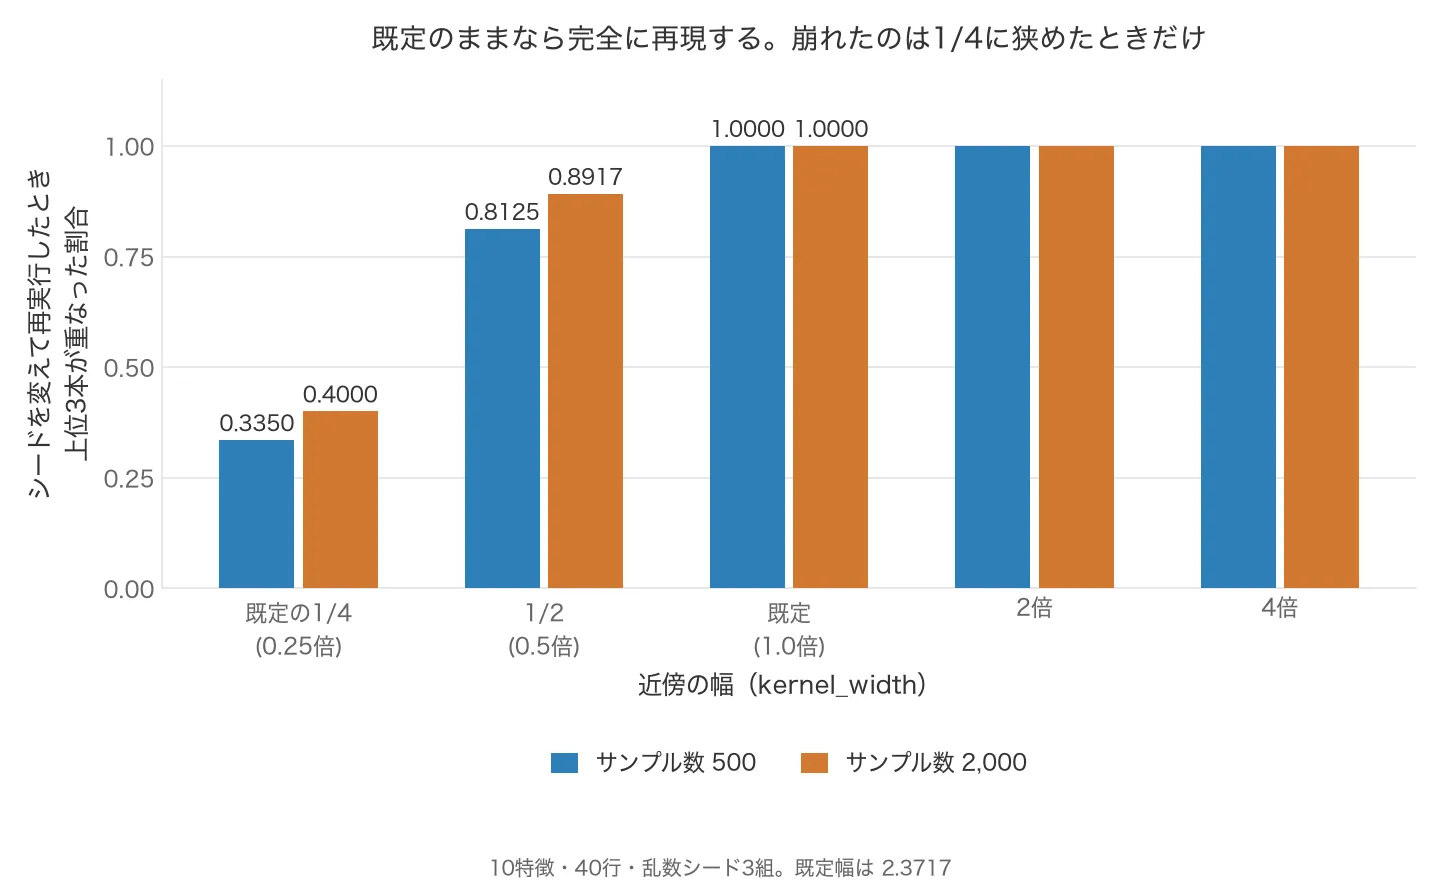
完全ではありませんでした。既定幅でサンプル数を500にした条件だけ、第1位の一致が平均0.9917、最小0.9750です。あるシードの組で、40行のうち1行だけ第1位が入れ替わりました。サンプル数を2,000にすると、この差は消えています。
この1行は、危うく見落とすところでした。最初はシード1組だけで再現性を測っていて、その組では第1位の一致率も1.0000です。1組では偶然揃った場合と区別できないため3組に増やし、平均と最小を併記したところで違いが表に出ました。
倍率2.0と4.0でも、上位3特徴と第1位は既定設定と一致しました。ただし測っているのは上位3の集合と第1位だけです。4位以下の順位、寄与の大きさ、局所線形モデルの当てはまりまで安定しているとは言えません。
4分の1まで狭めると、同じ設定でも上位3本が揃わなくなった
倍率0.25、つまり既定の4分の1まで近傍を狭めた条件では、同じ入力を説明し直しても上位の顔ぶれが安定しません。1回きりの結果をそのまま採用する使い方は、この条件では成り立たないということです。
上位3の一致率はシード3組の平均で0.3350、最小で0.3225。第1位の一致率も平均0.2917、最小0.2250にとどまりました。モデル、入力、LIMEの設定はすべて固定で、違うのは乱数シードだけです。
崩れる理由は、LIMEがkernel_widthをどう使うかにあります。点は説明対象の周囲ではなく学習データの平均を中心に撒かれるため、幅を変えてもサンプルの位置と広がりは動きません。変わるのは各点の重みだけです。
幅を狭めるほど遠い点の重みは急速に0へ近づき、生成した数が同じでも、線形近似に実質的に効く点は少なくなります。どの点が残るかはシード次第なので、係数の揺れにつながった可能性があります。ここまでは重みの式から考えた筋道で、今回の実験で原因を切り分けたわけではありません。重みの式そのものは記事末に置きました。
壊れ方は坂ではなく段差だった
幅を半分にした時点では、説明はまだかなり保たれます。倍率0.5の上位3一致率は平均0.8125と0.8917、第1位は平均0.9000と0.9750でした。前掲の表で倍率0.25の行と並べると、同じ「既定より狭い」でも中身が違うことが分かります。
つまり、幅を狭めた分だけなだらかに悪くなるのではなく、あるところで一気に落ちます。今回の5水準で低下幅が大きかったのは、0.5倍と0.25倍の間でした。
その間に測定点を置いていないため、安定性が変わる境界値までは特定できません。近傍幅を既定から動かすなら、候補値ごとに再実行して一致率を確かめる必要があります。
サンプル数を4倍にしても、狭い近傍は戻らなかった
点を増やせば近似は安定しそうに見えます。倍率0.25でサンプル数を500から2,000へ増やすと、たしかに再実行時の上位3一致率は平均0.3350から0.4000へ上がりました。ただし最小値は0.3225から0.3300までで、ほとんど動きません。
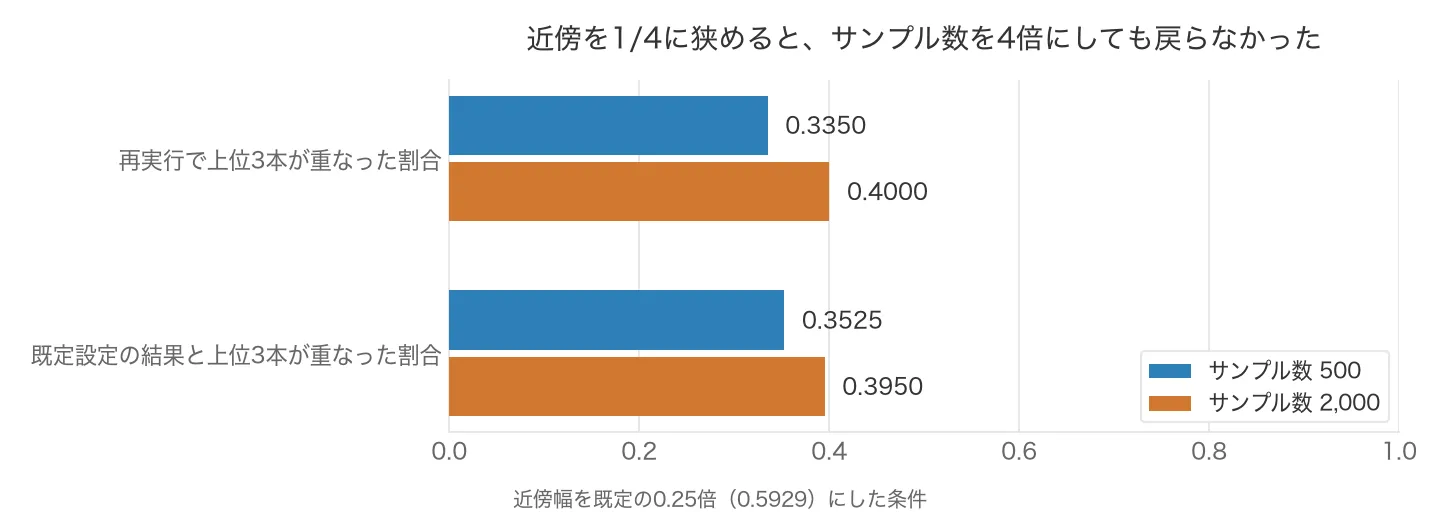
第1位の一致率は平均0.2917から0.3333へ、参照設定との一致率は0.200から0.450へ上がりました。後者はそれでも半分に届きません。
比べる相手は、倍率1.0・500サンプルの条件です。こちらは上位3特徴がすべて一致し、第1位が動いたのも40行中1行だけでした。サンプル数を4倍にして届かなかった水準に、幅を既定へ戻すだけで到達しています。
不安定さの主因は、少なくとも今回の比較では点の数ではなく近傍の広さでした。設定を触る順番も、そこから決まります。
手元で確かめるなら、幅を固定してから点の数を動かす
手元のデータで同じ確認をするなら、順番は次のとおりです。
kernel_widthを指定せず、基準となる結果を保存する- 乱数シードだけを変えて同じ入力を複数回説明する
- 上位特徴の集合と第1位を分けて一致率を測る
- 不安定なら
kernel_widthを確認し、幅を固定したままnum_samplesを増やす - 幅を変更する場合は、候補値ごとに再現性と基準結果との差を測る
手順2のシードは、1組で止めないほうが安全です。平均だけでなく最小値も並べておくと、40行のうち1行だけ入れ替わるような小さな差を拾えます。
ここで示した値は、採用すべき幅の基準ではありません。データ、特徴量数、モデルが変われば結果も変わるため、採用値は自分の条件で測り直して決めます。
この手順が当てはまるのは、連続値の離散化を切っている場合です。 既定はオンで、そのとき連続値は区間に置き換えられ、点の生成も距離の計算もその表現の上で行われます。オンでの再現性と感度は測っていないので、幅を先に見るという順番自体が変わる余地があります。既定のまま使っているなら、まず手順2と3の一致率を取ってからになります。
詳しい検証条件
データは5,000件の合成データで、10本の特徴量のうち4本が目的変数に影響します。そのうち2本には交互作用を持たせました。ここからLightGBMの二値分類モデルを1つ学習し、説明対象には検証用データの先頭40行を使っています。
kernel_widthの既定値は、特徴量数の平方根に0.75を掛けた値です。10特徴なら2.3717になり、これに0.25・0.5・1.0・2.0・4.0を掛けた5水準を試しました。設定への感度の基準にした参照設定は「既定幅・2,000サンプル」です。
再現性のシードの組は(1, 2)・(3, 4)・(5, 6)の3組です。各組で40行分のJaccard係数を平均し、得られた3つの値から平均と最小を取りました。1組だけでは偶然の一致を見分けにくいため、最小値を併記しています。
重みの式も書いておきます。各点の重みは、説明対象からの距離をdとしてsqrt(exp(-d^2 / kernel_width^2))です。分母にあたる幅を小さくすると、離れた点の重みが急速に0へ向かいます。
表の数値は、実行時に保存したログの集計です。10通りの設定を各2回実行し、それぞれ40行分を記録しました。
適用範囲と限界
- 連続値の離散化: オフで固定しています。LIME既定のオン設定は未検証です
- データとモデル: 合成データ、10特徴、LightGBMの1設定のみ。実データや高次元データは未検証です
- 近傍幅: 既定値は特徴量数から決まるため、特徴量数が違えば同じ倍率でも挙動が変わる可能性があります
- 説明対象: 40行。決定境界からの距離による違いは分析していません
- 評価指標: 上位3の集合と第1位の一致だけです。寄与の大きさそのものの安定性は測っていません
- 段差の位置: 0.5倍と0.25倍の間に測定点がないため、安定性が変わる境界値は特定できていません
近傍幅とサンプル数を振って再現性を測る
次のコードでは、近傍幅とサンプル数を変え、再現性と参照設定との一致率を計算します。設定の影響と乱数による揺れを分けるため、同じ設定をシードだけ変えて再実行。シードは3組用意し、平均だけでなく最小値も確認します。
"""LIME はパラメータで結論が変わるのか、同じ入力を2回説明すると同じ答えになるのか。

モデルも説明対象の行も固定し、LIME 側の設定だけを動かす。
  kernel_width  近傍の広さ(既定は sqrt(特徴数) * 0.75)
  num_samples   1行あたりに撒く摂動の数
再現性(同じ設定をシードだけ変えて2回)と感度(参照設定との一致)を分けて測る。
実行: python sample_limeparam.py (所要 5 分程度)
"""

import numpy as np
import pandas as pd
from lightgbm import LGBMClassifier
from lime.lime_tabular import LimeTabularExplainer
from sklearn.model_selection import train_test_split

N, N_FEATURES, N_EXPLAIN, TOPK, SEED = 5000, 10, 40, 3, 0
KERNEL_MULTIPLIERS = [0.25, 0.5, 1.0, 2.0, 4.0]   # 既定幅に対する倍率
NUM_SAMPLES = [500, 2000]
RERUN_SEED_PAIRS = [(1, 2), (3, 4), (5, 6)]


def make_data(seed=0):
    rng = np.random.default_rng(seed)
    X = rng.normal(size=(N, N_FEATURES))
    logit = (1.6 * X[:, 0] + 1.1 * X[:, 1] - 0.9 * X[:, 2] + 0.6 * X[:, 3]
             + 0.8 * X[:, 0] * X[:, 1])
    return (pd.DataFrame(X, columns=[f"x{i}" for i in range(N_FEATURES)]),
            rng.binomial(1, 1 / (1 + np.exp(-logit))))


def jaccard(a, b):
    return len(set(a) & set(b)) / len(set(a) | set(b))


def explain_all(Xtr, Xe, model, kernel_width, num_samples, random_state):
    ex = LimeTabularExplainer(
        Xtr.to_numpy(), feature_names=list(Xtr.columns), class_names=["0", "1"],
        discretize_continuous=False, kernel_width=kernel_width,
        random_state=random_state)
    out = []
    for i in range(len(Xe)):
        e = ex.explain_instance(Xe.iloc[i].to_numpy(), model.predict_proba,
                                num_features=N_FEATURES, num_samples=num_samples)
        out.append([j for j, _ in sorted(e.as_map()[1], key=lambda t: -abs(t[1]))])
    return out


X, y = make_data(SEED)
Xtr, Xte, ytr, _ = train_test_split(X, y, test_size=0.3, random_state=SEED)
model = LGBMClassifier(n_estimators=300, learning_rate=0.05, verbose=-1,
                       random_state=SEED, n_jobs=1).fit(Xtr, ytr)
Xe = Xte.iloc[:N_EXPLAIN].reset_index(drop=True)

default_width = float(np.sqrt(N_FEATURES) * 0.75)
ref = explain_all(Xtr, Xe, model, default_width, max(NUM_SAMPLES), 1000)

rows = []
for mult in KERNEL_MULTIPLIERS:
    width = default_width * mult
    for ns in NUM_SAMPLES:
        # シードを1組しか試さないと「たまたま揃った」と区別できない。3組で最小まで見る
        j, t1 = [], []
        for s1, s2 in RERUN_SEED_PAIRS:
            a = explain_all(Xtr, Xe, model, width, ns, s1)
            b = explain_all(Xtr, Xe, model, width, ns, s2)
            n = range(len(Xe))
            j.append(np.mean([jaccard(a[i][:TOPK], b[i][:TOPK]) for i in n]))
            t1.append(np.mean([a[i][0] == b[i][0] for i in n]))
        a = explain_all(Xtr, Xe, model, width, ns, RERUN_SEED_PAIRS[0][0])
        n = range(len(Xe))
        rows.append({
            "倍率": mult, "幅": round(width, 4), "サンプル数": ns,
            "再実行の上位3一致": np.mean(j), "同・最小": np.min(j),
            "再実行の第1位一致": np.mean(t1), "同・最小 ": np.min(t1),
            "参照との上位3一致": np.mean([jaccard(a[i][:TOPK], ref[i][:TOPK]) for i in n]),
            "参照との第1位一致": np.mean([a[i][0] == ref[i][0] for i in n]),
        })
        print(f"倍率={mult} サンプル数={ns} 完了", flush=True)

print(f"\n既定の kernel_width は {default_width:.4f} / 説明対象 {N_EXPLAIN} 行")
print(pd.DataFrame(rows).round(4).to_string(index=False))explain_allをシード1とシード2で2回呼び出す目的は、再現性の測定です。参照設定との一致だけを見ても、設定変更の影響と、その設定自体の揺れは区別できません。実際、倍率0.25は参照設定と異なるだけでなく、同じ設定で再実行した結果とも一致しにくい条件でした。
本文の表はIntel Xeon・Linux環境での測定値です。以下はApple M1・macOS・Python 3.11.15での再実行結果で、環境を変えても表の値が再現するかを確認しました。
実行結果
既定の kernel_width は 2.3717 / 説明対象 40 行
  倍率      幅  サンプル数  再実行の上位3一致   同・最小  再実行の第1位一致  同・最小   参照との上位3一致  参照との第1位一致
0.25 0.5929    500     0.3350 0.3225     0.2917  0.225     0.3525      0.200
0.25 0.5929   2000     0.4000 0.3300     0.3333  0.325     0.3950      0.450
0.50 1.1859    500     0.8125 0.7850     0.9000  0.825     0.8100      0.875
0.50 1.1859   2000     0.8917 0.8875     0.9750  0.950     0.9125      0.950
1.00 2.3717    500     1.0000 1.0000     0.9917  0.975     1.0000      1.000
1.00 2.3717   2000     1.0000 1.0000     1.0000  1.000     1.0000      1.000
2.00 4.7434    500     1.0000 1.0000     1.0000  1.000     1.0000      1.000
2.00 4.7434   2000     1.0000 1.0000     1.0000  1.000     1.0000      1.000
4.00 9.4868    500     1.0000 1.0000     1.0000  1.000     1.0000      1.000
4.00 9.4868   2000     1.0000 1.0000     1.0000  1.000     1.0000      1.000
上の表との照合結果は、10行60セルすべて一致。乱数シードを固定しているため、同じライブラリ構成なら手元でも同じ結果を確認できます。
確認はkernel_widthから始める
説明が実行ごとに変わる原因として、この実験で見つかったのは近傍の広さでした。既定幅なら、シードを変えても上位3本の顔ぶれは動きません。4分の1まで狭めると第1位が揃う割合は3割前後まで落ち、点の数を4倍にしても最小値はほとんど動きませんでした。
とはいえ、既定なら安全という読み替えはできません。既定幅は特徴量の本数で決まるので、本数が違えば同じ倍率でも挙動は変わりえます。連続値の離散化もオフで固定していて、既定のオンは測っていません。
次に知りたいのは、崩れ始める幅がどこにあるかです。今回は0.5倍と0.25倍の間に測定点を置いておらず、境界の位置は空いたままになっています。手元のデータで幅を動かす予定があるなら、その間を細かく刻んで一致率を取ると、この記事より先の答えが出ます。