
学習したモデルが何を見て予測しているのかを説明するとき、特徴量ごとの重要度を棒グラフにして、上位の列を報告することがあります。木モデルでよく使われるのがSHAPで、1件ごとの予測を特徴量の取り分へ分け、その平均で列を並べます。
ところが、同じモデルへ同じ計算部品(TreeExplainer)を渡しても、比較の基準になる背景データを一緒に渡すかどうかで内部の計算方法が切り替わります。出来上がった棒グラフに、その設定は表示されません。図だけを受け取った人には見えない差です。
設定の違いが効いてくるのは、似た情報を持つ列が並んでいる場合です。ある列を説明から外したときの埋め方がモードごとに違うので、寄与の配分も変わり得ます。ただ、仕様が違うと分かっても、上位の順位が実務でどれだけ動くのかまでは判断できません。
そこで、結果を作るのに使った列と使っていない列が最初から分かっている合成データを用意し、相関の強さを6段階に変えて2つのモードを同じLightGBMへ当てました。
先に結論: モードを変えても第1位は動かなかった
- TreeSHAPの2モードの差は、真の寄与がゼロの相関特徴への配分(合計1へ正規化した割合)で、5回平均どうしなら最大0.0034、1回ごとに突き合わせても最大0.0084。第1位は90回すべて真に効く
x1。 - 結果と無関係な3特徴へ、SHAPは合計8.7〜9.3%を配分。列を並べ替えて精度低下を測るPermutation Importanceでは、同じ3特徴からゼロと区別できる大きさを取り出せず。
- 相関を0から0.99へ強めると、寄与がゼロの相関特徴へのSHAP配分は約0.027から約0.042へ増加。ただし、真に効く特徴の順位を上回った試行はなし。
- SHAPはモデル内での使われ方、Permutation Importanceは列を崩したときの精度低下。特徴量を残すか判断するときは、この違いを分けて扱う。
- 測ったのは、加法・線形の合成データにLightGBMを1設定、500行を平均した全体重要度。1件ごとのSHAP値や交互作用は未検証。
SHAPと2つのモード、対照に置いた並べ替えが測るもの
必要な前提は、木モデルを一度学習してSHAPの棒グラフを出したことがある、くらいです。
SHAPは、1件の予測値を基準値と各特徴量の寄与へ分ける方法です。この記事では500件について寄与の絶対値を求め、その平均を合計1へ正規化した「全体の重要度」を比較します。正規化後の0.1は、5特徴へ配られた重要度のうち10%を占めたという意味で、予測精度が10%改善したという意味ではありません。
木モデル向けのTreeExplainerには、特徴量を説明から外した状態の作り方が2通りあります。tree_path_dependentは学習時に各枝を通ったデータ数で外した列を埋め、interventionalは渡した背景データの値で埋めます。背景データとは、説明対象の特徴量を外したときに、ほかの特徴量をどのような値で補うかを決める参照用のデータです。
対照に置いたPermutation Importanceはそのどちらでもなく、検証データと正解を使って1列だけを並べ替え、予測精度がどれだけ落ちるかを測ります。落ち幅の大きい列ほど重要と数える代わりに、その列が個々の予測へどう寄与したかは答えません。
3つに共通するのは、その列をデータから外して学習し直したときに精度がどう動くかまでは分からない点です。
shap.TreeExplainer(model)のように背景データを渡さない場合、shap 0.51.0ではautoを通じてtree_path_dependentが選ばれます。モード名は完成した棒グラフに自動表示されないため、コードや分析記録に残す必要があります。
正解が最初から分かるデータで、3つの手法を同じモデルへ当てた
特徴量は5本用意し、結果yをy = 3 * x1 + 雑音で生成しました。それぞれの役割は次のとおりです。
x1: 結果の生成に使う唯一の特徴量x2:x1とは相関するものの、結果の生成には使わない特徴量z1、z2、z3:x1とも結果とも無関係な特徴量
x2と3本のzは生成式に入っていないため、真の寄与はゼロです。x2へ付いた重要度は相関を通じた誤帰属、z1〜z3への配分は無関係な列をモデルが使った結果として採点できます。
x1とx2の相関を0、0.3、0.6、0.9、0.95、0.99へ変え、1条件あたり6,000件を生成しました。乱数を変えた5回の平均を表に載せています。相関6水準、5回、3手法で合計90回です。
SHAPは検証データの先頭500件、Permutation Importanceは検証データ全体の1,800件と5回の並べ替えを使いました。後者は偶然によって精度が改善した負の値をゼロへ切り捨ててから正規化しています。反復数や負値の処理で分母が変わるため、両手法の値を倍率で比較せず、配分の大きさと試行ごとのばらつきを見ます。
見込んでいたのは、相関を強めればモードによって結論が変わり、無関係な特徴に高い重要度が付く、という展開でした。
相関を0.99まで強めても、モードの違いは順位を動かさなかった
外れたのは、モードで結論が変わるという側です。真の寄与がゼロでx1との相関だけを持つx2について、2つのモードはほぼ同じ量の重要度を配ります。全90回で第1位はx1のまま変わっていません。
全体重要度の上位を報告する用途なら、モードの取り違えで結論がひっくり返る事態は、この条件では起きませんでした。それでも設定は記録に残します。棒グラフだけを見ても、どちらで計算したかは判別できないからです。
| 相関 | 既定(tree_path_dependent) | 介入(interventional) | 並べ替え |
|---|---|---|---|
| 0.00 | 0.0266 | 0.0268 | 0.0004 |
| 0.30 | 0.0287 | 0.0290 | 0.0004 |
| 0.60 | 0.0287 | 0.0299 | 0.0006 |
| 0.90 | 0.0285 | 0.0303 | 0.0010 |
| 0.95 | 0.0301 | 0.0334 | 0.0016 |
| 0.99 | 0.0419 | 0.0420 | 0.0038 |
2つのSHAPモードで最も差が開いたのは相関0.95で、丸め前の差は0.003387、表示上は0.0034です。相関0.99では0.0419と0.0420まで近づきました。平均で見るかぎり、モードの選択は小数第3位の話にとどまります。
平均が近くても、1回ごとの差が必ず小さいとは限りません。対応する30組の最大差は0.0084でした。相関0.99・乱数0の組で、tree_path_dependentが0.0516、interventionalが0.0431です。全体では26組で後者の配分が大きかった一方、4組では逆転しています。モードによる一定方向の差は見えるものの、1回の分析から安定した差として取り出せる大きさではありませんでした。
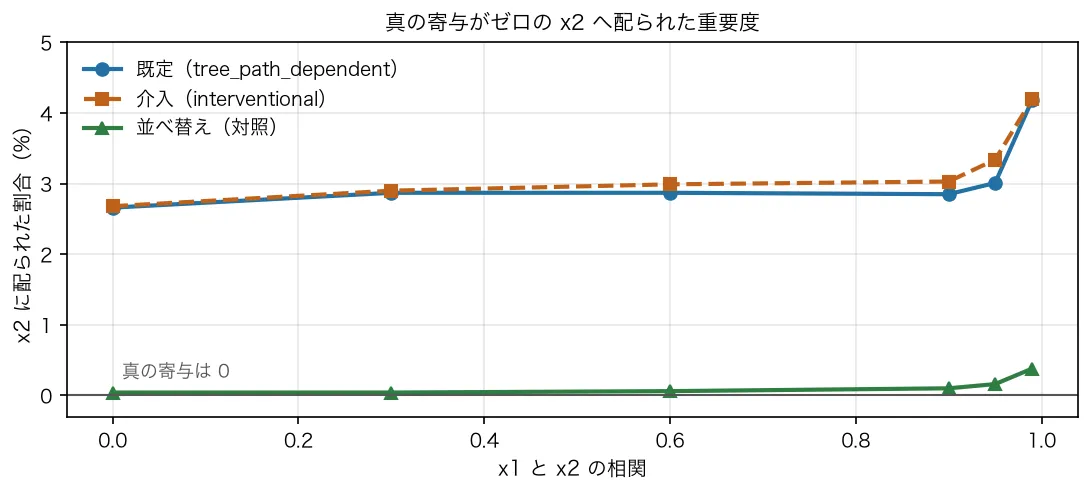
相関を強めると、x2へのSHAP配分は約0.027から約0.042へ増えました。ただし、真に効くx1への配分は約0.87あり、順位を脅かす水準には届いていません。モードの定義が違うことと、全体重要度の結論が変わることは別でした。 同じ相関水準で、曲線を読むPDPとALEがどう動くかはPDPとALEの比較で測っています。
表のPermutation Importanceは0.0004〜0.0038です。x2への配分に限ると、30回のうち6回は切り捨て後にちょうど0でした。並べ替えの側は、x2をほとんど拾っていません。
差が大きかったのは、モードの間ではなく手法の間
x1とも結果とも無関係なz1〜z3でも、2つのモードはやはり並びました。離れたのはSHAPとPermutation Importanceのほうです。SHAPは2モードともこの3列へ1割近くを配り、並べ替えはほぼゼロのまま動きません。
つまり、SHAPの下位に値が付いていても、それだけで「弱いながら予測に役立つ特徴」とは読めないということです。削除候補を探すなら、モデル内での使われ方を示すSHAPに加えて、その列を崩したときに精度が落ちるかを別に確認します。
| 手法 | 相関0 の x1 | 相関0.99 の x1 | 相関0 の z合計 | 相関0.99 の z合計 |
|---|---|---|---|---|
| 既定(tree_path_dependent) | 0.8858 | 0.8659 | 0.0876 | 0.0922 |
| 介入(interventional) | 0.8839 | 0.8651 | 0.0893 | 0.0928 |
| 並べ替え | 0.9991 | 0.9955 | 0.0005 | 0.0008 |
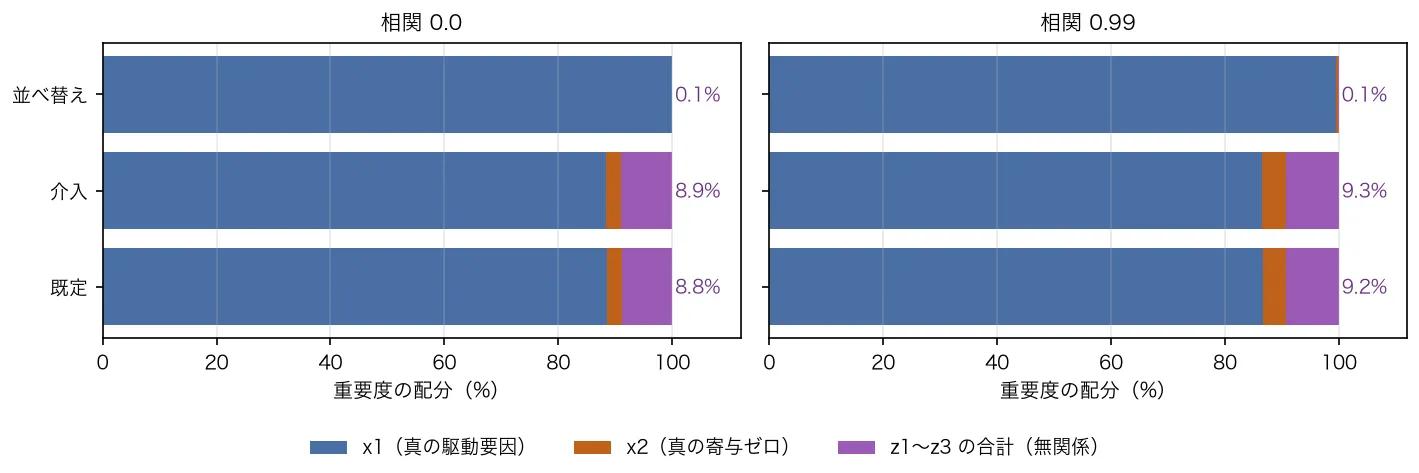
SHAPによる3特徴の合計配分は、相関6条件の平均で8.7〜9.3%、個別の60回でも7.91〜9.86%でした。一方、z合計に対するPermutation Importanceの条件平均は0.035〜0.076%ですが、個別の30回は0〜0.19%まで散らばり、うち3回はちょうど0でした。したがって後者は、小さい効果があるというより、この測定手順ではゼロと区別できる大きさを取り出せなかったと読みます。
3手法は同じ学習済みLightGBMへ適用しているため、この差はモデル性能の違いではありません。SHAPはモデルが分岐で使った特徴へ寄与を配ります。無関係な列でも木が分岐に使えば値が付きますが、その列を並べ替えても予測精度がほとんど落ちなければ、Permutation Importanceはゼロ付近に残ります。効果ゼロの列に配分が付くこと自体は、10列の合成データでSHAPを採点した正解つきデータでの検証でも観測されており、そちらでは効果ゼロの4列にXGBoostで全体の4.1%が配られました。
相関0におけるz合計の差は、2つのSHAPモード間で0.0016、interventionalとPermutation Importanceの間で0.0887でした。探していたモード差より、測っている問いの違う手法間の差のほうが大きい結果です。
手元のモデルで確認する順番
最初に決めるのは、説明したい単位です。 500件を平均した全体重要度を見たいのか、特定の1件を説明したいのかで話が変わります。この記事の結果を使えるのは前者だけです。
モードは図ではなく記録に残す。 背景データの有無、feature_perturbationの値、shapのバージョンを分析結果と一緒に控えておきます。棒グラフだけでは設定を判別できません。
相関する特徴量があるなら、2モードを同じデータで回して差を見ます。 全体重要度と順位を両方で計算し、乱数条件を変えても差が残るかを確かめる作業です。今回の5回平均で見た最大差0.0034を、一般的なしきい値にはしないでください。
残すか外すかの判断は、別の指標で取る。 Permutation Importanceや、その列を除いた再学習を使い、検証データ上の性能変化を測ります。
最後は言葉づかいです。SHAPの値は「モデル内で寄与が割り当てられた」と表現します。 「結果に効いている」「削除すると精度が落ちる」と説明するには、別の検証結果が要ります。
詳しい検証条件
ここからは、上の数値を自分で検算したい読者向けの細部です。
- LightGBMは木300本、学習率0.05、
n_jobs=1の1設定です。 interventionalには訓練データの先頭200件を渡しました。ただしIndependentマスカーの既定値max_samples=100により、実際に使われる背景は100件です。- 重要度は合計1へ正規化し、
x1、x2、z1〜z3の合計への配分と第1位の特徴を記録しました。 - テストデータの決定係数は、条件平均で0.8858〜0.8867でした。決定係数は予測が正解の変動をどれだけ再現したかを表す指標で、1に近いほど当たっています。
- 表示値は小数第4位まで丸め、差は丸める前の値から計算しています。
Permutation Importanceを対照として残す理由
2つのSHAPモードだけを計算すると、差0.0034が実務上大きいのか判断する物差しがありません。同じモデルへPermutation Importanceを適用することで、モード間の差と、測っている問いが異なる手法間の差を分けて比較できます。
適用範囲と限界
- 加法・線形の生成過程だけを試しています。 交互作用や非単調な関係がある場合に、2モードの差や順位がどう変わるかは未検証です。
- 背景データの条件は1通りです。 訓練データの先頭200件を渡し、shap内部で100件へ間引かれた条件だけを測りました。件数や選び方による変化は含みません。
- 真に効く特徴は
x1の1本です。 相関する有用な特徴が複数ある場合、Permutation Importanceが重要度を分け合う可能性があり、今回の読み方をそのまま適用できません。 - 500件を平均した全体重要度だけを比較しました。 全体順位が同じでも、特定の1件に対するSHAP値が一致するとは限りません。
- Permutation Importanceは1,800件、5反復です。 負値をゼロへ切り捨てているため、0.035〜0.076%を安定した効果量として扱えません。
- 特徴量5本、LightGBMの1設定に限った結果です。 特徴量数、正則化、木の深さが変われば、無関係な列への配分も変化する可能性があります。
2モードとPermutation Importanceを同じモデルへ当てるコード
次のコードは、相関を変えた合成データを入力としてLightGBMを学習し、2つのTreeSHAPモードとPermutation Importanceによる配分を出力します。実データ向けの汎用診断ではなく、本文の比較を再現するための実装です。
"""TreeSHAP の推定モードで重要度がどれだけ変わるかを、正解つきで採点する。

生成過程:
    x1 が唯一の真の駆動要因、y = 3*x1 + eps
    x2 = rho*x1 + ...  … x1 と相関するが y には一切使わない
    z1..z3            … 無関係
x2 の真の寄与はゼロなので、x2 に配られた重要度はすべて誤帰属になる。
実行: python sample_tsmode.py (所要 3 分程度)
"""

import numpy as np
import pandas as pd
import shap
from lightgbm import LGBMRegressor
from sklearn.inspection import permutation_importance
from sklearn.model_selection import train_test_split

RHOS = [0.0, 0.3, 0.6, 0.9, 0.95, 0.99]
SEEDS = [0, 1, 2, 3, 4]
N, BETA, N_EXPLAIN, N_BACKGROUND = 6000, 3.0, 500, 200
FEATURES = ["x1", "x2", "z1", "z2", "z3"]


def make_data(rho, seed):
    rng = np.random.default_rng(seed)
    x1 = rng.normal(size=N)
    x2 = rho * x1 + np.sqrt(max(1e-12, 1 - rho**2)) * rng.normal(size=N)
    X = pd.DataFrame(
        np.column_stack([x1, x2, rng.normal(size=(N, 3))]), columns=FEATURES)
    return X, BETA * x1 + rng.normal(0, 1.0, N)  # y に x2 は使わない


def share(vals):
    """特徴ごとの平均絶対寄与を、合計1に正規化した配分にする。"""
    v = np.asarray(vals, dtype=float)
    return v / v.sum() if v.sum() > 0 else v


rows = []
for rho in RHOS:
    for seed in SEEDS:
        X, y = make_data(rho, seed)
        Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=seed)
        model = LGBMRegressor(n_estimators=300, learning_rate=0.05, verbose=-1,
                              random_state=seed, n_jobs=1).fit(Xtr, ytr)
        Xe, bg = Xte.iloc[:N_EXPLAIN], Xtr.iloc[:N_BACKGROUND]

        # 木の通過数で条件付けする既定経路(背景データ不要)
        tpd = np.abs(shap.TreeExplainer(
            model, feature_perturbation="tree_path_dependent"
        ).shap_values(Xe)).mean(axis=0)

        # 背景データを使って介入的に周辺化する経路
        itv = np.abs(shap.TreeExplainer(
            model, data=bg, feature_perturbation="interventional"
        ).shap_values(Xe, check_additivity=False)).mean(axis=0)

        # SHAP ではない対照: 列を並べ替えて精度低下を見る
        pi = np.clip(permutation_importance(
            model, Xte, yte, n_repeats=5, random_state=seed, n_jobs=1
        ).importances_mean, 0, None)

        for mode, vals in [("tree_path_dependent", tpd),
                           ("interventional", itv), ("permutation", pi)]:
            sh = share(vals)
            rows.append({
                "手法": mode, "rho": rho,
                "x1への配分": sh[0],
                "x2への配分(誤帰属)": sh[1],   # 真の寄与はゼロ
                "z合計への配分": sh[2:].sum(),
                "第1位がx2": FEATURES[int(np.argmax(sh))] == "x2",
            })
    print(f"rho={rho} 完了", flush=True)

print("\nx2 と z1..z3 の真の寄与はいずれもゼロ / シード5本の平均")
print(pd.DataFrame(rows).groupby(["手法", "rho"]).mean(numeric_only=True)
.round(4).to_string())check_additivity=Falseは、介入モードで加法性の検査を止める指定です。この実験では予防的に設定しており、寄与の計算値自体は変えません。
背景データの200件は、実際には100件へ間引かれる
N_BACKGROUND = 200と書いていますが、shap 0.51.0は渡されたDataFrameをIndependentマスカーで扱い、既定のmax_samples=100に合わせて100件へ間引きます。200件すべてを使う場合は、data=shap.maskers.Independent(bg, max_samples=200)のように件数を明示します。本文の実測値は既定の100件によるものです。この間引きはSHAPを正解つきデータで採点した検証でも実効件数を記録して確認しており、そちらでは250〜4,000件のどれを渡しても100件になりました。
このコードを実行したときの出力
本文の表はIntel XeonとLinuxによる実測です。次の出力はApple M1、macOS、Python 3.11.15で再実行し、平均値が一致することを確認した結果です。
実行結果
x2 と z1..z3 の真の寄与はいずれもゼロ / シード5本の平均
                          x1への配分  x2への配分(誤帰属)  z合計への配分  第1位がx2
手法                  rho
interventional      0.00  0.8839       0.0268   0.0893     0.0
                    0.30  0.8825       0.0290   0.0885     0.0
                    0.60  0.8819       0.0299   0.0882     0.0
                    0.90  0.8800       0.0303   0.0896     0.0
                    0.95  0.8770       0.0334   0.0895     0.0
                    0.99  0.8651       0.0420   0.0928     0.0
permutation         0.00  0.9991       0.0004   0.0005     0.0
                    0.30  0.9991       0.0004   0.0005     0.0
                    0.60  0.9991       0.0006   0.0004     0.0
                    0.90  0.9984       0.0010   0.0006     0.0
                    0.95  0.9977       0.0016   0.0006     0.0
                    0.99  0.9955       0.0038   0.0008     0.0
tree_path_dependent 0.00  0.8858       0.0266   0.0876     0.0
                    0.30  0.8841       0.0287   0.0872     0.0
                    0.60  0.8841       0.0287   0.0872     0.0
                    0.90  0.8828       0.0285   0.0887     0.0
                    0.95  0.8809       0.0301   0.0890     0.0
0.99 0.8659 0.0419 0.0922 0.0右端の列がすべて0なので、x2が第1位になった条件が90回中1つも無かったことも同じ出力から読めます。本文の2つの表に載せた平均値も、この出力の値です。
相関0.99・乱数0の0.0516と0.0431は、平均前の90行から取得した値です。試行ごとの結果を確認する場合は、最後の集計を行わずpd.DataFrame(rows)を表示します。
まとめ: SHAPの値と予測上の価値を分けて読む
全体のSHAP重要度を比べたこの条件では、tree_path_dependentとinterventionalのどちらを使っても第1位の特徴は同じでした。モードの選択より効いたのは、SHAPとPermutation Importanceが同じ「重要度」という名前で別の問いを測っていることのほうです。SHAPの値は、その特徴量を削除しても精度が落ちることを保証しません。 今回は結果と無関係な3列にも1割近くが配られました。
特徴量を残すか、外部へどう説明するかを決める場面では、「モデル内で寄与が付いた」と「検証データ上で予測に役立った」を分けて書きます。モードは自分のデータで順位と配分の差を測ってから選び、設定を分析記録へ残します。予測上の価値まで確かめるなら、Permutation Importanceや列を除いた再学習を足して、性能の変化を別に評価するのが次の作業です。