
表形式のデータで分類モデルを作るとき、最初に決めかねるのがライブラリ選びです。XGBoost、LightGBM、CatBoostはどれも定番として並んで紹介されるので、とりあえず1つ動かしてはみるものの、残りの2つなら精度が上がったのではないかという引っかかりは消えません。
3つを同じ条件で回してみると、答えは手元のデータが何件あるかで変わりました。数百件では差がはっきり出るのに、数万件まで増やすと精度はほとんど並びます。一方で、1回の学習にかかる時間の差は最後まで縮みませんでした。
そこで、3ライブラリを同じ条件に揃え、データ量をデータセットごとに最大4段階まで変えて比べました。精度はROC-AUCで測っています。正例を負例より上位に並べられる度合いを0から1で表す指標で、0.5付近ならランダム相当、1に近いほど正しく順位づけできています。確かめたかったのは、既定設定(パラメータを何も指定しない初期状態)での精度差が規模でどう動くか、そしてその差が学習時間に見合うかです。
先に結論
二値分類3データセット・計10条件では、既定設定の精度はCatBoostが最も高く、学習はXGBoost・LightGBMが速い結果でした。選び方は、データ規模と学習を繰り返す回数で変わります。
| 手元の条件 | 最初に試す候補 | 今回の比較で分かったこと |
|---|---|---|
| 数万件規模で、精度と速度を両立したい | LightGBM | adult全件ではCatBoostとのROC-AUC差が0.0013まで縮んだ |
| 2,000件までで、精度を優先したい | CatBoostも比較 | 2位との差が+0.009以上残った |
| 交差検証やチューニングで何度も学習する | LightGBM・XGBoost | CatBoostの学習時間は最速ライブラリの16〜40倍だった |
これは今回のデータとCPU環境での比較です。生のカテゴリ変数が多い場合やGPUでの学習、回帰タスクには同じ順位を当てはめられません。
GBDTの3実装は、どこが違うのか
今回の3つは、いずれもGBDT(勾配ブースティング決定木)の実装です。浅い決定木を「前の木の間違いを次の木が補う」形で順に足していく手法で、表形式のデータでは定番の選択肢になっています。
違うのは設計の重心です。XGBoostは長く使われてきた定番、LightGBMは速さ重視の軽量な実装、CatBoostはカテゴリ変数の扱いに強い後発です。同じ手法の実装でも、木を何本組むかといった初期値が揃っていないので、既定設定のまま使えば結果も揃いません。
パラメータの探索にはOptuna(少ない試行で良いパラメータを効率よく探すライブラリ)を使いました。本文で「軽いチューニング」と書いているのは、この探索を30試行だけ回した状態を指します。
3データセットを最大4段階の規模で比べた
使ったのは、性格の異なる実データ由来の2値分類3種です。adultは国勢調査から年収5万ドル超かを当てるデータ、magicはガンマ線か背景ノイズかを見分ける望遠鏡の観測データ、creditはドイツの与信審査で優良客かを判定するデータで、いずれもpmlb(公開データセットをまとめた配布リポジトリ)から取得しました。件数も説明変数の数も揃っていないので、規模の違いだけでなくデータの性格の違いも一緒に見ることになります。
| データセット | 件数 | 説明変数 | 少数派クラス |
|---|---|---|---|
| adult | 48,842 | 14 | 23.9% |
| magic | 19,020 | 10 | 35.2% |
| credit | 1,000 | 20 | 30.0% |
adultとmagicは500件・2,000件・8,000件・全件の4規模で測りました。creditは全体が1,000件しかないため、500件と全件の2規模だけです。合計10条件になります。それぞれの条件で「既定設定のまま」と「軽くチューニングした後」の2通りを回し、ROC-AUCと1回の学習にかかる秒数を記録しました。
今回のデータはおおむね数値化済みなので、生のカテゴリ変数が多いデータでCatBoostのカテゴリ対応がどこまで効くかは測れていません。分割やシードの決め方、検定の扱いといった条件は、記事の後半にまとめました。
CatBoostの精度差は規模とともに縮んだ
既定設定の精度はCatBoostが最高、だが差は規模で縮む
同じデータを渡しても、3ライブラリの成績は最初から並びません。既定設定のCatBoostは10条件すべてで首位でした。ただしその強さは、データが小さいほど効くという条件つきです。
データを集める余地があるなら、既定精度だけを理由にCatBoostを選ぶ根拠は薄れていきます。
| データ(規模) | CatBoost | LightGBM | XGBoost | 2位との差 |
|---|---|---|---|---|
| adult 500件 | 0.8836 | 0.8598 | 0.8533 | +0.0238 |
| adult 2,000件 | 0.9046 | 0.8932 | 0.8899 | +0.0114 |
| adult 8,000件 | 0.9183 | 0.9159 | 0.9113 | +0.0023 |
| adult 全件(48,842) | 0.9290 | 0.9290 | 0.9277 | +0.0000 |
| magic 500件 | 0.8920 | 0.8817 | 0.8778 | +0.0102 |
| magic 2,000件 | 0.9165 | 0.9074 | 0.9052 | +0.0092 |
| magic 8,000件 | 0.9328 | 0.9282 | 0.9249 | +0.0047 |
| magic 全件(19,020) | 0.9410 | 0.9361 | 0.9350 | +0.0049 |
| credit 500件 | 0.7923 | 0.7707 | 0.7651 | +0.0216 |
| credit 全件(1,000) | 0.8014 | 0.7795 | 0.7766 | +0.0219 |
縮み方はadultではっきり出ました。CatBoostとXGBoostのROC-AUC差は、500件で+0.0303、8,000件で+0.0070、全件で+0.0013です。つまりadultの全件では、ライブラリを替えて得られる精度は0.002を切ります。この幅が実務上重要かどうかは、誤判定のコストや予測件数によって変わります。
magicも向きは同じで、500件の+0.0142が全件で+0.0060まで縮みました。adult全件ではLightGBMとの明確な差を確認できず、表示した4桁では同じ値になっています。
creditは事情が違います。全件でも1,000件どまりで、そこまで増やせません。この規模ではCatBoostとXGBoostの差が縮み切らず、+0.025前後が残りました。
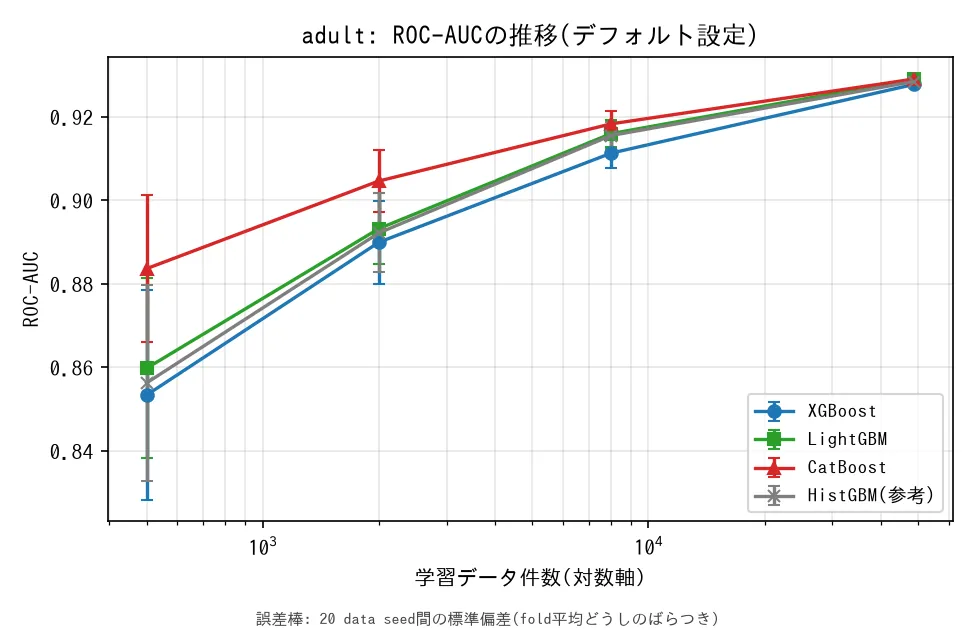
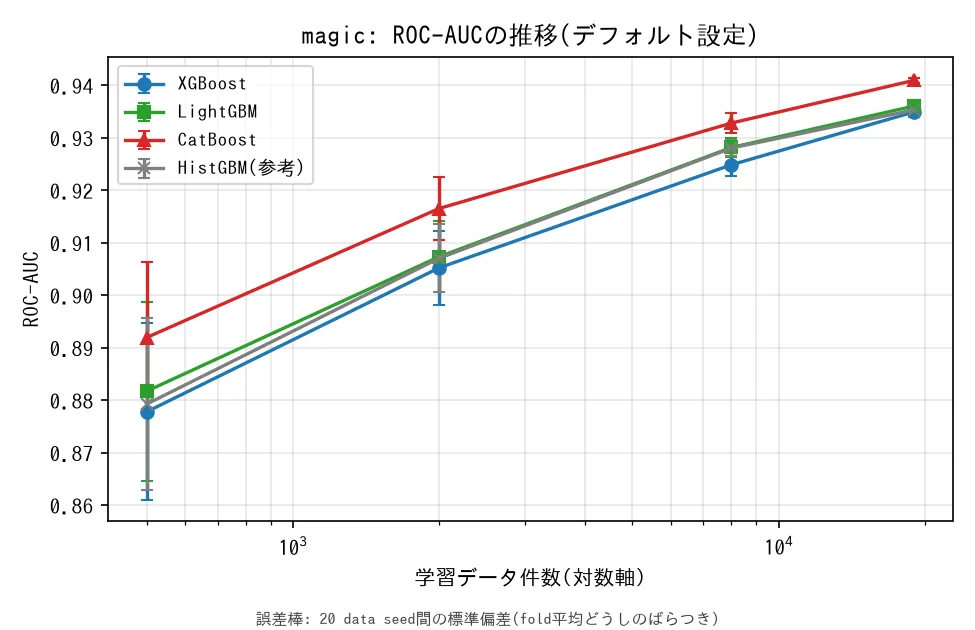
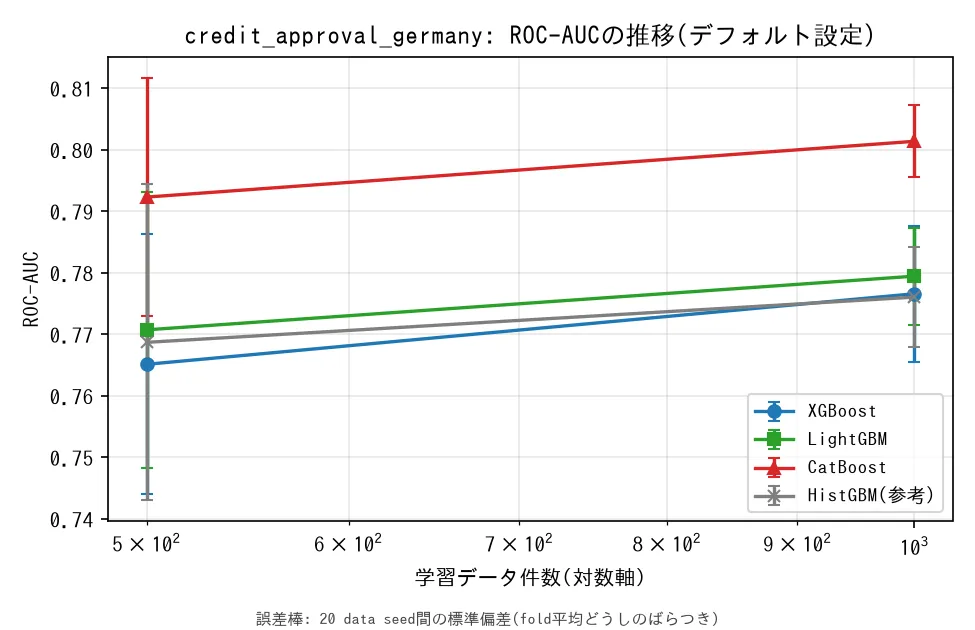
図でも、adultとmagicは全件に向けて3本の線が寄っていくのに対し、creditの2点は開いたままです。
軽いチューニングで開きは縮むが、CatBoost優位が消える規模はデータで違う
3つのパラメータを30試行だけ探索すると、3ライブラリのROC-AUCの開き(最大値と最小値の差)は10条件すべてで既定設定より縮みました。ただし、CatBoostの首位が消えるかどうかはデータセットで分かれます。数百件から数千件のデータを扱うなら、この節を「チューニングすればどれでも同じ」と読まないでください。
いちばん分かりやすいのがadult全件です。既定ではCatBoostが首位でしたが、チューニング後はXGBoost(0.9298)とLightGBM(0.9293)がCatBoost(0.9288)をわずかに上回りました。差はROC-AUCで0.001前後。この差は確認できましたが、今回の比較では、ライブラリ選定を左右するほどの大差ではありません。
順位まで入れ替わったのは、adultの8,000件と全件だけです。統計的に割り引いてもCatBoostの首位が残った条件は、10通り中6つありました。首位が消える規模もデータセットで違い、adultは2,000件(開き0.0015)で3ライブラリの明確な差を確認できなくなる一方、magicは8,000件でも残り、消えたのは全件の19,020件(0.0005)でした。1,000件どまりのcreditは、500件でも全件でも残ったままです。件数だけで線は引けません。
読み飛ばし可: チューニング後もCatBoostの首位が残った6条件の内訳
500件の3条件では開きがadult 0.0181・magic 0.0101・credit 0.0201で、CatBoostの値はadult 0.8861/magic 0.8889/credit 0.7932。既定設定での開き0.0142〜0.0303が0.0101〜0.0201までしか縮んでいません。1,000件以上でも残る条件はあり、magic 2,000件は0.0077、credit全件(1,000件)は0.0063、magic 8,000件は0.0021の開きで、どれもCatBoostが上でした。
探索空間の非対称を疑って再検証
気になったのはCatBoost側です。チューニングでかえって値が下がったセルが10通り中6つありました。ここで疑ったのが共通探索空間の木の本数上限(300)です。CatBoostは既定で1000本使う設計なので、上限300は本来より短く刈り込んでいることになります。これでは公平ではないかもしれません。そこでadult全件について、CatBoostだけ上限を1000まで広げて探索し直しました。
結果はあっけないものでした。選ばれた本数が855本になってもROC-AUCは0.9288から0.9289へほとんど動かず、既定の0.9290にも届きません。少なくともこのセルでは、上限300がCatBoostの足を引っ張った主因ではなさそうです。ただし確認したのはadult全件だけで、他の低下セルは検証していません。
チューニングのコストにも差が出ます。adult全件で30試行を回すのにかかった時間は、XGBoostが約63秒、LightGBMが約55秒に対し、CatBoostは約179秒。探索そのものもCatBoostが重いので、何度も回すなら効いてきます。
学習時間はCatBoostが一貫して最も遅い
精度の差は規模で縮みました。学習時間の差は縮みません。既定設定のCatBoostは10通りすべてで最も遅く、最速のライブラリと比べて16〜40倍かかりました。
| データ(規模) | CatBoost | LightGBM | XGBoost | CatBoost/最速 |
|---|---|---|---|---|
| adult 500件 | 0.938秒 | 0.047秒 | 0.031秒 | 30倍 |
| adult 2,000件 | 1.196秒 | 0.076秒 | 0.047秒 | 25倍 |
| adult 8,000件 | 2.185秒 | 0.099秒 | 0.079秒 | 28倍 |
| adult 全件(48,842) | 6.255秒 | 0.266秒 | 0.231秒 | 27倍 |
| magic 500件 | 1.471秒 | 0.037秒 | 0.066秒 | 40倍 |
| magic 2,000件 | 1.944秒 | 0.094秒 | 0.106秒 | 21倍 |
| magic 8,000件 | 3.205秒 | 0.119秒 | 0.147秒 | 27倍 |
| magic 全件(19,020) | 4.721秒 | 0.152秒 | 0.196秒 | 31倍 |
| credit 500件 | 0.863秒 | 0.047秒 | 0.048秒 | 18倍 |
| credit 全件(1,000) | 0.882秒 | 0.093秒 | 0.056秒 | 16倍 |
CatBoostの既定は木を1000本組む設計です。他の2つが数十〜100本前後で済ませるのに対して手数が多く、これが絶対時間の差に効いていると見られます。規模を上げても倍率は詰まらず、絶対差はむしろ開きました。
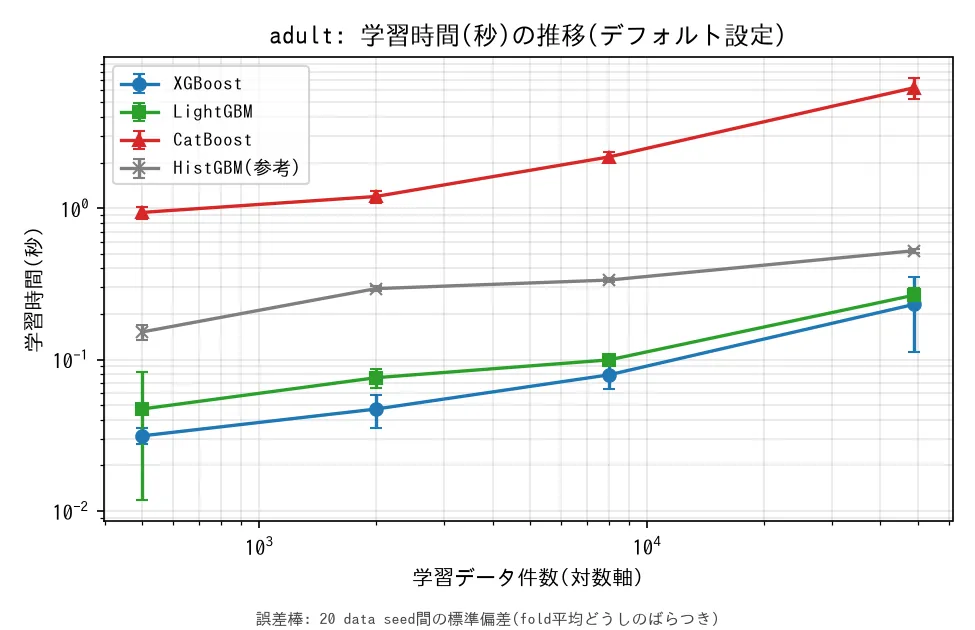
この差は、1回だけなら大きな問題にならないこともあります。効いてくるのは、交差検証(データを分けて学習と評価を何度も繰り返す手続き)やチューニングで、学習を数十回積み上げるときです。精度がほぼ並ぶ領域で速いライブラリを選べば、同じ計算時間でより多くの試行を回せます。
予測が最も割れた1件では、CatBoostだけが正答した
平均のROC-AUCは、どのケースで3ライブラリの判断が食い違うかまでは映しません。creditの全件・既定設定で、3ライブラリの予測確率が最も大きく割れた検証サンプルを1件だけ取り出しました。正解はクラス0のサンプルです。
断っておくと、これは差が最大だった1件であり、一般的な予測傾向を代表する例ではありません。XGBoostはこのサンプルでクラス1の確率を0.933と高く見積もって誤答、LightGBMも0.561で誤答、CatBoostだけが0.345にとどめて正答しました。1,000件しかない小さなデータで、CatBoostの既定が他の2つより手堅く出た一例で、creditで既定差が縮まなかった傾向と方向が揃います。
規模が小さければCatBoost、反復が多ければLightGBMから試す
最初の候補にはLightGBMを置きます。数万件まで増えた条件ではCatBoostとの精度差が0.005以下まで詰まり、学習は一貫して最速級でした。ただし、答えは「常にLightGBM」ではありません。
2,000件までで精度を優先するなら、CatBoostも試します。1,000件どまりのcreditでは既定差の+0.025が残りました。その代わり、学習時間は前節のとおり最速ライブラリの16〜40倍になります。
データ量が多く、交差検証やチューニングで何度も学習するなら、XGBoostかLightGBMへ寄ります。数万件まで増えると既定の精度差はほぼ消える一方、学習時間の差は残りました。最終的には、手元のデータで精度差と反復にかかる総時間を並べて決めます。
ここで比べているのは精度と学習時間だけです。ライブラリを決めた後に特徴量を足す工夫がどれだけ効くかは、特徴量エンジニアリング5手法のablationで測りました。今回と同じadultでは、定番の変換を全部盛りにしてもROC-AUCが±0.0000のまま、特徴量数と学習時間だけが数倍に増えています。
件数や金額の回帰で迷っている場合は、ライブラリの比較とは別にLightGBMのPoisson・Tweedie・二乗誤差の比較で目的関数の選び方を整理しています。
詳しい検証条件
3ライブラリともスレッド数は4に固定しました。既定設定はコンストラクタの初期値のみを使い、指定したのはスレッド数と乱数シード、それにログ出力を抑える設定です。
数値はすべて、実際に実行して保存したログを集計したものです。独立単位はデータ分割のシードで、20個(42〜61)ぶんの5分割交差検証(計100分割)の平均を、各データ×規模×ライブラリ×設定のセルごとに取りました。
統計的に割り引いても残った差は「差を確認できた」、割り引くと消える差は「明確な差を確認できなかった」と書いています(「差がない」と証明したわけではありません)。いずれもROC-AUCの実数値を添えて読んでください。
読み飛ばし可: 統計手法・探索空間・チューニングの注意点・取得元
- 検定はWilcoxon符号順位検定(対応あり)。多重比較はBonferroni補正(実施した60比較を家族としてalpha=0.05/60)を主報告とし、Holm法も併算しました。ブートストラップCI(B=10,000、seed=42)は「評価サンプルに対する推定の不確実性」であって実行時間のばらつきではありません。60比較中41比較(Holm法では44比較)で補正後も差が残りました。n=20では符号が一貫していれば僅差でも有意になりうるので、判定は必ず効果量と併せて読んでください。
- チューニングはOptunaで30試行、learning_rate: [0.01, 0.3](対数一様)、木の深さ: [3, 8]、木の本数: [50, 300] の3軸を3ライブラリ共通の範囲で探索しました。木の本数の上限300はCatBoostの既定(1000)より小さく、CatBoostにやや不利に働いた可能性があります(本文の該当箇所で再検証しています)。
- 全件規模ではチューニング用の抜き出しが全行と一致するため、探索と最終評価が同じデータプールを見ています。このため「チューニング後 − 既定」の改善幅には楽観方向のバイアスが乗りうる点に注意してください。3ライブラリには同じ評価手順を適用していますが、バイアスの大きさまで揃っている保証はないため、チューニング後の相対比較も参考値として扱ってください。
- 参考枠としてsklearn同梱のHistGBMも測っています。スレッド数を明示固定して既定設定のみ再計測し、ROC-AUCは固定前後で完全一致で、主結果に影響はありません。
- データはpmlb(コミット
7c1f4bdc)から取得。取得元のコミットは固定し、取得時の来歴も実行ログに残しています。
適用範囲と限界
- 適用範囲: 数値化済みの実データ由来2値分類、500件〜約5万件の範囲での傾向です。生のカテゴリ変数が多いデータや超高次元・強い非線形のデータは範囲外で、CatBoostのカテゴリ対応の効果もそこでは変わりえます。
- チューニングは3軸・30試行の軽い探索に限った話です。木の本数上限(300)はCatBoostの既定より小さく、頑健性の確認はadult全件の1セルだけなので、CatBoostのチューニング後の値は探索範囲を広げれば動く余地があります。
- 全件規模の「チューニング後 − 既定」の改善幅は、探索と評価が同じデータプールを見るぶん楽観方向に振れている可能性があります。3ライブラリに同じ手順を当てているとはいえ、振れ幅まで揃っている保証はないので、チューニング後の順位は参考値として扱ってください。
- 測っていない条件が2つあります。GPU学習は対象外で、今回はCPUのみです。HistGBMは既定設定の参考値だけを測っているため、チューニング後の3ライブラリとは比較できません。
- 予測の根拠を特徴量ごとに読みたい場合や、少数派が極端に少ないデータでは、ライブラリの選択より前に決めることがあります。EBMとLightGBMを比べた検証では実データ3件のROC-AUCの差がいずれも0.012以下、不均衡データの対策を比べた検証では無処置のLightGBMが実データで一度も負けませんでした。
- 評価そのものが甘く出る経路は別に整理しています。データリーク5パターンを測った検証では、分割前のSMOTEで交差検証のスコアが独立ホールドアウトより+0.24高く出ました。
サンプル実装
同じデータを3ライブラリに渡し、既定設定と軽いチューニング(Optuna)のそれぞれでROC-AUCと学習時間を測る実装です。実験と条件をそろえてスレッド数だけ4に固定しています。scikit-learn同梱の乳がん診断データ(569件)を使うので、取得なしでそのまま動きます。load_breast_cancer の行を差し替えれば、手元のデータで同じ比較ができます。チューニングまで要らなければ、末尾のループの後ろ3行を消すと既定設定だけの比較になります。
"""既定設定と、軽いチューニング(Optuna)を比較する完全版デモ。"""
import time
import optuna
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, StratifiedKFold, cross_val_score
from sklearn.metrics import roc_auc_score
from xgboost import XGBClassifier
from lightgbm import LGBMClassifier
from catboost import CatBoostClassifier

optuna.logging.set_verbosity(optuna.logging.WARNING)

# ここを自分のデータ(特徴量X・ラベルy)に差し替えれば、そのまま同じ比較ができる
X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=42
)

# 既定設定(コンストラクタのデフォルト値のみ)
DEFAULTS = {
    "XGBoost": lambda: XGBClassifier(n_jobs=4, random_state=42),
    "LightGBM": lambda: LGBMClassifier(n_jobs=4, random_state=42, verbose=-1),
    "CatBoost": lambda: CatBoostClassifier(thread_count=4, random_state=42, verbose=False),
}

# 実験と同じ3軸(学習率・木の深さ相当・木の本数相当)の探索空間
TUNED_BUILDERS = {
    "XGBoost": lambda lr, depth, n: XGBClassifier(
        learning_rate=lr, max_depth=depth, n_estimators=n, n_jobs=4, random_state=42
    ),
    "LightGBM": lambda lr, depth, n: LGBMClassifier(
        learning_rate=lr, max_depth=depth, n_estimators=n, n_jobs=4, random_state=42, verbose=-1
    ),
    "CatBoost": lambda lr, depth, n: CatBoostClassifier(
        learning_rate=lr, depth=depth, n_estimators=n, thread_count=4, random_state=42, verbose=False
    ),
}


def tune(name, n_trials=30):
    # learning_rate: 0.01〜0.3(対数一様)、木の深さ相当: 3〜8、木の本数相当: 50〜300
    def objective(trial):
        lr = trial.suggest_float("learning_rate", 0.01, 0.3, log=True)
        depth = trial.suggest_int("max_depth", 3, 8)
        n_estimators = trial.suggest_int("n_estimators", 50, 300)
        model = TUNED_BUILDERS[name](lr, depth, n_estimators)
        cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
        scores = cross_val_score(model, X_train, y_train, cv=cv, scoring="roc_auc")
        return scores.mean()

    study = optuna.create_study(direction="maximize", sampler=optuna.samplers.TPESampler(seed=42))
    study.optimize(objective, n_trials=n_trials)
    return study.best_params


def evaluate(model, name, label):
    start = time.perf_counter()
    model.fit(X_train, y_train)
    elapsed = time.perf_counter() - start
    proba = model.predict_proba(X_test)[:, 1]
    auc = roc_auc_score(y_test, proba)
    print(f"{name} ({label}): ROC-AUC={auc:.4f}  学習時間={elapsed:.3f}秒")


for name in DEFAULTS:
    evaluate(DEFAULTS[name](), name, "default")
    best = tune(name)
    tuned_model = TUNED_BUILDERS[name](best["learning_rate"], best["max_depth"], best["n_estimators"])
evaluate(tuned_model, name, "tuned")実行手順: 上のコードを quickstart_gbdt.py として保存し、必要なライブラリを入れて実行します。
pip install xgboost==3.2.0 lightgbm==4.7.0 catboost==1.2.10 scikit-learn==1.9.0 optuna==4.9.0
python quickstart_gbdt.py
このデータは本文の3データセットとは別の小さな参考データなので、絶対値や順位は本文の結果と一致しない場合があります。
今回の判断
どのライブラリが強いかという問いには、手元のデータが何件あるかを添えないと答えられません。既定設定のCatBoostは10条件すべてで首位でしたが、数万件まで増やすと2位との差は表示した4桁で消えました。adult全件では、軽いチューニング後にXGBoostとLightGBMがわずかに上回っています。学習時間の差だけは、規模を上げても縮んでいません。
この結果なら、小さなデータで1回の精度を詰めるときはCatBoost、大きなデータで学習を繰り返すときはLightGBMかXGBoostを先に試します。引っかかったままなのはチューニングの効き方で、CatBoostは10通り中6つのセルで既定設定より値が下がりました。木の本数の上限を広げても戻らなかったので、探索空間の設計だけでは説明しきれていません。確認できたのはadult全件の1セルだけなので、次に測るなら残りの低下セルからです。
そして、生のカテゴリ変数が多いデータは今回の範囲外です。そこではCatBoostのネイティブなカテゴリ対応を含めて測り直す必要があります。