
モデルを学習して特徴量重要度の棒グラフを出すと、似た動きをする列がそろって上位に並ぶことがあります。片方が増えるともう片方も増えます。相関した2列です。この図だけでは、片方を消してよいのか、2列をまとめて1つとして読むべきなのか、値の小さいほうを捨ててよいのかは決まりません。
よく紹介されるのは、「相関が強いと、並べ替えて測るPermutation Importance(以降PFI。ある1列の値をシャッフルして、予測精度がどれだけ落ちるかを見る方法)は重要度を低く見積もる」という説明です。対処として挙がるのが、その列を外してモデルを学習し直すdrop-columnになります。
ただ、この2つは同じ問いに答えていません。PFIは「今のモデルがその列を使えなくなると、精度がどれだけ落ちるか」、drop-columnは「その列なしで最初から学習しても、同じ精度に届くか」を測ります。代わりになる列があるなら、後者の値が小さく出るのは自然です。厄介なのは、実データに各列の本当の寄与が書かれていないことでした。どちらを信じるかを採点できません。そこで、正解を計算できる合成データを作り、相関を0から0.999まで動かしました。真の第1位を先に手放したのは、対処として勧められるdrop-columnのほうです。
先に結論: 先に崩れたのはdrop-columnの側
- データを作った式での寄与を正解に採ると、真の第1位を先に見失ったのはdrop-columnのほうだった。 LightGBMでは相関0.8で、drop-columnが10回すべて1位を外し、PFIは10回とも1位を保った。
- 列を外して学習し直すdrop-columnの値が小さくても、その列が予測に不要とは限らない。相関する代役が残っていれば、値が小さくなるのは定義どおりの挙動。
- 相関下でPFIが手放したのは、2列への配り方の安定性。 ペア全体の重要度は残った。真の寄与が等しい設定の相関0.99では、片方の配分がデータの生成し直しで10倍近く振れた。
- 相関ペアをまとめて並べ替えるグループ順列は重要度を回復できたが、自動グループ化が相関0.8のペアを束ねられたのは10回中1回。
- 測ったのは回帰の合成データ、相関ペア1組、ランダムフォレストとLightGBM、各条件10回ずつ。分類や実データで同じ境界になるかは未検証。
前提と、3つの測り方が答えている問い
想定しているのは、木のモデルを学習して重要度の棒グラフまでは出せる段階の読者です。並べ替えの内部計算やSHAPの理論には踏み込まないので、出てきた値の読み方だけを追ってもらえれば足ります。
精度の指標は決定係数(R²)です。予測が実際の値をどの程度説明できたかを表します。列を並べ替えたり外したりした後のR²の低下量を、この記事では重要度と呼びます。
3つの方法はいずれも予測精度の変化を利用しますが、入力に加える操作が違えば、答えている問いも違います。
| 方法 | 入力に加える操作 | 値から分かること | 値だけでは分からないこと |
|---|---|---|---|
| PFI | 学習済みモデルへ渡す1列を並べ替える | 現在のモデルがその列を使えないときの精度低下 | 代役になる列を含むペア全体の寄与 |
| drop-column | 1列を除いてモデルを学習し直す | その列なしで同等のモデルを作れるか | 既存モデルがその列をどれだけ使っているか |
| グループ順列 | 相関する列をまとめて並べ替える | ペアやグループ全体を使えないときの精度低下 | グループ内の各列への配分 |
比較には、学習済みの木から直接取り出す「モデル内蔵の重要度」と、予測値を特徴量ごとの寄与へ分けるSHAPも加えました。前者は木の分岐が誤差をどれだけ減らしたかを集計した値、後者は各予測に対する寄与の絶対値を平均したものです。どちらもPFIの代替策として優劣を競わせる目的では使いません。狙いは、相関した列への値の配り方を比べることです。
本文の「配分」は、8列に付いた重要度を合計1に直したときの取り分です。配分0.5なら、全体の半分がその列に割り当てられたことになります。あわせて、各条件はデータもモデルも10回作り直して測りました。本文の「10回中◯回」はこの回数で、乱数条件(seed)を変えたときに結果がどれだけ動くかを表します。
正解が分かる合成データで、相関だけを動かした
特徴量はx0からx7までの8列です。相関させるのはx0とx1だけになります。相関0なら2列はほぼ別々に動き、1に近づくほど同じように動きます。目的変数はx0、x2、x3と、x4の二次項から作り、x5からx7は結果へ影響しない列にしました。各条件で学習用2,000件、テスト用1,000件を生成しています。
相関による影響を切り分けるため、2種類の設定を用意しました。
| 設定 | 相関するx0とx1 | 比較の狙い |
|---|---|---|
| シナリオA | x0だけが結果へ影響し、x1の効果は0 | 効果のない代役があると、真の第1位を見失うか |
| シナリオB | x0とx1の寄与が等しく、無相関のx2も同じ寄与 | 同じ寄与を持つ3列への配分が、相関だけで変わるか |
正解には、データ生成式の各項が目的変数をどれだけ変動させるかを使います。シナリオAではx0が9.0、x2が4.0、x4が2.0、x3が1.44で、残る4列は0です。どれもモデルの出力とは無関係で、データを作る段階で設定した影響の大きさを指します。相関を変えても各列に設定した効果は動かないため、どの水準でも同じ正解で採点できます。
ランダムフォレストとLightGBMを使い、シナリオAでは相関7水準、シナリオBでは4水準を設定しました。当初は上端を0.99までと考えていましたが、規模を決めるための試し打ちで相関0.95のPFIが無傷だったため、本計測を始める前に0.999を足しています。壊れる点まで見ておきたかったからです。
学習済みモデルとは別に、データ生成式そのものへPFIを適用した対照も走らせました。この対照が安定していれば、配分を動かした原因を並べ替えの手続きから切り離し、相関列を代役として学習したモデル側にあると切り分けられます。
正解の置き方や正規化の詳しい条件は、記事後半の「詳しい検証条件」に分けて置きました。
相関を強めたとき、先に順位を崩したのはdrop-columnでした
真の第1位を手放す順番が、予想と逆だった
相関を強めていくと、真の第1位であるx0を1位に置けない手法が出てきます。先に脱落したのはdrop-columnでした。PFIのほうは、かなり強い相関まで1位を保っています。相関があるとPFIの順位は当てにならない、という向きの結果にはなっていません。
相関ペアを抱えたデータで「どの列が結果を動かしているか」を順位で知りたいなら、drop-columnの並びをそのまま採用しないほうが安全です。
次の表の数字は、x0を1位に置けた回数(10回中)です。「PFI(テスト)」はテストデータで測ったPFIを指します。
手法 / x0とx1の相関 | 0.0 | 0.5 | 0.8 | 0.9 | 0.95 | 0.99 | 0.999 |
|---|---|---|---|---|---|---|---|
| PFI(テスト)ランダムフォレスト | 10 | 10 | 10 | 10 | 10 | 7 | 1 |
| PFI(テスト)LightGBM | 10 | 10 | 10 | 10 | 10 | 10 | 1 |
| drop-column ランダムフォレスト | 10 | 10 | 1 | 0 | 0 | 0 | 0 |
| drop-column LightGBM | 10 | 10 | 0 | 0 | 0 | 0 | 0 |
| 対照: 真の関数へのPFI | 10 | 10 | 10 | 10 | 10 | 10 | 10 |
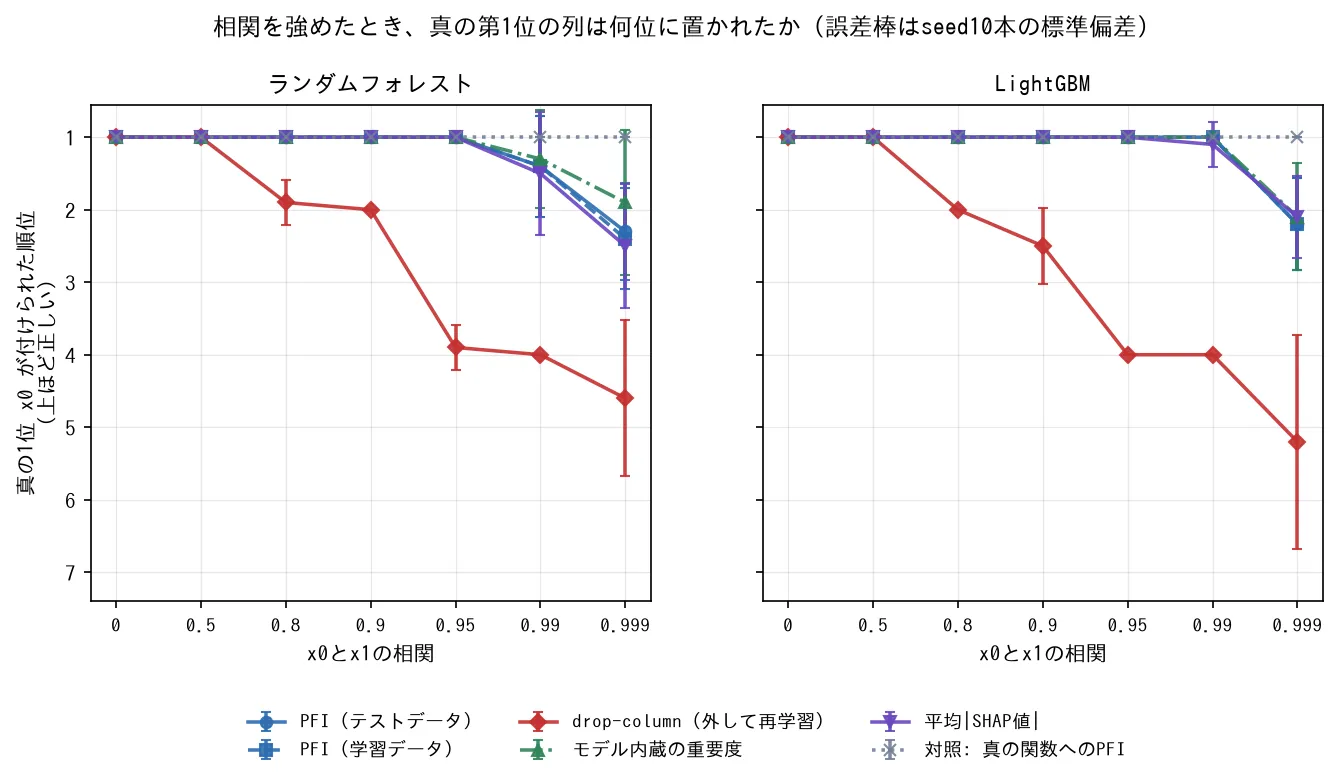
PFIが両モデルとも1位をほぼ失ったのは相関0.999で、drop-columnはそれよりずっと手前の0.8で崩れています。同じ0.8の条件でPFIは両モデルとも10回すべて正しい1位だったので、手法間の差ははっきりしていました。
企画の段階で立てていた「PFIが先に薄まり、drop-columnで回復する」という予想は、この時点で支持されませんでした。
配分で見ても向きは同じです。次の表はLightGBMの値になります。
| x0とx1の相関 | PFI(テスト) | drop-column | 対照: 真の関数へのPFI |
|---|---|---|---|
| 0.0 | 0.566 | 0.559 | 0.548 |
| 0.5 | 0.555 | 0.476 | 0.543 |
| 0.8 | 0.556 | 0.306 | 0.544 |
| 0.9 | 0.552 | 0.192 | 0.545 |
| 0.95 | 0.543 | 0.113 | 0.545 |
| 0.99 | 0.457 | 0.027 | 0.546 |
| 0.999 | 0.253 | 0.003 | 0.546 |
相関0.8まで来てもPFIの取り分は相関なしとほぼ変わらず、drop-columnは3割ほどまで落ちています。ランダムフォレストでも形は同じで、相関0から0.999にかけてdrop-columnは0.609から0.003、PFIは0.612から0.215へ動きました。つまり、片方の手法だけを見て「この列は効いていない」と読むと、相関の強さ次第で正反対の結論になります。
重要度の並び全体は、正解との順位相関でも比べました。1に近いほど正しい順序に近い指標で、相関0.99ではPFIが0.939、drop-columnが0.786です。真の寄与が0で並ぶ4列の扱いにより、モデルから測る手法の上限は0.939なので、PFIはこの条件で到達できるところまで保っていました。
この結果はdrop-columnの実装ミスではありません。 この方法が測るのは、「その列が最初からなくても、モデルを作り直せるか」です。ほぼ同じ情報を持つ代役が残っていれば、性能低下がゼロに近づくのは定義に沿った答えになります。ずれが生じるのは、そこから「元の列は結果に影響していない」と読み替えたときです。
同じデータでも、目的が違えば重要度の1位が入れ替わる
平均値だけでは実際の重要度グラフを想像しにくいので、相関0.95、LightGBM、乱数条件0の1例を取り出します。
drop-columnでは、1位がx2(配分0.521)、2位がx4、3位がx3となり、真の第1位であるx0は4位(0.111)でした。同じデータでPFIを測ると、x0が1位(0.539)、x2が2位(0.272)です。設定上、x0の真の寄与はx2の2.25倍なので、構造的な寄与と順序が合ったのはPFIのほうでした。
理由は削除実験の結果に出ています。x0を外して学習し直したとき、テストR²の低下は0.061にとどまりました。代役のx1が残るためです。対してx2を外すと0.286低下するので、drop-columnではx2が上位になります。PFIでは、x0だけを並べ替えたときの低下が0.982、x2は0.494でした。棒グラフを1枚だけ人に見せるなら、どちらの手続きで作った図なのかを必ず添えておきたい差です。
真の寄与が等しい3列では、相関ペアがそろって沈んだ
シナリオBでは、x0、x1、x2の真の寄与を完全に等しくし、x0とx1だけを相関させました。同点のはずの3列で配分がずれれば、相関相手がいるかどうかだけが原因だと言えます。
この設定には副作用があり、相関を強めると目的変数全体のばらつきも増えて、ランダムフォレストのテストR²が0.815から0.892へ上がります。相関水準をまたいだ数値の単純比較ができないため、次の表では相関0.99に条件を固定して手法間の配分を比べました。値はLightGBMを10回測った平均です。
| 手法 | x0 | x1 | x2 |
|---|---|---|---|
| PFI(テスト) | 0.253 | 0.303 | 0.256 |
| drop-column | 0.011 | 0.009 | 0.550 |
| モデル内蔵の重要度 | 0.302 | 0.370 | 0.177 |
| 対照: 真の関数へのPFI | 0.258 | 0.259 | 0.264 |
相関0では、4手法とも3列が0.25から0.27の範囲に並びます。相関を0.99まで強めると、drop-columnは相関ペアの2列を、真の寄与が等しいx2のおよそ50分の1まで押し下げました。 x0がx2を下回った回数も、drop-columnでは相関0.8以上の全条件で10回中10回です。真の寄与が同点なら順位はおおむね半々に入れ替わるはずで、同じ状況のPFIは10回中5回から6回、対照は7回から8回でした。
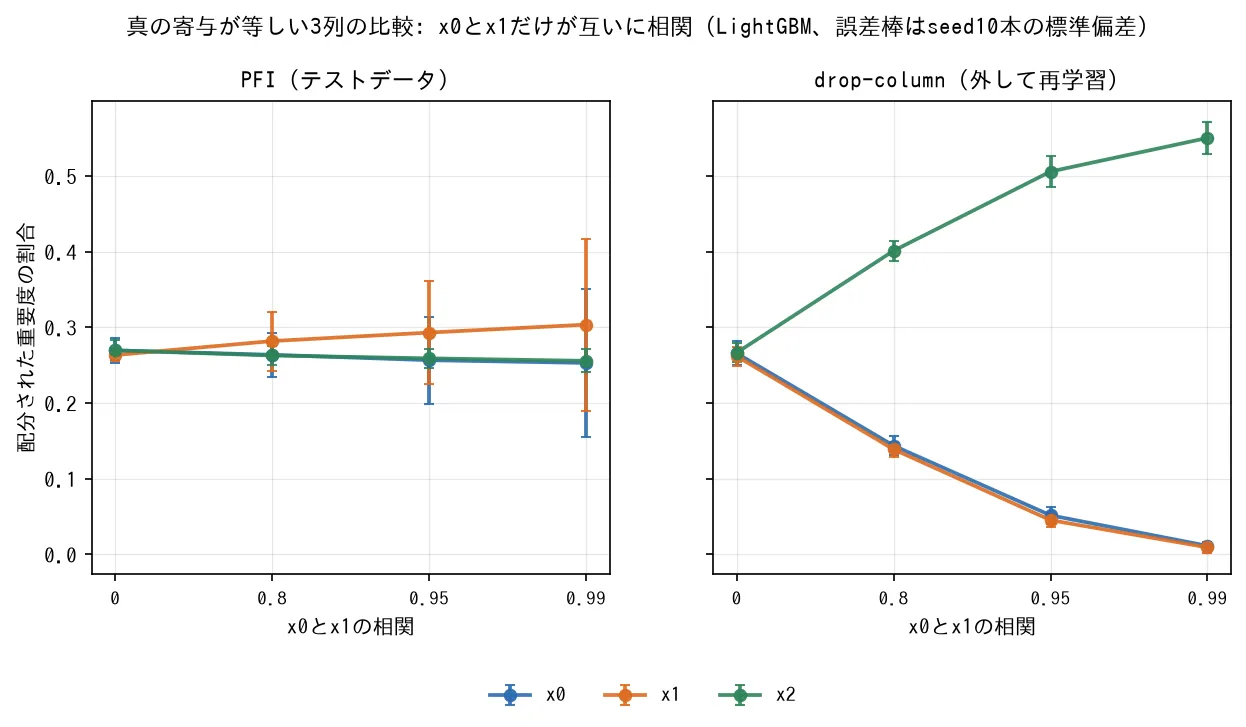
外れ方は手法ごとに向きが違います。モデル内蔵の重要度では相関ペアの合計が大きくなり、無相関のx2は0.264から0.177へ低下しました。ランダムフォレストでも0.278から0.175へ動きました。相関ペアの値が必ず分散して小さくなるとは限りません。今回はペア側へ多く配分されています。
ペアの合計が保たれても、内訳は毎回入れ替わりました
平均は動かないのに、片方の配分は作り直すたびに振れた
ここまでの表は平均値です。平均だけならPFIはほとんど動いていないように見えますが、データを作り直した10回のばらつきは大きく増えていました。次の表は、シナリオBでランダムフォレストを使ったときのx0の配分です。
| x0とx1の相関 | 平均 | 10回の標準偏差 | 最小 | 最大 | x0とx1の合計 |
|---|---|---|---|---|---|
| 0.0 | 0.293 | 0.014 | 0.266 | 0.321 | 0.579 |
| 0.8 | 0.286 | 0.084 | 0.187 | 0.466 | 0.619 |
| 0.95 | 0.266 | 0.147 | 0.071 | 0.540 | 0.627 |
| 0.99 | 0.246 | 0.144 | 0.051 | 0.499 | 0.628 |
ペアの合計は0.579から0.628とほぼ保たれた一方、x0単独の値は0.051から0.499まで振れました。 同じ条件の対照は標準偏差0.008から0.015の範囲で、ここまで広がっていません。ペア全体としての重要度は残っているのに、2列のどちらへ配るかがデータの引き直しで決まってしまう状態です。片方だけを見て「効いている」と判断すると、データを取り直した次の週に結論が入れ替わりえます。根拠は毎回入れ替わります。
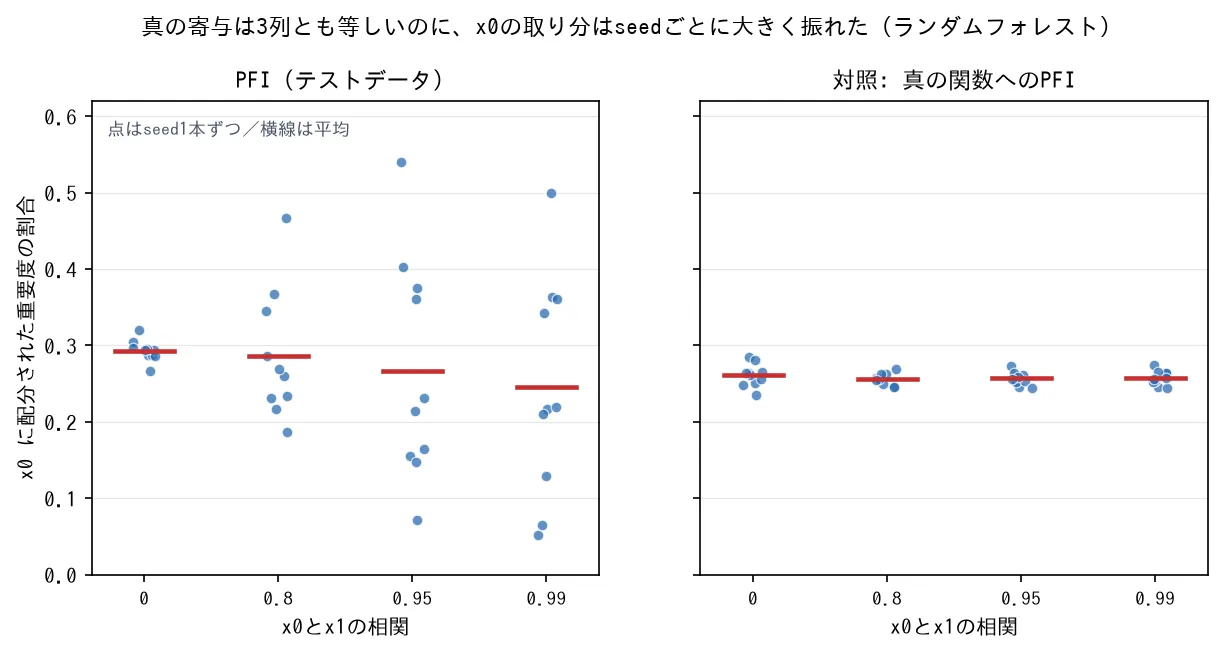
この不安定さに気づいたのは、実装ミスを疑ったからでした。平均表ではx1がx0より一貫して大きく見え、対称に作ったはずの2列を取り違えたのではないかと考えたのです。生値を開くと、相関0.99のランダムフォレストでx1が上回ったのは10回中6回でした。系統的な偏りではなく、作り直すたびに内訳が大きく動いていたわけです。平均だけを保存していたら、安定性の低下は見落としていました。
「合計は保たれる」と言えるのは、真の寄与が等しい設定についてです。 相関相手のx1が結果へ影響しないシナリオAでは、ペアの合計そのものも目減りしました。ランダムフォレストのPFI(テスト)は0.612から相関0.99で0.497、0.999で0.453まで下がり、LightGBMでも0.566から0.486、0.414へ動いています。同じ条件でモデル内蔵の重要度と平均SHAP値はペアの合計を保っており、合計が目減りしたのはPFIとdrop-columnでした。内訳の不安定さのほうは、PFI・モデル内蔵の重要度・平均SHAP値の3つに共通しています。
モデル内蔵の重要度から先に、効果ゼロの列が上位へ紛れ込んだ
シナリオAには、目的変数へ影響しない列が4本あります(x1、x5、x6、x7)。そのいずれかが、本当に効いている列を追い越した回数を数えたところ、相関0.95までは全手法で0回でした。順位が動き始めるのは相関0.99からです。次の表は、その相関0.99での追い越しの回数(10回中)だけを並べたものです。
| 手法 | ランダムフォレスト | LightGBM |
|---|---|---|
| モデル内蔵の重要度 | 10 | 5 |
| 平均SHAP値 | 7 | 1 |
| PFI(テスト) | 4 | 0 |
| drop-column | 0 | 0 |
| 対照: 真の関数へのPFI | 0 | 0 |
追い越しが最も多かったのは、学習済みの木からそのまま取り出すモデル内蔵の重要度で、ランダムフォレストでは10回すべてで発生しました。手軽に出せる値ほど先に崩れた、というのがこの結果からの推測です。順序そのものは事前に予想していませんでした。相関0.999まで来るとPFI、モデル内蔵、平均SHAP値のいずれも10回中8回以上、drop-columnでも3回から5回となり、対照だけが0回のままです。
なお、相関0.99でdrop-columnが0回だったことは、順位が正しい証拠になりません。相関ペアの2列がそろって低くなり、効果ゼロの列と一緒に上位から外れていただけです。
崩れの出どころと、まとめて並べ替える対処
並べ替えの計算そのものは崩れていない
データ生成式そのものへPFIを適用した対照では、シナリオAの全条件・全10回で真の第1位を保ちました。 配分も0.543から0.548の範囲に収まり、相関0.999でもほとんど動きません。シナリオBは3列の真の寄与が同点で「真の第1位」を定義できないため、そちらは配分が3列で均等かどうかを見て確認しています。
この対照があるので、今回の崩れは並べ替える計算の側では起きておらず、相関列を代役として使うように学習したモデル側の変化を含むと判断できます。原因はモデルの中にありました。裏を返せば、モデルが変わっている以上、その挙動を測る指標が影響を受けるのは避けられません。
それでいて、モデルの当てはまりはほとんど落ちていません。 シナリオAで相関を0から0.999へ上げても、テストR²はLightGBMで0.914から0.911、ランダムフォレストで0.866から0.861とほぼ横ばいでした。予測精度の監視を続けていても、重要度の並びだけが変わっていく状況には気づけません。
グループ順列は効いたが、束ねる前段でつまずいた
相関の強い列を同じ行順で一斉に並べ替える方式では、シナリオAの全条件・全10回で、x0を含むグループが1位でした。列ごとのPFIが崩れる相関0.999でも1位のままです。ペア全体をひとつの単位として読むなら、この方式は相関の影響をよく吸収しています。
つまずいたのは前段です。並べ替える前に、相関ペアを正しく見つけられるかどうかでした。距離1-|相関|、平均連結、閾値0.2で自動グループ化すると、x0とx1を束ねられたのは相関0.9以上です。相関0.8では10回中1回、0.5以下では一度も同じグループに入りませんでした。
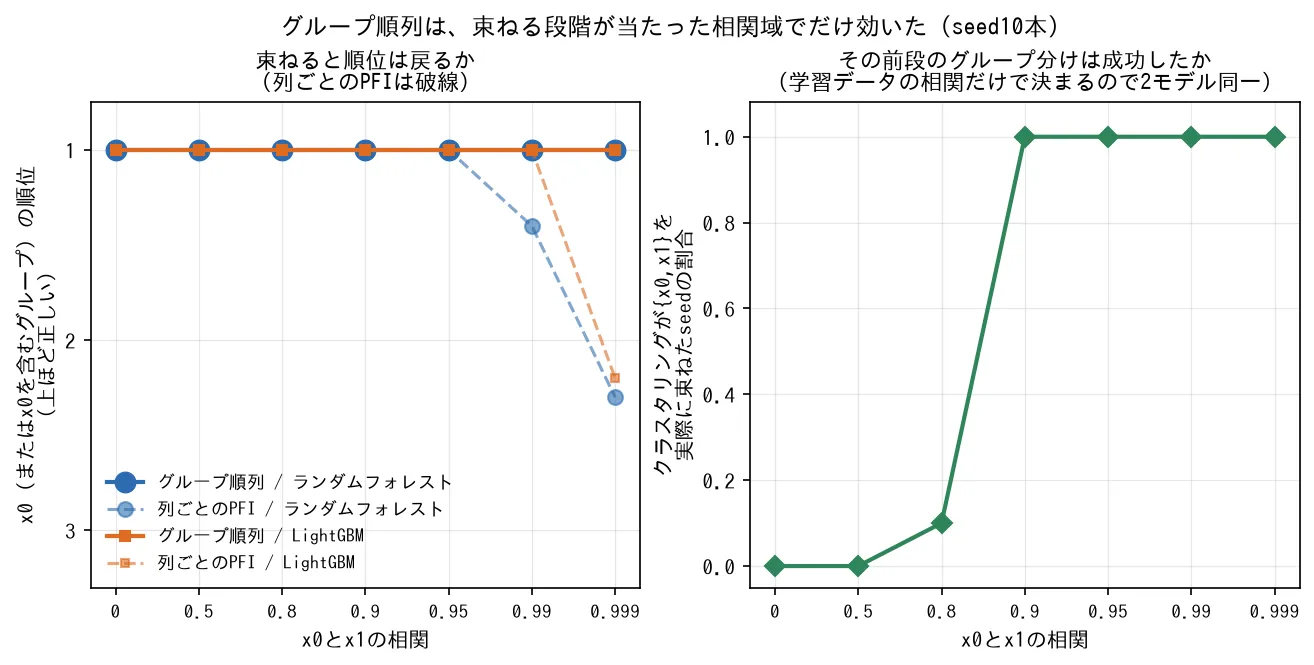
原因は、相関の種類と閾値の組み合わせにありました。実験条件の相関は元の値で計算していますが、グループ分けには値を順位へ置き換えてから計算するSpearman相関を使っています。今回のデータでは後者がわずかに小さく、相関0.8のペアが閾値の直下へ落ちていました。Pearson相関など別の相関係数を見て閾値を決めると、自動グループ化の判定とずれます。
実害の有無は設定によって分かれます。シナリオAの順位に限れば、相関0.8でも列ごとのPFIが正しく1位を出していたので困りません。一方、真の寄与が等しいシナリオBでは、同じ相関0.8ですでにx0の配分が0.187から0.466まで振れていました。内訳をまとめて読むためのグループ分けが、そのいちばん欲しい条件で10回中9回とも取りこぼしていたことになります。
手元の重要度を確認する順番
-
聞かれているのが「削除できるか」か「今使っているか」かを決める 現在のモデルが使っている列を知りたいならPFI、列を削除しても再学習後の精度を保てるか知りたいならdrop-columnです。名前が似た「重要度」でも、そのまま置き換えられません。
-
上位列と相関する相手を先に洗い出す PFIの上位列と強く相関する列を確認します。相関ペアがある場合は、片方の値だけで「効いていない」と判断せず、2列の合計と個別値を分けて読みます。
-
データを取り直して、順位と配分の振れ幅まで見る ブートストラップなどでデータを取り直し、PFIの順位と配分がどの程度動くかを確かめます。今回の相関0.99では片方の配分が約10倍の範囲で動いたため、平均値だけでは安定性を判断できませんでした。なお、この操作で分かるのはデータを変えたときの振れです。データを固定して学習や並べ替えの乱数だけを変えた振れとは異なります。
-
ペアをまとめた値と、個別値の合計を突き合わせる 相関ペアをまとめて並べ替えるグループ順列を試し、列ごとのPFI合計と比べます。グループ値が大きく上回るなら、片方を並べ替えた際にもう片方が情報を補っている可能性があります。
-
束ねられた組の一覧まで目視する 自動作成された組を一覧で確認し、狙った列が同じグループに入っているかを調べます。今回の閾値では相関0.8のペアを10回中1回しか束ねられなかったため、結果だけでなく前段のグループ分けも検査対象です。
モデルの予測精度は、この確認の代わりになりません。テストR²は横ばいのままでした。動いたのは重要度の並びだけです。
詳しい検証条件
相関した特徴量の「本当の重要度」には複数の定義があります。採点の物差しは1本選ぶしかありません。この記事では、ほかの列で代用できるかを脇に置き、データを作った式の中で各列が持つ構造的な寄与を正解としました。相関相手の値が分かっている状態で、その列が新たに加える情報を測る「条件付き重要度」を正解にすれば、採点結果も変わります。どの定義が常に正しいかを決める検証ではありません。なお、同じ構造効果を正解に置いて、相関する特徴量のもとでPDPとALEの曲線がどこまで縮むかを測った検証はPDPとALEの比較にあります。
手法ごとに重要度の単位が違うため、配分は負の値を0としてから、8列の合計が1になる割合へ換算しました。この換算は手法間の比較をしやすくする代わりに、元の精度低下量そのものからは離れます。
PFIを学習データとテストデータのどちらで測るかは、今回の設定で明確な差を確認できませんでした。LightGBMのx0配分は、相関0から0.99にかけてテストデータで0.566から0.457、学習データで0.551から0.446へ動き、1位になった回数も一致しています。過学習が強いモデルでは違いが出る可能性がありますが、その条件は測っていません。
読み飛ばし可: モデル・集計・採点の設定値
- ランダムフォレストは100本、
min_samples_leaf=5。LightGBMは200本、学習率0.05、num_leaves=31で、全処理をシングルスレッドに固定しました。 - PFIはscikit-learnの
permutation_importanceを使い、R²を評価指標として各列を5回並べ替えました。学習データとテストデータの両方で測っています。 - SHAPはTreeExplainerの介入設定で、背景100件とテスト200件を使い、SHAP値の絶対値を平均しました。
- グループは学習データのSpearman相関から作りました。距離は
1-|相関|、平均連結の階層クラスタリング、閾値は0.2です。 - 真の順位との一致にはSpearmanの順位相関を使いました。真の寄与が0で並ぶ4列に少しでも値を付ける手法では、今回の上限は0.939です。
- 表は10回の平均を中心に、標準偏差、最小値、最大値も確認しました。差が小さい学習データとテストデータの比較は「明確な差を確認できなかった」としています。
- 割合と相関は小数第3位、順位は小数第1位まで丸めました。
適用範囲と限界
- 正解の定義を「データ生成過程の各項が生む目的変数の分散」に採ったうえでの採点です。条件付き重要度を正解にすれば、シナリオAの
x1の真の寄与はゼロから外れ、採点結果も変わります。この記事はどちらが正しいかに答えていません。 - 相関させたのは1ペアだけです。3列以上の相関クラスタ、相関の連鎖、ブロック構造では挙動が変わりえますが、測っていません。
- 特徴量はガウス分布の連続値だけで、カテゴリ変数・欠測・裾の重い分布は含みません。真の関数も加法的(二次項を1つ含む)で、高次の交互作用は入れていません。
- 相関相手で層別して並べ替える条件付きPFIは実装していません。対処として測ったのは、グループ順列とdrop-columnの2つです。
- グループ分けの閾値は0.2の1点、PFIの並べ替え回数は5回、データの規模は学習2,000件・テスト1,000件の1点に固定しています。閾値を振ったときの成否、回数を増やしたときにばらつきがどこまで縮むか、件数を変えたときに内訳の振れがどう動くかは、いずれも測っていません。
- シナリオBには、相関を強めると目的変数の全分散も一緒に増えるという設計上の副作用があります。相関だけの効果を水準で読みたいときは、テストR²がほぼ横ばいのシナリオA(0.866から0.861)を参照してください。
- 対照が崩れなかったことは、交互作用を含まない今回のデータ生成式に対する観測です。どのモデルやデータでも並べ替え処理に問題がないと証明したわけではありません。
- 合成データに閉じた検証です。実データで同じ幅の崩れが起きるかは、真の寄与を定義できない以上この方法では確かめられません。
手元のデータでPFIとグループ順列を比べるコード
次のコードは、学習済みモデル、学習データ、テストデータを受け取り、列ごとのPFIを計算してから相関の強い列をまとめて並べ替えます。グループ値が各列のPFI合計を大きく上回れば、片方を並べ替えても相関相手が情報を補っていた可能性を疑う、という点検です。
コード内の閾値0.2は、絶対値でおよそ0.8を超える相関を同じグループへ入れる設定です。境界付近のペアは取りこぼすため、出力末尾の「束ねられた組」と相関の最大値も確認します。距離の閾値を0.25へ広げると、およそ0.75を超える組まで対象になりますが、関係の弱い列をまとめる範囲も広がります。
実行例にはscikit-learn同梱の糖尿病データ442件を使うため、外部からの取得は不要です。手元のデータへ置き換える場合は、特徴量をNumPyの2次元配列で渡し、pandasのDataFrameならdf.to_numpy()で変換できます。なお、相関行列を作る都合上、特徴量が3列以上あることが前提です。
"""相関でPFIが薄まっていないかを点検する最小の実装例。

列ごとのPFIに加えて、相関の強い列を束ねて「同じ行順で一斉に並べ替えた」ときの
重要度も出す。グループの値が、そのメンバー個々の値の合計より大きく上回るなら、
列ごとのPFIは相関相手に肩代わりされて低く出ている。
"""

import numpy as np
from scipy.cluster import hierarchy
from scipy.spatial.distance import squareform
from scipy.stats import spearmanr
from sklearn.datasets import load_diabetes
from sklearn.ensemble import RandomForestRegressor
from sklearn.inspection import permutation_importance
from sklearn.metrics import r2_score
from sklearn.model_selection import train_test_split

SEED = 0
N_REPEATS = 10
CORR_THRESHOLD = 0.2  # 距離 1-|相関| の閾値。0.2 なら |相関| がおよそ 0.8 超を束ねる


def correlation_groups(X, threshold=CORR_THRESHOLD):
    """学習データの Spearman 相関から、強く相関する列を束ねる。"""
    corr = np.asarray(spearmanr(X).statistic)
    corr = (corr + corr.T) / 2
    np.fill_diagonal(corr, 1.0)
    dist = np.clip(1.0 - np.abs(corr), 0.0, None)
    np.fill_diagonal(dist, 0.0)
    link = hierarchy.linkage(squareform(dist, checks=False), method="average")
    labels = hierarchy.fcluster(link, threshold, criterion="distance")
    groups = {}
    for j, lab in enumerate(labels):
        groups.setdefault(int(lab), []).append(j)
    return [sorted(g) for g in sorted(groups.values(), key=min)]


def grouped_permutation_importance(model, X, y, groups, seed=SEED, n_repeats=N_REPEATS):
    """グループ内の列を同じ行順で一斉に入れ替え、R2 の低下量を測る。"""
    rng = np.random.default_rng(seed)
    base = r2_score(y, model.predict(X))
    out = []
    for g in groups:
        drops = []
        for _ in range(n_repeats):
            Xp = X.copy()
            idx = rng.permutation(len(X))
            Xp[:, g] = X[idx][:, g]
            drops.append(base - r2_score(y, model.predict(Xp)))
        out.append(float(np.mean(drops)))
    return np.array(out)


def main():
    data = load_diabetes()
    X, y = data.data, data.target
    names = list(data.feature_names)

    X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=SEED)

    model = RandomForestRegressor(
        n_estimators=300, min_samples_leaf=5, random_state=SEED, n_jobs=1
    )
    model.fit(X_tr, y_tr)
    print(f"test R2 = {r2_score(y_te, model.predict(X_te)):.3f}\n")

    # 1) ふつうの列ごとの permutation importance(テストデータで測る)
    single = permutation_importance(
        model, X_te, y_te, scoring="r2", n_repeats=N_REPEATS,
        random_state=SEED, n_jobs=1,
    ).importances_mean

    print("列ごとのPFI(R2の低下量、大きい順)")
    for j in np.argsort(-single):
        print(f"  {names[j]:6s} {single[j]: .4f}")

    # 2) 相関で束ねてから、グループごとに一斉に並べ替える
    groups = correlation_groups(X_tr)
    grouped = grouped_permutation_importance(model, X_te, y_te, groups)

    top = max(grouped.max(), 1e-12)  # 最大のグループ値。小さすぎる差を騒がないための基準
    print("\nグループごとのPFI(薄まりの点検)")
    print(f"{'グループ':22s} {'グループ値':>10s} {'個々の合計':>10s} {'倍率':>7s}")
    for g, gv in sorted(zip(groups, grouped), key=lambda t: -t[1]):
        label = "+".join(names[j] for j in g)
        parts = float(single[g].sum())
        # PFIは負にもなるので、両方が正のときだけ倍率を出す
        show_ratio = gv > 0 and parts > 0
        ratio_s = f"{gv / parts: 7.2f}" if show_ratio else "      -"
        # 元から重要度がほぼ無いグループの倍率は実務的な意味がないので旗を立てない
        flag = ""
        if len(g) > 1 and show_ratio and gv / parts > 1.5 and gv > 0.05 * top:
            flag = "  <- 薄まりの疑い"
        print(f"  {label:20s} {gv: 10.4f} {parts: 10.4f} {ratio_s}{flag}")

    multi = [g for g in groups if len(g) > 1]
    if multi:
        print("\n束ねられた組と、その中の |Spearman相関| の最大値:")
        corr = np.abs(np.asarray(spearmanr(X_tr).statistic))
        for g in multi:
            pairs = [corr[a, b] for i, a in enumerate(g) for b in g[i + 1:]]
            print(f"  {'+'.join(names[j] for j in g)}: {max(pairs):.3f}")
    else:
        # 束ねられた組が無くても安全とは言えないので、判断材料に相関の最大値を出す
        corr_all = np.abs(np.asarray(spearmanr(X_tr).statistic))
        np.fill_diagonal(corr_all, 0.0)
        print(f"\n|相関| が閾値を超える列の組はありませんでした"
              f"(距離の閾値 {CORR_THRESHOLD} = |相関| がおよそ0.8超)。"
              f"データ内の |Spearman相関| の最大値は {corr_all.max():.3f} です。"
              f"閾値のすぐ下にある組は拾えないので、この値が0.8前後なら取りこぼしを疑ってください。")


if __name__ == "__main__":
    main()
実行方法と出力の読み方
上のコードをpfi_correlation_check.pyとして保存し、必要なライブラリを入れて実行します。
pip install scikit-learn==1.9.0 numpy==2.4.6 scipy==1.17.1
python pfi_correlation_check.py実行すると、s1+s2(|相関| 0.866)とs3+s4(0.814)の2組が作られます。s1+s2のグループ値は個別PFIの合計の2.69倍ですが、重要度の絶対値が小さいため、コード上の「薄まりの疑い」は付きません。旗を付ける条件は、倍率1.5超かつグループ値が最大グループの5%超です。この2つは動作例のために置いた基準であり、正解付きデータによる精度検証はしていないので、旗の有無だけで判断せず倍率と元の値を併記します。
test R2 = 0.325

列ごとのPFI(R2の低下量、大きい順)
  s5      0.1912
  bmi     0.1733
  bp      0.0298
  sex     0.0068
  s2      0.0048
  s6      0.0021
  s1     -0.0018
  age    -0.0029
  s4     -0.0051
  s3     -0.0137

グループごとのPFI(薄まりの点検)
グループ                        グループ値      個々の合計      倍率
  s5                       0.1942     0.1912    1.02
  bmi                      0.1679     0.1733    0.97
  bp                       0.0385     0.0298    1.30
  s1+s2                    0.0081     0.0030    2.69
  sex                      0.0047     0.0068    0.69
  s6                       0.0023     0.0021    1.12
  age                     -0.0016    -0.0029       -
  s3+s4                   -0.0087    -0.0188       -

束ねられた組と、その中の |Spearman相関| の最大値:
  s1+s2: 0.866
s3+s4: 0.814倍率の欄に条件を付けているのには理由があります。最初に書いたときは比を無条件に計算していて、グループ値も個々の合計も負になるs3+s4で倍率が無限大になり、「薄まりの疑い」という旗が誤って立ちました。PFIは負の値を取りうるので、両方が正のときだけ比を出し、そもそも重要度がほとんどないグループには旗を立てない、という2つの条件を足しています。
まとめ: 値の大小より、測っている問いと相関ペアを見る
PFIとdrop-columnのどちらを使うかは、精度の高い方法を選ぶ問題ではありません。決めるのは目的のほうです。今のモデルが列を使っているか知りたいのか、その列なしでモデルを作り直せるか知りたいのかを先に選びます。相関する代役があると、この2つの答えは大きく離れました。
列ごとのPFIを使う場合も、1回の棒グラフでは安定性まで分かりません。相関する列を洗い出し、データを取り直した再測定と、ペアをまとめたグループ順列を組み合わせます。自動でグループを作るなら、閾値の設定だけでなく、実際に束ねられた列の一覧までが確認対象です。
今回確認できた範囲は、回帰の合成データと相関ペア1組でした。分類、実データ、3列以上の相関構造、条件付きPFI、グループ化の閾値選びは未検証なので、実務では記事内の数値を境界として流用せず、手元のデータで同じ確認手順を実行します。
学習に使うライブラリ選びはGBDT3種を実測比較、評価の側で自分を騙さない話はデータリークの罠5パターンにあります。