
表形式のデータ(テーブルデータ)で精度を上げたいとき、多くの人がまず列を「足す」ところから始めます。2乗や積を作る、連続値を区間に切る、カテゴリごとの平均を足す。定番の変換はカタログとして共有されていて、つい全部かけてみたくなります。
気になるのは、その全部盛りが本当に得なのかどうかです。列を増やすほどモデルが暗記に走って、評価用に取り分けた別データではかえって壊れる、という警告はよく聞きます。一方で「どれがどれだけ効くかは事前には分からないから試すしかない」で終わる解説も多く、調べた範囲では、手法を横並びにして効果の大きさまで測った記録が見当たりませんでした。
そこで4つのデータで実際に測ってみると、壊れませんでした。代わりに膨らんだのは別のものです。実データのadultでは、精度がまったく動かないまま、列の数が9.5倍、1回の学習にかかる時間が5.7倍になりました。
先に結論: 実データでは精度が動かず、コストだけが増えた
- 「全部盛りにすると評価用の別データで精度が壊れる」という素朴な予想は、今回は成り立たなかった。その評価用データ(held-out)の ROC-AUC(順位づけの良さを見る指標)は、合成データ2種で +0.0046 と +0.0067 の改善、実データは adult が ±0.0000、credit が -0.0003。
- 逆説の実体は精度低下ではなくコスト増。adult では特徴量が14列から133列、1回の学習が0.41秒から2.33秒に増加。
- 学習データと評価データの精度差(過学習ギャップ)の拡大幅も、adult が4データ中もっとも大きい +0.0067。
- 上げる方向に効いたのは、2乗や積を足す多項式と交互作用の2つだけ。それも合成データでの話で、実データ2種ではこの2つも下げ側(adult -0.0010、credit -0.0040)。
- 値の種類だけが多いノイズ列を鍵にして平均や標準偏差を足す集約統計量は、4データ中3つで最下位。
- 適用条件: LightGBM(GBDTの軽量な実装)の既定設定、数値化済みのテーブルデータ4種(合成2種と、adult 48,842件・credit 1,000件)、データを5等分して学習と評価を入れ替える層化5-fold交差検証を乱数シード20本で回したCPUでの実測。
足す5手法と、効果の測り方
生データから予測に効きそうな新しい列を作る工夫を、まとめて特徴量エンジニアリングと呼びます。今回そろえた定番は5つです。多項式は特徴の2乗や積を足し、交互作用は積だけを足します。ビニングは連続値を区間に切り、集約統計量はカテゴリごとの平均や標準偏差を足します。ターゲットエンコーディングは、カテゴリを目的変数の平均で置き換えるやり方です。
効果を測る相手にしたのはGBDT(勾配ブースティング決定木)です。浅い決定木を「前の木の間違いを次の木が補う」形で順に足す手法で、テーブルデータでは定番の選択肢になっています。実装にはLightGBM(速さ重視の軽量なGBDT)を使いました。選定理由はGBDT3種の実測比較にまとめています。
精度は held-out(学習に使わず評価だけに取り分けた別データ)の ROC-AUC で見ます。0から1で予測の順位づけの良さを表す指標で、正例と負例をどれだけきれいに並べ分けたかを映します。副指標の PR-AUC は、正例が少ないデータで正例側の当たり方を敏感に拾う指標です。
もう1本の軸が過学習ギャップです。学習データでの ROC-AUC から held-out の ROC-AUC を引いた差で、大きいほど「暗記」に寄っています。列を足した見返りが本物かどうかは、精度とこのギャップを並べて初めて見えます。
4つのデータで、baseline に1手法ずつ足した
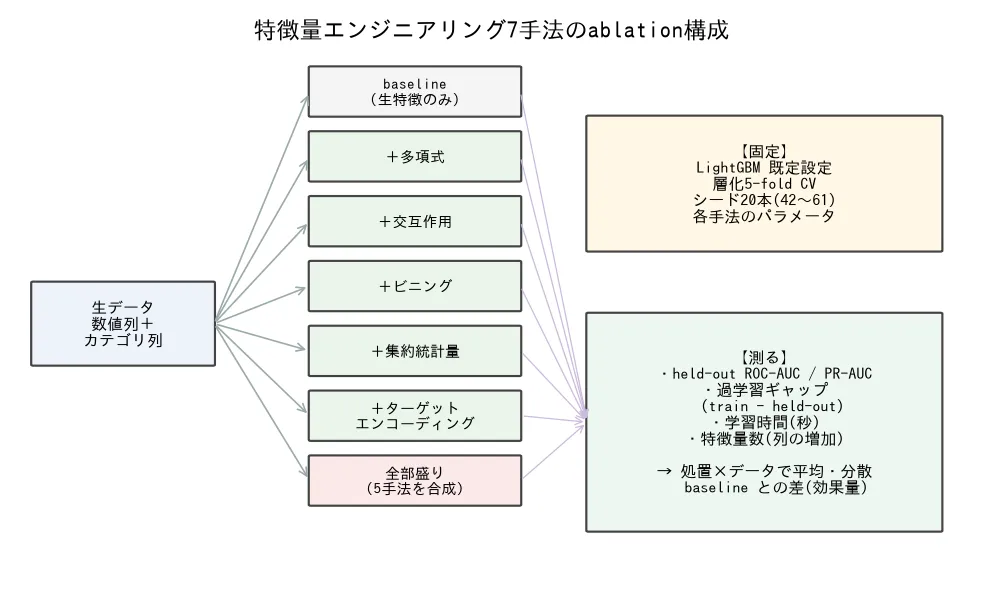
比べたのは7条件です。baseline(変換をかけない生の特徴だけ)、そこへ5手法を1つずつ足した5条件、5手法を一度にかけた全部盛り。1つずつ足して効果を分けて見るこのやり方を ablation(切り分け比較)と呼びます。分類器はLightGBMの既定設定に固定し、測ったのは held-out の ROC-AUC(主)と PR-AUC、過学習ギャップ、1回の学習にかかる秒数、適用後の特徴量数です。
データは4つで、性格を分けてあります。合成2種は make_classification で作った正解既知のデータです。有益な数値列とノイズ列を作り分けてあり、内訳は低ノイズが有益5・ノイズ5、高ノイズが有益4・ノイズ16。どの列が本物かが分かるので、ノイズから作った特徴が held-out を汚すかどうかを切り分けられます。
実データ2種はpmlb(公開データセットをまとめた配布リポジトリ)から取得しました。adultは国勢調査から年収5万ドル超かを当てるデータで48,842件、creditはドイツの与信審査で優良客かを判定するデータで1,000件です。creditは件数が小さく、シードを変えるとスコアが大きく揺れます。
変えたもの・固定したもの・測ったものの対応は、次の図にまとめてあります。
回す前に、仮説を2つ置いていました。1つは「全部盛りは held-out を上げず、過学習ギャップと学習時間・特徴量数だけが増える」。もう1つは「ターゲットエンコーディングは、正しく out-of-fold で符号化すれば効く」です。out-of-fold は、評価に使う行の正解を見ずに特徴を作るやり方を指します。
なお、相手にしたのは木系のモデル1つだけです。分割やシードの決め方、リークを避けた符号化の手順といった条件は、記事の後半にまとめました。
全部盛りでも精度は壊れず、増えたのはコストだった
5手法を一度にかけても、held-out の精度は下がりませんでした。壊れる代わりに膨らんだのは、列の数と学習時間です。
つまり実務で見るべきなのは、精度が動いたかどうかよりも、増えたコストに見合っているかのほうになります。次の表は baseline と全部盛りの差を4データで並べたものです(列名のΔは baseline からの変化量)。
| データ | 全部盛りのΔheld-out AUC | 特徴量数 | 学習時間 | 過学習ギャップ |
|---|---|---|---|---|
| 合成・低ノイズ | +0.0046 | 13→141(10.8倍) | 0.15→1.38秒(9.3倍) | 縮小(-0.0034) |
| 合成・高ノイズ | +0.0067 | 23→376(16.3倍) | 0.27→5.14秒(19.2倍) | 縮小(-0.0063) |
| adult(実) | ±0.0000 | 14→133(9.5倍) | 0.41→2.33秒(5.7倍) | 拡大(+0.0067) |
| credit(実) | -0.0003 | 20→130(6.5倍) | 0.04→0.36秒(9.0倍) | 拡大(+0.0003) |
シードごとに見ると、合成2種は20本すべてで held-out が上がっています。全部盛りが本物の信号を引き出した形です。adultは20シード中7本しか正になりません。改善したとは言えないまま、暗記の余地だけが4データ中もっとも広がった状態です。creditも精度は動かず、増えたのはコストだけでした。
実データ2種はほぼ仮説のとおりでした。外れたのは合成2種の側です。上がらないと見ていた精度が上がり、増えると見ていた過学習ギャップはむしろ縮みました。
なぜadultで壊れないのか。LightGBMのような木系モデルは、無関係な列を分割候補から外すのが得意です。全部盛りで大量のノイズ列を混ぜても held-out が壊れにくいのは、これが理由だと考えられます。ただし、この頑健さと引き換えのものがあります。列が増えれば学習は重くなり、暗記の余地はadultのように広がることがあります。
効いたのは多項式と交互作用、それも合成データだけ
手法を1つずつ見ると、効き方はデータの性格でくっきり割れました。数値の信号が多い合成データでは多項式と交互作用が効く一方、実データ2種で上がったのはadultの集約統計量の+0.0005など実務で気づけない幅にとどまり、creditではむしろ下げ側に振れています。
全体像は次の表で見えます。各手法の baseline からの held-out ROC-AUC の変化です。改善が確認できた合成2データだけ、列内で最も高い値を太字にしています(実データ2つは列内最良でも実務では動かない幅なので、太字は付けていません)。
| 手法 | 合成・低ノイズ | 合成・高ノイズ | adult(実) | credit(実) |
|---|---|---|---|---|
| 多項式 | +0.0047 | +0.0070 | -0.0010 | -0.0040 |
| 交互作用 | +0.0042 | +0.0059 | -0.0010 | -0.0040 |
| ビニング | -0.0002 | -0.0001 | +0.0000 | -0.0011 |
| 集約統計量 | -0.0031 | -0.0046 | +0.0005 | -0.0061 |
| ターゲットエンコーディング | +0.0004 | -0.0002 | +0.0003 | -0.0001 |
| 全部盛り | +0.0046 | +0.0067 | ±0.0000 | -0.0003 |
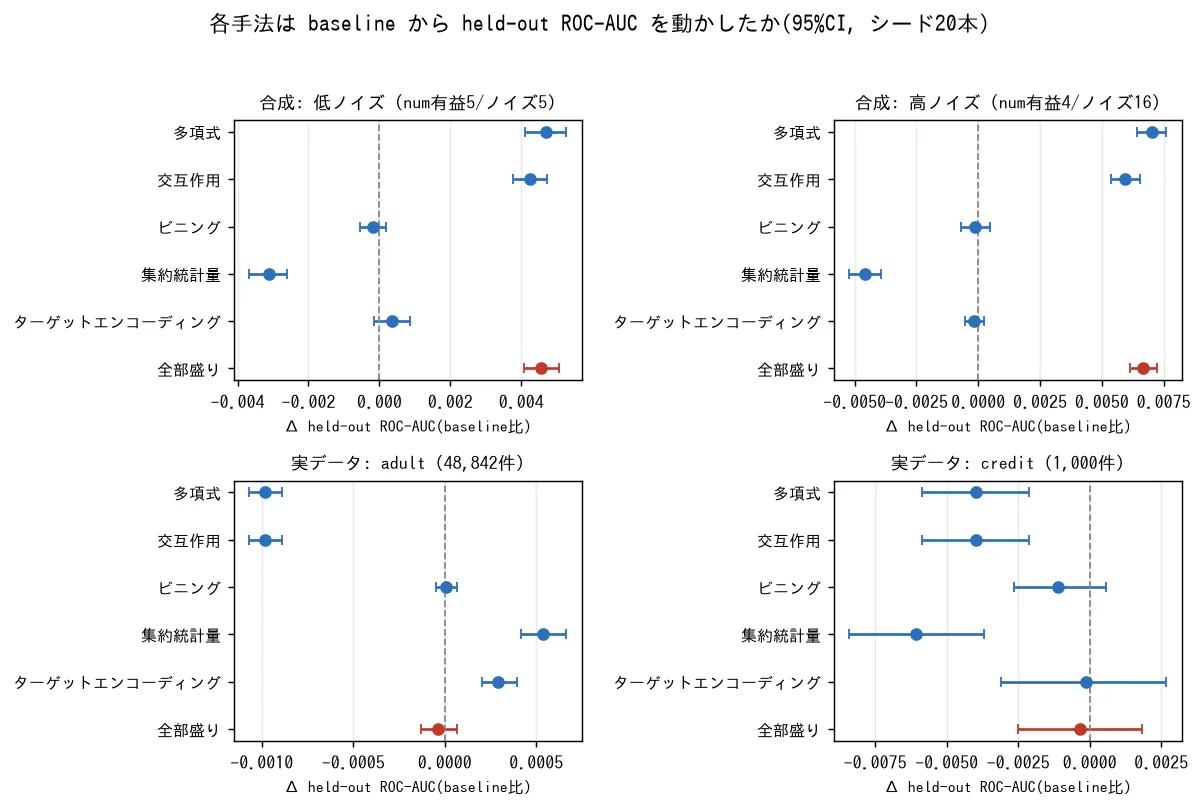
高ノイズの多項式は+0.0070。20シードすべてが正で、効果量(差の大きさをばらつきで割った値)も5.13と大きく、統計的に割り引いても改善が残りました。木は本来この積や2乗を自力で近似しますが、あらかじめ列として渡すと発見が楽になるぶん held-out が伸びたと見られます。全部盛りが伸びたのも、中身はこの多項式・交互作用ぶんです。
実データは様子が違います。adultでいちばん高いのは集約統計量の+0.0005(効果量1.90)ですが、実務では気づけない幅です。多項式・交互作用はむしろ小幅に悪化しました(-0.0010、20シード中0本しか正でない)。creditは最も下げ幅の小さいターゲットエンコーディングでも-0.0001で、明確に効く手法がありません。
そのターゲットエンコーディングに、検証前のもう1つの仮説を置いていました。リークさえ正しく潰せば効くはずだ、という見込みです。こちらは成り立ちませんでした。実測は4データとも -0.0002〜+0.0004 の幅で、out-of-fold で符号化したターゲットエンコーディングはどのデータでも held-out を動かしていません。
合成で効いた多項式・交互作用が、実データでは下げ側に回る。ここがこの実験の一番の含意です。手法そのものの優劣より、データの中に活きた数値信号がどれだけあるかが効き方を決めています。
集約統計量は、種類が多いだけの列を鍵にすると逆効果になりやすい
手法の中で目立って悪かったのが集約統計量で、4データ中3つで最下位でした。合成・高ノイズで-0.0046、合成・低ノイズで-0.0031、creditで-0.0061と、いずれも効果量の大きい悪化です(順に-3.00、-2.52、-1.11)。プラスに振れたのはadultだけでした。
理由は集約の「鍵」に使う列にあります。今回の合成データには、目的変数と無関係で値の種類だけが多い高カーディナリティのノイズ列を混ぜてあります。そこを鍵にしてカテゴリごとの平均や標準偏差を取ると、各グループがほぼ個体単位まで細切れになります。残るのは、たまたまの偏りを拾った「それらしいが中身のない」列です。
過学習ギャップの図でも、集約統計量は合成データでギャップを広げる側に振れています。
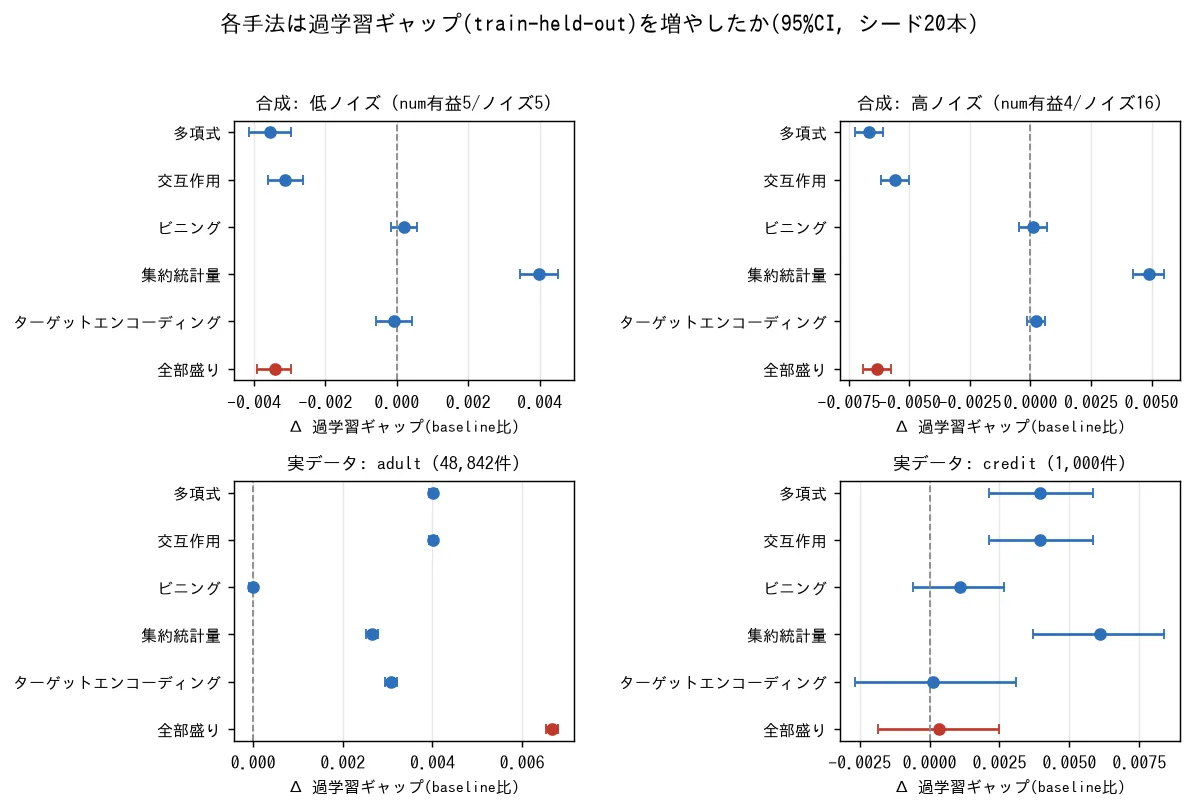
集約統計量は、鍵の列に本物の意味があるときの手法です。種類が多いだけの列に機械的にかけると逆効果になりやすい、と読めます。
同じデータで、足した列の中身によって精度も暗記も真逆に動いた
平均の数字だけだと、手法の良し悪しが同じデータの中でどれだけ分かれるかまでは伝わりません。合成・高ノイズの1データで見ると、全部盛りは held-out を+0.0067改善しつつ過学習ギャップを0.0063縮めました。ところが同じデータに集約統計量だけを足すと、held-out は逆に0.0046下がり、過学習ギャップは0.0049広がります。
データもモデルも分割も同じです。違うのは足した列の中身だけで、精度と暗記の度合いがどちらも真逆に動きました。「特徴量を足す」という一言では、起きることが決まらないということです。
実務では、1手法ずつ確かめてから束ねる
実務で意味のある幅で上がったのは合成データの多項式と交互作用だけで、実データ2種ではどちらも小幅の悪化側でした。それでも試す順番の先頭に置くのはこの2つです。合成データでは統計的に割り引いても残る改善(+0.0047 と +0.0070)でしたが、adultでは-0.0010、creditでは-0.0040と下げており、効く保証はありません。足す前後で held-out が動いたか、過学習ギャップが不自然に開いていないかを、自分のデータで対にして確かめてください。
全部盛りは、効く1手法を見つけてから束ねるほうが安全です。今回、全部盛りが伸びたのは中の多項式・交互作用が効いていたからでした。実データadultでは、held-out が動かないまま特徴量数も学習時間も数倍に膨らんでいます。払ったコストに見合う精度が出ているかは、両方を並べれば分かります。
集約統計量とターゲットエンコーディングは、鍵にするカテゴリ列に本物の意味があるかを先に問う。種類が多いだけのノイズ列を鍵にすると、集約統計量は今回3データで held-out を下げました。ターゲットエンコーディングのほうは、正しく out-of-fold で符号化しないとスコアが甘く出ます。実装のリーク統制も併せて確認してください。
詳しい検証条件
数値はすべて、実際に実行して保存したログを集計したものです。層化5-fold交差検証(各foldで層=クラス比を保って分割)を20個の乱数シード(42〜61)で回し、その平均を各セルの値としています。このシードが変えるのは交差検証の分割の仕方だけで、データそのもの(合成データの生成を含む)は固定です。
ターゲットエンコーディングには落とし穴があります。素朴に全データでカテゴリごとの平均を取ると、目的変数が特徴に漏れてスコアが甘く出ます。今回は学習fold内で out-of-fold に符号化し、検証foldのラベルを一切使わないやり方に統一しました。このリークの怖さはデータリークの罠5パターンで別途実測しています。
健全性チェックとして、ノイズ列だけを単独でこのやり方で符号化したときの検証AUCも見ています。値は約0.4966で、当て推量の0.5とほぼ同じ。リークが乗っていないことを確認できました。
差の強さは3語で表しています。「改善を確認できた」(統計的に割り引いても残る差)、「測定値は高かった」(点推定の言及)、「明確な差を確認できなかった」(割り引くと消える差)。いずれも ROC-AUC の実数値と効果量を添えて読んでください。
読み飛ばし可: 統計手法・効果量・取得元
- 独立単位はデータ分割のシード20本(42〜61)で、各処置×データについて baseline との差(対応あり)を評価しました。検定はWilcoxon符号順位検定(両側)。多重比較はBonferroni補正を主報告、Holm法を副報告とし、実施した24比較(6条件×4データ)のうち15比較で補正後も差が残りました(どちらの方法でも判定は一致します)。
- 効果量は対応ありのCohen’s d(d>0.8を大きい差の目安とします)。ブートストラップ信頼区間(B=10,000、seed=42)は「分割に対する推定の不確実性」であって学習時間のばらつきではありません。n=20では符号が一貫していれば僅差でも有意になりうるので、判定は必ず効果量と併せて読んでください。
- 「差を確認できた/できなかった」の判定の考え方はデータリークの罠5パターンと揃えています。
- 各手法のパラメータは一意に固定しています(多項式・交互作用はdegree=2、ビニングは分位で10区間、集約統計量はカテゴリ別の平均・標準偏差、ターゲットエンコーディングは学習fold内5-foldのOOF+平滑化)。データはpmlbから取得し、取得元のコミットは固定して、取得時の来歴も実行ログに残しています。
適用範囲と限界
- 適用範囲: LightGBMを既定設定で使った、数値化済みのテーブルデータでの傾向です。木系は無関係な列に頑健なので全部盛りが壊れにくいという結論は、線形モデルや距離ベースの手法には当てはまりません。多項式や交互作用は線形モデルで効きやすいと言われますが、今回測ったのはGBDTだけで、そこでの効き方は変わりえます。
- 件数と性格への依存: 実データはadult(約4.9万件)とcredit(1,000件)の2点で、creditはシード間のばらつきが大きく傾向を強くは言えません。「効くのは数値信号が豊富なデータ」という像は主に合成データで観察したもので、あらゆる実データへの一般化ではありません。
- 範囲外: 作った後に列を削る特徴量選択は測っていません。測ったのは「作って足す」効果だけです。BMIのようなドメイン知識由来の手作り特徴も対象外で、今回扱ったのは汎用の機械的変換に限られます。
- 学習時間はこの環境のウォールクロック実測で、CPU4コア・GPUなしに依存します。GPU学習は測っていません。
サンプル実装
make_classification の合成データで、baseline と全部盛りを層化5-fold交差検証で比べ、held-out ROC-AUC・過学習ギャップ・特徴量数を出す最小デモです。ここでの全部盛りは多項式・ビニング・out-of-fold ターゲットエンコーディングの3つで、ターゲットエンコーディングは学習fold内で符号化し検証foldのラベルを使いません。リークを作らない書き方をそのまま見せています。make_data を自分のデータに差し替えれば同じ比較ができます。
"""baseline と全部盛りを層化5-fold CVで比較する最小デモ(コピペで動く)。"""
import numpy as np
import pandas as pd
from lightgbm import LGBMClassifier
from sklearn.datasets import make_classification
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import StratifiedKFold
from sklearn.preprocessing import KBinsDiscretizer, PolynomialFeatures


def make_data(seed=0, n=6000):
    # 数値の有益列5本+ノイズ列5本+yに弱く相関するカテゴリ+高カーディナリティのノイズカテゴリ
    Xnum, y = make_classification(
        n_samples=n, n_features=5, n_informative=5, n_redundant=0,
        weights=[0.7, 0.3], class_sep=0.8, flip_y=0.03, random_state=seed,
    )
    rng = np.random.default_rng(seed)
    df = pd.DataFrame(Xnum, columns=[f"num_inf_{i}" for i in range(5)])
    for i in range(5):
        df[f"num_noise_{i}"] = rng.normal(size=n)          # yと無関係
    latent = y + rng.normal(scale=1.2, size=n)
    df["cat_inf"] = np.digitize(latent, np.quantile(latent, [.2, .4, .6, .8]))
    df["cat_hcnoise"] = rng.integers(0, 200, size=n)        # 高カーディナリティのノイズ
    numeric = [c for c in df.columns if c.startswith("num_")]
    categorical = ["cat_inf", "cat_hcnoise"]
    return df, y, numeric, categorical


def _smoothed(cat, y, gmean, m):
    # カテゴリ別の平均を全体平均へ引き寄せる(少数カテゴリの暴走を抑える)
    d = pd.DataFrame({"c": cat.to_numpy(), "y": y}).groupby("c")["y"].agg(["mean", "count"])
    return (d["count"] * d["mean"] + m * gmean) / (d["count"] + m)


def oof_target_encode(tr_col, ytr, va_col, seed, m=10.0):
    # 学習foldは内側5-fold OOFで符号化、検証foldは学習fold全体の平滑化写像を使う
    gmean = ytr.mean()
    tr_enc = np.full(len(tr_col), gmean)
    inner = StratifiedKFold(5, shuffle=True, random_state=seed)
    tr_col = tr_col.reset_index(drop=True)
    for itr, ite in inner.split(tr_col, ytr):
        s = _smoothed(tr_col.iloc[itr], ytr[itr], gmean, m)
        tr_enc[ite] = tr_col.iloc[ite].map(s).fillna(gmean).to_numpy()
    full = _smoothed(tr_col, ytr, gmean, m)
    va_enc = va_col.reset_index(drop=True).map(full).fillna(gmean).to_numpy()
    return tr_enc, va_enc


def build_baseline(Xtr, Xva, ytr, numeric, categorical, seed):
    cols = numeric + categorical
    return Xtr[cols].to_numpy(float), Xva[cols].to_numpy(float)


def build_all(Xtr, Xva, ytr, numeric, categorical, seed):
    # 全部盛り: 多項式(2次)+ビニング+OOFターゲットエンコーディング、すべて学習foldでfit
    pf = PolynomialFeatures(degree=2, include_bias=False)
    poly_tr = pf.fit_transform(Xtr[numeric]); poly_va = pf.transform(Xva[numeric])
    kb = KBinsDiscretizer(n_bins=10, encode="ordinal", strategy="quantile", subsample=None)
    bin_tr = kb.fit_transform(Xtr[numeric]); bin_va = kb.transform(Xva[numeric])
    te_tr, te_va = [], []
    for c in categorical:
        a, b = oof_target_encode(Xtr[c], ytr, Xva[c], seed)
        te_tr.append(a); te_va.append(b)
    cat_tr = Xtr[categorical].to_numpy(float); cat_va = Xva[categorical].to_numpy(float)
    tr = np.hstack([poly_tr, cat_tr, bin_tr, np.column_stack(te_tr)])
    va = np.hstack([poly_va, cat_va, bin_va, np.column_stack(te_va)])
    return tr, va


def evaluate(build_fn, df, y, numeric, categorical, seed=42):
    skf = StratifiedKFold(5, shuffle=True, random_state=seed)
    tr_aucs, va_aucs, nfeat = [], [], 0
    for tr, va in skf.split(df, y):
        Xtr, Xva, ytr, yva = df.iloc[tr], df.iloc[va], y[tr], y[va]
        Ftr, Fva = build_fn(Xtr, Xva, ytr, numeric, categorical, seed)
        nfeat = Ftr.shape[1]
        m = LGBMClassifier(random_state=seed, n_jobs=1, verbose=-1).fit(Ftr, ytr)
        tr_aucs.append(roc_auc_score(ytr, m.predict_proba(Ftr)[:, 1]))
        va_aucs.append(roc_auc_score(yva, m.predict_proba(Fva)[:, 1]))
    return np.mean(va_aucs), np.mean(tr_aucs) - np.mean(va_aucs), nfeat


if __name__ == "__main__":
    df, y, numeric, categorical = make_data(seed=0)
    for label, fn in [("baseline", build_baseline), ("all(全部盛り)", build_all)]:
        auc, gap, nf = evaluate(fn, df, y, numeric, categorical)
        print(f"{label:14s} held-out ROC-AUC={auc:.4f} 過学習ギャップ={gap:.4f} 特徴量数={nf}")
上のコードを quickstart.py として保存し、必要なライブラリを入れて実行します。
pip install lightgbm==4.7.0 scikit-learn==1.9.0 numpy==1.26.4 pandas==2.3.3
python quickstart.py
この合成データでは、baseline の held-out ROC-AUC が約0.9330に対して全部盛りが約0.9355とわずかに高く、特徴量数は12から79へ増えました(過学習ギャップも同じ行に出力されます)。本文の全部盛りはここに集約統計量も加えたもので、実データでは同じようには効きません。
まとめ: 壊れはしないが、ただでもない
「盛るほど壊れる」は今回は起きませんでした。木系は無関係な列に頑健で、壊れる代わりにコストだけが乗ります。ただし、どこまで確信できるかはデータで割れました。合成2種では全部盛りが20シードすべてで held-out を上げた一方、実データ2つには実務で気づける幅の改善が1つもありません。adultはその典型で、精度が動かないまま特徴量と学習時間だけが膨らみました。
検証前の2つの仮説と突き合わせると、adultの姿は「held-out を上げずコストだけが増える」という仮説のとおりです。外れたのは、改善した合成2種と、リークさえ潰せば効くと踏んでいたターゲットエンコーディングです。手法が効くかどうかより、効く条件のほうを読み違えていました。
手を動かすなら、サンプル実装を自分のデータで回すところから。足した列が held-out を動かすか、過学習ギャップと学習時間がどれだけ増えるかを対で確かめれば、全部盛りが得かどうかは自分のデータで判定できます。不均衡なデータで正例側の当たりを見るなら不均衡データ手法の実測も参考になります。木系以外のモデルや、作った後に列を削る工程は今回測っていないので、手法を足したときは同じ条件で測り直します。