
機械学習の評価スコアが急に上がったとき、それが本当の実力なのか、手順のミスなのかはすぐには見分けられません。前処理の順番を間違えても、コードはエラーを出さず、手元のスコアだけが良くなるからです。
今回は、正解と何の関係もない乱数の列を1本だけ用意して、わざとその間違いを再現してみました。すると、この役に立たないはずの列だけで、手元の評価スコアが0.795まで上がりました。使ったのはAUCという指標で、1に近いほどよく当たっていて、当てずっぽうなら0.5付近になります。
ところが、変換にも学習にも一度も使っていない別のデータで同じ列を評価すると、0.499でした。つまり、この列には実力がまったくありません。原因は、カテゴリを数値へ置き換えるときに、評価用データの正解まで平均の計算へ混ぜてしまったことです。
先に結論: 危ないのは1カテゴリあたりの件数が少ない列
- 全4,000件を1,000カテゴリに分けた条件では、目的変数と無関係な乱数の列でも、全データからカテゴリ平均を作ると交差検証のAUCが0.795まで上がった
- 見かけのスコアが膨らむ向きを決めたのは1カテゴリあたりの件数。ただし1カテゴリ約20件になる条件を2通り作ると、見かけと実力の差は+0.085と+0.063に分かれ、件数だけを安全基準にはできない
- カテゴリ平均を全体平均へ引き寄せる平滑化は途中で頭打ちになり、リークを消す手段にはならなかった
- 評価対象の行を平均の計算から外す実装(out-of-fold、以下OOF)なら、無関係な列のAUCは0.5付近へ戻り、明確な盛れを確認できなくなった
ターゲットエンコーディングと「盛れ幅」の意味
Pythonで分類モデルを学習し、交差検証で精度を測ったことがあれば読めます。ターゲットエンコーディング自体を使ったことがなくてもかまいません。
ターゲットエンコーディング(以下TE)は、カテゴリ列を、そのカテゴリごとの目的変数の平均で数値に置き換える前処理です。この置き換えを符号化と呼びます。カテゴリAに陽性が多ければ、Aには大きな値が割り当てられます。カテゴリ列が取る値の種類数は水準数(カーディナリティ)と呼び、同じデータ件数なら、水準数が多いほど1カテゴリに属するデータは少なくなります。
平均を作るデータの範囲を誤ると、評価対象の正解まで特徴量へ混ざります。これがこの記事で扱うデータリークです。分割前の全データからカテゴリ平均を計算する実装をここでは素朴TE、評価する行を含まないデータだけで平均を作る実装をOOF TEと呼び分けます。
スコアは2種類を並べます。1つは交差検証のAUCで、データを5組に分け、4組で学習して残る1組を評価する処理を交代で繰り返した平均です。もう1つは、符号化にも学習にも使わず評価専用に取り分けた独立ホールドアウトのAUCです。この2つの差、つまり交差検証AUCから独立ホールドアウトAUCを引いた値を、この記事では盛れ幅と呼びます。正なら、交差検証のスコアが実力より高く見えている状態です。
盛れ幅が偶然のばらつきを考慮しても0より大きい場合を「盛れが残った」、0をまたぐ場合を「明確な盛れを確認できなかった」と書きます。後者は安全性の証明ではありません。
正解が分かっている列を使い、条件を1つずつ変えた
確かめたかったのは3点です。素朴TEが評価をどれだけ押し上げるか、その大きさが何で決まるか、そしてOOFに替えれば戻るか。
主役は、正解との関係が最初から分かっている合成データです。目的変数と無関係な一様乱数のカテゴリ列cat_noiseと、目的変数に弱く相関する値を10カテゴリに分けたcat_infを用意しました。前者は情報を持たない列、後者は情報を持つ列です。どちらの場合も、学習器へ渡すのは符号化後の1列だけで、ほかの特徴は加えていません。分類器は勾配ブースティング決定木のライブラリであるLightGBMで、設定は既定のままです。
盛れ幅を左右しそうな条件は、水準数、平滑化の強さ、データ件数の3つです。一度に変える条件は1つにし、残りは代表となる値に固定しました。実データで同じ向きが出るかは、adultでも1点だけ確認しています。
実験前は、素朴なTEなら高水準数の条件でAUCが0.60程度まで上がると見込んでいました。実測すると、代表条件では想定より小さく、水準数が高く1カテゴリあたりの件数が少ない条件では想定を上回りました。
分割やシードの細かい設定は、記事後半の「詳しい検証条件」にまとめてあります。素朴なTEで正解が特徴へ混ざる仕組みそのものはデータリークの罠5パターンで扱っているため、ここでは盛れ幅を変える条件とOOFの効果に絞ります。
水準数・件数・平滑化で盛れ幅がどう動いたか
盛れ幅の大きさを決めていたのは、水準数そのものではなく1カテゴリあたりの件数でした。ただし、その件数だけでは決まりきらない場面もあります。後半では、盛れる仕組みを1シードの中身と実データでも確かめます。
代表条件でも素朴TEに+0.021の盛れが残った
代表条件では、素朴TEの交差検証AUCが0.525、独立ホールドアウトが0.503でした。目的変数と無関係な乱数カテゴリしか渡していないのに、実力のない列が少しだけ効いているように見える状態です。
ただし、無情報な列のAUCは0.5の上下へ自然に振れます。少し0.5を超えただけではリークと判断できないので、同じ列を独立ホールドアウトでも評価し、差が残るかを見ます。代表条件は水準数100・4,000件・平滑化なしです。
| 実装 | 見かけの検証AUC | ホールドアウトAUC | 盛れ幅 |
|---|---|---|---|
| 素朴TE(全データ平均) | 0.525 | 0.503 | +0.021 |
| OOF TE | 0.500 | 0.501 | -0.002 |
素朴TEの盛れ幅は、偶然のばらつきを考慮しても0より大きい結果でした。つまり、交差検証のスコアだけを見ている限り、実力のない列を有効だと誤認します。評価対象を平均の計算から外したOOF TEの側は0をまたぐので、この条件では明確な盛れを確認できません。
素朴TEでは、全データから平均を作る時点で各行のラベルが自分の符号化値へ混ざり、検証対象のラベルまで特徴へ漏れます。前処理を分割前の全データで学習して交差検証だけが高く見える構図はTEに限らず、交差検証の前に特徴選択やSMOTEを当てた検証でも同じ向きの盛れを実測しています。
水準数を上げるほど盛れは急に大きくなった
水準数を5から1,000まで上げると、見かけの検証AUCは0.501から0.795へ動きました。ホールドアウト側はどの水準でも約0.50のままなので、上乗せされた分はまるごと見かけです。
4,000件・平滑化なしで、無関係な列を素朴TEで符号化した結果です。
| 水準数 | 1カテゴリあたり | 見かけの検証AUC | 盛れ幅 |
|---|---|---|---|
| 5 | 約800件 | 0.501 | -0.001 |
| 20 | 約200件 | 0.500 | -0.003 |
| 50 | 約80件 | 0.507 | +0.004 |
| 100 | 約40件 | 0.525 | +0.021 |
| 200 | 約20件 | 0.585 | +0.085 |
| 1000 | 約4件 | 0.795 | +0.296 |
この実験範囲では水準数50まで明確な盛れを確認できず、200から増加しました。リークしたままの実装でも、50水準以下なら交差検証AUCは0.5からほとんど動きません(4,000件、水準数だけを変えた範囲)。 逆に、最も高い水準数1,000の盛れ幅+0.296は、実力のない列がそこそこ効く特徴のように見えてしまう大きさです。ここから、手元のカテゴリ列を点検するなら水準数の多い列から先に疑う、という順番が立ちます。
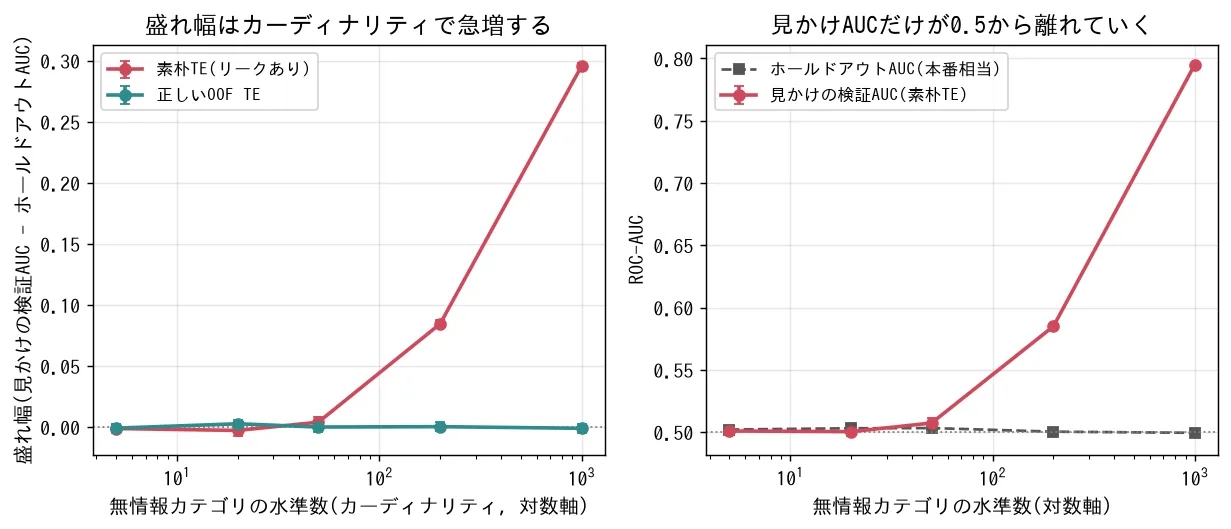
水準数を増やすと、同時に1カテゴリあたりの件数が減ります。数件しか属さないカテゴリでは、カテゴリ平均に各行自身のラベルが強く反映され、符号化値が正解ラベルに近づきます。この2つの要因を分けるため、次は水準数を固定してデータ件数だけを変えました。
件数を増やすと盛れは縮んだが、件数だけでは決まらなかった
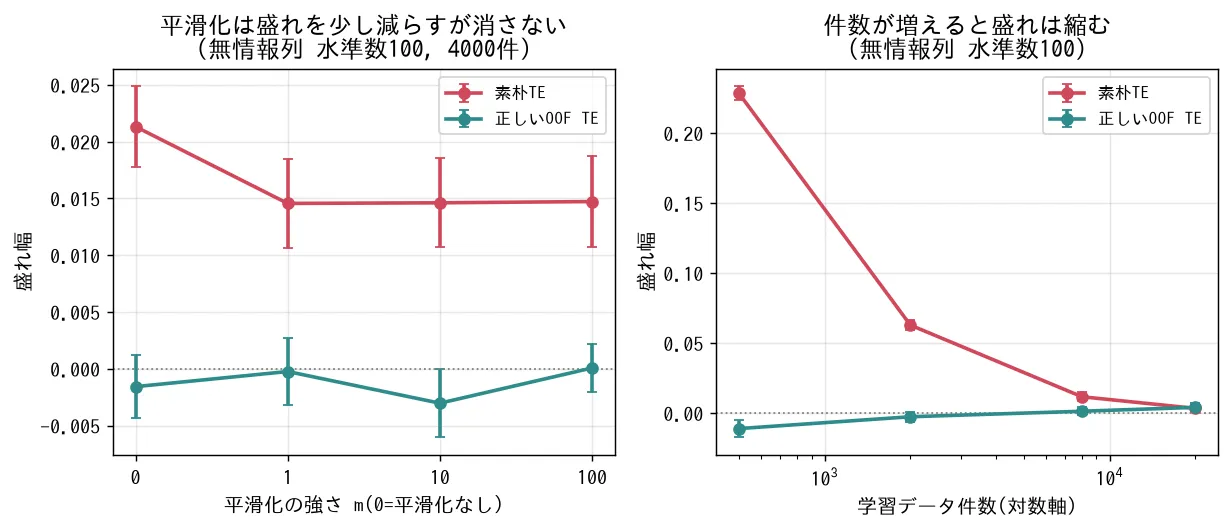
水準数を100に固定して件数だけを増やすと、盛れ幅は500件の+0.229から20,000件の+0.003まで縮みました。同じ現象を件数の側から見た形で、1カテゴリあたりの件数は真っ先に確認する価値のある手がかりです。
| 件数 | 1カテゴリあたり | 見かけの検証AUC | 盛れ幅 |
|---|---|---|---|
| 500 | 約5件 | 0.730 | +0.229 |
| 2,000 | 約20件 | 0.568 | +0.063 |
| 4,000 | 約40件 | 0.525 | +0.021 |
| 8,000 | 約80件 | 0.511 | +0.012 |
| 20,000 | 約200件 | 0.503 | +0.003 |
4,000件の行は代表条件の再掲です。20,000件の+0.003は偶然のばらつきを考慮すると0をまたぐため、ここでは明確な盛れを確認できていません。水準数を増やした場合と件数を減らした場合に共通していたのは、1カテゴリあたりの件数が少なくなるほど盛れ幅が大きくなる向きです。
一方で、この件数だけから盛れ幅を予測することはできませんでした。1カテゴリあたりが同じ約20件になる条件を水準数側と件数側から1つずつ作ると、盛れ幅は+0.085と+0.063に分かれ、偶然のばらつきを考慮しても2つは区別できました。同じ約80件どうしの2条件(+0.004と+0.012)は区別できず、こちらは差の証拠になりません。
つまり、1カテゴリあたりの件数は優先して確認できる手がかりですが、水準数や件数分布を無視した安全基準ではありません。 件数分布そのものを見ないと、どの列が危ないかまでは絞り込めません。
読み飛ばし可: 1カテゴリあたりの件数を揃えた4条件の95%信頼区間
約80件どうしの比較も含めた4条件です。
| 条件 | 1カテゴリあたり | 盛れ幅 | 95%信頼区間 |
|---|---|---|---|
| 水準数200・4,000件 | 約20件 | +0.085 | 0.079〜0.091 |
| 水準数100・2,000件 | 約20件 | +0.063 | 0.056〜0.070 |
| 水準数50・4,000件 | 約80件 | +0.004 | -0.004〜0.012 |
| 水準数100・8,000件 | 約80件 | +0.012 | 0.006〜0.017 |
同じ約20件どうしでは区間が重なりません。同じ約80件どうしでは区間が重なるので、こちらは2条件に差がある証拠になりません。
平滑化を強めても盛れは頭打ちのまま残った
平滑化は、件数の少ないカテゴリの平均を全体平均へ近づけ、ばらつきを抑える処理です。引き寄せる強さをパラメータmで指定します。
先に判断を書くと、平滑化はOOFの代わりになりませんでした。少数カテゴリのばらつき対策としては使えても、リークを消す手段としては当てにできません。
代表条件でmを0、1、10、100と増やすと、盛れ幅は最初に+0.021から約+0.015へ下がり、そこから先は変わりませんでした。平滑化を強めれば盛れも減り続けるという実験前の予想とは、違う結果です。
この頭打ちは、AUCが値の大きさではなく予測の順位を評価する性質と整合します。カテゴリごとの件数がほぼ揃う今回の条件では、平滑化しても符号化値の順位がほぼ保たれます。学習器へ渡した特徴もこの1列だけなので、値を全体平均へ近づけても木の分割と予測順位が変わらず、リークが残ったと解釈できます。ここは結果からの解釈で、計算過程を個別に追って機序を直接検証したわけではありません。
OOFでは無関係な列の明確な盛れを確認できず、役に立つ列の実力は残った
実務で効くのはここです。素朴TEとOOFで違うのは符号化を分割の内側で行うかどうかだけで、パラメータの調整は要りませんでした。
無情報列をOOFで符号化すると、水準数と件数の全条件をまとめた盛れ幅は-0.001となり、偶然のばらつきを考慮すると0をまたぎました。素朴TEで盛れが最大だった水準数1,000でもOOFは0.501で、データを500件まで減らしても0.5付近です。実装をOOFへ替えるだけで、リークの側だけを取り除けたことになります。
有効な情報まで失われていないかは、目的変数と弱く相関する10水準の列で確認しました。OOF TEの独立ホールドアウトAUCは0.754で、無情報列の0.5付近とは明確に異なります。この有情報列は1カテゴリあたりの件数が多く、素朴TEの盛れ幅も+0.004と偶然の範囲でした。ただし有情報列は10水準に固定したままなので、水準数の多い有情報列でも同じとは言えません。
単一シードで中身を見ると、符号化値とラベルの相関は0.49だった
なぜ盛れるのかを、符号化後の値そのものでも確かめました。ここだけは20シードの集計ではなく、水準数1,000・4,000件の条件から1シードを抜き出した観察です。
そのシードでは、実際に現れた981カテゴリのうち約8%が1件だけ、約22%が2件以下のデータしか含みません。1件しか入らないカテゴリでは、符号化値はその行自身のラベルそのものです。2件でも、自分のラベルが値の半分を占めます。
学習に使ったデータでは、符号化値と各行のラベルの相関が0.49になりました。同じ対応表を独立ホールドアウトへ適用すると相関は0.004まで下がります。学習側で作られた関係が、新しいデータではまったく再現していないということです。このシードの交差検証AUCは0.795、ホールドアウトAUCは0.503でした。
実データのadultでも、注入した無情報列は盛れた
合成データの中だけで起きる現象ではありませんでした。adultへ500水準の無情報列を注入すると、素朴TEの盛れ幅は+0.047、OOFでは-0.002で、実データでも向きは同じです。
ただし、大きさは別です。adultは約4万件あるため1カテゴリあたりは約80件で、同程度の件数だった合成条件の+0.012とは合いません。水準数がadultでは500、合成では100と異なり、データ分布も揃っていないため、この違いの原因を実データだからだと決めることはできません。
実在のnative-country(42水準・約4万件)は、素朴・OOFとも盛れ幅がほぼ0でした。ただしこの列は多くの行が少数のカテゴリに集中しており、なぜ盛れなかったかまでは切り分けていません。実データで確かめたのはこの1点だけです。
実務ではOOF符号化と独立ホールドアウトの照合を組にする
最初に見るのは件数分布。水準数で割った平均では足りない 各列について、1カテゴリあたりの件数分布と、1件だけのカテゴリの割合、最大・最小件数まで調べます。1カテゴリあたりが同じ約20件でも盛れ幅は分かれたので、件数を水準数で割った1つの値だけでは判定できません。
符号化はかならず分割の内側へ。平滑化を代わりに置かない 交差検証の各分割で、学習側のデータだけからカテゴリ平均を計算します。学習側の符号化値も自分自身のラベルを含めない内側OOFで作り、評価側には学習側で作った対応表を適用します。平滑化は少数カテゴリのばらつきを抑える目的でなら併用できますが、今回の条件では強度を上げても盛れが残ったため、入れた後も同じ照合が要ります。
自己点検の乱数列は、1カテゴリの件数が少なくなる水準数で作る 目的変数と無関係な乱数カテゴリを1本だけ作り、その列だけを符号化して交差検証AUCを測ります。既存の特徴と混ぜると本物の特徴でAUCが0.5を超えるため、判定の物差しになりません。水準数は、自分のデータ件数で割ったときに1カテゴリあたり数件から十数件へ収まる値にします。件数の多いデータで水準数を小さいまま据え置くと、リークしたままの実装でも交差検証AUCは0.5から動かず、点検が素通りします。
判定するのは差。0.5付近は安全の証明にならない 交差検証AUCから、符号化に一度も使っていないホールドアウトのAUCを引きます。乱数のシードを変えて何度か繰り返し、差が毎回同じ向きに残るかを見ます。差が0をまたぐなら、そこで言えるのは「明確な盛れを確認できなかった」までで、リークが無いことの確認ではありません。
詳しい検証条件: データ・分割・集計の設計
本文の数値はすべて、実際に実行して保存したログから集計しています。
合成データは1条件につき、無情報列cat_noiseか有情報列cat_infのどちらか1列だけを特徴に使います。前者は目的変数と独立な一様乱数、後者は10水準で目的変数に弱く相関させた列です。タスクは2値分類です。
評価は層化5分割交差検証で、各分割の平均を1回分のスコアとしました。独立ホールドアウトは符号化にも学習にも使わない別データで、同じ列を評価しています。データシードは20個(42〜61)で、各5分割の平均を求めたうえで、その20個を集計しました。
AUCは陽性例を陰性例より上位に並べられる度合いなので、予測値の大小ではなく順位だけで決まります。この性質は平滑化の結果を読むときに効いてきます。
変えた条件は水準数、平滑化の強さm、データ件数です。1つを動かすあいだ、残りの2つは代表値へ固定しています。試した値と代表値は下の一覧にまとめました。
実データのadultには、500水準の無情報カテゴリ列を1本注入しました。実在のnative-country列は、そのまま符号化しています。
読み飛ばし可: 統計手法・試した値・取得元・丸め方針
- 平均・95%信頼区間はブートストラップ(1万回、seed=42)で算出しました。この区間は評価サンプルに対する推定の不確実性を表し、実行時間のばらつきではありません。
- 素朴とOOFの盛れ幅の差はWilcoxon符号順位検定(対応あり)で確認しました。補正の対象になる主要な比較はこの1組だけなので、Bonferroni補正でもHolm法でも判定は同じです。
- 各条件で試した値: 水準数は5・20・50・100・200・1000、平滑化 m は0・1・10・100、件数は500・2,000・4,000・8,000・20,000。代表値は水準数100・4,000件・平滑化なしです。
- OOF TEは、検証foldのラベルを使わないよう学習fold内でさらに5分割して符号化しています(内側OOF 5-fold)。
- 実データのadultはpmlb(コミット
7c1f4bdc)から取得しました。取得元のコミットは固定し、取得時の来歴も実行ログに残しています。 - 数値は丸めて表記しています。盛れ幅は丸める前の値から計算しているため、表に並べた見かけAUCとホールドアウトAUCを引いた値と、盛れ幅の列の末尾が一致しない場合があります。
適用範囲と限界
- モデルとタスク: 分類器はLightGBMの既定設定、2値分類だけです。線形モデルや距離ベースのモデルでは符号化値の使われ方が違うため盛れ方も変わりえます。回帰・多クラスのTEは測っていません。one-hotやfrequency encodingとの比較もしていません(主題はTEのリーク量で、符号化手法どうしの優劣ではありません)。
- 変えた条件: 平滑化を試したのはカテゴリごとの件数がほぼ揃う合成条件で、m は100までです。件数の偏りが大きい列なら平滑化はカテゴリごとに違う強さで効くので、話は変わりえます。有情報列は10水準に固定したままで、水準数と件数を変えたのは無情報列だけです。この設計では「列の中身より件数が効く」とまでは一般化できません。
- どこまで持ち出せるか: 主体は正解既知の合成データで、実データはadult1点です。他への一般化は外挿になります。盛れ幅の絶対値もこの合成データの生成条件と件数に紐づいた値なので、手元の列に当てはめられるのは向き(1カテゴリあたりの件数が少ないほど盛れる)までです。
コピペで動く自己点検コード
無情報な乱数カテゴリを使って、素朴TEとOOF TEの見かけAUCを比べる最小デモです。
"""無情報な乱数カテゴリ列で、素朴TE(全データ平均)とOOF TEの
「見かけの検証AUC」を比べる健全性チェック(コピペで動く完全版)。
"""
import numpy as np
import pandas as pd
from lightgbm import LGBMClassifier
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import StratifiedKFold


def make_data(seed=0, n=6000, cardinality=500):
    # y と無関係な高カーディナリティの乱数カテゴリ(=無情報。正解が既知)
    rng = np.random.default_rng(seed)
    y = (rng.random(n) < 0.3).astype(int)
    cat_noise = rng.integers(0, cardinality, size=n)
    return pd.DataFrame({"cat_noise": cat_noise}), y


def smoothed_map(cat, y, gmean, m):
    # カテゴリ別平均を全体平均へ引き寄せる(平滑化)
    d = pd.DataFrame({"c": np.asarray(cat), "y": np.asarray(y)})
    agg = d.groupby("c")["y"].agg(["mean", "count"])
    return (agg["count"] * agg["mean"] + m * gmean) / (agg["count"] + m)


def naive_cv_auc(X, y, col, m=0.0, seed=42):
    # 素朴TE: 全データでカテゴリ平均を計算してから交差検証(検証foldに自分のラベルが混じる)
    y = np.asarray(y)  # pandas Series を渡してもラベル参照にならないよう位置参照へ揃える
    gmean = y.mean()
    enc = X[col].map(smoothed_map(X[col], y, gmean, m)).fillna(gmean).to_numpy()
    aucs = []
    for tr, va in StratifiedKFold(5, shuffle=True, random_state=seed).split(enc, y):
        model = LGBMClassifier(random_state=seed, n_jobs=1, verbose=-1)
        model.fit(enc[tr].reshape(-1, 1), y[tr])
        aucs.append(roc_auc_score(y[va], model.predict_proba(enc[va].reshape(-1, 1))[:, 1]))
    return float(np.mean(aucs))


def oof_cv_auc(X, y, col, m=0.0, seed=42):
    # OOF TE: fold内で符号化、検証foldのラベルは使わない
    y = np.asarray(y)  # pandas Series を渡してもラベル参照にならないよう位置参照へ揃える
    aucs = []
    for tr, va in StratifiedKFold(5, shuffle=True, random_state=seed).split(X, y):
        c_tr, c_va = X[col].iloc[tr].reset_index(drop=True), X[col].iloc[va].reset_index(drop=True)
        ytr = y[tr]
        gmean = ytr.mean()
        tr_enc = np.full(len(c_tr), gmean)
        for itr, ite in StratifiedKFold(5, shuffle=True, random_state=seed).split(c_tr, ytr):
            s = smoothed_map(c_tr.iloc[itr], ytr[itr], gmean, m)
            tr_enc[ite] = c_tr.iloc[ite].map(s).fillna(gmean).to_numpy()
        va_enc = c_va.map(smoothed_map(c_tr, ytr, gmean, m)).fillna(gmean).to_numpy()
        model = LGBMClassifier(random_state=seed, n_jobs=1, verbose=-1)
        model.fit(tr_enc.reshape(-1, 1), ytr)
        aucs.append(roc_auc_score(y[va], model.predict_proba(va_enc.reshape(-1, 1))[:, 1]))
    return float(np.mean(aucs))


if __name__ == "__main__":
    X, y = make_data(seed=0, cardinality=500)
    naive = naive_cv_auc(X, y, "cat_noise")
    oof = oof_cv_auc(X, y, "cat_noise")
    print(f"無情報な乱数カテゴリ(500水準)だけを特徴にした見かけの検証AUC")
    print(f"  素朴TE(全データ平均) : {naive:.4f}  <- 0.5を大きく超えたらリーク")
    print(f"  OOF TE               : {oof:.4f}  <- 0.5付近は「明確な盛れなし」まで(安全の証明ではない)")
上のコードを quickstart.py として保存し、必要なライブラリを入れて実行します。
pip install lightgbm==4.7.0 scikit-learn==1.9.0 numpy==1.26.4 pandas==2.3.3
python quickstart.py手元で実行すると、500水準の無情報列だけで素朴TEの見かけAUCが約0.666、OOFで約0.499になります。このデモは6,000件なので、500水準では1カテゴリあたり約12件しかなく、盛れが大きく出る設定です。逆に言えば、このcardinalityを据え置いたまま件数だけ増やすと、リークしたままでも見かけAUCは0.5から動かなくなります。
自分のデータで試すとき: 差し替えるのはラベルと学習の中身だけにして、cat_noise(目的変数と無関係な乱数列)はそのまま残してください。0.5という基準が成立するのは無情報な列に対してだけです。本物の情報を持つ列に置き換えると、リークが無くても正当に0.5を超えるので、判定の物差しが壊れます。
あわせて、cardinalityは自分のデータ件数に合わせて上げてください。目安は1カテゴリあたり十数件以下で、今回の実測では1カテゴリ約80件以上になる水準数5〜50のとき、素朴TEでも明確な盛れを確認できませんでした。そして素朴TE側が0.5付近に収まった場合も、そこで分かるのは明確な盛れを確認できなかったことまでで、自分の実装にリークが無いことの証明にはなりません。
まとめ
この検証で言えるのは、1カテゴリあたりの件数が少ない列ほど素朴なターゲットエンコーディングは盛れやすく、平滑化では盛れが残り、OOFなら無情報列に明確な盛れを確認できなくなる、というところまでです。自分が実務でカテゴリ列を符号化するなら、平滑化を調整する前に、まず符号化を分割の内側へ移します。
意外だったのは平滑化の効き方でした。強くするほど盛れも減っていくつもりでmを上げましたが、途中から動かなくなります。AUCが順位で決まる以上、値を縮めても順位が残れば効かない、という理屈は結果を見てから腑に落ちました。
まだ確かめられていないことも残っています。平滑化の頭打ちはmを100までしか試しておらず、カテゴリごとの件数の偏りが大きい列では効き方が変わりえます。実データはadultの1点だけで、native-country列がなぜ盛れなかったのかも切り分けていません。次に測るなら、水準数の多い有情報列でOOFがどう振る舞うか、そして件数の偏った列で平滑化がどう効くか、この2つからです。
関連記事: リーク全体の見取り図はデータリークの罠5パターン、分類器にLightGBMを選んだ理由はGBDT3種の実測比較にあります。
出典: 実データはpmlb (Penn Machine Learning Benchmarks)(コミット7c1f4bdc、2026-07-23取得、MITライセンス)経由で取得したadultデータセットです。元データは米国国勢調査に基づくUCI Adultで、CC BY 4.0の下で提供されています。これに、目的変数と無関係な乱数カテゴリ列を1本注入して使いました。