
件数や金額を予測するモデルを作ると、予測したい列(目的変数)の大半が0という場面があります。この記事で使った自動車保険の請求データも、67,856行のうち93%は請求額が0でした。残りの数%だけが値を持ち、その中に飛び抜けて高い請求が混ざります。
こうしたデータを、ふつうの回帰と同じ設定のまま学習してよいのかは迷うところです。予測にマイナスが混ざったり、少数の大きな値へ学習が引っぱられたりするからです。
決定木を少しずつ足して予測するLightGBMには、この形のデータ向けの目的関数(学習中に何を誤差と見なすかの設定)が用意されています。PoissonやTweedieがそれで、目的変数をlog1pで小さな尺度へ変えてから学習し、expm1で元へ戻す手もよく使われます。ただし「ゼロが多ければPoisson」「値の幅が広ければ対数変換」と覚えるだけでは、自分のデータにどれを使うか決まりません。
もう一つ見落としやすいのが、予測値の使い道です。各行の予測をそのまま使う場合と、全行を足して総量を見積もる場合では、同じモデルでも評価が変わります。
先に結論: 1行ごとの誤差と合計で、勝つ目的関数が入れ替わる
- 1行ごとの予測誤差を減らしたいなら、Poissonが最初の候補。 ただし改善幅は測る指標しだい。裾が重い(少数の行だけ極端に大きい)条件で、正解の期待値と比べる合成データの相対誤差なら二乗誤差の0.29〜0.46倍だが、同じ予測を実測値に対するRMSEで測ると0.92倍まで縮む。
- 予測を足し上げた合計は、既定の二乗誤差がいちばん正確。 合成データ16条件で、予測合計は本来の合計(生成のしくみから計算できる値)の0.984〜1.008倍。Poissonは0.855〜0.991。
- ゼロの多さだけでは目的関数を決められない。改善幅を大きく分けたのは裾の重さで、ゼロ比率がはっきり効いたのは裾が軽い側。
- log1pで学習してexpm1で戻す手は、合計まで見ないと危険。 ゼロが93%の実データでは、補正なしの予測合計が実測合計の0.5%。
- 適用条件: 合成データ16条件(各10回)と公開データ2件、LightGBM 4.7.0の目的関数9通りを同じ学習設定で比較。統計的検定は行っていない。
目的関数を替えると、学習が優先する誤差が変わる
この記事に出てくる4系統は、名前こそ違っても、変えているのは1点だけです。学習中にどの行の外れを重く数えるか、その基準を差し替えています。入力する特徴量と目的変数が同じでも、基準が変われば、LightGBMが次にどんな木を作るかが変わります。
| 方法 | 何を重く見るか | 主な特徴 |
|---|---|---|
| 二乗誤差(L2・既定) | 大きく外した行 | LightGBMの通常の回帰設定。予測が負になることがあります |
| Poisson | 値の大きさに応じた誤差 | ゼロ以上の件数向けで、予測は負になりません |
| Tweedie | 平均とばらつきの関係をpで調整した誤差 | 0が多く、0より大きい部分が連続値となる金額などを扱えます |
| log1p+expm1 | 対数へ変換した後の二乗誤差 | 大きな値を圧縮できますが、元へ戻した予測が負になる場合があります |
Poissonが想定しているのは、平均が大きい行ほど値のばらつきも大きくなるデータです。件数のように0以上の値が並ぶ場面が対象です。あとで使う合成データも、件数の族はこの想定どおりに作り、金額の族はそこから外れる形にしています。
Tweedieはその考え方を広げたもので、tweedie_variance_power(以下p)を1から2の間で指定します。p=1がPoissonに当たり、2へ近づくほど「0が多く、0より大きい部分は連続値」という金額らしい形を想定します。pを上げれば常に良くなるわけではなく、今回の結果でも有利な値はゼロ比率によって動きました。
log1p+expm1は目的関数ではなく、目的変数を変換して戻す手順です。元の尺度へ戻したときに平均より低い予測へ寄る「逆変換バイアス」があるため、残差から補正倍率を求めるDuanのスミアリング補正も比べました。補正なしのlog1p+expm1は、稀な高値を狙う不均衡回帰の8条件比較でも条件の一つとして測っています。補正倍率は、学習に使った行の残差から求める方法と、学習データを5分割して各行を未学習のモデルで予測した残差から求める方法の2通りです。
LightGBMを選んだ理由は、GBDT3種の実測比較にまとめています。本文と図で使う「L2(既定)」はobjective="regression"で指定する二乗誤差と同じものです。
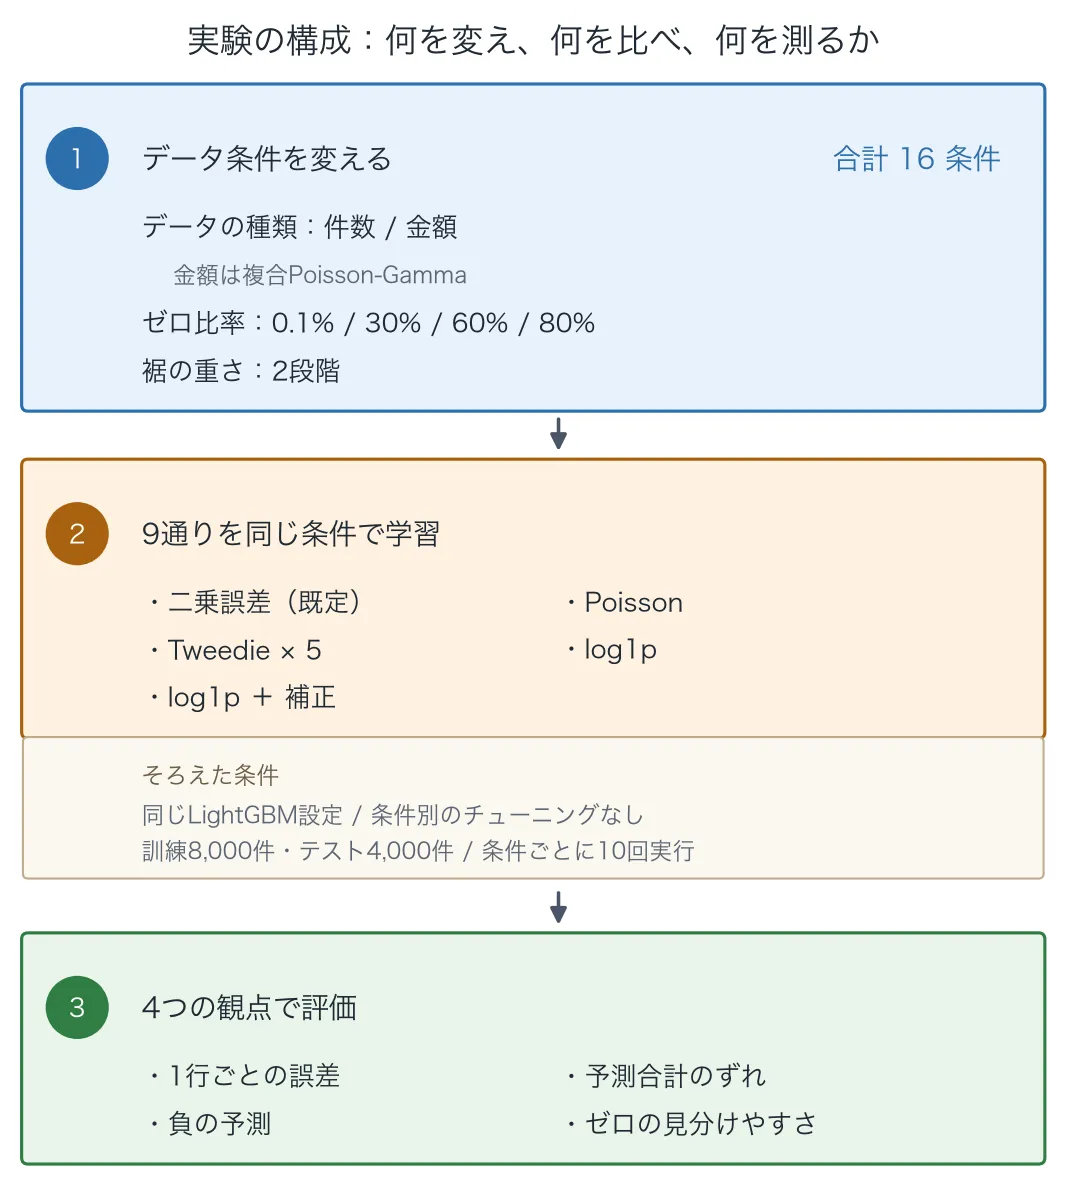
ゼロの多さと裾の重さを別々に振り、9通りを同じ設定で学習した
使ったのは、生成のしくみが分かっている合成データ16条件と、公開されている実データ2件です。合成データには、件数を想定したPoisson分布と、発生件数に1件あたりの金額を掛け合わせる複合Poisson-Gamma分布を使いました。それぞれについてゼロ比率を0.1%・30%・60%・80%の4段階、右側の裾の重さを2段階に振っています。各条件は訓練8,000件、テスト4,000件で、データ生成から10回繰り返しました。
裾の伸びは歪度という数値で確認できます。0に近ければ左右の偏りが小さく、正の値が大きいほど右側へ長く伸びた形です。今回の実測値は、裾が軽い条件で1.5〜4.4、重い条件で11.9〜25.8でした。
合成データを使う利点は、各行で平均的にどの値になるはずか、つまり真の条件付き期待値を計算できることです。実データには正解が1行につき一つしかないため、モデルが低めに予測したのか、たまたま大きな値を観測したのかを切り分けられません。生成のしくみが分かれば、偶然のばらつきとモデルの系統的なずれを分けて調べられます。
実データには、外来受診回数を記録したNMES1988と、自動車保険の請求金額を記録したdataCarを使いました。NMES1988は4,406件でゼロ15.5%・歪度3.3、dataCarは67,856件でゼロ93.2%・歪度17.5です。どちらも学習70%・評価30%の分割を10通り作りました。
比べた9通りは、二乗誤差、Poisson、pを1.1から1.9まで変えたTweedie 5通り、log1p+expm1、訓練データの残差を使ったスミアリング補正です。学習設定は全条件でそろえ、条件別の調整は行っていません。
評価項目は次の4種類です。
- 1行ごとの誤差: 合成データでは、予測が真の期待値から何割ずれたかを平均した相対誤差とRMSE。実データでは、実測値に対するRMSEとMAEを使います。
- 予測合計のずれ: 予測合計を、合成データでは真の期待値合計、実データでは実測合計で割ります。1.0なら一致、0.8なら総量を約20%少なく見積もった状態です。
- ゼロの見分けやすさ: 予測値の小ささで実測値0の行を順位づけしたROC-AUC(0.5ならでたらめに並べたのと同じ、1.0なら完全に分けられる指標)と、実測値0の行に対する平均予測を確認します。
- 負の予測: 件数や金額としてそのまま使えない、0未満の予測が出た割合を数えます。
当初はTweedie devianceを主指標にしていました。devianceは当てはまりの悪さを表す損失で、想定する分布ごとに物差しが変わります。ところが、負の予測をどの値まで切り上げるかによって数値が大きく変わりました。そこでdevianceは目的関数どうしの順位確認に限り、結論には下限処理のいらない相対誤差、合計比、実測RMSE、MAEを使っています。
比べているのはLightGBMの目的関数の中での選択で、ゼロが多いデータ向けの専用モデルは入れていません。データの作り方や学習設定の細かい条件は、記事の後半にまとめました。
1行ごとの誤差は、裾が重いほどPoissonが下げた
相対誤差は、裾が重い条件で二乗誤差の3〜4割まで落ちた
裾が重い条件では、Poissonの誤差が二乗誤差の半分以下になりました。ただし、効いていたのは「ゼロの多さ」ではありません。手元のデータで替えるかどうかを決めるときは、ゼロの割合より先に、一部の行だけ極端に大きい形になっていないかを見ます。
次の表は二乗誤差を1.0とした相対誤差の比で、0.6なら相対誤差が二乗誤差の6割だったことを表します。数値は10回の平均どうしを割ったもので、小さいほど良い結果です。
| シナリオ | Poisson | Tweedie p=1.3 | log1p+expm1 | log1p+スミアリング(訓練内残差) |
|---|---|---|---|---|
| 計数・歪み強・ゼロ0.1% | 0.425 | 0.201 | 0.190 | 0.192 |
| 計数・歪み強・ゼロ80% | 0.443 | 0.471 | 0.635 | 0.612 |
| 計数・歪み弱・ゼロ80% | 0.666 | 1.016 | 0.976 | 0.826 |
| 金額・歪み強・ゼロ0.1% | 0.290 | 0.140 | 0.125 | 0.126 |
| 金額・歪み強・ゼロ80% | 0.359 | 0.369 | 0.486 | 0.484 |
| 金額・歪み弱・ゼロ80% | 0.600 | 0.873 | 0.982 | 0.705 |
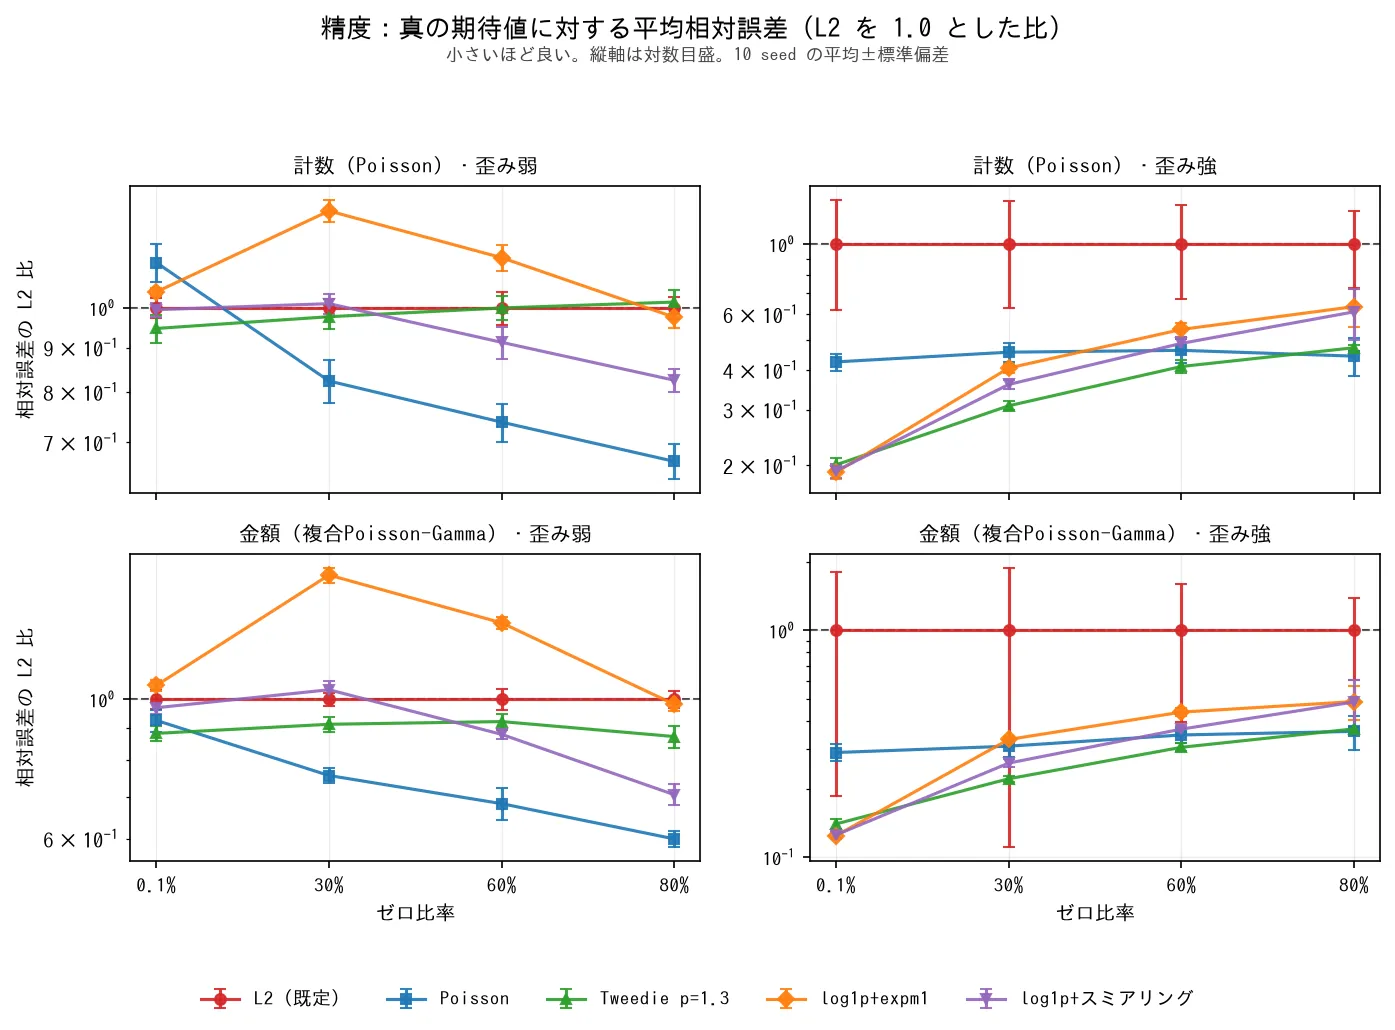
改善幅を大きく分けたのは、ゼロ比率より裾の重さでした。 ゼロが0.1%しかない条件でも、歪度が20を超えるとPoissonの相対誤差は二乗誤差の0.43倍・0.29倍まで下がっています。反対に歪度2〜4程度では、ゼロが80%あっても0.60〜0.67倍でした。実験前の「ゼロが多いほどPoissonが有利」という予想は、この結果を受けて「ゼロ比率と裾の重さを分けて確認する」へ変わりました。
なお、この相対誤差を計算できるのは真の期待値が分かっている合成データだけです。実データでの誤差は、目的関数に中立な実測RMSEとMAEで見ます。
裾が軽い側では、ゼロが増えるほど効きが強まった
裾が軽い条件だけを取り出すと、今度はゼロ比率が素直に効きます。Poisson目的関数の相対誤差をゼロ比率の順に並べ直すと、単調に下がりました(二乗誤差=1.0)。
| 歪みが弱い側 | ゼロ0.1% | ゼロ30% | ゼロ60% | ゼロ80% |
|---|---|---|---|---|
| 計数(歪度1.5〜2.3) | 1.128 | 0.824 | 0.739 | 0.666 |
| 金額(歪度2.7〜4.4) | 0.926 | 0.757 | 0.683 | 0.600 |
例外は左上の1.128です。件数データで裾が軽く、ゼロもほとんどない場合、Poissonの相対誤差は二乗誤差より約1割増えました。Poissonが二乗誤差を下回らなかったのは、16条件のうちこの1条件だけです。裾が重い側ではゼロ比率を変えても差が小さく、比の幅は0.037〜0.069に収まっています。
この単調な下がり方が出たのは、PoissonとTweedie p=1.1だけでした。Tweedieはpの高い側ほど逆を向き、裾が軽い条件ではゼロが増えるほど比が上がっていきます。裾が軽い側に限れば、p=1.5以上はゼロが多い条件で既定より悪くなります。計数・歪み弱のp=1.9はゼロ0.1%の0.959からゼロ80%の1.882まで上がり、既定のまま使うより誤差がおよそ倍でした。log1pして戻す2条件は上下して定まりません。
16シナリオのばらつきを、どの条件がどれだけ説明しているかで割り振っても、同じ向きが出ます。相対誤差で測るかぎり、歪みの取り分が73〜95%(Poissonでは73.6%)で、ゼロ比率はPoissonで7.6%でした。ただし、この取り分は指標を替えると変わります。
Poissonの改善幅は、指標を替えると0.29倍から0.92倍まで動いた
同じ予測でも、どの指標で測るかによって「どれだけ良くなったか」が大きく変わります。つまり、他社の記事や社内の過去資料と改善幅を比べるときは、指標をそろえないと話が噛み合いません。
金額・裾が重い・ゼロ0.1%のPoissonと二乗誤差の比は、相対誤差で0.290、実測RMSEで0.924、MAEで0.740でした。真の期待値に対するRMSEを含めた4指標で測り直しても、順位の付き方は指標ごとに違います。
差が生まれる理由は、各指標が重く数える行にあります。二乗誤差で学習したモデルでは、真の期待値が最も小さい1割の行が相対誤差全体の60.8%を占める一方、二乗した誤差では0.99%にすぎません。二乗した誤差の88.0%は、真の期待値が最も大きい1割の行から生じています。
4指標とも、Poissonの平均が二乗誤差を下回った条件は同じ15件でした。ただし、10回すべてで下回った条件数は異なります。
| 指標 | 平均で下回った条件(16中) | うち10回とも下回った条件 |
|---|---|---|
| 相対誤差 | 15 | 15 / 15 |
| 期待値RMSE | 15 | 6 / 15 |
| 実測RMSE | 15 | 5 / 15 |
| MAE | 15 | 14 / 15 |
二乗誤差を下回らなかった1条件も4指標で共通です。実測RMSEでは10回すべて下回ったのが5条件に限られ、金額・裾が軽い・ゼロ0.1%と、件数・裾が重い・ゼロ60%では10回中4回でした。平均だけでは方向が安定しているか分からないため、手元のデータでも実際に使う指標を複数の分割で比べます。RMSEとMAEのどちらを主指標にするかの考え方は、RMSE・MAE・MAPEの選び方の比較に整理しています。
ここまでは誤差を下げる話でした。予測合計だけは、これと反対の結果になります。
予測を足し上げると、既定の二乗誤差がいちばん正確だった
合成16条件のすべてで、二乗誤差の合計比が最も1.0に近かった
1行ごとの誤差とは反対に、予測合計では既定の二乗誤差が最も安定しました。1行ごとの誤差が小さい方法でも、足し上げた合計まで正確とは限りません。 合計を使う処理では、RMSEやMAEとは別に合計比を確認する必要があります。
予測合計を真の期待値合計で割った比は、全16条件で0.984〜1.008でした。Poissonは0.855〜0.991で、Tweedieはpを上げるほど1.0から下へ離れています。
合計を最も大きく外した方法は、ゼロ比率によって変わりました。ゼロが少ない側ではlog1p+expm1、6割を超えるあたりからはpの大きいTweedieへ移り、ゼロ80%の4条件ではすべてp=1.9が最下です。全16条件で見ると、p=1.9は0.256〜0.978、log1p+expm1は0.505〜0.957でした。次の表には、裾が重い金額データの4条件を示します。
| 手法 | ゼロ0.1% | ゼロ30% | ゼロ60% | ゼロ80% |
|---|---|---|---|---|
| 二乗誤差(既定) | 0.984 | 0.987 | 0.993 | 0.995 |
| Poisson | 0.899 | 0.903 | 0.892 | 0.855 |
| Tweedie p=1.3 | 0.901 | 0.873 | 0.805 | 0.655 |
| Tweedie p=1.9 | 0.896 | 0.811 | 0.625 | 0.334 |
| log1p+expm1 | 0.893 | 0.740 | 0.620 | 0.533 |
| log1p+スミアリング(訓練内残差) | 0.906 | 0.886 | 0.775 | 0.691 |
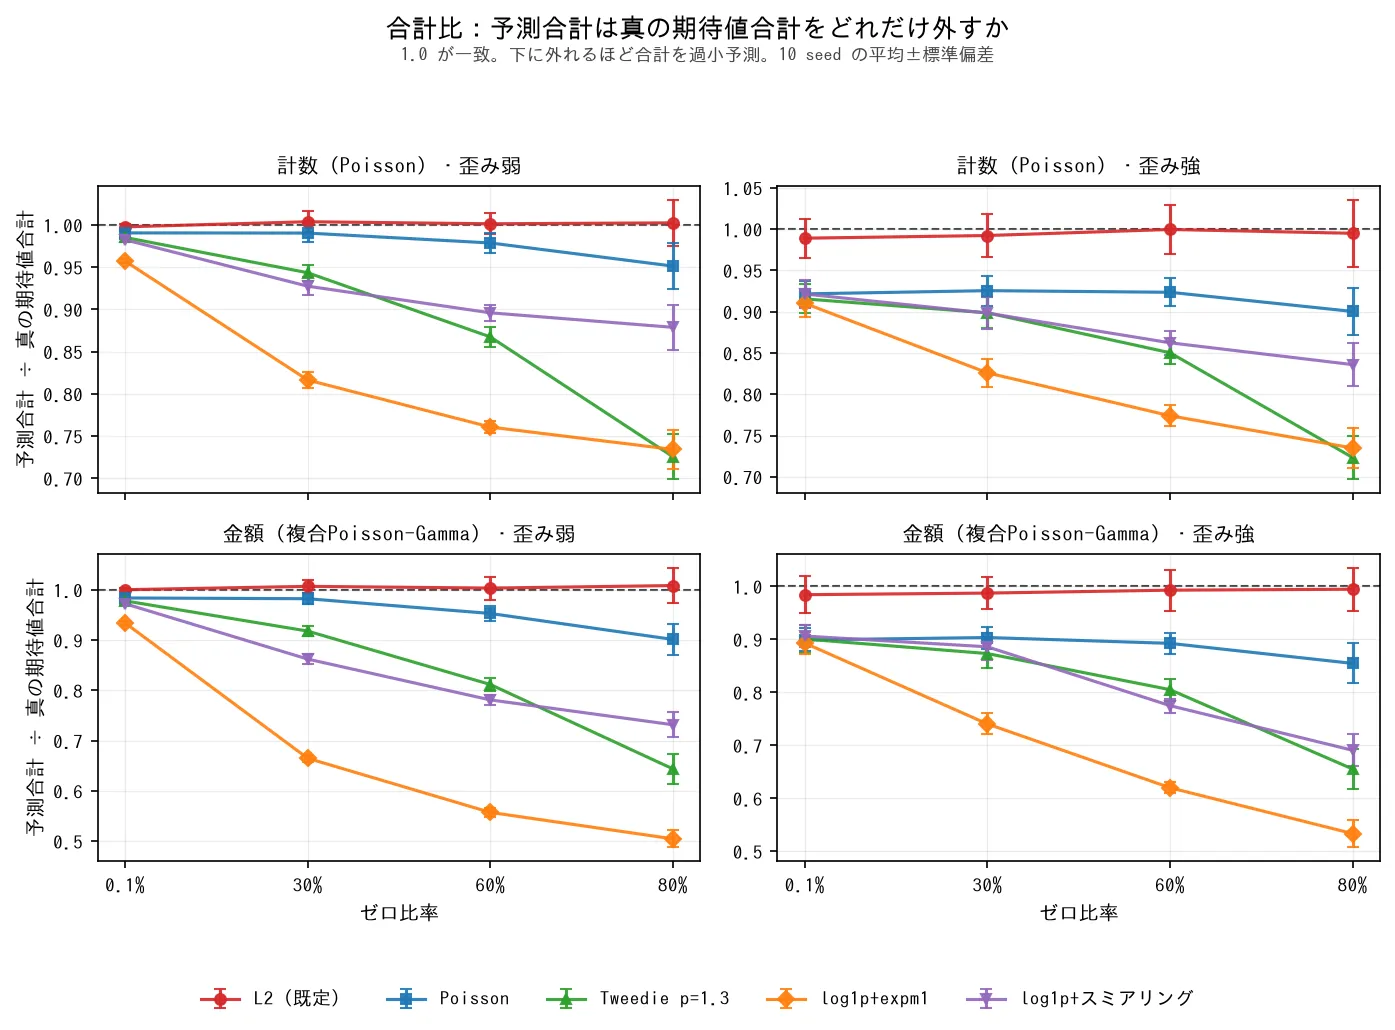
スミアリング補正で値は上がったものの、訓練に使った行の残差から倍率を求めた場合、ゼロ80%の合計比は0.691にとどまりました。この値は、後述するように残差の取り方でも変わります。
成り立つのは今回の2つの生成過程の範囲での話です。ただし、これは実測合計ではなく真の期待値合計との比なので、標本のばらつきではない系統的な偏りです。
実データでも二乗誤差の合計が最も近く、log1pだけ桁違いに下振れした
合成で見えた合計比の向きは、実データ2件でも一致しました。次の表は、予測合計を実測合計で割った値です。
| 手法 | NMES1988(受診回数) | dataCar(請求金額) |
|---|---|---|
| 二乗誤差(既定) | 0.981 | 1.011 |
| Poisson | 0.959 | 0.940 |
| Tweedie p=1.3 | 0.903 | 0.733 |
| Tweedie p=1.9 | 0.834 | 0.495 |
| log1p+expm1 | 0.705 | 0.005 |
| log1p+スミアリング(訓練内残差) | 0.869 | 0.751 |
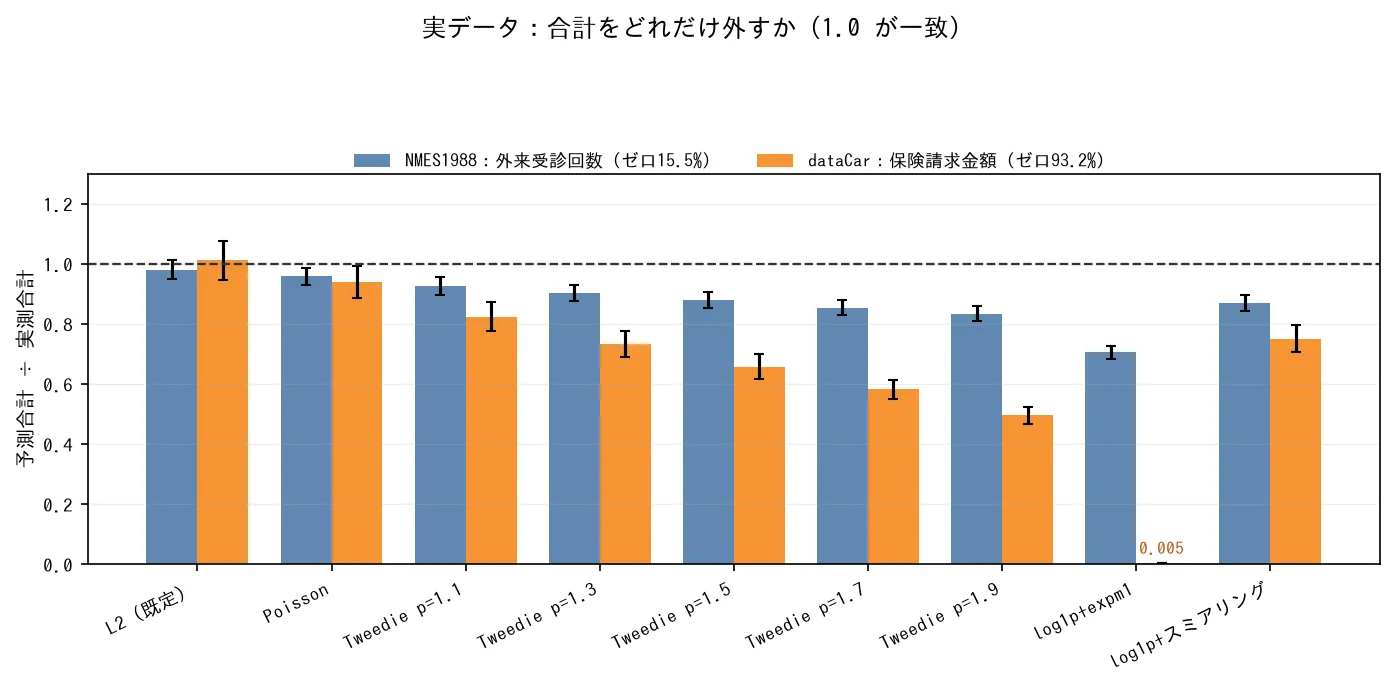
dataCarのlog1p+expm1では、予測合計が実測合計の0.5%まで下がりました(10分割の標準偏差0.0002)。実測値の93%が0なので、log1pで変換した目的変数も大半が0となり、モデルの出力がほぼ0へ寄ったためです。expm1で元へ戻しても値は増えず、訓練データの残差によるスミアリング補正を加えて0.751まで戻りました。
それでも、評価指標を一つに絞ると、この落ち込みは見えません。 同じdataCarのRMSEは9条件すべて1043〜1055で、二乗誤差との差は同じ分割内でも最大1.1%でした。少数の大きな請求がRMSEを強く動かすため、目的関数による差がほとんど表れません。MAEに至っては、合計を約200分の1にしたlog1p+expm1が最小です。次の表は二乗誤差からの変化率で、負の値が誤差の減少を表します。
| 手法 | NMES1988 RMSE | dataCar RMSE | NMES1988 MAE | dataCar MAE |
|---|---|---|---|---|
| Poisson | −2.1% | −0.2% | −3.9% | −5.9% |
| Tweedie p=1.3 | −0.5% | −0.8% | −3.4% | −15.3% |
| Tweedie p=1.9 | −0.6% | −0.8% | −4.8% | −26.2% |
| log1p+expm1 | +1.3% | −0.3% | −6.3% | −47.1% |
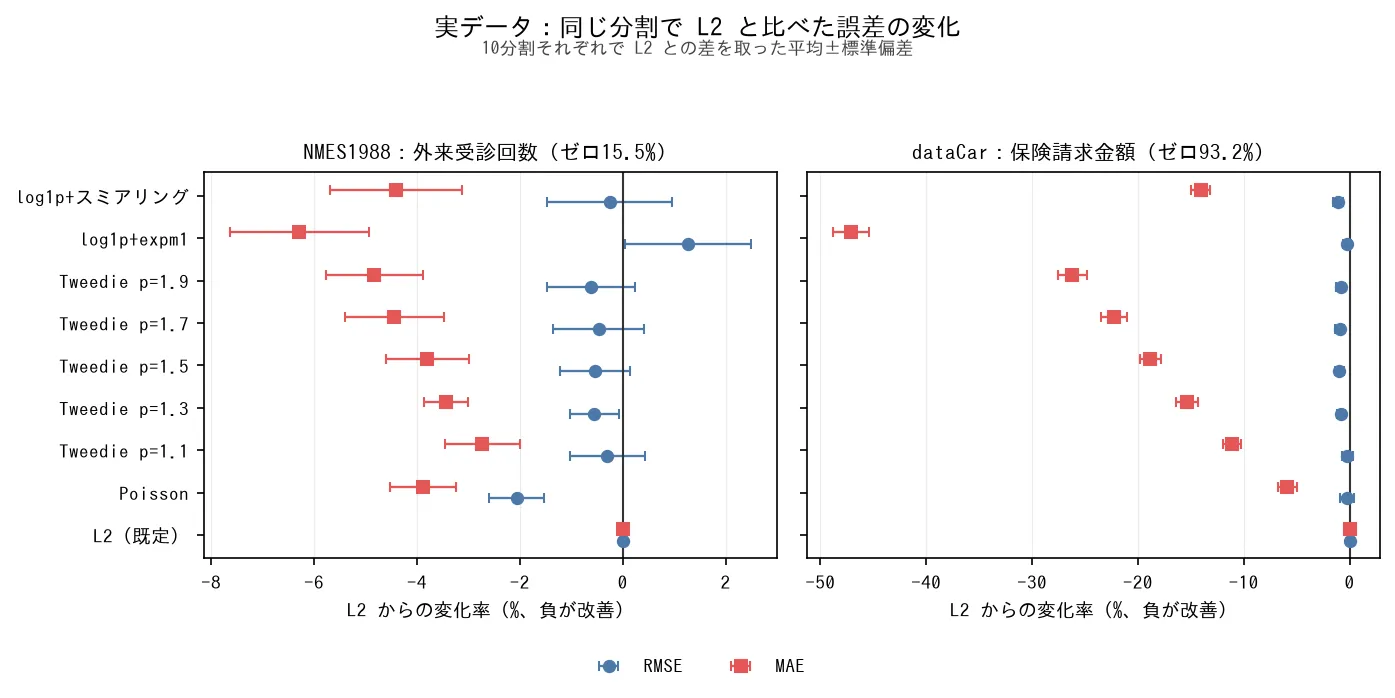
MAEだけが大幅に小さくなる理由は単純です。実測値の93%が0なので、ほぼ0を返す予測ほど多くの行で誤差を抑えられます。合計の大幅な不足はMAEへ反映されないので、用途に合計が含まれるなら両方を並べて判断します。
方向の安定度も見ておきます。NMES1988ではPoissonのRMSEが2.1%下がり、10分割すべてで二乗誤差を下回りました。dataCarでPoissonのRMSEが下がったのは10分割中7回で、こちらは方向が安定していません。
実データでは真の期待値が分からないので、ここでの合計比は実測合計との比です。裾が重いデータでは実測合計そのものも分割ごとに揺れます。
合計不足を埋めようとして分かった、3つの副作用
木を増やしても合計不足は直らず、Poissonではさらに広がった
PoissonやTweedieの合計不足について、最初に疑ったのは木の本数が足りない可能性でした。そこで100本から3000本まで増やしましたが(3回・2条件の追加診断で、10回平均の本編値とは一致しません)、予想とは逆に不足が広がります。金額・ゼロ80%・裾が重い条件のPoissonは、300本の0.845が3000本では0.399まで下がりました。二乗誤差のほうは1.0付近で横ばいです。方法によって木を増やしたときの方向が異なる理由は、今回の検証からは分かりません。
つまり、木の本数を固定して目的関数だけを比べると、設定を変えたときの順位逆転を見落とします。 学習量を変える予定があるなら、合計比は本数ごとに測り直す必要があります。
さらに、訓練データの合計比はほぼ1.0なのに、テストデータだけで不足が生じました。 同じ条件のPoisson 300本では、訓練データの実測合計に対して1.0005、テストデータでは0.819です(真の期待値合計で割ると0.845)。木を3000本まで増やしても訓練側は1.0000のまま、テスト側との差だけが広がりました。この差が生じる仕組みまでは特定できていません。
LightGBMには poisson_max_delta_step(既定0.7)という、Poisson目的関数での更新幅を抑えるつまみがあります。これを10へ緩めると金額側の合計比は0.845から1.020へほぼ戻った一方、devianceは2.452から3.569へ悪化しました。観測範囲では、更新幅の制限が合計不足に関係しており、合計と当てはまりの間にトレードオフがあります。
読み飛ばし可: 木の本数とpoisson_max_delta_stepの走査表
本編値とのずれは、300本の二乗誤差が本編0.995に対して0.978、Poissonが0.855に対して0.845です。次の表は、金額・ゼロ80%・裾が重い条件での合計比です。
| 木の本数 | 二乗誤差 | Poisson | Tweedie p=1.5 | log1p+expm1 |
|---|---|---|---|---|
| 100 | 0.980 | 0.918 | 0.723 | 0.501 |
| 300 | 0.978 | 0.845 | 0.573 | 0.533 |
| 1000 | 0.976 | 0.668 | 0.300 | 0.566 |
| 3000 | 0.986 | 0.399 | 0.129 | 0.591 |
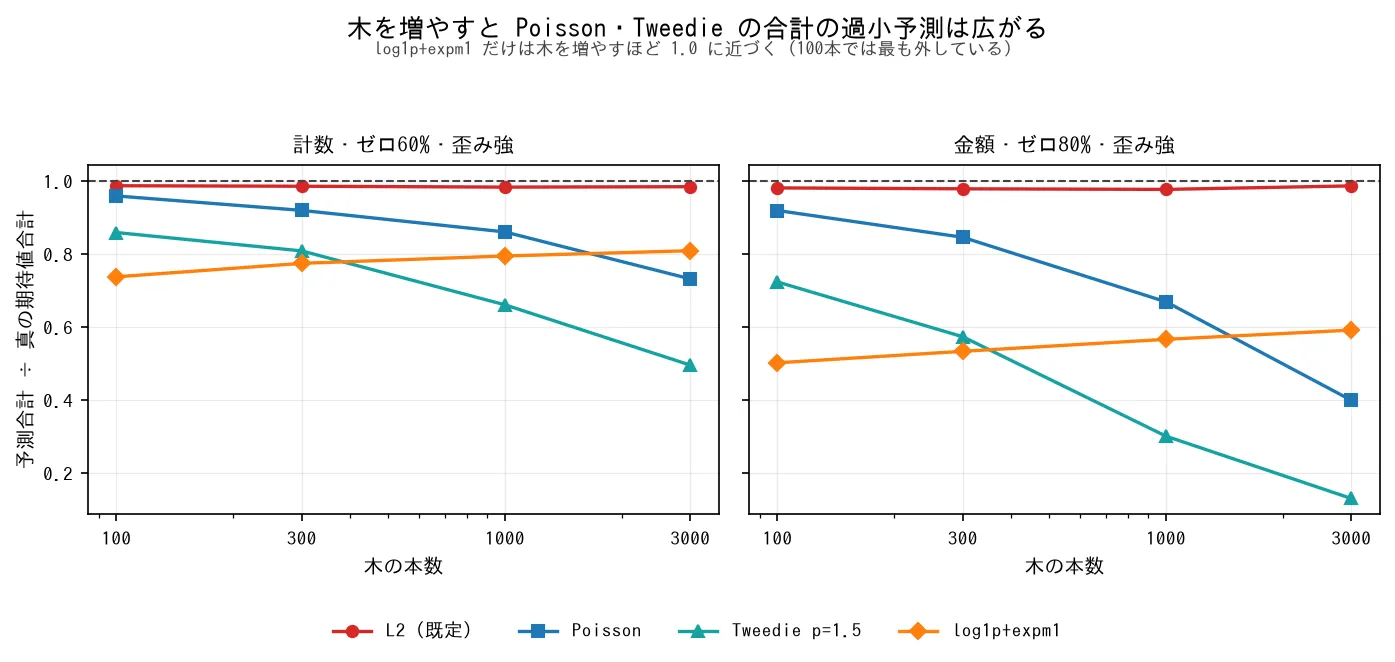
100本ではlog1p+expm1の合計比が最も1.0から離れていましたが、3000本ではTweedie p=1.5、次いでPoissonの不足が大きくなりました。log1p+expm1は、件数・ゼロ60%・裾が重い条件でも0.737から0.808へ動いています。
poisson_max_delta_stepの走査は次のとおりです。いずれもPoisson目的関数なので予測は正の値だけで、devianceの下限処理は結果へ影響しません。
| poisson_max_delta_step | 金額: 合計比 | 金額: deviance | 計数: 合計比 | 計数: deviance |
|---|---|---|---|---|
| 0.7(既定) | 0.845 | 2.452 | 0.919 | 1.050 |
| 10 | 1.020 | 3.569 | 1.022 | 2.184 |
| 100 | 1.020 | 3.572 | 1.022 | 2.186 |
Tweedieのpは、生成時の値ではなくゼロ比率によって最良値が動いた
pの選び方についても、生成分布に合わせれば済むという話にはなりませんでした。実務では、pを想定だけで固定せず、候補を並べて評価します。
合成データは生成過程が分かっているので、真のpowerも計算できます(金額の族が1.333、計数の族が1.0)。掃引したp=1.1〜1.9とPoisson(p=1)のうち、devianceが最小だったものを歪み強の条件で並べます。
| ゼロ比率 | 金額(真のp=1.33) | 計数(真のp=1.0) |
|---|---|---|
| 0.1% | p=1.7 | p=1.9 |
| 30% | p=1.1 | p=1.3 |
| 60% | Poisson(p=1) | p=1.1 |
| 80% | Poisson(p=1) | Poisson(p=1) |
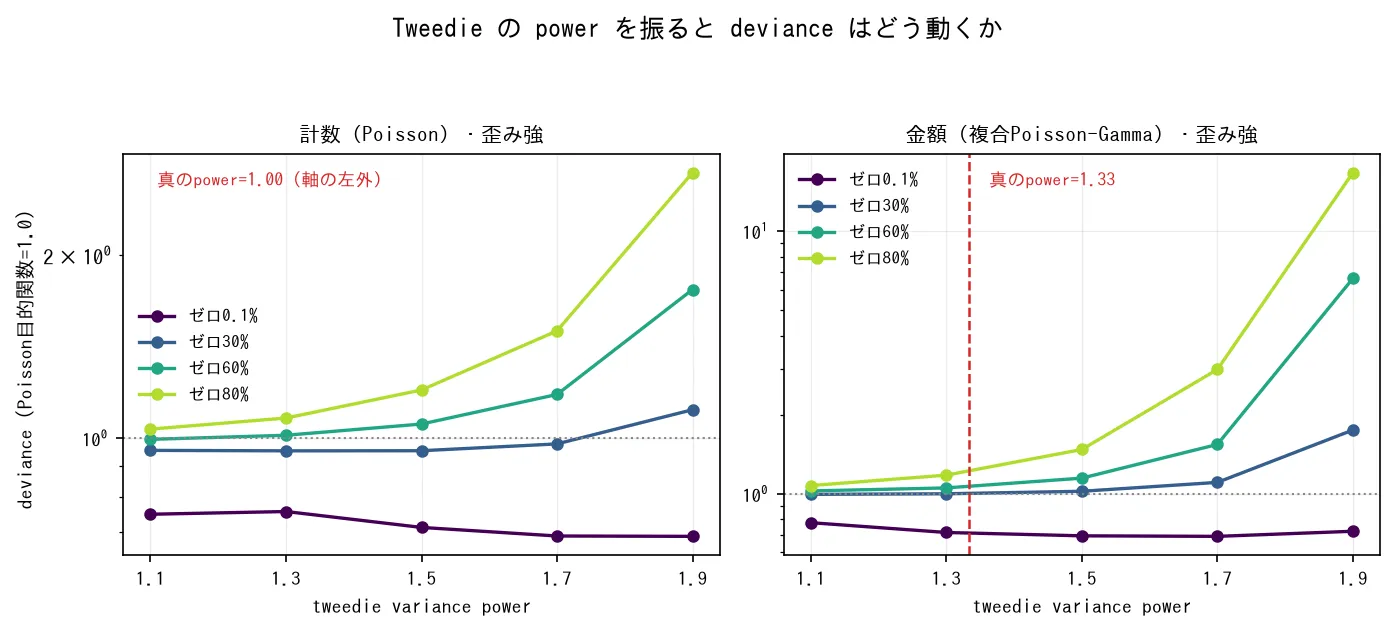
ゼロが増えるほどdevianceが最小となるpは下がり、60%以上では両方の分布とも生成時の値より低い側へ移りました。反対にゼロがほとんどない条件では高い側に寄っています。生成過程のpowerが分かっていても、その値が最良の学習設定になるとは限らない、ということです。
読み飛ばし可: devianceの値は下限の置き方で桁が変わる
図7から比較できるのは、devianceが最小になるpの位置です。二乗誤差などの負の予測を含めて値の大きさまで比べるには、0以下の予測を正の下限まで切り上げなければなりません。その下限によって、同じモデルのdevianceが300倍以上変わりました。 dataCarの1分割では、二乗誤差の値が下限1e-6で35,792.7、下限1.0で105.8です。Poissonは予測が正なので72.4から動きません。金額・ゼロ80%・裾が重い条件でも、p=1.9とPoissonの差は下限によって約18倍から1.5倍へ縮みました。
dataCarでは上位6方法の順位が5つの下限で変わらず、動いたのは負の予測を出す二乗誤差とlog1p+expm1でした。ただしNMES1988では二乗誤差が8位から2位まで動いています。最良のpは、下限を1e-6から0.1まで変えた4条件で同じでした。この記事では、devianceの順位は参考にしても「何倍良い」という差の大きさには使っていません。
log1pの補正倍率は、残差をどのデータで測るかで変わった
最初の集計では、スミアリング補正を加えても合計不足は残りました。ところが実装を確認すると、補正倍率を学習に使った行の残差から求めています。木300本を早期打ち切りなしで学習すれば、その行に対する誤差は実際より小さく見え、補正倍率も小さく出ます。そこで学習データを5分割し、各行を、その行を学習に使っていないモデルで予測して残差を取り直しました(テストデータは補正倍率の計算に使っていません)。予想していた以上に合計不足が埋まります。
16条件×5回の80回すべてで、5分割から求めた補正のほうが合計比1.0に近づきました。 合計比の値域は、訓練データの残差による補正の0.691〜0.982から0.919〜1.045へ縮み、16条件すべてが1.0の±10%以内に収まっています。
ただし、合計が合っても1行ごとの精度は上がりません。 同じ実行で、真の期待値に対する平均相対誤差は80回中74回で悪化しました。係数は全行を一律に持ち上げるので、真の期待値が小さい行ほど相対誤差が膨らむためです。係数の取り方を変えれば合計はほぼ埋まりますが、行ごとの精度でPoisson目的関数に並ぶわけではありません。
読み飛ばし可: 補正2方式の走査表と実データでの動き
補正倍率は、訓練データの残差から取ると16条件の平均で1.012〜1.210、5分割の未学習残差から取ると1.036〜1.409でした。次の表は16条件×5回の合計比で、右の2列は1.0からのずれが指定範囲に収まった条件数です。
| 係数の取り方 | 合計比の値域 | ±5%以内(16中) | ±10%以内(16中) |
|---|---|---|---|
| 掛けない(log1p+expm1) | 0.503〜0.957 | 1 | 3 |
| 訓練データの残差 | 0.691〜0.982 | 2 | 5 |
| 学習データの5分割 | 0.919〜1.045 | 13 | 16 |
実データでもdataCarは0.751から1.027、NMES1988は0.869から1.100へ動いています。NMES1988の10%超過は分割数を20まで増やしても1.095で残りました。合計を合わせるには大きな予測ほど強く反映した残差の平均が必要ですが、通常のスミアリングでは各行を同じ重さで平均するため、条件によって上振れします。
相対誤差の悪化幅は、金額・ゼロ80%・歪み強で0.756から1.386です(ここでの相対誤差は二乗誤差との比ではなく実数値で、同じ実行の二乗誤差は1.659、Poissonは0.551です)。実データのMAEも悪化します(dataCarで223.95から255.99、NMES1988で4.11から4.48)。実測RMSEのほうは逆に、80回中74回で改善しました。
負の予測は選択理由になり、ゼロの見分けやすさはならなかった
負の予測は二乗誤差とlog1pで出て、Poisson・Tweedieでは出なかった
負の値をそのまま使えない処理では、誤差だけでなく予測範囲も選定基準になります。金額・ゼロ80%・裾が重い条件で、二乗誤差は予測の10.3%、log1p+expm1は7.93%が0未満でした。スミアリング補正を加えると同じ条件では0.73%まで下がりましたが、件数・ゼロ80%・裾が重い条件では2.37%残っています。PoissonとTweedieの負の予測は、合成データ16条件すべてで0%でした。
expm1 は入力が負なら負を返すので、対数の世界で0を下回った予測はそのままマイナスで戻ってきます。件数や請求額の予測にマイナスが混じると、そのまま下流の処理へ渡せません。予測を金額として扱う場面では、この1点だけでPoissonかTweedieを選ぶ理由になります。
ゼロの見分けやすさは、目的関数を替えてもほとんど動かなかった
PoissonやTweedieへ替えれば、実測値0の行も見分けやすくなると予想していました。実際には、順位づけの精度はデータ側の条件で決まっていました。予測を順位にしか使わない用途なら、目的関数を替える動機は小さいということです。
予測値の小ささで0の行を順位づけしたROC-AUCは、ゼロが3割以上の12条件で0.59〜0.86だったのに対し、同じ条件内で目的関数を替えた差は最大0.036です。ゼロ0.1%の4条件を含めても、条件内の最大差は0.045、中央値は0.0185でした。
予測値の水準には違いがありました。件数・裾が重い・ゼロ30%の条件で、実測値0の行に対する平均予測は二乗誤差0.834、Poisson 0.867、Tweedie p=1.3が0.729、p=1.9が0.556、log1p+expm1が0.626です。pを上げるほど0に近づいたものの、同時に予測合計も下がっており、値が低いことだけでは良否を判断できません。
実務では、予測の使い道から順に決める
まず予測値の使い道を決めます。今回の結果では、1行ごとの誤差を減らしたいのか、合計を合わせたいのかで有利な目的関数が逆になりました。
| 予測の使い道・条件 | 比較する候補 | 採用前に確かめること |
|---|---|---|
| 1行ごとの誤差を減らしたい | 二乗誤差を基準にPoissonを追加 | 同じ分割でRMSE・MAEを比べ、分割ごとに改善の方向がそろうか |
| 件数・金額を足し上げたい | 既定の二乗誤差も残す | 予測合計÷実測合計が1.0に近いか。行ごとの誤差も併せて確認 |
| 負の予測をそのまま使えない | Poisson・Tweedie | 誤差と合計比が用途に合うか |
| log1pを使っている | expm1で戻した値を評価 | 負の予測の割合と合計不足。補正するなら未学習の行の残差から倍率を求める |
| Tweedieを使いたい | pを複数比較 | 生成分布の想定だけでpを固定せず、ゼロ比率と評価指標を合わせて見る |
Poissonはどの条件でも良いわけではありません。裾が軽くゼロもほとんどないデータでは、相対誤差が既定より約1割増えた例もありました。poisson_max_delta_stepを緩めると合計不足は縮まりましたが、当てはまりは悪化しています。
スミアリング補正も合計を合わせるための候補です。今回の比較では1行ごとの相対誤差とMAEは悪化したため、補正後の値で両方を確かめます。予測を順位づけにしか使わない場合、目的関数によるゼロ識別AUCの差はわずかで、替える利点は小さい結果でした。
目的変数の形は、ゼロ比率と裾の重さを分けて見ます。ただし今回測った歪度は2つの帯に分かれており、その中間に明確な境界値を引ける結果ではありません。また、合成データの相対誤差は真の期待値が分かるから計算できる指標です。手元の実データでは、利用目的に合うRMSEまたはMAE、合計比、負の予測件数を最低限そろえます。
RMSEとMAEのどちらを選ぶか迷う場合は、回帰指標によってモデルの順位が入れ替わる例を先に確認すると、比較に使う指標を決めやすくなります。
詳しい検証条件
学習設定は木300本、学習率0.05、葉31で全条件そろえ、早期打ち切りは使っていません。学習データを5分割して補正倍率を求めるスミアリングだけは追加検証で、16条件×5回を測りました。実データ2件はどちらもRdatasetsから取得しています。
数値は保存済みの実行ログから集計し、合成データは各条件10回、実データは10分割の平均です。統計的検定は行っていません。
相対誤差を二乗誤差との比で示した表だけは、集計順序によって値が動きます。10回の平均どうしを割ると本文の値になりますが、各回で比を計算してから平均すると、裾が重い条件で金額・ゼロ0.1%は0.290から0.368、件数・ゼロ0.1%は0.425から0.460へ変わりました。金額・ゼロ0.1%では二乗誤差の相対誤差が回ごとに0.52〜3.26と大きく振れ、平均どうしの比が誤差の大きい回に強く影響されたためです。集計順序による差は、裾が軽い条件なら全方法で0.005以内、相対誤差以外の指標なら裾が重くても0.034以内でした。
読み飛ばし可: 生成過程と評価の細かい設定
- 平均を決めるシグナルは
0.9x0 - 0.7x1 + 0.6x2x3 + 0.5sin(2x4) + 0.4(x5>0.3)を固定のパイロット標本で標準化したものです。ゼロ比率は切片を二分法で校正して目標値に合わせ、実現値を記録しています。 - 合成データの真のTweedie powerは、計数の族が1.0、金額の族が4/3(1.333)です。金額の族は重症度をGamma分布(形状2.0)で引いているので、powerが生成過程から決まります。
- 実データは真のpowerが分からないため、評価に使うpowerはこちらが選んだ設定です(NMES1988は1.0、dataCarは1.5)。この設定は同じpowerのTweedie条件に有利に働きうるので、実データでは目的関数に中立な実測RMSE・MAE・合計比を主に読んでいます。
- 特徴量からは目的変数と同じ期間の外来利用、救急利用、請求の有無を除きました。ただしNMES1988では同じ期間の入院回数(
hospital、目的変数との相関0.241)が14特徴量に残っています。9条件の比較には同じ特徴量を使っているため公平性は保たれますが、本文の数値はこの列を残した構成です。除外して測り直したPoissonの改善はRMSE 2.0%、MAE 3.7%で、10分割すべてで二乗誤差を下回る点は変わりませんでした。 - スミアリングの係数(掛け戻す倍率)は、訓練データの残差から取ると16シナリオの平均で1.012〜1.210、学習データの5分割から取ると1.036〜1.409でした。5分割版は、各行を「その行を学習に使っていないモデル」で予測した残差から係数を求めています(テスト集合には触れていません)。最終予測は両方とも、全学習データで学習したモデルの出力に係数を掛けたものです。
- 誤差の散らばりの切り分けは、16シナリオ(族2×ゼロ比率4×歪み2)を1点ずつとして、ばらつきのうち各条件だけで説明できる分を割り振り、残りを条件どうしの組み合わせ(交互作用)として残す形で見ています。
- この取り分は指標で変わります。相対誤差では歪みが73〜95%を占めますが、ほかの3指標では8.4〜44.5%まで下がり、真の期待値に対するRMSEでは順位が入れ替わって、交互作用が53.3%と最大になります。
- 切り分けには断りが2つあります。ひとつは、振ったのが信号の散らばりの2水準で、歪度はその実現値だという点です。強い帯ではゼロを増やすほど実現歪度も下がるので(相関−0.798)、実現値として見れば2つの因子は直交していません。もうひとつは、ゼロ比率を切片の校正で作っているため、ゼロを増やすと目的変数の平均も下がる点です(計数・歪み弱で14.34、1.41、0.55、0.23)。ゼロ比率の効果は、この平均水準の低下と切り分けられていません。
- 木の本数を振った診断と
poisson_max_delta_stepの比較は3 seed、スミアリングの係数の取り方を比べた追加実行は5 seedです。それ以外は10 seedです。
適用範囲と限界
この比較はLightGBMの目的関数を選ぶ判断材料であり、ゼロが多い回帰全体の最適解を決めるものではありません。採用判断に影響しやすい制約から並べます。
- ゼロ比率の効果は、平均水準の低下と切り分けられていません。 ゼロ比率は切片の校正で作っているので、ゼロを増やすと目的変数の平均も下がります(計数・歪み弱で14.34、1.41、0.55、0.23)。「ゼロが多いほど効く」はこの2つが混ざった観測です。
- 歪みも、歪度そのものを直交させて振った実験ではありません。 振ったのは信号の散らばりで、歪度はその実現値です。強い帯ではゼロを増やすほど実現歪度も下がります(相関−0.798)。弱い側(歪度1.5〜4.4)と強い側(11.9〜25.8)の2水準しかないので中間は測っておらず、この範囲もシナリオ平均で、seed単位では弱い側が1.40〜5.59、強い側が5.56〜52.4と両端が接します。
- ゼロ過剰専用のモデル(ゼロ膨張ポアソン、ハードルモデル)は比較に入れていません。 ゼロが多いデータでの本来の対抗馬なので、ここでの結論は「勾配ブースティングの目的関数の中でどれを選ぶか」に限られます。
- 適用範囲は、LightGBMの回帰で既定の学習設定どうしを比べた結果です。木の本数や学習率を条件ごとに調整すれば差は動きえます。早期打ち切りも使っておらず、木の本数を振った診断は3 seed・2シナリオだけです。
- 速度は比較できません。他の処理と資源を分け合う環境で計測しているためです。
- 真の期待値が小さい行と大きい行の寄与を分けた集計(テストの4,000行を真の期待値の小さい順に10等分し、各1割が誤差の合計にどれだけ効いているかを見たもの)は、金額・歪み強・ゼロ0.1%の1シナリオだけです。
- スミアリングの係数は、訓練データの残差から取る版と学習データを分割して取る版の2通りを比べました。分割数は実データ2件で2から20まで振っており、係数は3%ほどしか動きませんでした(合成データでは振っていません)。分割ぶんの学習が余計に要る点は、採用時のコストとして残ります。
- 合成データの結論は、こちらが決めた2つの生成過程(Poissonと複合Poisson-Gamma)の形に依存します。実データは2件だけで、評価に使ったTweedieのpowerもこちらが選んだ設定です。
手元のデータで目的関数を比べるコード
次のコードはゼロが約6割の件数データを作り、二乗誤差、Poisson、Tweedie、log1p+expm1、スミアリング補正2通りを同じ設定で学習します。出力するのはRMSE、Poisson deviance、合計比です。Xとyを手元のデータへ置き換えれば、同じ項目を比較できます。
スミアリング補正は、訓練に使った行の残差から倍率を求める方法と、学習データを5分割して未学習の行に対する残差から求める方法を含みます。DataFrameや整数型へ差し替えた場合にも意図した計算になるよう、入力をNumPyのfloat配列へそろえています。
"""ゼロ過剰なカウントデータで目的関数を比べる最小例。

必要なもの: lightgbm, scikit-learn, numpy
    pip install lightgbm scikit-learn numpy
実行: python quickstart.py
"""
import numpy as np
from lightgbm import LGBMRegressor
from sklearn.metrics import mean_tweedie_deviance
from sklearn.model_selection import KFold, train_test_split

rng = np.random.default_rng(0)

# ゼロが約6割になるカウントデータを作る
X = rng.standard_normal((12000, 6))
eta = 0.9 * X[:, 0] - 0.7 * X[:, 1] + 0.6 * X[:, 2] * X[:, 3]
mu = np.exp(-0.9 + 1.2 * eta)
y = rng.poisson(mu)
print(f"ゼロ比率 {np.mean(y == 0):.3f} / 平均 {y.mean():.3f} / 最大 {y.max():.0f}")

# 手元のデータに差し替えるときは、ここで numpy の float 配列にそろえる。
# DataFrame や Series のまま渡すと、後段の X_tr[tr_idx] が位置ではなくラベル参照になり KeyError になる。
X = np.asarray(X, dtype=float)
y = np.asarray(y, dtype=float)

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.33, random_state=0)

# 学習設定は全条件で共通にする(片方だけ念入りに調整しない)
params = dict(n_estimators=300, learning_rate=0.05, n_jobs=1, verbose=-1, random_state=0)

results = {}

for name, obj in [
    ("L2(既定)", dict(objective="regression")),
    ("Poisson", dict(objective="poisson")),
    ("Tweedie p=1.3", dict(objective="tweedie", tweedie_variance_power=1.3)),
]:
    pred = LGBMRegressor(**obj, **params).fit(X_tr, y_tr).predict(X_te)
    results[name] = pred

# log1p 変換して L2 で学習し expm1 で戻す(よく使われる手)
model_log = LGBMRegressor(objective="regression", **params).fit(X_tr, np.log1p(y_tr))
results["log1p+expm1"] = np.expm1(model_log.predict(X_te))

# Duan のスミアリング補正: E[y|x] = exp(f(x)) * mean(exp(残差)) - 1
# 残差を「学習に使ったのと同じデータ」で取ると、木が当てはめきっている分だけ係数が小さく出る
smear_in = np.mean(np.exp(np.log1p(y_tr) - model_log.predict(X_tr)))
results["log1p+スミアリング(訓練内残差)"] = np.exp(model_log.predict(X_te)) * smear_in - 1.0

# 学習データを K 分割して、各行を「その行を学習に使っていないモデル」で予測し残差を取る
kf = KFold(n_splits=5, shuffle=True, random_state=0)
oof = np.empty(len(y_tr), dtype=float)
for tr_idx, va_idx in kf.split(X_tr):
    m = LGBMRegressor(objective="regression", **params).fit(X_tr[tr_idx], np.log1p(y_tr[tr_idx]))
    oof[va_idx] = m.predict(X_tr[va_idx])
smear_oof = np.mean(np.exp(np.log1p(y_tr) - oof))
results["log1p+スミアリング(out-of-fold残差)"] = np.exp(model_log.predict(X_te)) * smear_oof - 1.0

print(f"\nスミアリング係数: 訓練内残差 {smear_in:.4f} / out-of-fold残差 {smear_oof:.4f}\n")
for name, pred in results.items():
    rmse = np.sqrt(np.mean((y_te - pred) ** 2))
    # deviance は正値しか受け付けないので下限だけクリップする
    dev = mean_tweedie_deviance(y_te, np.clip(pred, 1e-6, None), power=1.0)
    bias = pred.sum() / y_te.sum()  # 1.0 から離れるほど合計を外している
print(f"RMSE={rmse:6.4f} Poisson deviance={dev:6.4f} 予測合計/実合計={bias:6.4f} {name}")コードをquickstart.pyとして保存し、必要なライブラリを入れて実行します。
pip install lightgbm==4.7.0 scikit-learn==1.9.0 numpy==2.4.6
python quickstart.py
実行結果(手元での出力)
ゼロ比率 0.582 / 平均 1.404 / 最大 467

スミアリング係数: 訓練内残差 1.0458 / out-of-fold残差 1.0917

RMSE=2.7898  Poisson deviance=1.7497  予測合計/実合計=1.0920  L2(既定)
RMSE=2.0549  Poisson deviance=1.0666  予測合計/実合計=0.9407  Poisson
RMSE=1.9487  Poisson deviance=1.0621  予測合計/実合計=0.8942  Tweedie p=1.3
RMSE=1.9696  Poisson deviance=1.1088  予測合計/実合計=0.8258  log1p+expm1
RMSE=1.9217  Poisson deviance=1.0328  予測合計/実合計=0.8983  log1p+スミアリング(訓練内残差)
RMSE=1.8838  Poisson deviance=1.0193  予測合計/実合計=0.9711  log1p+スミアリング(out-of-fold残差)
結果を比べるときは、まずRMSEと合計比を使います。Poisson devianceは、PoissonとTweedieのように予測が負にならない方法どうしの比較に限るほうが安全です。二乗誤差やlog1p+expm1を含めると、負の予測をどの下限まで切り上げるかで順位が変わる場合があります。
この出力は1条件を1回実行した例であり、本文の平均値を再現するものではありません。ここでも補正倍率は訓練内残差の1.0458から5分割の1.0917へ上がり、合計比は0.8983から0.9711へ近づいています。
まとめ
ゼロの多さだけでは、目的関数を決められませんでした。選択を分けたのは、予測を1行ずつ使うのか足して総量に使うのかという使い道と、目的変数の裾の重さです。
指標を1つに絞ると、行ごとの誤差を改善しながら総量を大きく外す状態を見落とします。実データのdataCarでは、MAEが最も小さい方法が、合計を桁違いに外していました。木を増やせば合計不足も縮むという見込みが逆に外れたのも、今回の収穫です。
木を増やしたときにPoissonの合計不足が広がる仕組み、ゼロ過剰専用モデルとの比較、条件別に早期打ち切りを使った結果は未検証です。予測を1つの値ではなく区間で答えたい場合は分位点回帰で予測区間を作った検証を、ライブラリ自体の選択から比べたい場合はGBDT3種の実測比較を参照してください。