
与信モデルが、ある申込者を審査で落としたとします。担当者は「なぜ落ちたのか」を説明しなければなりません。そこで使うのが、1件の予測について「どの項目がどれだけ効いたか」を数字にする道具です。広く使われているのがSHAPとLIMEで、どちらも棒グラフの形で「いちばん効いた項目」を見せてくれます。
ところが、この2つが同じ答えを返すとは限りません。SHAPでは「年収」が最上位なのに、同じモデル・同じ申込者をLIMEで説明すると「勤続年数」が最上位に出る、ということが起こります。
片方しか使っていなければ、この食い違いには気づけません。出てきた図をそのまま読んで、「この予測では年収が最も効いた」と報告することになります。
では実際、どれくらい一致するのでしょうか。同じLightGBMモデルの同じ行にSHAPとLIMEを当て、両手法が「最も効いた」とした特徴が同じかどうかを、合計1,080行で数えました。
先に結論
- 同じモデルの同じ行でも、SHAPとLIMEが「いちばん効いた特徴」で一致したのは 33.3〜46.1%。半数以上の行で答えが違う
- LIME自身を2回走らせたぶれと比べても、食い違いはLIMEのばらつきでは説明できない。掛け合わせ(複数の特徴が組み合わさって効く関係)の効果が無い条件では、シードだけ変えた再実行が360行すべてで一致
- 特徴の掛け合わせが強いほど食い違いは広がる。ただし最も強い条件ではLIME自身も不安定になり(再実行の一致 0.6611)、手法差だけでは読めない
- どちらが正しいかは採点していない。合成データ12特徴・LightGBM の1設定・LIME はサンプル数3,000で固定した範囲の結果
前提知識と、一致の数え方
SHAPやLIMEを使い込んでいなくても読めます。ただし結果の読み方が言葉に左右されるので、一致の数え方だけ先に揃えておきます。中身の計算式には立ち入りません。
SHAPもLIMEも、1件の予測に各特徴がどう関わったかを説明する手法です。ただし、計算しているものは異なります。
- SHAPは、特徴を加えたり外したりしたときの予測の変化を、さまざまな組み合わせについて配分する
- LIMEは、説明したい1件の近くにデータを作り、その周辺だけを単純なモデルで近似する
どちらの出力も画面には「特徴の寄与」として並びますが、同じ値になる保証はありません。この記事は、その差が結果にどれだけ出るかを数える話です。
一致の度合いは3つの指標で見ます。第1位の一致は、両手法が同じ特徴を最上位に挙げた行の割合です。上位3の一致は、上位3本の顔ぶれがどれだけ重なるかを0から1で表します。順位相関は、12特徴すべての並び順がどの程度近いかを示す値で、1に近いほど同じ並びです。
もうひとつ、掛け合わせという言葉を使います。ある特徴の効き方が別の特徴の値によって変わることで、交互作用とも呼ばれます。今回は、正解を作るときにこの成分をどれだけ混ぜるかを3段階に変えました。
掛け合わせ3水準で同じ1,080行を説明させた
使ったのは、先頭4本だけが結果に効く12特徴の合成データです。二値分類の正解を決める要素として、「特徴が単独で効く成分」と「2特徴の掛け合わせで効く成分」を用意し、混ぜる割合を 0・0.5・1.0 の3水準にしました。
掛け合わせが強いほど、局所を線形で近似するLIMEには難しい条件になると考えられます。この割合を動かし、データの構造と食い違いの関係を調べました。
学習器はLightGBMに固定しています。各条件でシードを3本使い、1シードにつき120行を説明しました。1条件360行、3条件で合計1,080行です。
LIMEの再実行を物差しとして横に置きました。 一致しなかった理由を、すぐに「手法の違い」と断定はできません。LIMEは説明用のデータを乱数で作るため、実行するたびに結果が揺れる可能性があるからです。そこで各行では、乱数シードだけ変えたLIMEをもう一度走らせ、同じ指標で比べています。LIME同士は一致するのにSHAPとは一致しないなら、食い違いを乱数だけでは説明できません。反対にLIME同士も一致しないなら、SHAPとの差にはLIME自身の揺れが混ざっています。
SHAPとLIMEの細かい設定と、指標の正確な定義は、後半の「詳しい検証条件」にまとめました。
第1位が一致したのは3割から4割半ば
同じモデルの同じ行を説明させても、SHAPとLIMEが最上位に挙げる特徴はしばしば違いました。半数以上の行で、報告すべき「いちばんの理由」が入れ替わります。
実務に引き直すと、片方の出力だけを見て「この予測では年収が効いた」と確定させるのは危うい、ということです。もう一方を使った人は、別の特徴名を報告します。
| 掛け合わせの割合 | SHAP対LIME 第1位 | SHAP対LIME 上位3 | SHAP対LIME 順位相関 | LIME再実行 第1位 | LIME再実行 上位3 |
|---|---|---|---|---|---|
| 0.0 | 0.4611 | 0.6525 | 0.4524 | 1.0000 | 1.0000 |
| 0.5 | 0.4111 | 0.5256 | 0.3329 | 0.9472 | 0.9819 |
| 1.0 | 0.3333 | 0.3967 | 0.2484 | 0.6611 | 0.5606 |
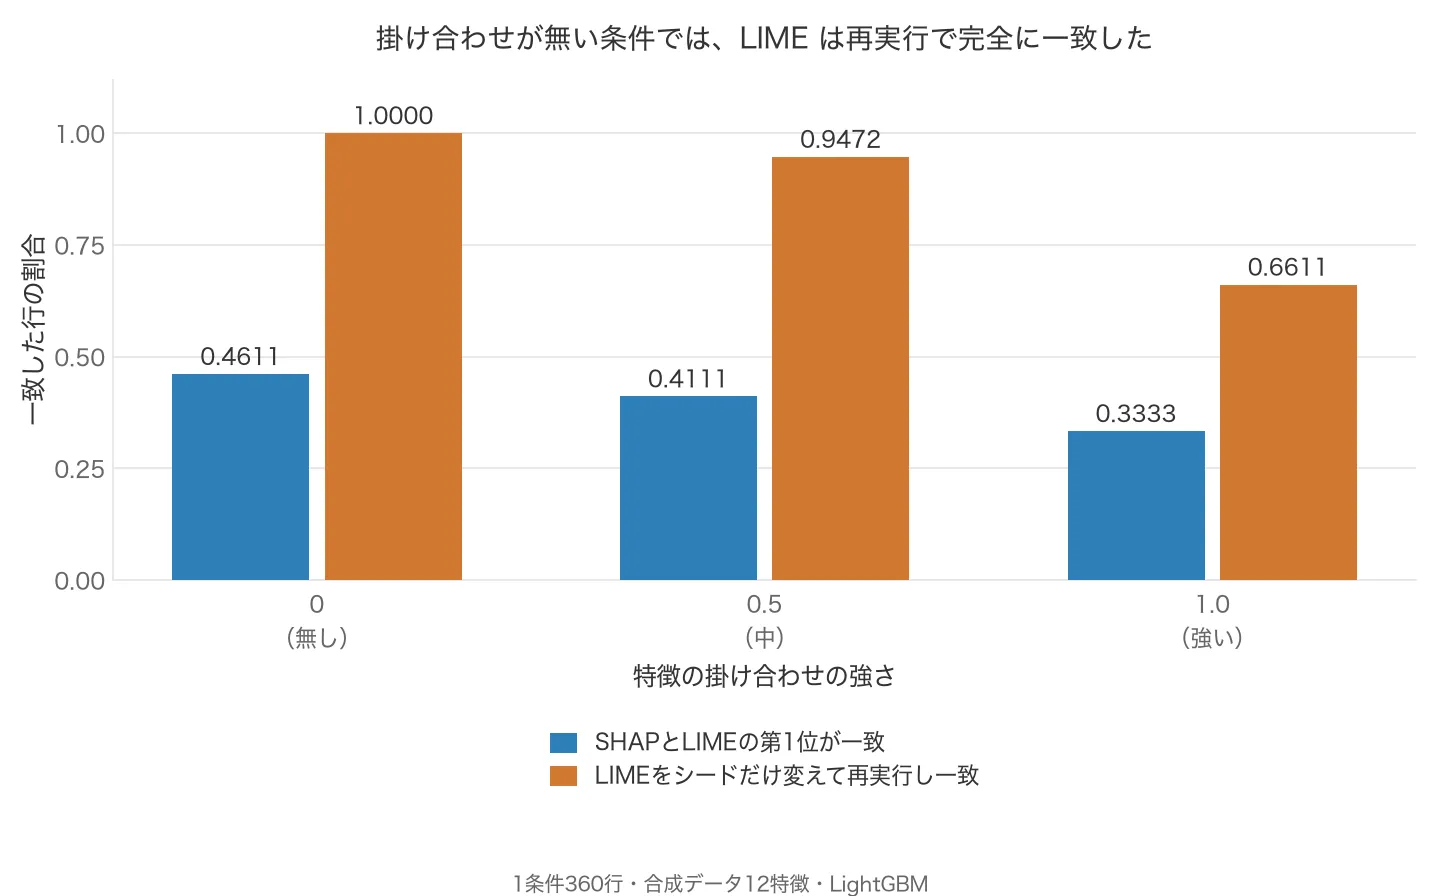
表の値は、1条件360行の平均です。最も一致した掛け合わせ0の条件でも、第1位一致は4割半ばにとどまりました。条件をいちばん易しくしても、10行のうち5行以上で最上位の特徴名が食い違うということです。
シードを変えても、この水準は大きく動きません。掛け合わせ0のシード別では0.4333・0.4333・0.5167と、いずれも半数前後でした。
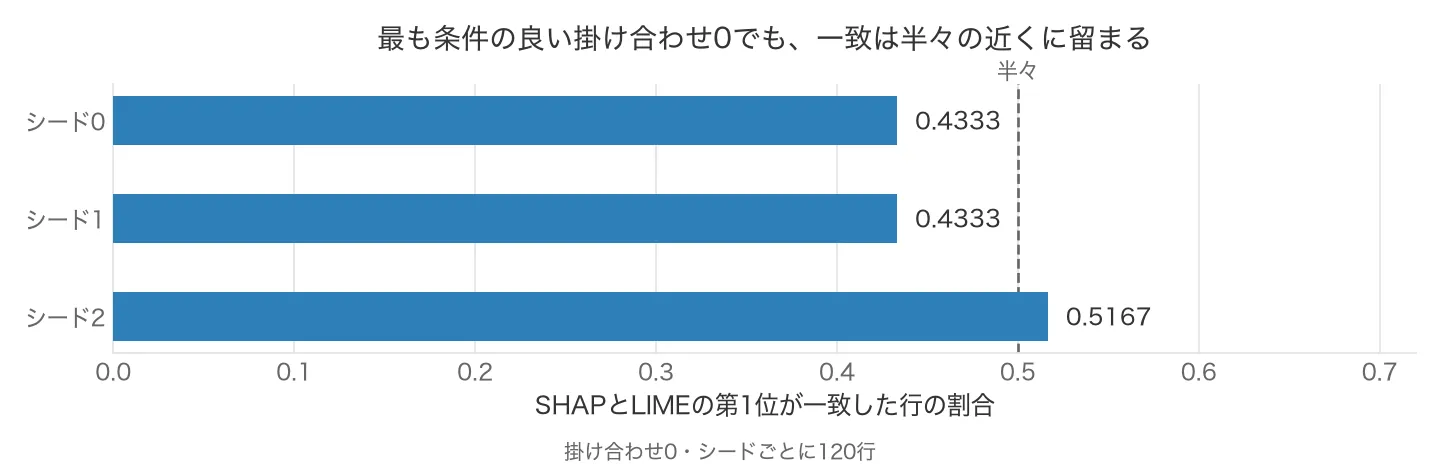
与信の説明に置き換えれば、SHAPが「年収が最大の要因」と示した申込者でも、LIMEでは別の特徴が最上位になる場合があるということです。どちらの図にも明確な1位が表示されますが、その特徴名は半数以上の行で一致しませんでした。
疑っていたLIMEの乱数は、犯人ではなかった
実験前に立てた見込みは、「SHAPとLIMEは相当数の行で食い違い、LIME自身も再実行でぶれる」でした。前半は当たり、後半は条件によって外れます。
掛け合わせ0の条件では、LIMEをシードだけ変えて再実行しても、第1位・上位3とも一致率は1.0000でした。360行すべてで、最上位の特徴も上位3本の顔ぶれも変わっていません。それでもSHAPとの第1位一致は0.4611です。
つまりこの条件の食い違いは、LIMEの乱数では説明できません。LIME自身の答えは再現しているのに、SHAPとは別の特徴を上位に置いています。片方を1回実行するだけでは、この違いは見えないままです。
なぜ個々の行で別の特徴を選んだのかまでは測っていません。ただし、SHAPは特徴を抜き差ししたときの寄与を組み合わせ全体から配分し、LIMEは対象行の周辺を近似した線形モデルの係数を求めます。どちらも「特徴の寄与」と呼ばれる一方で、計算している量は同じではありません。今回の一致率は、その違いが出力にどれだけ現れたかを数えたものです。
掛け合わせが強いほど食い違いは広がる
掛け合わせの割合を上げると、第1位・上位3・順位相関の3指標がそろって低下しました。1段ごとの小さな差より、掛け合わせ0と1.0の開きが目立ちます。説明の難しいデータほど、2つの手法は別のことを言い出すわけです。
掛け合わせがあると、ある特徴の効き方が別の特徴の値に左右されます。LIMEでは局所的な線形近似が難しくなり、SHAPでも寄与の配分が組み合わせに依存します。この構造が一致率の低下に関係した可能性はありますが、結果からの推測にすぎません。条件ごとのモデル性能を記録していないため、原因としては確定できません。
なお、動かしたのは目的変数を作るときの掛け合わせの割合で、特徴量同士の相関ではありません。実測から言えるのは、2特徴の掛け合わせで正解が決まる割合を増やすほど、説明の一致率が下がったことまでです。
最も強い条件では、LIME自身も揺れる
掛け合わせ1.0の行は、他の2条件と同じようには読めません。この条件ではLIME自身の再実行一致も、第1位0.6611・上位3 0.5606まで落ちています。同じ設定で2回実行すると、約3行に1行は別の特徴が第1位になりました。
したがって、SHAPとの第1位一致0.3333には、手法の違いだけでなくLIME自身の揺れも含まれます。手法差の指標としては、前の2条件と同じ意味を持ちません。
LIMEがほぼ安定していた掛け合わせ0と0.5の間では、手法間の一致率が下がったと読めます。1.0でさらに低下したのは観測事実ですが、どこまでが手法差で、どこからがLIMEの揺れなのかは分けられていません。
片方の上位1本だけを「予測の理由」にしない
どちらを使うかを正しさで決める材料は、この記事にはありません。 どちらが正解に近いかを採点していないためです。SHAPの側については、真の寄与が分かる合成データで説明を採点した結果をSHAPの特徴量重要度を正解つきデータで検証した記事が扱っています。この実験から言えるのは、手法を選んだ後の扱い方です。
審査理由や顧客への説明のように、モデルの外へ説明を出すなら、まず手元のデータで一致率を測る。 両手法を同じ行に当て、第1位や上位3がどれだけ揃うかを数えます。測り方はこの実験と同じで足ります。1条件120行を説明し、シードを3本回して平均とばらつきを見る、という規模です。その規模でも、シード別の値は前掲のとおり半数前後に収まりました。今回の33〜46%は合成データでの値なので、実データで同じ水準になるとは限りません。
判断の物差しも、この実測に置いています。掛け合わせのない最も易しい条件ですら第1位一致は4割半ばでした。手元の数字がその水準かそれ以下なら、説明は「この手法から見た寄与」と位置づけることになります。SHAPとLIMEで結果が分かれた行は、単一の特徴を断定せず、両方の上位特徴や食い違いそのものをレビュー対象にするのが安全です。
説明の方法自体を替える案も出てきますが、本体を浅い決定木で置き換えて説明するやり方にも別の限界があります。別のデータで測った決定木の代理モデルの忠実度の検証では、人が読める深さ3の木が本体と同じ答えを返す割合は条件によって開きました。置き換えれば説明が確かになる、という話ではありません。
LIMEを使うなら、乱数シードを変えた再実行をセットにします。 LIME同士が一致しなければ、手法選択以前に説明の再現性が足りていません。サンプル数やカーネル幅を見直す余地はありますが、その調整効果は今回の実験範囲に含めていません。設定を動かして一致率を測ったのは別の実験で、LIMEの近傍幅とサンプル数を比べた検証では、既定幅とそれより広い条件で上位3特徴がシード3組すべて一致した一方、既定の4分の1まで狭めると平均0.3350まで落ちています。
詳しい検証条件
設定を突き合わせて手元で回したい読者のために、条件を細かく書いておきます。
データは12特徴で、いずれも標準正規分布から生成しています。目的変数は、先頭4特徴の単独の効きと、2特徴の掛け合わせ2組を、割合 0・0.5・1.0 で混ぜて作った二値のラベルです。混ぜる前に、それぞれの成分を平均0・標準偏差1へ標準化しています。学習と説明の分け方、係数、行数は、後掲のコードがそのまま実験の縮小版になっています。
2つの手法の設定は次のとおりです。
- SHAP: 木構造をたどる経路を使う方式(
tree_path_dependent) - LIME: 連続値の離散化を切り、1件あたり3,000サンプル、カーネル幅は既定値
指標の中身も書いておきます。上位3の一致は、両手法の上位3集合が重なった数を、両方を合わせた集合の数で割った値です。順位相関にはケンドールの順位相関係数を使い、12特徴すべての寄与の大きさで計算しました。同じ3指標を、乱数シードだけ変えた2回のLIMEにも当てています。
数値はすべて、実際に実行して保存したログを集計したものです。掛け合わせ3水準 × シード3本 × 120行の行ごとの比較を記録し、その平均を載せています。
適用範囲と限界
- どちらが正しいかは判定していません。正解を仕込んだ採点はしておらず、一致しないという事実だけを示しています
- 対象は合成データ・12特徴・LightGBMの1設定のみです。実データでは特徴量の相関や分布の偏りが加わるため、一致率は変わりえます
- LIMEは離散化なし、3,000サンプル、既定のカーネル幅に固定しました。設定変更による一致率や再現性の変化は測っていません
- SHAPは木の経路をたどる方式だけを使いました。背景データを使う方式では、結果が変わる可能性があります
- 比較したのは第1位と上位3本の集合です。僅差の順位逆転と、寄与が大きく異なる行は区別していません
- 掛け合わせ1.0の条件はLIME自身が不安定で、手法差とLIMEの揺れの内訳を分けられていません
- 条件ごとのモデル性能は記録していないため、掛け合わせを強めると一致率が下がった原因は特定できません
同じ行でSHAP・LIME・LIME再実行を比べる
以下は、同じモデルの同じ行にSHAPとLIMEを適用し、一致率を数える最小コードです。LIMEは乱数シードを変えて2回実行します。
"""SHAP と LIME は、同じ行で同じ特徴を挙げるのか。

同一の学習済みモデル・同一の行に両方を当て、行ごとに上位特徴が一致するかを数える。
LIME は乱数で揺れるので、シードだけ変えた2回目も測る。
これがあると「手法の違い」と「LIME 自身のばらつき」を分けて読める。
実行: python sample_disagree.py (所要 1 分程度)
"""

import numpy as np
import pandas as pd
import shap
from lightgbm import LGBMClassifier
from lime.lime_tabular import LimeTabularExplainer
from scipy.stats import kendalltau
from sklearn.model_selection import train_test_split

N, N_FEATURES, N_EXPLAIN, LIME_SAMPLES, TOPK = 6000, 12, 120, 3000, 3
SEED = 0


def make_data(inter_share, seed):
    """交互作用の割合を inter_share で連続的に変えた二値分類データ。"""
    rng = np.random.default_rng(seed)
    X = rng.normal(size=(N, N_FEATURES))
    main = X[:, :4] @ np.array([1.6, -1.2, 0.9, 0.6])         # 単独で効く成分
    inter = 2.0 * X[:, 0] * X[:, 1] + 1.4 * X[:, 2] * X[:, 3]  # 掛け合わせで効く成分
    main = (main - main.mean()) / main.std()
    inter = (inter - inter.mean()) / inter.std()
    logit = 2.0 * ((1 - inter_share) * main + inter_share * inter)
    return (
        pd.DataFrame(X, columns=[f"x{i}" for i in range(N_FEATURES)]),
        rng.binomial(1, 1 / (1 + np.exp(-logit))),
    )


def lime_scores(Xtr, Xe, model, random_state):
    ex = LimeTabularExplainer(
        Xtr.to_numpy(), feature_names=list(Xtr.columns), class_names=["0", "1"],
        discretize_continuous=False, random_state=random_state,
    )
    out = []
    for i in range(len(Xe)):
        m = dict(
            ex.explain_instance(
                Xe.iloc[i].to_numpy(), model.predict_proba,
                num_features=N_FEATURES, num_samples=LIME_SAMPLES,
            ).as_map()[1]
        )
        out.append([abs(m.get(j, 0.0)) for j in range(N_FEATURES)])
    return np.array(out)


def jaccard(a, b):
    return len(set(a) & set(b)) / len(set(a) | set(b))


def top(v, k=TOPK):
    return list(np.argsort(-v)[:k])


rows = []
for share in [0.0, 0.5, 1.0]:
    X, y = make_data(share, SEED)
    Xtr, Xte, ytr, _ = train_test_split(X, y, test_size=0.3, random_state=SEED)
    model = LGBMClassifier(
        n_estimators=300, learning_rate=0.05, verbose=-1, random_state=SEED, n_jobs=1
    ).fit(Xtr, ytr)
    Xe = Xte.iloc[:N_EXPLAIN].reset_index(drop=True)

    sv = np.asarray(shap.TreeExplainer(
        model, feature_perturbation="tree_path_dependent").shap_values(Xe))
    shap_abs = np.abs(sv[:, :, -1] if sv.ndim == 3 else sv)

    lime_a = lime_scores(Xtr, Xe, model, 1)
    lime_b = lime_scores(Xtr, Xe, model, 2)  # シードだけ変えた2回目

    for i in range(len(Xe)):
        rows.append({
            "交互作用": share,
            "SHAP対LIME 第1位": int(top(shap_abs[i], 1)[0] == top(lime_a[i], 1)[0]),
            "SHAP対LIME 上位3": jaccard(top(shap_abs[i]), top(lime_a[i])),
            "SHAP対LIME 順位相関": kendalltau(shap_abs[i], lime_a[i]).statistic,
            "LIME再実行 第1位": int(top(lime_a[i], 1)[0] == top(lime_b[i], 1)[0]),
            "LIME再実行 上位3": jaccard(top(lime_a[i]), top(lime_b[i])),
        })
    print(f"交互作用の割合 {share} 完了", flush=True)

print(f"\n各条件 {N_EXPLAIN} 行 / seed={SEED}")
print(pd.DataFrame(rows).groupby("交互作用").mean().round(4).to_string())
実行すると X does not have valid feature names という警告が出ます。LIME が列名の無い配列でモデルを呼ぶために出るもので、結果には影響しません。
掲載コードを実行すると、次の結果が得られます。
実行結果
各条件 120 行 / seed=0
      SHAP対LIME 第1位  SHAP対LIME 上位3  SHAP対LIME 順位相関  LIME再実行 第1位  LIME再実行 上位3
交互作用
0.0          0.4333         0.6833          0.4785       1.0000       1.0000
0.5          0.4000         0.5225          0.3414       0.9500       0.9708
1.0          0.3750         0.3858          0.2758       0.6333       0.5608
本文の表はシード3本・計360行の平均、掲載コードは実行時間を抑えたシード1本・120行です。そのため数値は完全には一致しません。ただし、掛け合わせ0ではLIMEの再実行が1.0000になること、SHAPとLIMEの第1位一致が0.33〜0.46の範囲にあること、掛け合わせを強めると一致率が下がることは共通しています。シードを [0, 1, 2] に広げると、本文の表と同じ集計条件になります。
安定していても同じ説明になるとは限らない
「SHAPとLIMEはどちらを使うか」に対して、この実験が返せる答えは限定的です。掛け合わせがない条件では、LIMEをシードだけ変えても360行すべてで第1位と上位3が再現しました。それでもSHAPとの第1位一致は半数に届きません。乱数だけでは説明の付かない食い違いが残るということで、個々の行で何が分かれ目になったかまでは測っていません。
同じモデルと同じ行でも説明手法によって上位特徴が変わる、というところまでが今回の確認です。どちらが正しいかは採点していないため、片方を正解として選ぶ根拠にはなりません。次に知りたいのは、実データでも同じ幅の食い違いが出るのかどうかで、そこは今回測っていません。