
分類モデルに1件ずつ予測させると、たいてい0から1のあいだの数字が返ってきます。「この申し込みは0.9」のような値です。この0.9を、10回のうち9回はそうなる見込みとして扱ってよいのでしょうか。
読み方が問われるのは、数字そのものを使うときです。「0.9を超えたら通知を送る」と決めたり、期待値でコストを見積もったり、値をそのまま顧客に見せたり。天気予報の「降水確率70%」が、本当に7割の日で雨になって初めて意味を持つのと同じで、目盛りが合っていなければどれも成り立ちません。
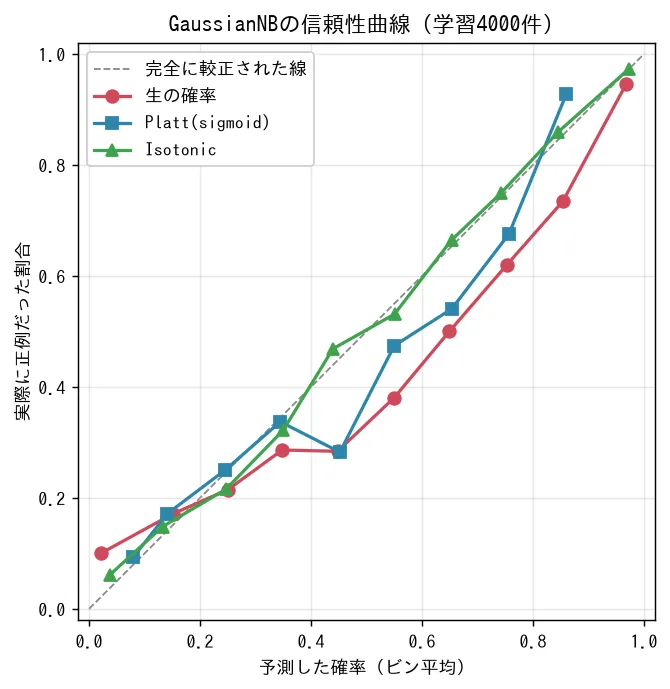
そして目盛りは、しばしば合っていませんでした。今回測った中では、GaussianNB(ナイーブベイズ)が「85%くらい」と答えたサンプルを集めたとき、実際に当たりだったのは7割強です。この目盛りを後から直す処理がキャリブレーション(較正)で、代表的な手法にPlattスケーリングとIsotonic回帰があります。
気になったのは、その効果がどのモデルでも同じように出るのかでした。1つのモデルで「較正すると良くなった」と確かめても、手元のモデルにかけるべきかは決まりません。そこで確率の歪み方が違う3つのモデルに同じ較正を当て、2手法の差と順位性能への影響まで、同じ条件で一度に測りました。
先に結論: 較正の効き幅は、モデルの歪み方が決める
- 確率のずれ(ECE)はGaussianNBで生(較正前)の0.078がIsotonicで0.017、RandomForestで生0.097が0.012まで縮む。一方、もともと整っているロジスティック回帰では改善を確認できず。
- 順位づけの質(ROC-AUC)への影響は確認できず。生の確率との差は主実験(学習4000件)で最大0.0017、学習件数を変えた条件まで含めても0.006以内。上位N件を取るだけの用途なら較正は要らない。
- PlattとIsotonicでは、今回はIsotonicのほうが低い。RandomForestで較正器(確率を引き直す変換)に渡る件数を100件まで減らしても、その順位は変わらず。ただし両者のECE差は、同じRandomForestで学習500件の0.016が8000件では0.002まで縮む。
- ECEの差は、ビン設定(確率を区切る帯の数と切り方)を変えたときの動き幅と比べてから読む。0.08規模の較正効果は8通りのビン設定すべてで残ったが、ロジスティック回帰のPlatt悪化(+0.0015)は等幅ビンを細かくすると符号ごと消えた。
- 適用条件: 合成2値分類データ(20特徴のうち8個が冗長)、クラス比はほぼ均衡で正例が約40%、学習4000件・テスト4000件、3モデル×3方式×10シードの平均(データ量の比較はRandomForestのみ学習500・2000・8000件)、ECEは等幅10ビン、scikit-learn 1.9.0。
確率の良し悪しを測る言葉と、2つの較正方式
この先の表には、確率の良し悪しを測る列が3つと、較正の方式が2つ並びます。名前の意味だけ先に押さえておけば、較正そのものを知らなくても読めます。
- Brierスコア: 予測確率と実際の正解(0か1)の二乗誤差の平均。確率の正確さを総合的に測る指標で、小さいほど良い。
- ECE(期待較正誤差): 予測確率を0.0〜1.0の帯(ビン)に分け、各帯で「モデルが言った平均確率」と「実際に正例(当てたい側のクラス)だった割合」のずれを取り、件数で加重平均したもの。小さいほど確率が正確。
- 信頼性曲線: そのずれを図にしたもの。点が対角線に乗っているほどよく較正されている。
- ROC-AUC: 正例を負例より上位に並べられているかだけを見る指標。1に近いほど良い。確率を単調に引き直す変換では値が変わらない性質がある。
- Plattスケーリング: 予測確率をS字(シグモイド)の曲線1本で引き直す較正。scikit-learnでは
method="sigmoid"と指定する。曲線の形を決めるつまみは2つだけで、大きく形を変えられない代わりに、少ないデータでも崩れにくい。 - Isotonic回帰: 「単調に増えれば形は自由」という、より柔らかい較正。
確率の癖が違う3モデルへ、同じ較正を当てた
選んだのは、確率の癖が正反対だと言われる2つと、もともと整っているはずの1つです。GaussianNBは特徴が互いに独立だと仮定するので、似た情報が重なっていると確率を0や1へ寄せて自信過剰になりがちです。RandomForestは逆に、木の投票を平均するぶん確率が真ん中へ寄る癖があると言われます。ロジスティック回帰は、学習の時点で確率そのものを最適化します。
データはmake_classificationで作った合成の2値分類です。20個の特徴のうち8個をわざと冗長(他の特徴の混ぜ合わせ)にして、GaussianNBが自信過剰になりやすい状況を意図して作りました。正例は約40%で、クラス比はほぼ均衡です。
比べたのは、この3モデルに対する3つの方式(生の確率、Platt、Isotonic)です。評価は独立なテストデータ4000件で行い、データ生成と分割のシードを10回変えた平均を取りました。RandomForestだけは学習件数も500・2000・8000件と振り、データ量で2手法の優劣が入れ替わるかを見ています。
検証前に立てた問いは「較正はBrierスコアとECEをどれだけ下げるか。モデルによって効き方は変わるか」という、下げ幅を測る形でした。悪くなる場合があるかは入れていません。この問いの外から出てきた結果が1つあります。
なお、今回測ったのは合成データだけで、実データや多クラス分類は範囲外です。ほかに測っていない条件は記事末の「適用範囲と限界」に、分割・シード・較正の交差検証といった設定は「詳しい検証条件」にまとめました。
歪んだモデルほど較正が効いた。ずれは5分の1近くまで縮む
もともと確率が歪んでいた2つのモデルでは、較正で目盛りがはっきり合いました。手元のモデルの信頼性曲線が対角線から離れているなら、較正をかける価値があるということです。
GaussianNBの生のECEは0.078。モデルが言う確率と実際の割合が、平均で約8ポイントずれている状態です。Isotonicをかけると、そのずれは5分の1近くまで縮みました。RandomForestの下がり幅はさらに大きく、次の表のとおりPlatt・Isotonicとも0.01台まで落ちています。
| モデル(方式) | Brier | ECE | ROC-AUC |
|---|---|---|---|
| GaussianNB 生 | 0.148 | 0.078 | 0.868 |
| GaussianNB Platt | 0.142 | 0.041 | 0.868 |
| GaussianNB Isotonic | 0.139 | 0.017 | 0.868 |
| RandomForest 生 | 0.071 | 0.097 | 0.971 |
| RandomForest Platt | 0.058 | 0.017 | 0.971 |
| RandomForest Isotonic | 0.058 | 0.012 | 0.971 |
ECEでは2手法に差が出ますが、RandomForestのBrierは、PlattとIsotonicが表示桁では同じ値に並んでいます。表示桁の範囲でBrierに差がない以上、この2手法を選び分ける材料になるのはECEのほうです。
ずれの直り方が素直に見えるのは信頼性曲線です。GaussianNBは生の曲線が対角線から離れており、確率を0や1へ寄せる自信過剰の癖が見えます。較正後は2本ともほぼ対角線に乗りました。
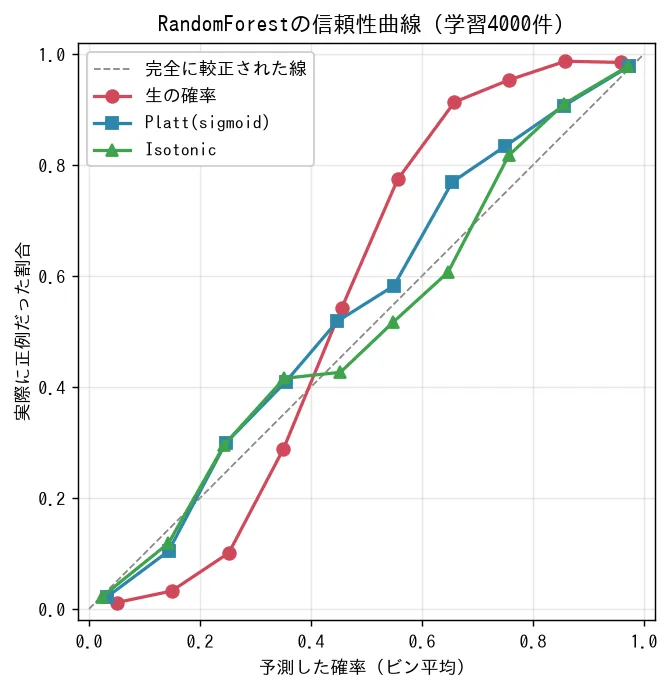
RandomForestは逆です。生の曲線は対角線より急で、実際の正例率が動くほどには確率が振り切れていません。自信を控えめに出す側の歪みです。こちらも較正で引き伸ばされました。性格が正反対の歪みが、どちらも同じ単調な変換で対角線へ寄っています。
「85%」と言った256件の実際は73%だった
冒頭で触れたずれを、1回の実行から取り出して数えてみます。確率の目盛りが合っていないというのは、実務ではこういう形で表れます。
代表シード42・学習4000件のうち、GaussianNBが生の確率で0.80〜0.90の帯に入れたサンプルは256件あり、この帯の平均確率は0.85でした。実際に正例だったのは73%です。0.12ぶんの自信過剰にあたります。
ここへIsotonicをかけると、同じ帯の確率は約0.73へ引き下げられ、実測の割合とほぼ重なりました。較正がやっているのは、モデルの言い分を実際の頻度のほうへ寄せ直す作業です。「85%」を鵜呑みにコスト計算をしていたら、この12ポイントぶんだけ見積もりを外していたことになります。
上位N件を取るだけなら較正は要らない。順位づけの力はほぼ動かなかった
較正をかけても、正例を上位に並べる力はほぼそのままでした。並べ替えて上位N件を処理するだけの使い方なら、較正の有無で成績は動かないと考えて差し支えありません。
主実験(学習4000件)では、3モデル・3方式・10シードを通して、生の確率との差が最大0.0017。学習件数を変えた条件まで含めても最大0.006にとどまりました。順位づけへの影響は確認できていません。
理由は変換の形にあります。PlattもIsotonicも予測確率をほぼ単調に引き直すので、正例と負例の並び順は大きくは崩れません。ROC-AUCは並び順だけで決まる指標です。厳密に言えば、交差検証で作った複数の較正器を平均する今回の手順は単調変換ではありませんが、それでも差はこの幅に収まりました。
整ったロジスティック回帰では改善を確認できず、Plattの+0.0015は等幅ビンを細かくすると符号ごと消える
ロジスティック回帰には、較正で確率が良くなる気配がありませんでした。直す余地が最初から小さいモデルに較正をかけても、得られるものは小さいということです。等幅10ビンで測ると、Plattをかけた側はむしろ少しECEが高く出ます。
| モデル(方式) | Brier | ECE |
|---|---|---|
| ロジスティック回帰 生 | 0.1412 | 0.0232 |
| ロジスティック回帰 Platt | 0.1413 | 0.0246 |
| ロジスティック回帰 Isotonic | 0.1412 | 0.0192 |
ロジスティック回帰は学習の時点で確率を最適化するので、生のECEが0.023とすでに小さく、直す余地がほとんどありません。
ここで比べる相手が対等でない点は先に断っておきます。生の確率は学習データ全体で学習した1つのモデルの出力ですが、PlattとIsotonicは交差検証で分けた5つのモデルを平均した出力です。
その上でPlattをかけると、10シードすべてでECEがわずかに増えました。シード単位のペア差の平均で+0.0015です(表の値は丸めているので、引き算した差とはわずかに違います)。この差には較正だけでなく、いま述べた学習量と平均化の違いも混じっています。Isotonicは0.019へ下がったものの、こちらも明確な差を確認できていません。
そして「10シードすべて」と言えるのは、ECEを等幅10ビンで測ったときだけでした。同じ予測確率にビン設定を8通り当て直すと、悪化側に出るシードは等幅20ビンで6まで落ちます。等幅50ビンでは5。平均差の符号も-0.00032へ反転しました。
等頻度ビンならもっと差が出にくくなるだろうと踏んでいたのですが、そちらは50ビンでも符号が悪化側の+0.00065のままでした。崩れたのはシードの一致だけです。予想が当たったのは「脆い」という見立てまでで、崩れ方は切り方によって違いました。
差が小さすぎるのです。ロジスティック回帰の生ECEは、同じ確率のままビンを増やすだけで0.017(等幅5ビン)から0.039(等幅50ビン)まで2倍以上に動きます。+0.0015はその動き幅の中に埋もれる大きさで、Plattがロジスティック回帰の確率を悪くする、とまでは言えません。
対照的に、この記事の主な結論はビン設定を変えても動きませんでした。GaussianNBとRandomForestで較正するとECEが下がる向きは、8設定すべてで平均が改善側です。シード単位でも、GaussianNBのPlattが7〜9シードにとどまるほかは、8設定すべてで10シードとも改善しました。GaussianNBでIsotonicがPlattより低いことも、8設定すべて・10シードすべてで保たれています。差の大きさが2桁違うと、測り方の選択に対する強さもここまで変わります。
PlattとIsotonicの差は、較正に回せる件数が増えるほど消えていく
PlattとIsotonicのどちらを選ぶかは、使えるデータ量で見え方が変わります。データが少ないうちはIsotonicの分がはっきりしていて、増えるとほぼ並びます。
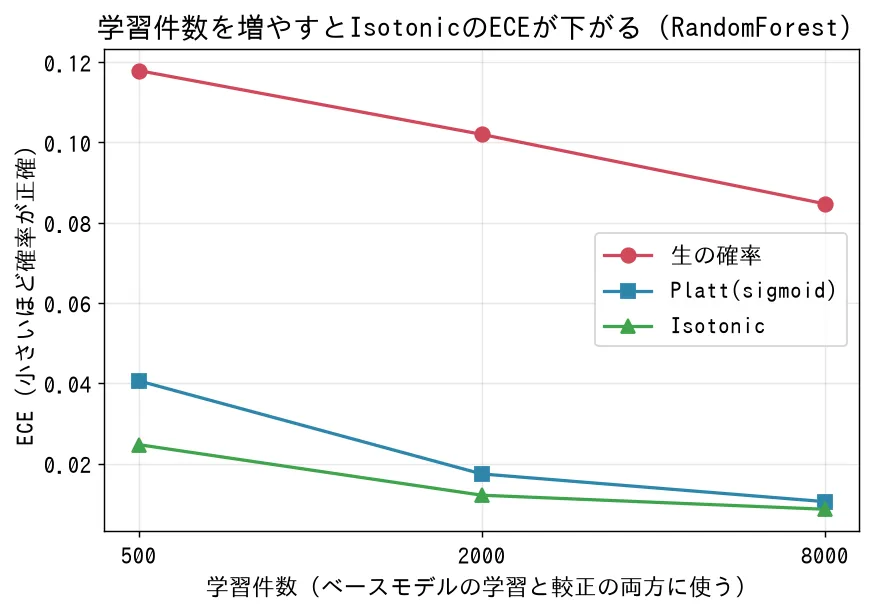
RandomForestで学習件数を変えると、どの規模でも測定値はIsotonicのECEがPlattをわずかに下回り、その差はデータが増えるほど縮みました。
| 学習件数 | 生ECE | Platt ECE | Isotonic ECE |
|---|---|---|---|
| 500 | 0.118 | 0.041 | 0.025 |
| 2000 | 0.102 | 0.017 | 0.012 |
| 8000 | 0.085 | 0.011 | 0.009 |
生ECEの列が0.118から0.085へ下がっているのは、動かしているのが学習件数なので、ベースモデルの学習量も一緒に増えているためです。較正器が見るのはその5分の1で、100件・400件・1600件にあたります。
較正器あたり100件(学習500件)では、Isotonicが0.016ぶん低く出ます。同1600件(学習8000件)では0.002ぶんまで縮みました。変わったのは差の大きさだけです。向きは3規模とも同じでした。8000件でもシード単位のペア差の95%区間は[+0.00059, +0.00329]で0をまたいでいません。
Plattのほうが低く出るシードは8000件で3回ありますが、500件でも2000件でも1回ずつあります。データ量が増えると優劣が入れ替わる、という読み方はできません。
Isotonicは形の自由度が高いぶん、S字1本では拾いきれないずれにも合わせられるので、小さいデータで開く差はその余地ぶんと読めます。一方でこの自由度は、較正データが少ないと過学習の心配につながります。今回は較正器あたり100件でも過学習は表面化しませんでした。交差検証で5つの較正器を平均したことが効いたのかもしれませんが、cvの値も平均化の有無も振っていないので、そこは確かめていません。
実務での順番: ずれを測ってから、較正するかを決める
最初に見るのは、手元のモデルのずれ: いきなり較正せず、信頼性曲線とECEを出します。信頼性曲線はsklearn.calibration.calibration_curveにテストの正解と予測確率を渡せば、ビンごとの実際の正例率と平均予測確率が返ります(描画までまとめてやるならCalibrationDisplay)。ECEは下のサンプル実装の関数で出せます。ずれが小さければ較正で得られるものも小さく、今回のロジスティック回帰では改善を確認できませんでした。ずれていれば較正の出番です。
順位づけだけを使うなら、較正は不要: 並べ替えて上位N件を処理するような使い方では、主実験で生の確率とのROC-AUCの差が0.002を超えませんでした。しきい値も、検証データで実際に選び直すなら較正の有無で選ばれる点が移るだけです。ただし「0.85を超えたら」のように確率の値そのものに意味を持たせて切るなら、それは確率を使う側の話で、上の「85%」の例がそのまま当てはまります。
ずれを直すときの出発点は、Isotonic: 今回はGaussianNBでもRandomForestでもECEが最も下がりました。RandomForestでは較正器あたり100件まで減らしても、その順位は変わりません(GaussianNBで件数を振ってはいないので、こちらは4000件での結果です)。裏を返すと、実測でIsotonicを推せるのはそこまでで、100件を下回る規模は測っていません。一般にIsotonicは少数データで崩れやすいので、較正に回せる件数がそれより心もとないなら、つまみが2つだけのPlattの素直さが安全側に働きます。効いたかどうかは、較正前後の信頼性曲線が対角線に寄ったかを目で見れば分かります。
手法間の小さなECE差は、ビン設定を振ってから読む: ECEはビンの切り方を決めて初めて出る値で、同じ予測確率でもビン数や等幅・等頻度の選択で動きます。比べたい差がその動き幅より小さいなら、その差を根拠に手法を選ばないでください。確かめ方は単純で、モデルは触らず、同じ予測確率のままビン数と切り方を変えたECEを並べるだけです。
詳しい検証条件
較正は必ず学習データの内側だけで行っています。CalibratedClassifierCVに交差検証(cv=5)を指定し、ベースモデルの学習と、確率を引き直す変換(較正器)のフィットを別々のデータに任せる形です。ここを分けないと、較正器が答えを覗き見て、見かけ上うまく合ってしまいます。cv=5なら学習データを5つに分けて較正器を5つ作り、最後に平均します。較正器1つが見るのは、学習件数の5分の1です。
比較の基準になる生の確率は、学習データ全体で学習したモデルのpredict_probaをそのまま使いました。データ量でPlattとIsotonicの効き方が変わるかを見る条件では、RandomForestだけ学習件数を500・2000・8000件と変えて同じ較正を測っています。GaussianNBとロジスティック回帰は学習4000件の1条件だけです。
ECEはビンの切り方を決めないと計算できません。この記事の数値はすべて等幅10ビンです。ここは測る側の選択で、ECEの絶対値もビンの取り方で動きます。そこで主実験と同じ予測確率に対して、等幅と等頻度×5・10・20・50ビンの8通りでECEを取り直し、結論がビンの選び方に寄りかかっていないかを別に確かめました(2026-08-18実施)。
この追加計測だけは実行機がmacOS/arm64で、本編のLinux/x86と違います。GaussianNBとロジスティック回帰の値は本編と一致しましたが、RandomForestだけ最大3.4e-3ずれました。RandomForestの較正効果(ECEで0.08前後)より1桁以上小さいので、本文の判定は変わりません。
数値はすべて、実際に実行して保存したログを集計したものです。独立した試行単位はデータ生成と分割のシードで、42から51までの10個ぶんの平均を各モデル×方式ごとに取りました。
読み飛ばし可: 統計手法・データ生成パラメータ・再現条件
- 合成データは
make_classification(n_features=20, n_informative=10, n_redundant=8, n_clusters_per_class=2, class_sep=0.8, flip_y=0.02, weights=[0.6, 0.4])。少数派クラスは約40%。 - 主実験は学習4000件・テスト4000件を固定。較正の交差検証はcv=5。RandomForestは木100本の既定設定。
- ずれの大きさが手法選択を左右する箇所(PlattとIsotonicの差、ロジスティック回帰での増減)については、シード単位のペア差にブートストラップ95%信頼区間(B=10,000、seed=42)を当て、区間が0をまたぐかを確認しました。この区間は「10シードから推定した平均差の不確実性」であって、実行時間などの測定ばらつきではありません。
- ロジスティック回帰のECEの変化量は、Plattが+0.0015[+0.0010, +0.0019]で区間が0をまたがず、Isotonicは-0.0040[-0.0085, +0.0001]で0をまたぎました。
- ECEはビン境界
np.linspace(0, 1, 11)の等幅10ビンで算出。信頼性曲線の図は代表シード42・学習4000件で描画しています。 - 実行機の違いによるECEのずれは、GaussianNBとロジスティック回帰で8e-15まで一致、RandomForestで最大3.4e-3でした(ライブラリ版は本編と同一)。
適用範囲と限界
- 適用範囲: 合成2値分類データでの傾向です。実データや多クラス分類では、較正の効き方も手法間の差も変わりえます。
- クラス比: 正例が約40%のほぼ均衡なデータだけを測っています。正例が数%しかないような強い不均衡は範囲外で、そこでは較正の効き方も変わりえます。
- データ量: 較正データ量だけの効果は分離していません。学習件数を振ったのはRandomForestだけで、GaussianNBとロジスティック回帰は学習4000件の1条件です。較正器あたり100件より小さい規模の挙動も測っていません。
- 指標の測り方: 本文のECEは等幅10ビンの値です。ビン設定を8通りに変えても0.08規模の差は残りましたが、0.002を下回る差は等幅でビンを細かくすると符号ごと動きます。
- モデル依存: 効果はモデルの元の歪みに強く依存します。ここで測った3モデル以外へそのまま一般化はできません。
サンプル実装
RandomForestの生の確率・Platt・Isotonicを、Brierスコア・ECE・ROC-AUCで比べる最小の実装です。make_classificationで合成データを作るので、取得なしでそのまま動きます。較正はCalibratedClassifierCV(cv=5)で学習データの内側だけで行い、評価は独立なテストデータで行います。ECEを計算する関数の定義も、本文と同じ等幅10ビンです。
"""生の確率・Platt・Isotonicを Brier / ECE / ROC-AUC で比較する完全版デモ。"""
import numpy as np
from sklearn.datasets import make_classification
from sklearn.ensemble import RandomForestClassifier
from sklearn.calibration import CalibratedClassifierCV
from sklearn.model_selection import train_test_split
from sklearn.metrics import brier_score_loss, roc_auc_score


def expected_calibration_error(y_true, y_prob, n_bins=10):
    # 予測確率を等幅ビンに分け、各ビンの|正解率 - 平均予測確率|を件数で加重平均する
    edges = np.linspace(0.0, 1.0, n_bins + 1)
    idx = np.digitize(y_prob, edges[1:-1])
    n = len(y_true)
    ece = 0.0
    for b in range(n_bins):
        mask = idx == b
        if mask.sum() == 0:
            continue
        conf = y_prob[mask].mean()          # ビン内の平均予測確率
        acc = y_true[mask].mean()           # ビン内の実際の正解率
        ece += (mask.sum() / n) * abs(acc - conf)
    return ece


# 冗長特徴を含む合成2値分類データ
X, y = make_classification(
    n_samples=8000, n_features=20, n_informative=10, n_redundant=8,
    n_clusters_per_class=2, class_sep=0.8, flip_y=0.02, weights=[0.6, 0.4],
    random_state=42,
)
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=4000, stratify=y, random_state=42)

# 生の確率: 学習データ全体で学習してそのまま予測
raw = RandomForestClassifier(n_estimators=100, random_state=42, n_jobs=4)
raw.fit(X_tr, y_tr)
probs = {"生": raw.predict_proba(X_te)[:, 1]}

# Platt(sigmoid)とIsotonic: 学習データの内側を cv=5 で分けて較正
for name, method in [("Platt", "sigmoid"), ("Isotonic", "isotonic")]:
    base = RandomForestClassifier(n_estimators=100, random_state=42, n_jobs=4)
    calibrated = CalibratedClassifierCV(base, method=method, cv=5)
    calibrated.fit(X_tr, y_tr)
    probs[name] = calibrated.predict_proba(X_te)[:, 1]

# 3方式をまとめて評価
for name, p in probs.items():
    print(f"{name:9s}  Brier={brier_score_loss(y_te, p):.4f}  "
          f"ECE={expected_calibration_error(y_te, p):.4f}  "
f"ROC-AUC={roc_auc_score(y_te, p):.4f}")実行手順: 上のコードを calibration_demo.py として保存し、必要なライブラリを入れて実行します。
pip install scikit-learn==1.9.0 numpy==2.4.6
python calibration_demo.pyこのデモは単一シードなので、本文の10シード平均とは小数点以下が少しずれます。それでも、ECEが生よりPlatt・Isotonicで大きく下がり、ROC-AUCが3方式でほぼ同じになる関係はそのまま再現できます。信頼性曲線は入れていませんが、sklearn.calibration.calibration_curve(y_te, p, n_bins=10, strategy="uniform")にここで作ったy_teと各方式の確率を渡すと、ビンごとの実際の正例率と平均予測確率が返ります。それを対角線と一緒に描けば図1・図2と同じ形になります(記事の図もこの関数で描いています)。
まとめ
較正は、当てれば必ず得をする後処理ではありませんでした。効き幅はモデルの歪み方が決め、もともと歪んでいないモデルには効きません。
引っかかったのは、その整ったロジスティック回帰です。Platt側がわずかに悪く見えました。下げ幅だけを測るつもりで立てた検証前の問いに、悪化という選択肢は入れていません。それが手法の欠点なのか測り方の揺れなのかを切り分けるには、同じ確率にビン設定を8通り当て直す追加の計測が要りました。
自信を持って持ち帰れるのは、確率が歪んだモデルではECEが大きく下がること、それでも順位づけはほぼ動かないこと、この2つまでです。合成データでクラス比がほぼ均衡という条件の外へは出られていません。次は同じ較正を実データの不均衡な分類に当て、ずれの直り方としきい値選びへの影響を確かめます。新しい数値は、この記事の結果と並べて追記する予定です。
同じシリーズでは、SMOTEやクラス重みといった少数派を増やす対策そのものを不均衡データの対策を比較で測っています。ただしあちらは少数派1%まで含む不均衡データが対象で、正例が約40%の今回とは条件が違います。テーブルデータでのモデル選びそのものはGBDT3種の実測比較にまとめています。