
回帰モデルをいくつか作って精度表を並べると、誤差の測り方を変えただけで1位が入れ替わることがあります。片方は普段の予測がよく当たるものの、ときどき大きく外すモデルで、もう片方は飛び抜けて大きな失敗がない代わりに、普段の誤差が少し大きいモデルです。どちらを選ぶべきかは、精度表を眺めるだけでは決まりません。
理由は、指標によって「よい予測」の基準が違うからです。RMSEは大きな誤差を重く扱い、MAEは各行を同じ重さで数え、MAPEは実測値に対する誤差の割合で見ます。複数の指標を並べても、何を減らしたいかが曖昧なままでは、採用するモデルを決められません。
そこで、目的変数の偏り、外れ値、ゼロ付近の値を別々に変え、同じモデルの予測順位がどう動くかを調べました。比較するときは、1位が同じかどうかと、順位全体が揃っているかを分ける必要があります。この違いを押さえると、指標が割れたときに確認すべきデータと、主指標を決める順番が見えてきます。
目的に合わせて読む: RMSEの目安を知りたい / 外したときの損失から選ぶ / ゼロ・負の値の注意点 / 手元のモデルの順位を比べる。
先に結論: 主指標は多数決ではなく、外したときの損失で決める
主指標は、予測を外したときに何が困るかから決めます。普段の誤差を均等に減らしたいならMAE、大きな失敗を特に避けたいならRMSEが候補になるため、複数指標の多数決では用途に合うモデルを選べません。実際に、5,000行の2%をモデルから予測できない極端な値へ変えると、10回すべてでRMSEとMAEの1位が異なりました。単に分布が右へ偏っていることよりも、どのような行で大きく外すかが判断を分けます。
比率で評価したい場合は、先に実測値の範囲を確認します。ゼロ付近ではMAPEが不安定になり、負の値があるとRMSLEは計算できないためです。また、同じテストデータではR²とRMSEのモデル順位が一致するので、R²を別の1票として数える意味はありません。R²は評価側の平均を予測する定義上の基準からの差として読み、後で使う学習側平均の基準予測とは区別します。
この判断の根拠は、合成データ180通り(1条件5,000行・特徴量8列)とPMLBの実データ4件での比較です。8モデルの設定を全条件で固定し、10 seedの平均を求めていますが、検定は行っていません。
この記事で使う6つの物差し
この記事で使う6つの指標は、実測値と予測値のずれを数値にまとめる点では共通していますが、どの誤差を重く扱うかが異なります。RMSEやMAEのように小さいほどよい指標がある一方、R²は大きいほどよい指標なので、値の向きと、重視する誤差を合わせて押さえておきます。
- RMSE: 誤差を2乗して平均し、平方根を取った値。大きく外した行ほど強く効きます。
- MAE: 誤差の絶対値の平均。すべての行を同じ重さで見ます。
- MedAE: 誤差を小さい順に並べたときの中央の値。極端に大きな誤差が少数あっても影響を受けにくい指標です。
- MAPE: 誤差を実測値で割った比率の平均をパーセントで表した値。実測値が小さい行ほど重くなります。
- RMSLE: 実測値と予測値を対数へ変換してから測る指標。値そのものより、何倍ずれたかを重視します。
- R²: 評価側の実測値が一定でない場合、その平均を常に予測する比較を0、完全一致を1とする指標。0を下回ることもあります。
RMSEの目安は?単位・基準予測・許容誤差で確認する
「RMSEが1以下なら良い」といった、どの問題にも使える合格点はありません。 RMSEは予測対象と同じ単位を持つため、同じ予測のずれでも、円から万円へ直せば数値は1万分の1になります。良し悪しを判断するには、まず基準予測との改善幅を比べ、そのうえで用途に必要な精度を満たすかを確かめます。
| 確認すること | 手元で行う作業 | ここで分かること |
|---|---|---|
| 単位と評価行 | 実測値と予測値の行順を揃え、同じ単位に戻して計算する | 数値を比較できる状態か |
| 基準予測との差 | 学習側の平均を常に返す予測と、同じ評価行でRMSEを比べる | 単純な予測から改善したか |
| 許容誤差の超過 | 用途から先に決めた誤差の上限を、何件がどちら向きに超えたか数える | 大きな失敗が何件残ったか |
基準予測は、複雑なモデルを使う価値を確かめるための比較相手です。RMSEには学習側の平均、MAEには学習側の中央値を返す定数予測が出発点になります。これはscikit-learnのDummyRegressorでも作れます。運用中の予測方法があるなら、それも同じ評価行で比べてください。
基準からどれだけ改善したかを計算する
同じ評価行・単位・重みで計算した2つのRMSEを入れます。基準の値がまだなければ、下の確認コードで求められます。
改善率 = (1 − モデルのRMSE ÷ 基準のRMSE) × 100。基準が0なら割合は計算できません。基準が0に近いと割合が大きく動くため、元の単位での差も確認します。
計算はブラウザー内で行います。入力値の送信・保存はしません。基準よりRMSEが小さくても、用途に必要な精度を満たすとは限りません。次に、許容誤差を超える件数を確認します。
基準のRMSEがないときは、予測配列から確認する
下のコードに必要なのは、学習側の実測値、評価側の実測値と予測値、許容する誤差の4つです。基準の平均・中央値を決めるのは学習側だけで、評価側の答えは使いません。学習時の行へ当てた予測ではなく、未学習の評価行への予測を渡します。
標準化や対数変換を使った場合は、実測値・予測値を比較したい単位へ戻してから評価します。log1p(y)を学習した例なら予測配列をnp.expm1で戻します。計算済みのRMSEの数値だけにexpやexpm1をかけても、元の単位のRMSEにはなりません。
学習側の基準予測と、許容誤差の超過を確認するコード
下のコードはNumPyだけを使い、Python 3.12.13・NumPy 2.5.4で実行を確認しています。末尾にある4つの入力を置き換えると、手元の予測を評価できます。掲載した4行の架空例は計算を確かめるためのもので、実モデルの性能を測った実験ではありません。
import numpy as np


def check_regression(y_train, y_eval, y_pred, tolerance):
    # 単一の目的変数、各行を同じ重みで評価する
    train, truth, pred = [np.asarray(v, dtype=float)
                          for v in (y_train, y_eval, y_pred)]
    if any(v.ndim != 1 or v.size == 0 or not np.isfinite(v).all()
           for v in (train, truth, pred)):
        raise ValueError("空でない1次元の有限な数値配列を入れてください")
    if truth.shape != pred.shape:
        raise ValueError("評価用の実測値と予測値の長さを揃えてください")
    if not np.isfinite(tolerance) or tolerance < 0:
        raise ValueError("許容誤差には0以上の有限な数値を入れてください")

    # 基準値は学習側だけで決め、評価側の平均や中央値は使わない
    with np.errstate(over="raise", under="raise", invalid="raise", divide="raise"):
        mean_prediction = np.mean(train)
        median_prediction = np.median(train)
        error = pred - truth  # 正なら過大予測、負なら過小予測
        absolute_error = np.abs(error)
        rmse = float(np.sqrt(np.mean(error ** 2)))
        baseline_rmse = float(np.sqrt(np.mean((truth - mean_prediction) ** 2)))
        mae = float(np.mean(absolute_error))
        baseline_mae = float(np.mean(np.abs(truth - median_prediction)))
    reduction = None if baseline_rmse == 0 else (1 - rmse / baseline_rmse) * 100
    if reduction is not None and not np.isfinite(reduction):
        reduction = None
    return {
        "n": len(truth), "rmse": rmse, "baseline_rmse": baseline_rmse,
        "reduction_percent": reduction,
        "mae": mae, "baseline_mae": baseline_mae,
        "over_tolerance": int(np.sum(absolute_error > tolerance)),
        "under": int(np.sum(error < -tolerance)),
        "over": int(np.sum(error > tolerance)),
        "max_absolute_error": float(absolute_error.max()),
    }


# 以下は計算確認用の架空の例。実モデルの性能を示すデータではない
# y_trainだけが学習側。y_evalとy_predは未学習の同じ行順・元の単位で揃える
y_train = [80., 100., 100., 160.]
y_eval = [80., 100., 120., 100.]
y_pred = [82., 101., 118., 116.]
tolerance = 5.  # 説明用の仮定。実際は用途から事前に決める

r = check_regression(y_train, y_eval, y_pred, tolerance)
print(f"RMSE: モデル {r['rmse']:.3f} / 学習側平均の基準 {r['baseline_rmse']:.3f}")
rate = r["reduction_percent"]
print("RMSE改善率:", "計算不能" if rate is None else f"{rate:.1f}%")
print(f"MAE: モデル {r['mae']:.3f} / 学習側中央値の基準 {r['baseline_mae']:.3f}")
print(f"許容誤差を超えた行: {r['over_tolerance']}/{r['n']}")
print(f"超過の内訳: 過小予測 {r['under']} / 過大予測 {r['over']}")
print(f"最大絶対誤差: {r['max_absolute_error']:.3f}")
この例の出力:
RMSE: モデル 8.139 / 学習側平均の基準 17.321
RMSE改善率: 53.0%
MAE: モデル 5.250 / 学習側中央値の基準 10.000
許容誤差を超えた行: 1/4
超過の内訳: 過小予測 0 / 過大予測 1
最大絶対誤差: 16.000
モデルのRMSEは基準から53.0%下がりましたが、誤差16の過大予測があり、仮に決めた許容誤差5を超える行が1件残っています。このように平均的な誤差が改善しても、大きな失敗を許容できるとは限らないため、改善率と超過した行を併せて判断します。ただし、4行の例から本番の失敗率を見積もることはできません。
許容誤差とちょうど同じ行は超過に数えず、上回った行だけ数えます。RMSEの基準が0の場合、改善率は「計算不能」と表示します。非常に大きい・小さい数値でFloatingPointErrorが出たら、単位を見直して両側へ同じ換算を施してください。
結果を見て、次に調べる場所を決める
| 確認結果 | 次に行うこと |
|---|---|
| 基準予測よりRMSEが悪い | 行順・単位・前処理を照合し、学習側と評価側で対象が変わっていないか調べる。モデルの調整へ進む前に、単純な予測も残す |
| 基準より良いが、許容誤差を超える行がある | 超過した行を確認する。入力ミスなら修正し、実際に起こる事象なら除かず、対象別の誤差と対処を検討する |
| この評価では基準より良く、超過もない | 別の妥当な分割・期間でも確認する。用途の許容条件、推論時間や運用コストを併せて判断する |
結果を見ながら許容誤差を緩めたり、都合のよいテスト行だけ残したりすると判断基準が変わります。対処法を検証データで選び、最終テストは条件を固定してから確認します。相談や報告には、評価対象と件数/単位/基準予測の作り方/RMSEの差/許容誤差と超過件数/未確認の条件を残すと、判断に足りない情報が分かります。
適用条件: 時系列、R²、正規化したRMSEの注意点
- このコードは単一の目的変数を各行同じ重みで評価します。複数の目的変数、サンプル重み、過小・過大予測の異なる損失には、その用途に合う集計が必要です。
- 時系列は時間順の分割を守り、前期値・前年同時期などの基準も候補になります。単純な時系列予測を基準にした比較を参照してください。
- R²が0となる定義上の比較は、評価側の実測値の平均です。上のコードで使う学習側平均とは違うため、「学習側平均に勝てば必ずR²が正」とは限りません。評価側が一定値のときなど、R²には別の扱いが必要です。
- NRMSEという名前でも、RMSEを平均・標準偏差・最大最小の幅のどれで割るかで値が変わります。分母や評価対象が違う値を比べたり、一律の合格点を置いたりしないでください。
目的変数の形だけを変えて、同じ8モデルの順位を見た
指標が食い違う原因を分けるため、目的変数の形を変えた合成データを用意しました。変えたのは、値が右へ偏る強さ(右歪み)、特徴量からは予測できない外れ値(一部の行の値を10〜100倍にしたもの)の混入率、目的変数とゼロの距離です。それぞれを6段階ずつ変えたうえで、公開データ4件でも同じ比較を行い、モデルの順位がどう動くかを確かめました。
比べたのは、平均や中央値を返すだけの基準モデルから線形回帰・決定木・LightGBMまでの8モデルです。指標ごとのチューニングはせず、設定は全条件で固定しています。
偶然の結果でないかを見るため、乱数を変えて10回繰り返しました。合成データでは、データの生成と学習用・テスト用の分け方が回ごとに変わります。実データでは、分け方だけが変わります。同じ回では、8モデルすべてを共通のテストデータで評価しています。
食い違いの大きさは、主に2つの数で表します。「1位一致率」は2つの指標が同じモデルを最良にした割合、「順位逆転率」は2つのモデルの優劣が指標を変えると逆になる割合です。
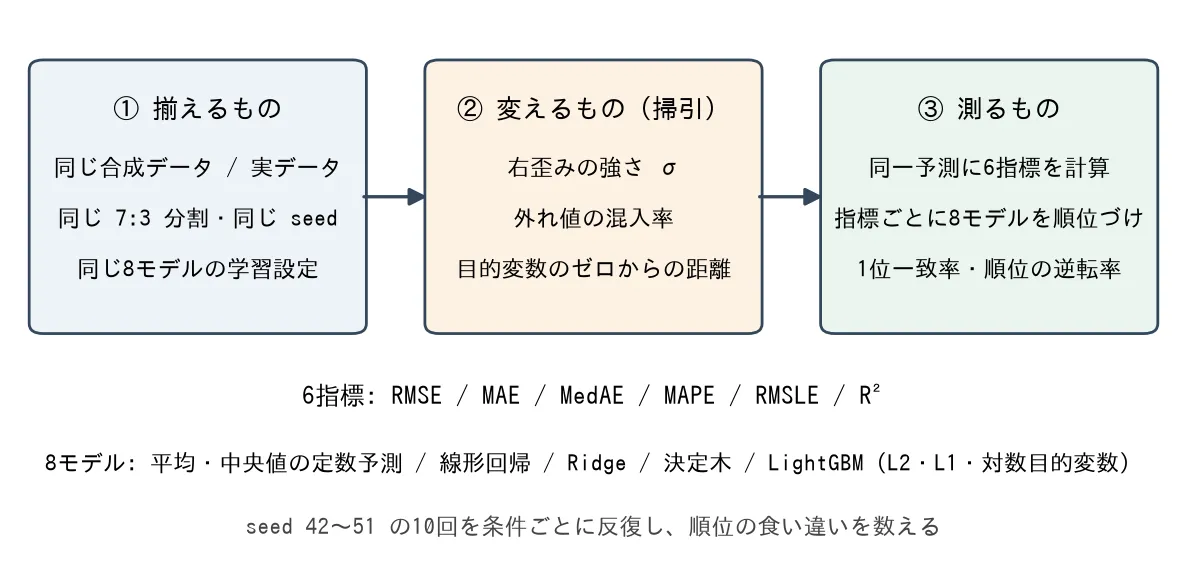
読み飛ばし可: 3条件の作り方・実データの内訳・モデル構成・集計の定義
合成データは、入力データと目的変数の基本的な関係を固定し、目的変数の形だけを変えて作りました。各条件で5,000行を生成しています。
- 右歪み: 小さい値が多く、一部だけ大きな値を取る分布です。偏りの弱い状態から強い状態まで6段階を用意しました。
- 外れ値の混入率: 右への偏りが中程度の分布を土台に、0から10%まで6段階。特徴量とは無関係に行を選び、その実測値を10〜100倍にします。単位の取り違えや記録ミスに相当する汚れです。
- ゼロからの距離: 目的変数全体を平行移動し、ゼロ付近や負の値が増える条件を6段階で作りました。
実データ4件は、公開データセットの配布リポジトリPMLB(Penn Machine Learning Benchmarks)から選びました。住宅価格(20,640行)、CPU使用率(8,192行)、大気汚染(500行)、体脂肪率(252行)です。CPU使用率は実測値がちょうど0の行を3.5%含みます。
8モデルの内訳は、平均を返すだけと中央値を返すだけの基準モデル2つ、線形回帰、Ridge、決定木、LightGBM3種です。LightGBMの3種は学習時に重く見る誤差が違い、大きな誤差を重く見るL2版、各行の誤差を均等に見るL1版、目的変数を対数へ変換して学習する対数版と呼び分けます。
順位逆転率は、8モデルから2つ選んだ28組のうち、指標を変えると優劣が逆になった組の割合です。1位だけでなく途中の順位まで割れているかを確認するため、順位全体の揃い方を表すKendall tauも補足の表で併用しています(定義はその表の前に置きます)。
指標を並べても1位は揃わず、割れ方は条件ごとに違った
6指標の1位が揃うことはまれでした。RMSEとMAEでは、予測できない外れ値を2%以上混ぜると毎回1位が異なる一方、右への偏りだけを最も強くした条件では10回中7回一致しました。ゼロ付近の値では、主にMAPEとの順位が変わりました。
6指標の1位が一致することは少なかった
計算できた指標の1位がすべて一致したのは、合成データで30.6%、実データでは7.5%でした。多くの条件で、少なくとも1つの指標だけ異なるモデルが1位になっています。
組み合わせ別では、大きな誤差を強く重く見るRMSEと、ほかの指標との間で1位が分かれやすい結果でした。一方、RMSEとR²の順位は常に一致しています。1位が割れること自体は異常ではありません。問題は、どの指標を主にするかを決めないまま票を数えることです。
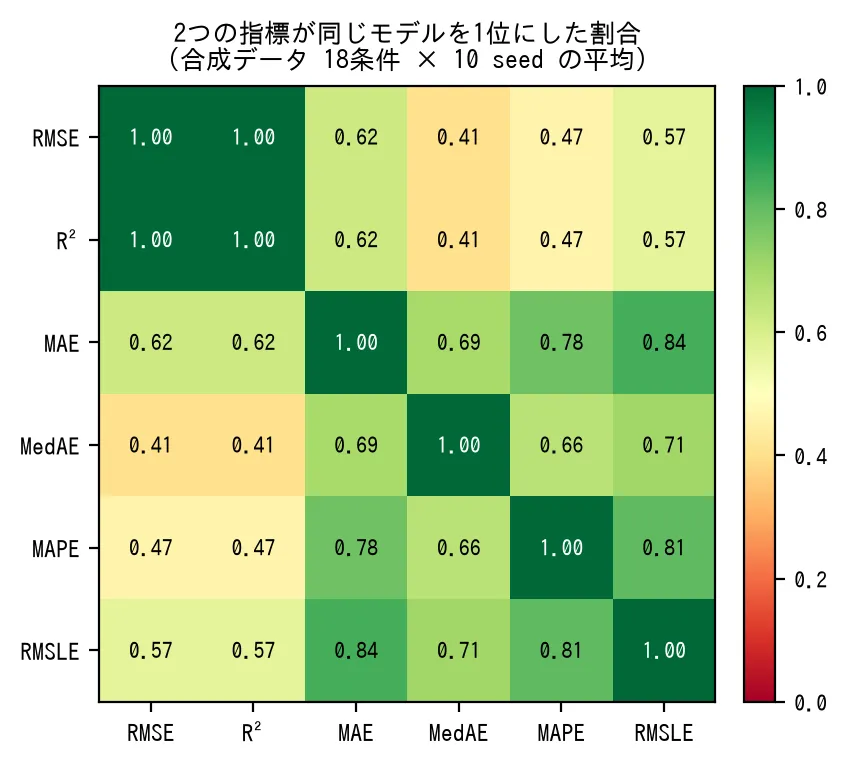
読み飛ばし可: 指標ペアごとの一致率と集計条件
「計算できた指標が」と断っているのは、合成データの180通りのうち41通りではRMSLEが計算できず、5指標だけで判定しているからです。6指標すべてが計算できた139通りに限れば一致率は0.381、5指標だけの41通りでは0.049でした。実データの40通りは全件で6指標とも計算できているので、0.075はどちらの数え方でも同じです。
指標の組み合わせごとに見ると、割れ方には偏りがあります。合成データ18条件・10seedの平均です。表のKendall tauは順位全体の揃い方を1つの数にしたもので、1なら2つの指標の順位が完全に一致し、0なら順位に関係がありません。
| 指標のペア | 1位一致率 | 順位逆転率 | Kendall tau |
|---|---|---|---|
| RMSE と R² | 1.000 | 0.000 | 1.000 |
| MAE と RMSLE | 0.842 | 0.063 | 0.875 |
| MAE と MAPE | 0.783 | 0.109 | 0.781 |
| RMSE と MAE | 0.622 | 0.168 | 0.664 |
| RMSE と RMSLE | 0.568 | 0.188 | 0.624 |
| RMSE と MAPE | 0.467 | 0.250 | 0.500 |
| RMSE と MedAE | 0.406 | 0.246 | 0.508 |
行ごとに集計対象の条件数が違う点だけ、先に断っておきます。RMSLEを含むペアは実測値に負が出ない139通り、含まないペアは180通りの平均です。15ペアすべてが計算できる139通りに揃え直すと、MAEとMAPEの1位一致率は0.783から0.928へ上がり、行の並び順も入れ替わります。読むべきは行どうしの細かい上下ではなく、RMSEを含むペアが下位に沈むという全体の向きです。
順位を大きく変えたのは、外れ値とゼロ付近の値だった
外れたのは予想のほうでした。右へ長い裾を持つデータほど指標が割れると見込んでいたのに、実際に順位を壊したのは裾の重さではなく、特徴量と無関係に混ぜた外れ値です。
3種類の条件を比べると、指標が食い違う理由は同じではありませんでした。
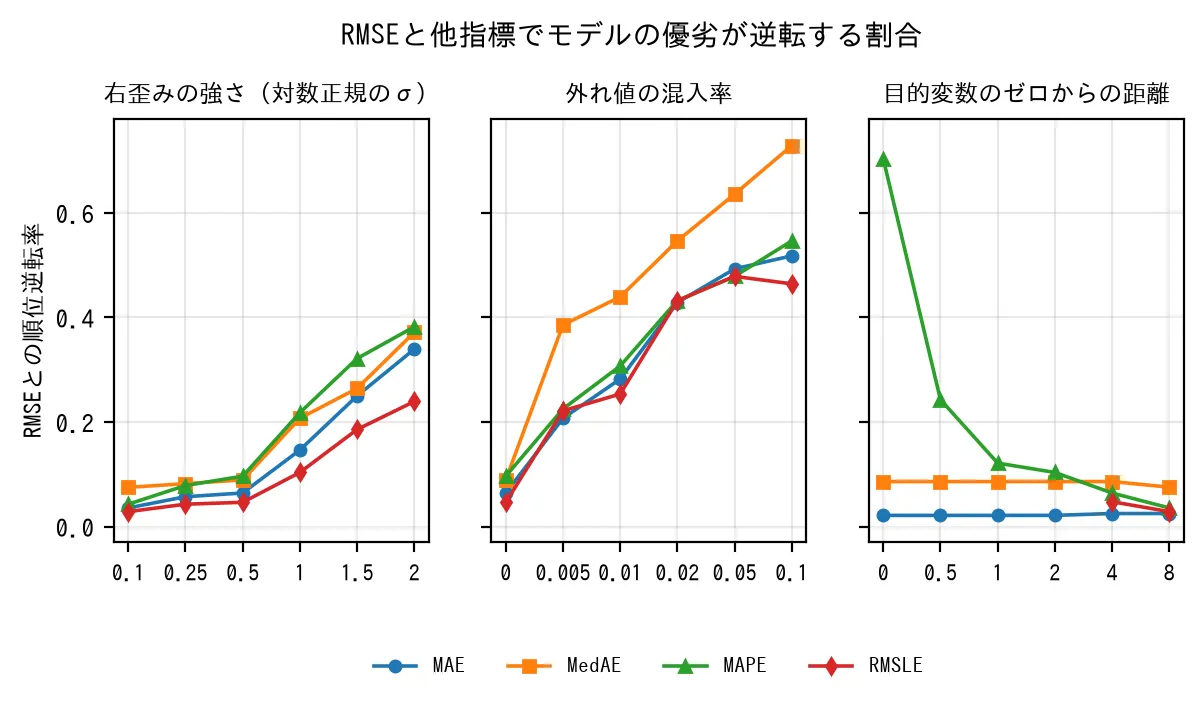
最も大きく順位が割れたのは、モデルから予測できない外れ値を混ぜた条件です。5,000行のうち25行前後を極端な値へ変えただけで、RMSEとMAEの1位一致率は9割から3割へ下がりました。100行前後を変えた2%の条件では、10回の測定すべてで1位が異なりました。
1位の一致で見ると、右への偏りだけを強めた条件では、外れ値を混ぜた条件ほどの食い違いは起きませんでした。偏りを最も強くした条件でも、RMSEとMAEの1位は10回中7回一致しています。ただし、順位全体が揃ったわけではありません。この条件の順位逆転率は0.339で、外れ値1%の0.282より高く、1位の一致と全順位の一致は区別する必要があります。
2026年11月4日訂正: この比較の説明を、1位の一致と順位全体の一致に分けました。元の測定値は変更していません。
ゼロ付近ではMAPEだけが大きく動きました。足す定数を0にして目的変数がゼロをまたぐ条件では、RMSEとMAPEの1位は10回すべてで異なり、MAPE上の1位は平均または中央値を返すだけのモデルでした。 同じ条件でもRMSEとMAEの関係はほとんど変わりません。
読み飛ばし可: 条件別の順位逆転率と1位一致率
| 外れ値の混入率 | 順位逆転率 | 1位一致率 |
|---|---|---|
| 0% | 0.064 | 0.9 |
| 0.5% | 0.207 | 0.3 |
| 1% | 0.282 | 0.1 |
| 2% | 0.429 | 0.0 |
| 5% | 0.493 | 0.0 |
| 10% | 0.518 | 0.0 |
右歪みだけを強めた系列では、変化は緩やかでした。同じRMSEとMAEでも、σ=0.1では逆転率0.036・1位一致率0.9、σ=0.5でも0.064・0.9です。σ=2.0まで上げて、ようやく0.339・0.7となりました。
目的変数をゼロへ近づけると、今度はMAPEだけが大きく動きます。RMSEとMAPEの逆転率は、足す定数が8のときの0.036から定数0の0.704へ上がり、1位一致率は0.9から0.0へ低下しました。同じ系列でRMSEとMAEの逆転率は0.021〜0.025に収まっているため、データ全体でモデル順位が不安定になったわけではありません。
目的変数がゼロをまたぐ条件(定数0)では、MAPE上の1位は10 seedすべてが定数予測でした(平均が5回、中央値が5回)。同じ条件のRMSE上の1位はLightGBMのL2版が7回、対数版が3回です。実測値がゼロ付近を通る行では、少し外しただけで比率の誤差が跳ね上がるため、その行の予測を小さく保つ定数モデルが有利になります。
分かれ目は、大きくなった行をモデルが予測できたかどうかでした。右へ強く偏った条件では、大きな値にも特徴量から予測できる情報が残っています。外れ値の条件では、どの行を大きくするかを特徴量と無関係に決めたため、モデルには予測できませんでした。どのモデルも同じ行で大きく外すと、RMSE上のモデル差がほとんど消えてしまいます。順位が割れた原因を探すなら、分布の偏りを見る前に、平均を返すだけのモデルと比べてRMSE上の改善がほとんど消えていないかを確かめます。
読み飛ばし可: 裾の重さと予測しやすさを測り直した結果
冒頭で触れた予想(分布の裾に極端な値があるほど割れる)を、分布の形に加え、平均を返すだけの定数予測から最良モデルのRMSEがどれだけ下がったかで測り直します。すると、裾が最も重いのは右歪みσ=2.0なのに、順位が完全に割れたのは外れ値2%の条件でした。
| 条件 | 最大値÷中央値 | 中央値の10倍超の行 | 上位1%の2乗誤差寄与 | 最良モデルのRMSE削減率 | 最良モデルのMAE削減率 | RMSEとMAEの1位一致率 |
|---|---|---|---|---|---|---|
| 右歪み σ=2.0 | 3,685倍 | 12.5% | 96.3% | 18.2% | 48.3% | 0.7 |
| 外れ値 2% | 193倍 | 1.8% | 93.1% | 0.35% | 40.8% | 0.0 |
分布の形の3列はseed 42の1本、削減率と一致率は10 seedぶんの集計です。削減率の比較基準は、RMSE・MAEともに平均を返す定数予測です。「最良モデル」は、RMSE側が定数予測も含めた8モデルからの最小、MAE側が定数予測を除いた6モデルからの最小です。MAEの削減率は中央値を返す定数予測との比較ではありません。
裾の重さを表す3列は、いずれも右歪みσ=2.0の方が大きいにもかかわらず、RMSEとMAEの1位一致率は0.7を保っています。対する外れ値2%は、裾が相対的に軽くても一致率が0.0でした。外れ値系列の中でも、上位1%の行が2乗誤差に占める割合は、混入率0.5%の97.2%から10%の64.7%へ下がる一方、逆転率は0.207から0.518へ上がります。「2乗誤差が少数行へ集中するほど割れる」という予想とも逆向きです。
両者を分けたのは、定数予測からのRMSE削減率でした。右歪みはσ=2.0でも18.2%の改善余地を残しますが、外れ値2%では0.35%まで縮みます。MAEの削減率はどちらの系列でも39〜51%を保っていました。
この説明には限界があります。「削減率」はRMSEから作った量なので、RMSEとMAEの食い違いとは独立ではありません。機序の説明としては筋が通りますが、独立した検証ではないという位置づけです。RMSEと無関係な根拠は、外れ値の行を特徴量と無関係に選んでいるという生成の作りだけです。加えて、ゼロ近傍の系列は裾がまったく重くない(上位1%の寄与は8.4%)のにRMSEとMAPEの逆転率が0.704まで上がります。食い違いを裾の話だけに一本化することはできません。
外れ値10%では、MAEの改善幅は比較する基準でも変わる
外れ値を10%まで増やした条件では、RMSEが最も小さいモデルでも、平均を返すだけのモデルとの差は0.6%でした。対してMAEでは、LightGBMのL1版(各行の誤差を均等に見る設定)が平均予測から41.6%改善しています。ただし、MAEは平均だけでなく、中央値を返す定数予測とも比較する必要があります。中央値予測のMAEは4.817、LightGBM(L1)は4.622で、両者の差は小さい結果でした。
平均予測からの41.6%の改善だけでは、学習モデルを使う価値が大きいとは判断できません。 RMSEには平均、MAEには中央値という、それぞれの指標に合う定数予測を基準にして改善幅を確認します。
読み飛ばし可: 外れ値10%における各モデルの指標値
値は10 seedの平均で、太字はその指標の列でいちばん良い値を指します。RMSEとR²では線形回帰とRidgeが並びました。
| モデル | RMSE | MAE | MAPE(%) | R² |
|---|---|---|---|---|
| 平均の定数予測 | 18.517 | 7.916 | 479.5 | -0.000 |
| 中央値の定数予測 | 19.050 | 4.817 | 52.2 | -0.059 |
| 線形回帰 | 18.405 | 7.930 | 389.1 | 0.012 |
| Ridge | 18.405 | 7.930 | 389.1 | 0.012 |
| LightGBM(L2) | 19.162 | 8.521 | 449.0 | -0.072 |
| LightGBM(L1) | 18.979 | 4.622 | 29.4 | -0.051 |
| LightGBM(対数) | 18.854 | 4.910 | 63.8 | -0.037 |
| 決定木 | 20.928 | 8.162 | 434.6 | -0.279 |
RMSEの列だけを見ると、最良の18.405と平均を返すだけのモデルの18.517の差は、0.6%しかありません。この18.405は線形回帰とRidgeが並んだ値です。表示した桁では区別がつかず、10 seedの平均でRidgeがごくわずかに下回っただけでした。R²も0.012で、表示上は-0.000となる平均予測を含め、8モデル中6モデルが負です。
実際、RMSEとR²の1位は10 seed中Ridgeが7回、線形回帰が2回、そして平均の定数予測そのものが1回でした。RMSEのseed間の標準偏差は1.6前後あり、モデル間の差より大きく開いています。
同じ予測をMAEで見ると景色が変わります。LightGBM(L1)が4.622で、平均の定数予測の7.916に対して41.6%の削減です。MAPEでもLightGBM(L1)の29.4%に対しLightGBM(L2)は449.0%で、15.3倍の開きがあります。MAE・MedAE・MAPEの1位は10 seedすべてLightGBM(L1)、RMSLEの1位は10 seedすべてLightGBM(対数)でした。
外れ値10%は極端な設定ですが、10〜100倍という値の飛び方そのものは、単位の取り違えや記録ミスでも起こりえます。指標を変えて改善が大きく見えたときは、比較する定数予測の選び方でも印象が変わっていないかを確認します。
R²はRMSEと同じ順位しか返さなかった
合成データ180通り、実データ40通りのすべてで、RMSEとR²は同じモデル順位になりました。
RMSEとR²は、どちらも誤差を2乗して計算します。同じテストデータなら「RMSEが小さい順」と「R²が大きい順」は一致するため、2つを並べてもモデル選定の票は増えません。
R²は順位を決めるための追加情報ではなく、値の水準に意味があります。0を下回ったモデルは、平均を返すだけの予測よりも悪い状態です。
読み飛ばし可: R²が0を下回った件数
合成データ1,440件のうち543件でR²が0を下回り、定数予測を除いても183件ありました。最小値は右歪みσ=2.0における決定木の-19.24です。実データでも320件中86件が負で、定数予測を除くと6件、最小値は大気汚染データの決定木による-0.2435でした。
MAPEは小さい実測値を重く見て、予測全体を低めに寄せることがある
事前に立てた仮説は「MAPEは過小予測を過大に罰する」でしたが、この形では成立しませんでした。
1件ずつ見れば、MAPEは同じ絶対誤差の上下を同じ重さで扱います。誤差の絶対値を実測値で割るため、実測値100に対して90と予測しても110と予測しても10.0%です。一方、絶対誤差が同じ10でも、実測値10なら100.0%、1000なら1.0%になります。誤差の向きではなく、実測値の大きさが行ごとの重みを決めます。
定数だけで予測した追加実験では、MAPEが最小になる値が、実測値の中央値より下へ寄りました。MAPEを小さくすることが、予測全体を低めに置く方向へ働く場合があります。過小予測と過大予測で損失が異なる用途では、MAPEが小さいことと業務上の損失が小さいことを同一視できません。
読み飛ばし可: 予測を上下へずらした追加実験
この仮説だけは本体と分けた小さな実験で確かめました。実測値をいったん完全な予測とみなし、全行へ一律のずれを加えたときに指標がどう変わるかを調べます。加法では実測値の標準偏差の0.1倍と0.2倍を足し引きし、乗法では0.9倍・0.8倍と、その逆数である1.111倍・1.25倍を使いました。対象はσ=1.0の対数正規に従う合成データ5,000行と住宅価格データ、seedは42の1通りです。
合成データで、予測全体に一律のずれを入れたときの値です。
| ずらし方 | RMSE | MAE | MAPE(%) | RMSLE |
|---|---|---|---|---|
| 全体に -0.1sd(過小) | 0.2208 | 0.2208 | 36.071 | 0.1231 |
| 全体に +0.1sd(過大) | 0.2208 | 0.2208 | 36.071 | 0.1119 |
| 全体に ×0.9(過小) | 0.2757 | 0.1652 | 10.000 | 0.0560 |
| 全体に ×1.111(過大) | 0.3064 | 0.1836 | 11.111 | 0.0581 |
加法のずれでは、MAPEは36.071と36.071で一致しました。ただしこれは測定というより計算の結果です。実測値そのものを予測とみなしてから同じ量を足し引きしているので、全行の絶対誤差が同じ値になり、上下で一致するのは避けられません。RMSE・MAE・MedAEが3つとも0.2208で並んでいるのが、その現れです。
加法のずれで上下差が出たのはRMSLEでした。過小予測の0.1231が過大予測の0.1119を上回りますが、ここには負になった339行を0へ直した影響が混ざっています。同じ表の乗法では過大側の0.0581が過小側の0.0560より大きく、向きが逆です。どちらか一方をRMSLEが常に重く罰すると一般化できる結果ではありません。
乗法の行では、MAPEは過大側の11.111%が過小側の10.000%を上回りました。ここで使った×0.9と×1.111は逆数の関係にある倍率で、対数のうえでは同じ幅ですが、線形の比率では-10%と+11.1%とずらし幅そのものが違います。
住宅価格データでは、RMSLEが乗法のずれに対してほぼ対称でした(×0.9と×1.111がどちらも0.1054)。これはデータの性格の違いというより計算式の話で、RMSLEは実測値と予測値に1を足してから対数を取るため、値が1より十分大きい住宅価格では足した1がほとんど効きません。合成データは値が1前後なので、足した1が効いて左右がずれます。
読み飛ばし可: 各指標が最小になる定数予測
MAPEの偏りは、行をまたいで予測全体を動かすと現れます。実測値が小さい行では過大予測の比率誤差に上限がありませんが、予測値が0以上なら過小予測は100%で頭打ちです。そこで、定数だけで全行を予測した場合に各指標が最小になる位置を探しました。実測値の0.1パーセント点から99.9パーセント点までを4,001点に区切り、表では中央値を1とした比で示します。
| データ | RMSE | MAE | MedAE | MAPE | RMSLE |
|---|---|---|---|---|---|
| 合成(σ=1.0の対数正規) | 1.661 | 1.000 | 0.579 | 0.372 | 1.245 |
| 住宅価格 | 1.151 | 1.000 | 0.723 | 0.708 | 0.986 |
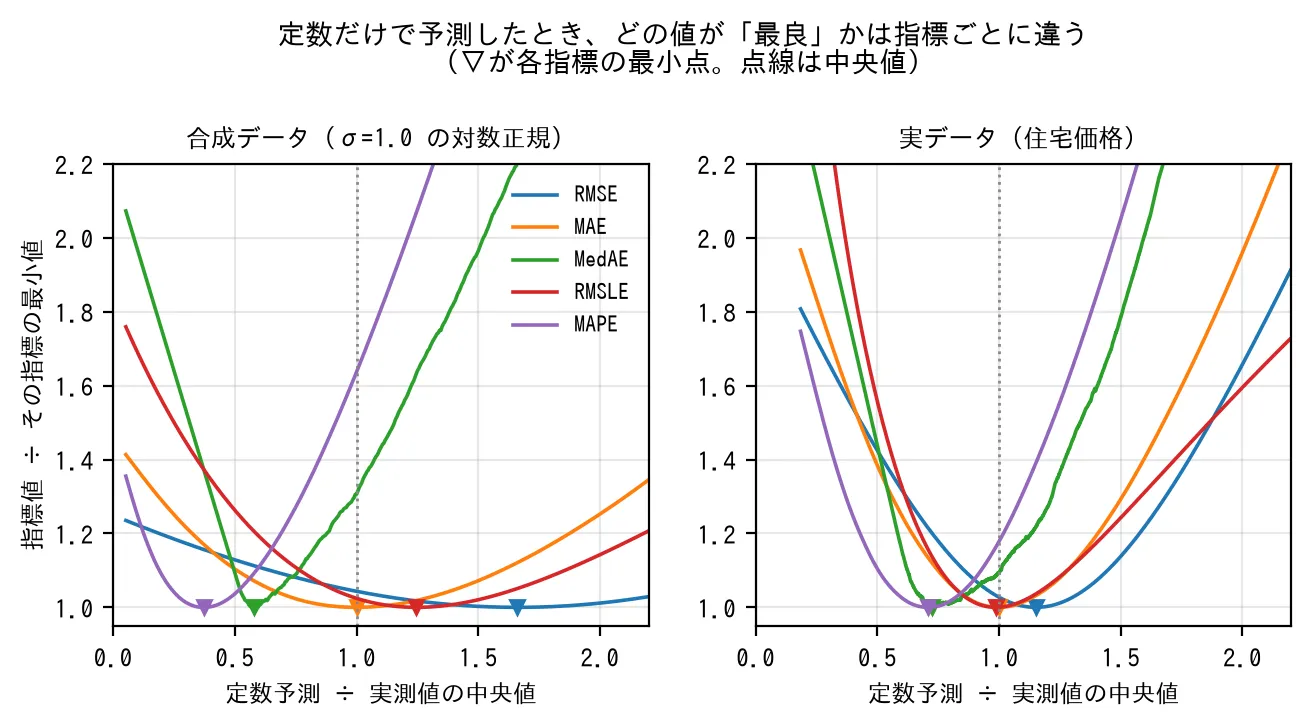
実データでも、指標ごとに別のモデルが安定して1位になった
実データの1つである住宅価格データでも、RMSE上の1位はLightGBMのL2版(大きな誤差を重く見る設定)、MedAEではL1版、MAPEとRMSLEでは対数版(目的変数を対数へ変換して学習する設定)でした。乱数を変えた10回すべてで同じ結果だったため、偶然のデータ分割だけで生じた違いではありません。
もう1つ目を引いたのが線形回帰です。RMSEでは8モデル中4番手(平均順位4.4)なのに、RMSLEでは最下位(平均順位8.0)で、平均を返すだけの定数予測より悪い値になりました。
原因は予測の下側にあります。線形回帰は住宅価格を負と予測する行を出しており、その行数はseedによって25行から43行でした。0に直してからRMSLEを計算するため、この数十行が対数の世界で極端に大きな誤差になります。
読み飛ばし可: 住宅価格データの指標値とモデル順位
住宅価格データ(20,640行、テスト6,192行)の10 seed平均です。
| モデル | RMSE | MAE | MedAE | MAPE(%) | RMSLE | R² |
|---|---|---|---|---|---|---|
| 平均の定数予測 | 115618 | 91373 | 76388 | 62.49 | 0.5922 | -0.0002 |
| 中央値の定数予測 | 118802 | 88663 | 68975 | 53.02 | 0.5716 | -0.0560 |
| 線形回帰 | 69586 | 50844 | 39093 | 30.52 | 0.8932 | 0.6376 |
| Ridge | 69586 | 50843 | 39094 | 30.52 | 0.8923 | 0.6376 |
| 決定木 | 74191 | 53407 | 39191 | 31.57 | 0.3673 | 0.5881 |
| LightGBM(L2) | 47281 | 31906 | 21312 | 18.12 | 0.2370 | 0.8327 |
| LightGBM(L1) | 49817 | 31575 | 19177 | 16.72 | 0.2350 | 0.8142 |
| LightGBM(対数) | 48576 | 31631 | 19891 | 16.59 | 0.2281 | 0.8234 |
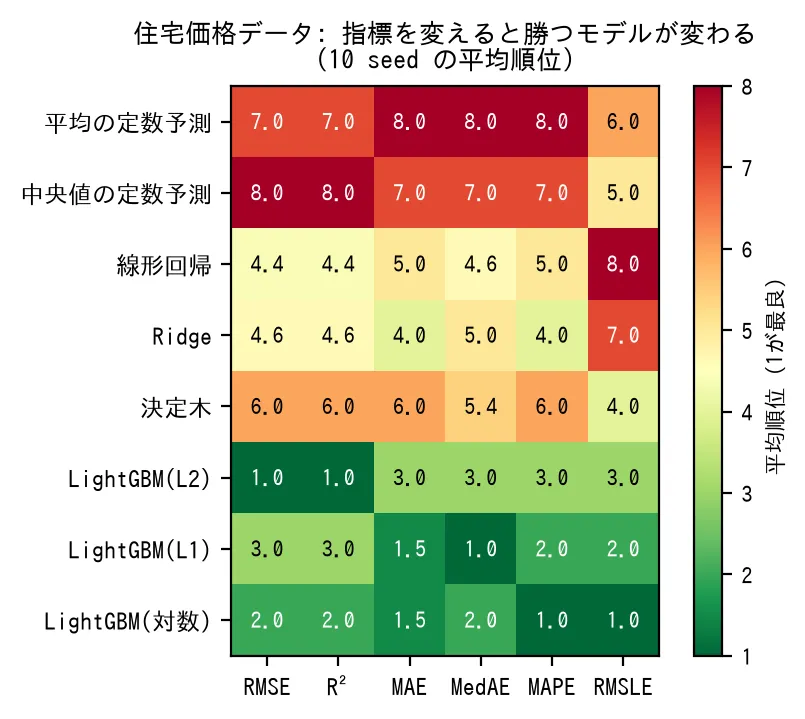
上位3モデルはいずれもLightGBMで、違うのは学習時の目的関数です。それでも1位は指標ごとに分かれ、RMSEとR²ではL2版、MedAEではL1版、MAPEとRMSLEでは対数版が10 seedすべてで選ばれました。MAEのみ、L1版と対数版が5回ずつです。学習時と評価時に重く見る誤差が対応した並びですが、目的関数だけの効果を分離した実験ではありません。
seed間の振れ幅も指標で違いました。線形回帰のRMSEは68,733から71,207の範囲に収まる一方、同じ線形回帰のRMSLEは0.8127から1.0234まで揺れています。比率で評価する指標を採用する前に、モデルが負や極端に小さい値を出していないかも確認します。
MAPEは実測値0、RMSLEは負の値に注意する
順位が食い違う以前に、指標が値を返さないことがあります。
MAPEのゼロ割は実データでも起きました。CPU使用率データでは、テスト2,458行のうち平均81.1行(3.3%)が実測値0のため評価から外れています。体脂肪率データでも76行中平均0.1行を除外しました。今回は該当行を除く実装ですが、scikit-learnの既定のように分母へ下限を設ければ、除外されず巨大な値として残ります。処理方法によって評価対象や値が変わるため、MAPEにはゼロの件数と計算方法を併記します。
RMSLEも、合成データ1,440件のうち実測値に負を含む328件で計算できませんでした。足す定数が0・0.5・1・2の条件は全モデル・全seed、定数4も10 seed中1 seedが該当します。負の予測を0へ直してから計算した組み合わせは、合成で300件、実データで72件ありました。目的変数が負を取りうるならRMSLEは使えず、MAPEも比率の解釈が不自然になります。
主指標は損失から決め、割れたら外れ値・ゼロ・負の予測を見る
最初に決めるのは、外したときに何が高くつくかという損失の形。 普段の誤差を少しずつ減らしたいのか、大きく外す少数のケースを特に避けたいのかを決めます。前者ならMAE、後者ならRMSEが候補です。割合のずれを重視する場合はMAPEやRMSLEも候補になります。
指標の名前より先に、目的変数と予測値の範囲を数える。 0、負の値、極端に小さい値がないかを数えます。実測値0ではMAPEをそのまま計算できず、負の値があればRMSLEは使えません。計算と解釈が成立するかを確かめたうえで、指標を決めます。
平均や中央値を返すだけのモデルも、同じデータで評価しておく。 学習したモデルだけで順位を付けないという意味です。高性能なはずのモデルが基準モデルからほとんど改善していなければ、指標が一部の外れ値に引っぱられている可能性があります。外れ値を10%混ぜた条件では、RMSEで最良のモデルでも改善幅が1%に届きませんでした。
この3つで主指標を1つ決め、ほかの指標はモデルの弱点を探すために使います。指標ごとに1位が違っても、多数決で決める必要はありません。
主指標を決めたあと、ほかの指標と順位が違ったら、外れ値、実測値0、負の予測を確認します。今回の比較では、目的変数が右へ偏っているという見た目だけでは、RMSEとMAEがどれだけ食い違うかを判断できませんでした。
比率で評価する場合は、予測値の範囲にも注意が必要です。前節の線形回帰の例のように、負の予測が数十行あるだけでRMSLEは定数予測より悪くなります。MAPEには予測全体を低めへ寄せる方向も観測されているため、過小予測と過大予測のどちらが高くつくかを先に決めておきます。
詳しい検証条件: 分割・計算不能時の扱い・実装の定義
学習用とテスト用の比率は7対3です。集計はどの条件も10 seedの平均と1位になった回数で、統計的検定は行っていません。指標の偏りを調べる小さな実験だけは本体と分けており、条件は該当する節に示しています。
読み飛ばし可: MAPEとRMSLEを計算できない場合の扱い
MAPEは実測値が0の行で割り算が成立しないため、その行を除外し、除外件数も記録しました。scikit-learnの既定のように分母へ下限を設けなかったのは、ゼロ近傍で値が発散する挙動をそのまま観測するためです。
RMSLEは実測値に負が1つでも含まれる条件を計算不能として順位の集計から外し、予測が負になった場合は0に直したうえで件数を記録しました。R²の分母には、テスト側の実測値の平均を使っています。
数値は保存した実行ログから集計しています。指標別のチューニング、今回の6つ以外の指標、時系列やカウントデータは対象外で、詳しい範囲は次の節にまとめました。
読み飛ばし可: 指標の実装定義・モデル設定・データの取得元
- RMSEは誤差の2乗平均の平方根、MAEは誤差の絶対値の平均、MedAEはその中央値。MAPEは実測値が0でない行について「誤差の絶対値÷実測値の絶対値」の平均を100倍したもの。RMSLEは実測値と予測値に1を足して対数を取った差の2乗平均の平方根で、予測が負の場合は0に直してから計算します。R²は「1 − 誤差の2乗和 ÷ 実測値の分散に相当する量」です。
- LightGBMは3種とも木の本数200、学習率0.05、葉の数31で固定。決定木は深さ5まで、Ridgeはalphaがscikit-learnの既定値です。対数化して学習するモデルは、学習データの最小値が正でない場合に「1 − 学習データの最小値」を足してから対数を取り、予測時に戻します。この足し込む量は学習データだけから決めており、テスト側は参照していません。
- 外れ値の条件は、σ=0.5の対数正規分布を土台にしています。
- 外れ値の混入は分割の前に全行へ独立に適用しているので、テストの情報が学習側へ渡ることはありません。
- 実データはPMLBから取得しました。取得日は2026-08-01で、取得時のHTTPステータスとバイト数、SHA256を実行ログに残しています。PMLBのリポジトリ自体はMITライセンスですが、収録されたデータの元の配布条件はデータセットごとに異なります。自分の用途で使う場合は、元の出典の条件を確認してください。
適用範囲と限界
検証対象は表形式データの回帰です。合成データは1条件5,000行・特徴量8列で、目的変数のもとになる値(潜在値)へ加えるノイズは、信号の標準偏差の0.5倍に固定しました。行数、特徴量数、信号とノイズの比を変えた場合に、順位の食い違いがどう動くかは測っていません。実データ4件もPMLB由来の252〜20,640行であり、時系列、カウントデータ、目的変数が確率や比率となる問題は範囲外です。ゼロが多いカウントデータで指標と目的関数の選択がどう絡むかは、LightGBMのPoisson・Tweedie・log1pを比べた検証で別に測っています。
8モデルの設定は全条件で固定し、評価指標に合わせたチューニングを行っていません。実務では学習時の損失関数を主指標へ合わせることがあり、その場合の順位は変わる可能性があります。また、示した順位はseedごとの振れを含んだ集計であり、検定で判定したものではありません。
MAPEの偏りを調べた別実験は、右への偏りの強さを表すσが1.0の合成データと住宅価格の2件、seed 42の1通りに限られます。MAPEを最小にする定数が中央値より下へ寄った結果を、すべてのデータへ一般化することはできません。MAPEでは実測値0の行を除き、RMSLEでは負の予測を0へ直しているため、分母へ下限を設けるなど実装を変えれば数値も変わります。
この検証から判断できるのは、どの条件で6指標のモデル順位が分かれたかまでです。業務上どの指標を優先すべきかは、過小予測と過大予測、大外れと通常の誤差にどのような損失があるかを別途定義して決めます。
手元のデータで確かめるサンプルコード
次のコードは、実測値と4モデルの予測値を受け取り、6指標の値と順位、指標を変えると優劣が逆転するモデルの組を返します。例では平均の定数予測、線形回帰、LightGBMのL2版とL1版を学習しています。手元で確認する場合は、データ生成部分を自分の特徴量と目的変数へ置き換えてください。
"""複数モデルの予測に6指標を当てて、指標間で優劣が逆転する組み合わせを洗い出す。

必要なもの: numpy, pandas, scikit-learn, lightgbm
実行: python metric_disagreement_check.py
"""
import itertools

import numpy as np
import pandas as pd
from lightgbm import LGBMRegressor
from sklearn.dummy import DummyRegressor
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

# 小さいほど良い指標
LOWER_IS_BETTER = {"RMSE", "MAE", "MedAE", "MAPE", "RMSLE"}


def score_all(y, p):
    """同じ予測に6指標を当てる。MAPEは実測値0の行を除外、RMSLEは予測の負値を0にクリップ。"""
    y, p = np.asarray(y, float), np.asarray(p, float)
    nz = y != 0
    out = {
        "RMSE": np.sqrt(np.mean((y - p) ** 2)),
        "MAE": np.mean(np.abs(y - p)),
        "MedAE": np.median(np.abs(y - p)),
        "MAPE": np.mean(np.abs(y[nz] - p[nz]) / np.abs(y[nz])) * 100 if nz.any() else np.nan,
        "RMSLE": (np.sqrt(np.mean((np.log1p(y) - np.log1p(np.clip(p, 0, None))) ** 2))
                  if (y >= 0).all() else np.nan),
        "R2": 1 - np.sum((y - p) ** 2) / np.sum((y - y.mean()) ** 2),
    }
    out["MAPE_除外行数"] = int((~nz).sum())
    return out


def compare(y_true, preds):
    """preds は {モデル名: 予測配列}。指標ごとの値・順位と、逆転したペアを返す。"""
    table = pd.DataFrame({name: score_all(y_true, p) for name, p in preds.items()}).T
    metrics = [c for c in table.columns if c != "MAPE_除外行数"]
    ranks = pd.DataFrame(index=table.index)
    for m in metrics:
        # 1位=最良になるよう、大きいほど良い指標だけ並び順を反転
        ranks[m] = table[m].rank(ascending=(m in LOWER_IS_BETTER))

    reversals = []
    for ma, mb in itertools.combinations(metrics, 2):
        if table[ma].isna().any() or table[mb].isna().any():
            continue
        for a, b in itertools.combinations(table.index, 2):
            da = ranks.loc[a, ma] - ranks.loc[b, ma]
            db = ranks.loc[a, mb] - ranks.loc[b, mb]
            if da * db < 0:
                win_a = a if da < 0 else b
                win_b = a if db < 0 else b
                reversals.append({"指標A": ma, "指標B": mb, "モデル1": a, "モデル2": b,
                                  "Aの勝者": win_a, "Bの勝者": win_b})
    return table, ranks, pd.DataFrame(reversals)


def main():
    rng = np.random.default_rng(0)
    n = 4000
    X = rng.normal(size=(n, 6))
    u = 1.2 * X[:, 0] - 0.8 * X[:, 1] + 0.6 * np.sin(1.5 * X[:, 2]) + rng.normal(scale=0.6, size=n)
    y = np.exp(0.5 * (u - u.mean()) / u.std())
    # 2%の行を極端な値にする(記録ミス相当)
    hit = rng.random(n) < 0.02
    y[hit] *= 30

    X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0)
    preds = {
        "平均の定数予測": DummyRegressor(strategy="mean").fit(X_tr, y_tr).predict(X_te),
        "線形回帰": LinearRegression().fit(X_tr, y_tr).predict(X_te),
        "LightGBM(L2)": LGBMRegressor(objective="l2", n_estimators=200, learning_rate=0.05,
                                      random_state=0, n_jobs=1, verbose=-1
                                      ).fit(X_tr, y_tr).predict(X_te),
        "LightGBM(L1)": LGBMRegressor(objective="l1", n_estimators=200, learning_rate=0.05,
                                      random_state=0, n_jobs=1, verbose=-1
                                      ).fit(X_tr, y_tr).predict(X_te),
    }

    table, ranks, rev = compare(y_te, preds)
    print("== 指標値 ==")
    print(table.round(3).to_string())
    print("\n== 順位(1が最良) ==")
    print(ranks.to_string())
    print(f"\n== 逆転したペア: {len(rev)}件 ==")
    if len(rev):
        print(rev.to_string(index=False))
    for m in ["RMSE", "MAE", "MAPE"]:
        print(f"{m} の1位: {ranks[m].idxmin()}")


if __name__ == "__main__":
    main()
コードを metric_disagreement_check.py として保存し、必要なライブラリを入れて実行します。
pip install numpy==2.4.6 pandas==3.0.5 scikit-learn==1.9.0 lightgbm==4.7.0
python metric_disagreement_check.py
この実行例では、RMSE上の1位は線形回帰、MAEとMAPEではLightGBM(L1)でした。指標15ペアとモデル6ペアを組み合わせた90組のうち18組で優劣が逆転し、逆転がなかった指標ペアはRMSEとR²、MAEとMAPE、MAEとRMSLE、MAPEとRMSLEの4組です。
実行結果(長い出力)
== 指標値 ==
               RMSE    MAE  MedAE     MAPE  RMSLE     R2  MAPE_除外行数
平均の定数予測       5.246  1.507  0.982  122.514  0.544 -0.002        0.0
線形回帰          5.182  1.443  0.863   84.385  0.484  0.023        0.0
LightGBM(L2)  5.454  1.900  0.830  129.968  0.657 -0.083        0.0
LightGBM(L1)  5.214  0.791  0.135   17.525  0.380  0.010        0.0

== 順位(1が最良) ==
              RMSE  MAE  MedAE  MAPE  RMSLE   R2
平均の定数予測        3.0  3.0    4.0   3.0    3.0  3.0
線形回帰           1.0  2.0    3.0   2.0    2.0  1.0
LightGBM(L2)   4.0  4.0    2.0   4.0    4.0  4.0
LightGBM(L1)   2.0  1.0    1.0   1.0    1.0  2.0

== 逆転したペア: 18件 ==
  指標A   指標B    モデル1         モデル2         Aの勝者         Bの勝者
 RMSE   MAE    線形回帰 LightGBM(L1)         線形回帰 LightGBM(L1)
 RMSE MedAE 平均の定数予測 LightGBM(L2)      平均の定数予測 LightGBM(L2)
 RMSE MedAE    線形回帰 LightGBM(L2)         線形回帰 LightGBM(L2)
 RMSE MedAE    線形回帰 LightGBM(L1)         線形回帰 LightGBM(L1)
 RMSE  MAPE    線形回帰 LightGBM(L1)         線形回帰 LightGBM(L1)
 RMSE RMSLE    線形回帰 LightGBM(L1)         線形回帰 LightGBM(L1)
  MAE MedAE 平均の定数予測 LightGBM(L2)      平均の定数予測 LightGBM(L2)
  MAE MedAE    線形回帰 LightGBM(L2)         線形回帰 LightGBM(L2)
  MAE    R2    線形回帰 LightGBM(L1) LightGBM(L1)         線形回帰
MedAE  MAPE 平均の定数予測 LightGBM(L2) LightGBM(L2)      平均の定数予測
MedAE  MAPE    線形回帰 LightGBM(L2) LightGBM(L2)         線形回帰
MedAE RMSLE 平均の定数予測 LightGBM(L2) LightGBM(L2)      平均の定数予測
MedAE RMSLE    線形回帰 LightGBM(L2) LightGBM(L2)         線形回帰
MedAE    R2 平均の定数予測 LightGBM(L2) LightGBM(L2)      平均の定数予測
MedAE    R2    線形回帰 LightGBM(L2) LightGBM(L2)         線形回帰
MedAE    R2    線形回帰 LightGBM(L1) LightGBM(L1)         線形回帰
 MAPE    R2    線形回帰 LightGBM(L1) LightGBM(L1)         線形回帰
RMSLE    R2    線形回帰 LightGBM(L1) LightGBM(L1)         線形回帰
RMSE の1位: 線形回帰
MAE の1位: LightGBM(L1)
MAPE の1位: LightGBM(L1)
このデータは本文の合成データや実データとは別の小さな例なので、絶対値や順位は本文の結果と一致しません。
まとめ
回帰の評価指標は、数を増やせば判断が自動的に確かになるわけではありません。今回の比較では、モデルから予測できない外れ値がRMSE上の差を消し、ゼロ付近の値はMAPEの順位を変えました。R²は最後までRMSEと同じ順位しか返しませんでした。
手元の比較で指標が割れたら、票を数える前に、外したときに何が高くつくかへ戻って主指標を1つ決めます。R²はその票に加えません。基準予測との比較は学習側だけで作った予測を使い、用途に必要な精度は許容誤差の超過件数も含めて判断します。
なお、RMSEの改善幅はRMSEから作った量なので、食い違いの原因を独立に証明したものではありません。指標に合わせて損失関数を調整した場合や、分位点損失・Huber損失を加えた場合の順位も未検証です。分位点損失やHuber損失を含む損失側の比較は、稀な高値を予測する8条件の検証で、高値側MAEと全体RMSEを対にして測っています。