
不正検知や病気の判定のように、当てたい出来事がデータのごく一部にしかない分類問題があります。こういうデータでは、学習させたモデルの成績が「99%」と出ても、まだ喜べません。全件を「多数派」と答えるだけで、この数字は99%に届くからです。
実際に測ると、そのとおりでした。少数派(当てたい側の、件数が少ないほうのクラス)が全体の1%のデータで、常に多数派だけを答えるダミー分類器を走らせると、正解率(accuracy、全予測のうち当たった割合)は99.00%です。テストに含まれる少数派60件は、1件も当たっていません。
では、正解率の代わりに何を見るか。候補の指標はいくつもありますが、どれが「何もしないモデル」と「学習したモデル」の実力差を映すのかは、同じデータへ並べて突き合わせるのが確実です。そこで少数派の比率を1%・5%・10%の3段階に変え、ダミーとロジスティック回帰・LightGBMを同じデータで比べました。
測って分かったのは、正解率の癖だけではありません。代わりに使う指標の側にも、1回の測定では優劣を決められないところがありました。
先に結論: 不均衡が強いほど、正解率は差を映さなくなる
- 正解率で見えるダミーと学習済みモデルの差は、少数派10%の8.18ポイントから1%の0.46ポイントまで縮む。
- 同じ少数派1%でも、PR-AUC(少数派を上位へ並べられた度合いを表す指標)は0.010対0.752で実力差が残る。
- 少数派を見つけたい問題の主指標には、PR-AUCと少数派recall(本当の少数派を何割拾えたか)を選んだ。見逃し件数や誤検知件数と対応づけて読めるため。指標そのものの優劣を測ってはいない。
- PR-AUCは自分のデータの陽性率(=当てずっぽう水準)と比べて読む。
- 学習したロジスティック回帰でも、少数派1%では20回中2回、テストの少数派60件を全件見逃した(recall 0.000)。指標より先に、何件中何件を当てたのかを数える。
- テストの少数派が60件しかない1%の条件では、少数派recallはシードで大きく振れ、モデル同士の順位も20回中6回逆転した。1回の分割でモデルの優劣は決めない。
- 適用条件: 合成データ2万件の2値分類、少数派1%・5%・10%、不均衡対策を入れない既定設定、シード20回の平均。
この記事の表を読むのに要る言葉
数式は出てきません。ただし、このあとの表は列名が採点用語で埋まります。中身を先に言っておきます。
- 少数派クラス: 当てたい側の、件数が少ないほうのクラス。この記事では全体の1%・5%・10%に振る。データに占めるその比率を陽性率とも呼ぶ。
- 正解率(accuracy): 全予測のうち当たった割合。多数派を当てるだけでも上がる。
- 少数派recall: 本当の少数派のうち何割を拾えたか。取りこぼしの少なさを表す。
- 少数派precision: 少数派だと予測したもののうち、何割が本当に少数派だったか。
- 閾値: モデルは0〜1の確率を出し、既定ではその値が0.5以上なら少数派と判定する。そこで切る値のこと。
- PR-AUC: recallとprecisionの兼ね合いを、閾値の取り方によらず1つの値にまとめた指標。scikit-learnでは
average_precision_scoreで計算する。
ここでもう1つ、表を見る前に押さえておきたいことがあります。当てずっぽうに相当する水準は、指標ごとに違います。 ROC-AUC(少数派を多数派より上位に並べられる度合い)はどんなデータでも0.5ですが、PR-AUCの当てずっぽう水準は陽性率、つまりデータに含まれる少数派の比率そのものです。少数派1%なら0.01付近が出発点になります。この土台を押さえないと、あとの表は読めません。
少数派1%・5%・10%で、ダミーと2つのモデルを同じデータに通した
データはsklearn.datasets.make_classificationで作った合成の2値分類で、2万件です。変えたのは少数派クラスの比率だけで、1%・5%・10%の3段階に振りました。
比べた分類器は3つです。多数派を出すだけのダミー、ロジスティック回帰、LightGBM。いずれも既定設定のままで、class_weightや再サンプリングといった不均衡対策は入れていません。素の挙動で正解率がどう誤解を招くかを見たいからです。
主役に据えた指標は少数派recallとPR-AUCで、正解率をはじめとする補助指標を添えて並べました。1つの条件につき、データ生成のシードを20回変えて平均しています。合成データなので、読むのは絶対値ではなく指標どうしの動きの差です。
生成条件・分割・シードの詳細と、検定を使わずに平均だけで判断してよい範囲は、後半の「詳しい検証条件」にまとめました。
ダミーの正解率は少数派が薄いほど上がり、当てた件数はゼロのまま
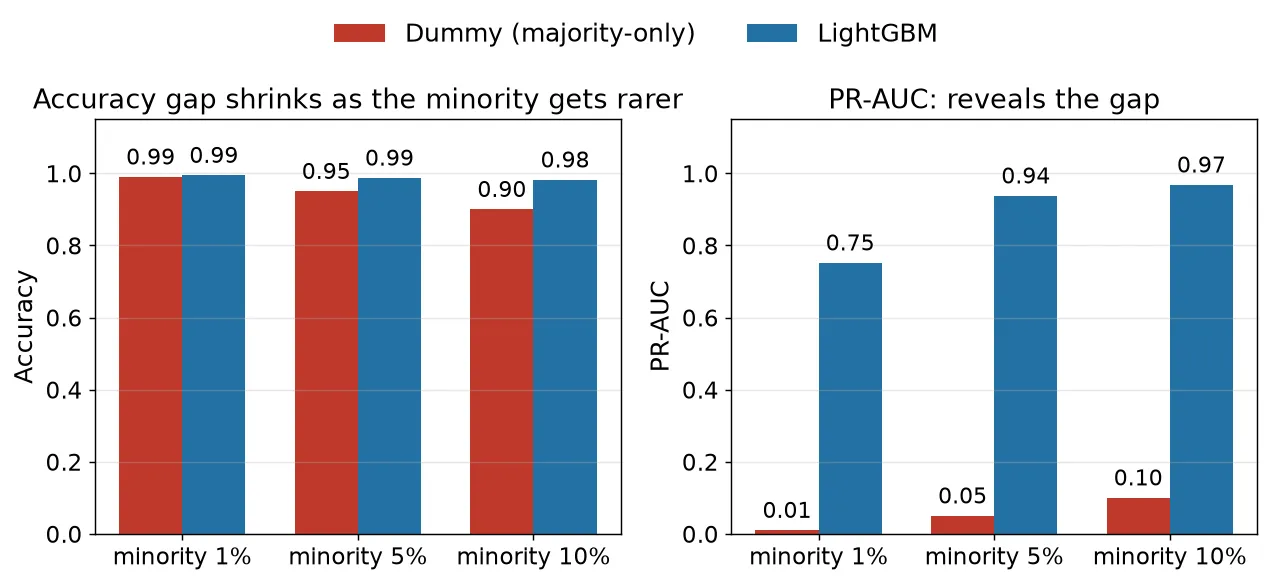
ダミーの正解率は、少数派5%で95.00%、10%で90.00%でした。冒頭で見た1%の99.00%と合わせると、どれも多数派の割合そのままの数字です。少数派recallは3水準とも0.000でした。つまり正解率の高さは、当てたい側を1件も拾えていない状態と平気で両立します。
3分類器の全指標を並べたのが次の表です。補助指標のうちbalanced accuracyは各クラスのrecallを平均した指標で、少数派を無視すると上がりません。少数派F1はrecallとprecisionの調和平均です。
| 少数派比率・モデル | 正解率 | balanced acc | 少数派recall | 少数派precision | 少数派F1 | PR-AUC | ROC-AUC |
|---|---|---|---|---|---|---|---|
| 1%・ダミー | 0.9900 | 0.500 | 0.000 | 0.000 | 0.000 | 0.010 | 0.500 |
| 1%・ロジスティック回帰 | 0.9937 | 0.704 | 0.409 | 0.813 | 0.518 | 0.558 | 0.905 |
| 1%・LightGBM | 0.9946 | 0.746 | 0.492 | 0.925 | 0.625 | 0.752 | 0.982 |
| 5%・ダミー | 0.9500 | 0.500 | 0.000 | 0.000 | 0.000 | 0.050 | 0.500 |
| 5%・ロジスティック回帰 | 0.9710 | 0.741 | 0.485 | 0.852 | 0.593 | 0.674 | 0.916 |
| 5%・LightGBM | 0.9870 | 0.890 | 0.782 | 0.946 | 0.854 | 0.937 | 0.993 |
| 10%・ダミー | 0.9000 | 0.500 | 0.000 | 0.000 | 0.000 | 0.100 | 0.500 |
| 10%・ロジスティック回帰 | 0.9462 | 0.776 | 0.564 | 0.818 | 0.655 | 0.738 | 0.921 |
| 10%・LightGBM | 0.9818 | 0.928 | 0.861 | 0.952 | 0.904 | 0.968 | 0.994 |
まずダミーの行のPR-AUC列を見てください。0.010・0.050・0.100と並んでいます。左端に並ぶ少数派比率(1%・5%・10%)を小数にしただけの値です。偶然ではなく、順位を付けられない分類器のPR-AUCは陽性率に一致するからです。つまりこの列は、その比率でのPR-AUCの当てずっぽう水準をそのまま示しています。
ダミーのbalanced accuracyとROC-AUCはどちらも0.500ですが、理由は別です。balanced accuracyは、多数派recallが1.000、少数派recallが0.000なので、その平均が0.500になります。ROC-AUCが0.500なのは、全件に同じ確率を返して順位が付かないからです。正解率0.99という数字は、この表の中ではむしろ「少数派を無視した」印になっています。
なお、ダミーの少数派precisionとF1が0.000になっているのは、正確には値が定まらないためです。ダミーの結果は3比率×20シードの60通りすべてで、少数派と予測した件数が0件でした(混同行列、つまり実際のクラスと予測したクラスの組み合わせごとに件数を並べた表で、tp + fpが0)。「予測したもののうち何割が本当か」の分母が0で、値が計算できません。scikit-learnのzero_division=0の慣例で0を入れています。「少数派と予測したものが全部外れた」のではなく、一度も予測していないという意味です。
実モデル側で目を引くのはprecisionの高さです。LightGBMは、少数派と予測したもののうち9割以上が正解でした。ただしこれは今回の生成条件が効いています。flip_y=0.0でラベルの反転ノイズを入れず、クラスの塊も1つずつ(n_clusters_per_class=1)にしているので、境界の外で誤検知が起きにくい設定です。1%のLightGBMの誤検知は、6,000件のテストで平均2.05件しかありません。ラベルの付け間違いやクラスの重なりがある実データで、既定の閾値のままこのprecisionが出ると期待しないでください。
それでも、この条件で観察できることはあります。9割以上を当てながら、少数派recallは0.492にとどまっている点です。足りないのは精度ではなく、拾えている件数のほうです。
正解率の差は不均衡が強いほど縮む一方、PR-AUCでは差が残る
少数派が薄くなるほど、正解率はダミーと実モデルの区別に使えなくなります。実務で言えば、少数派が1%まで薄いデータでは、正解率の差だけでは学習済みモデルとダミーすら見分けにくいということです。
| 少数派比率 | ダミーの正解率 | LightGBMの正解率 | 正解率の差(%ポイント) | PR-AUCの差 |
|---|---|---|---|---|
| 1% | 0.9900 | 0.9946 | +0.46 | +0.742 |
| 5% | 0.9500 | 0.9870 | +3.70 | +0.887 |
| 10% | 0.9000 | 0.9818 | +8.18 | +0.868 |
少数派1%での正解率の差は、わずか0.46ポイントでした。片方は少数派の半分近く(recall 0.492)を拾えるLightGBM、もう片方は1件も拾えないダミーです。少数派が薄いほど、どちらも「多数派と答える」割合が支配的になります。正解率は多数派の割合に張り付き、動く幅がごく小さくなります。 一方でPR-AUCの差は、どの比率でも+0.74以上を保ちました。
ただし、この表のPR-AUCの差を比率どうしで比べて「1%が最も開いた」と読むことはできません。基準線の高さが違う3つの物差しなので、比較できるのは同じ比率の中での差だけです。逆に言えば、その差だけで主張は足ります。どの比率でも実モデルは当てずっぽうの水準から大きく離れていて、たとえば少数派1%のLightGBMは、ダミーの75倍のPR-AUCに達しています。
なぜ正解率で消えた差が、PR-AUCとrecallでは残るのか。少数派recallは、本当の少数派をどれだけ拾えたかだけを直接測ります。多数派を何件正しく捨てても値は上がりません。PR-AUCはこれにprecisionを加え、少数派を拾いながら誤検知をどれだけ抑えられたかも反映します。どちらも、正しく捨てた多数派の件数(混同行列でいう真陰性)を勘定に入れません。 正解率のように多数派の正解で薄まらないぶん、不均衡が強い場面ほど、正解率で見えるものとPR-AUCで見えるものは食い違います。
学習したロジスティック回帰も、少数派1%では20回中2回、全件を見逃した
少数派1%では、ロジスティック回帰も正解率ではダミーとほとんど変わらない一方、PR-AUCと少数派recallでは上に出ました。ただし、そのロジスティック回帰は20シード中2回(seed 45と53)で少数派recallがちょうど0.000でした。 ダミーと同じく、60件を1件も拾えていません。この2回の正解率は0.989833と0.990000で、ダミーの0.9900を下回るか、同じです。学習したモデルでも、1%では取りこぼしが支配的になり得ます。
LightGBMとの優劣は、指標によって読み方が変わります。PR-AUCは20シード中18回でLightGBMが上(1%の平均で0.558対0.752、シード対応の差の平均+0.194)なので、優位と言ってよさそうです。一方で少数派recallとbalanced accuracyは20シード中6回で順位が逆転します。
1%のrecallは、ロジスティック回帰が平均0.409(標準偏差0.261)でした。LightGBMは平均0.492(標準偏差0.186)です。20シードでの範囲は前者が0.000〜0.817、後者が0.133〜0.783でした。テストの少数派は60件しかないので、標準偏差0.186は件数にすると±11件ぶんです。この幅では、recallでどちらが上かを決められません。1回の分割で出たrecallは、モデルの実力とその分割の当たり外れが混ざった値だからです。
シード42の1回分: 見逃し60件と24件の差が、正解率では0.58ポイント
20回の平均ではなく、少数派1%のシード42の1回分(下のサンプル実装と同じ実行)を取り出します。テストは6,000件、そのうち少数派は60件でした。ダミーは正解率99.00%で、少数派60件を全て見逃しました。LightGBMは正解率99.58%で、60件中36件を正解、見逃しは24件でした(誤検知は1件)。
この回のLightGBMはrecall 0.600で、20回平均の0.492より良い側にあたります。持ち帰るなら平均のほうです。 20シードでLightGBMが当てた件数は8件から47件まで動き、平均は29.5件でした(PR-AUCも0.397から0.926まで振れています)。下のサンプル実装のシードを変えると、60件中8件しか拾えない回にも当たります。
それでも正解率の差は0.58ポイントしかつきません。中身は、当てたい60件を1件も拾えないモデルと、36件を拾えるモデルの違いです。不正検知や病気の判定なら、この36件を見つけられるかどうかが損失に直結し得ます。正解率だけを眺めていると、この差はほぼ見えません。
手元のモデルを評価するときの順番
ここまでの結果を、実際に評価するときの手順に直します。
- 最初に見るのは、混同行列の実数。 テストに含まれる少数派が何件で、そのうち何件を拾えたかを数えます。今回のシード42の例なら「60件中36件、見逃し24件」で、0.9958という正解率よりずっと状況が伝わります。分母の小ささは、このあとの指標全部の読み方を左右します。60件なら、recallが0.1動いても中身は6件の増減です。
- 見逃しが痛い問題なら、主指標は少数派recallに置き、precisionを併記します。 recallを上げれば誤検知が増える方向に効くのが一般的ですが、その兼ね合いは今回の測定範囲の外です。両方をまとめて順位の質として見るなら、PR曲線・PR-AUCを使います。
- PR-AUCの良し悪しは、前に見た基準線と比べて判断します。 基準線は自分のデータの陽性率です。PR-AUC 0.08は、陽性率5%のデータなら0.05をほとんど超えておらず、当てずっぽうと大差ありません。陽性率が0.5%まで下がれば基準線は0.005なので、同じ0.08でも当てずっぽうより明確に上だと言えます。ただし、この比較で分かるのはそこまでで、実用に足りるかは別の判断です。
- 閾値の調整中はPR-AUC、固定後にbalanced accuracyとクラスごとのrecall。 この2つは交換可能ではありません。balanced accuracyは閾値0.5で判定した結果の成績、PR-AUCは閾値によらない順位の質だからです。閾値を動かしながらbalanced accuracyを主指標にすると、モデルが変わったのか閾値が変わったのかを切り分けられなくなります。
- モデル同士を比べるなら、シードを変えて複数回測ってから決めます。 今回の1%のrecallのように、シードを変えると順位が入れ替わる指標があります。1回の分割では決めず、分割やシードを変えて複数回測り、勝敗の内訳とばらつきを見てから選びます。
手順4で使うbalanced accuracyには、注意が1つあります。各クラスのrecallの平均なので多数派を当てるだけでは上がりませんが、値だけでは中身が決まりません。0.5は、今回のダミーのように多数派recall 1・少数派recall 0でも出ます。
そして、最終的に閾値をどこへ置くかを決めるのは指標ではなく、業務側のコストです。見逃し1件と誤検知1件のどちらがどれだけ重いかは、指標の値からは出てきません。
ROC-AUCについて一言添えます。今回の測定では、ROC-AUCもダミー0.500対LightGBM0.982(1%)と差を映していました。上で主指標に挙げなかったのは、この実験でROC-AUCが劣ったからではありません。 見逃し件数や誤検知件数と対応づけて読める指標を選んだ結果で、指標そのものの優劣を測った比較はしていません。手元の表でROC-AUCも高く出ていたなら、それはこの実験の結果と矛盾しません。
詳しい検証条件
データはsklearn.datasets.make_classificationで作った合成の2値分類です。1件あたり20個の特徴量を持ち、そのうち8個が本当に効く情報という設定で、2万件を生成しました。外部データの取得は要らず、同じ条件を手元でそのまま再現できます。
変えたのは少数派クラスの比率だけです。1%・5%・10%の3段階に振り、データの見分けやすさ(class_sep)や情報のある特徴量の数は全段階で固定しました。
分類器は、多数派を出すだけのダミー(DummyClassifier(strategy="most_frequent"))、ロジスティック回帰、LightGBMの3つです。いずれも既定設定のままで、不均衡対策は入れていません。データは学習70%・テスト30%に分割しました(層化分割: 少数派の比率が学習側とテスト側で同じになるように分けます)。
数値はすべて、実際に実行して保存したログを集計したものです。1回の測定はデータ生成のシード1つぶんで、42から61までの20回を(比率×分類器)ごとに平均しました。検定や信頼区間は使っていません。この省略が成り立つのは、ダミーと実モデルの比較に限ります。 ダミー対LightGBMは3つの比率・20シードのすべてで実モデルが上で、差が最も小さいシードでも正解率は+0.083ポイント、PR-AUCは+0.386ありました。向きが逆転する回が1つもないので、平均をそのまま読んでも判断は変わりません。
一方、ロジスティック回帰とLightGBMのようなモデル同士の順位には、この根拠は使えません。 少数派1%のrecallは20シード中6回で順位が逆転します。モデル間の比較を書いた箇所には、シードごとの勝敗とばらつきを添えました。
読み飛ばし可: 再現用のパラメータ
- 生成条件:
n_samples=20000,n_features=20,n_informative=8,n_redundant=2,n_clusters_per_class=1,class_sep=0.8,flip_y=0.0。少数派比率はweights=[1-p, p]で指定(p=0.01, 0.05, 0.10)。 - 分割:
train_test_split(test_size=0.3, stratify=y, random_state=seed)。 - 分類器: ダミーは
most_frequent、ロジスティック回帰はmax_iter=1000、LightGBMはn_jobs=4の既定。random_stateはシードに合わせます。 - PR-AUCとROC-AUCは少数派クラスの予測確率で計算。ダミーは全サンプルで同じ確率を返すため、ROC-AUCは0.5、PR-AUCは陽性率と一致します。
適用範囲と限界
- 適用範囲: 少数派が1〜10%の2値分類で、素の既定設定の挙動を見た結果です。
- 動かしたのはクラス比率だけで、データの難しさは1通りしか測っていません(
class_sep=0.8・flip_y=0.0・n_clusters_per_class=1)。ラベルの反転ノイズがなく、クラスの塊も1つずつという条件です。難易度を変えたときに指標の効き方がどう動くかは、この記事の範囲では分かりません。特にprecisionの高さは、この設定に強く依存します。 - 不均衡対策(
class_weight・SMOTE・閾値調整)を入れたあとの姿は測っていません。recallを上げる方向の処理を入れればprecisionとの釣り合いも変わりますが、その比較はここには含まれていません。 - 実データ特有のノイズや分布のゆがみも入っていません。合成データの絶対値をそのまま手元のデータへ持ち出すことはできません。
- 多クラス分類や、少数派が1%より薄い極端な不均衡は測っていません。傾向はさらに強まると予想されますが、これは外挿であって実測ではありません。
サンプル実装: ダミーとLightGBMを同じデータで比べる
少数派を1%にした合成データで、多数派を出すだけのダミーとLightGBMを同じデータに通し、正解率・balanced accuracy・少数派recall・PR-AUC・見逃し件数を並べて表示します。make_classificationで作るので取得は不要で、そのまま動きます。make_classificationの行を手元のデータ(特徴量X・ラベルy)に差し替えれば、同じ比較ができます。そのとき、ラベルは0が多数派・1が少数派であることが前提です。 ラベルが{1, 2}のような値だと、少数派の確率を取り出す行が多数派側を指してしまい、PR-AUCが黙って別のものを測ります。差し替える前に0と1へ振り直してください。出力はシード42の1回分なので、上の表の20回平均とは値がずれます。
"""不均衡データで accuracy が何を見落とすかを、ダミーと実モデルで比べるデモ。"""
from sklearn.datasets import make_classification
from sklearn.dummy import DummyClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import (
    accuracy_score,
    balanced_accuracy_score,
    recall_score,
    average_precision_score,
    confusion_matrix,
)
from lightgbm import LGBMClassifier

# 少数派を全体の1%にした不均衡データ(合成なので取得不要)
X, y = make_classification(
    n_samples=20000, n_features=20, n_informative=8, n_redundant=2,
    n_clusters_per_class=1, weights=[0.99, 0.01], class_sep=0.8,
    flip_y=0.0, random_state=42,
)
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=42
)

# 多数派を出すだけのダミーと、実モデル(LightGBM)を同じデータで比べる
models = {
    "ダミー(多数派)": DummyClassifier(strategy="most_frequent"),
    "LightGBM": LGBMClassifier(random_state=42, n_jobs=4, verbosity=-1),
}
for name, model in models.items():
    model.fit(X_tr, y_tr)
    pred = model.predict(X_te)
    # 少数派(クラス1)の予測確率。PR-AUC はこのスコアで測る
    pos = list(model.classes_).index(1)
    proba = model.predict_proba(X_te)[:, pos]
    tn, fp, fn, tp = confusion_matrix(y_te, pred, labels=[0, 1]).ravel()
    print(f"[{name}]")
    print(f"  正解率(accuracy)  : {accuracy_score(y_te, pred):.4f}")
    print(f"  balanced accuracy : {balanced_accuracy_score(y_te, pred):.4f}")
    print(f"  少数派 recall     : {recall_score(y_te, pred, pos_label=1, zero_division=0):.4f}")
    print(f"  PR-AUC            : {average_precision_score(y_te == 1, proba):.4f}")
print(f" 少数派 {tp + fn}件中 {tp}件正解 / {fn}件見逃し")上のコードをaccuracy_trap.pyとして保存し、必要なライブラリを入れて実行します。
pip install scikit-learn lightgbm
python accuracy_trap.py
実行結果(この環境での出力例)
[ダミー(多数派)]
  正解率(accuracy)  : 0.9900
  balanced accuracy : 0.5000
  少数派 recall     : 0.0000
  PR-AUC            : 0.0100
  少数派 60件中 0件正解 / 60件見逃し
[LightGBM]
  正解率(accuracy)  : 0.9958
  balanced accuracy : 0.7999
  少数派 recall     : 0.6000
  PR-AUC            : 0.8523
  少数派 60件中 36件正解 / 24件見逃し
まとめ
不均衡が強くなるほど、正解率の物差しはダミーと実モデルの差を映さなくなりました。少数派10%では8ポイント台あった正解率の差が、1%では0.5ポイントを切ります。それでもPR-AUCと少数派recallの差は残り、この向きは3つの比率・20回の測定で一貫していました。逆に、モデル同士の細かい優劣までは、この実験では決められません。1%の少数派recallはシードごとに大きく振れ、ロジスティック回帰とLightGBMの順位も入れ替わるためです。ダミーとの比較は平均だけで判断できましたが、実モデル同士を比べる段では、ばらつきと勝敗の内訳まで確かめる必要があります。
指標の選び方まで進んだら、次は手当ての効果です。class_weightや再サンプリングを入れたときにPR-AUCとrecallがどこまで動くかは、不均衡データの4つの対策を実測で比較した記事で測っています。ただし、生成条件が違うので数値はそのまま並べられません。本記事は2万件・n_informative=8・class_sep=0.8の70/30分割で1%のLightGBMがPR-AUC 0.752、あちらは5,000件・n_informative=10・class_sepは既定の5分割交差検証で1%の無処置がPR-AUC 0.558です。読み比べるのは絶対値ではなく、対策を入れる前後で何がどちらへ動いたかのほうです。