
モデルの学習が終わり、予測結果を確認したとします。全体ではよく当たっていても、見つけたい対象をどれだけ拾えているかを見ると、見逃しが多いことがあります。そこで見直せるのが、モデルの予測確率を「該当する・しない」の2択へ変える境目です。この境目をしきい値(閾値)と呼びます。
予測確率から2択に分ける分類では、0.5が標準的な境目です。ただ、0.5で区切った結果が、見逃しを減らしたい目的にも合うとは限りません。境目を下げれば該当すると予測する件数が増えるので、拾える対象と、誤って拾う対象の両方を確認する必要があります。予測確率と分類結果を分けて考える方法は、scikit-learnの公式解説でも扱われています。
この比較では、見つけたい少数派の割合を5〜50%に変え、ロジスティック回帰とLightGBMでしきい値を調整しました。主に比べたのは、見逃しと誤検知の両面をまとめたF1という点数です。不均衡が強い条件ほど改善幅が大きかった一方、同じ割合でもモデルによって差がありました。さらに、しきい値を選ぶデータを間違えると、成績だけが良く見えることも確かめています。
先に結論
- 少数派5%の合成データでは、ロジスティック回帰のテストF1が0.140改善。少数派50%では改善幅が小さく、LightGBMでは改善を確認できなかった。
- しきい値の調整で見逃しが減っても、誤検知は増えうる。F1を高くする選び方と、見逃しの損失を重く見る選び方では、選ぶしきい値も結果も変わった。
- しきい値を選ぶデータと、最後に成績を測るテストデータは分ける。 同じテストデータで選択と評価をすると、未使用のデータに対する性能としては過大評価になる。
しきい値を変えた後は、見逃しと誤検知を分けて確認する
見つけたい側を「陽性」、それ以外を「陰性」と呼びます。ここでは少数派を陽性にしました。陽性なのに陰性と予測するのが見逃し、陰性なのに陽性と予測するのが誤検知です。実験では、予測確率がしきい値以上なら陽性、それより小さければ陰性と判定しています。
陽性と予測したもののうち、実際にも陽性だった割合が適合率(precision)です。高いほど、陽性という予測の空振りが少ないと分かります。それに対して、実際に陽性だったものをどれだけ拾えたかを表すのが再現率(recall)で、低いほど見逃しが多く残っています。どちらも0〜1の値を取り、割合として読みます。
この2つを、小さい側の値の影響が強く出る平均でまとめたのがF1です。この平均を調和平均といいます。F1も0〜1で、高いほど適合率と再現率を両立できています。ただし、見逃し1件と誤検知1件の損失を指定する指標ではありません。実務の損失が分かるなら、その重さを直接反映する基準も候補になります。
陽性を拾えた割合と、陰性を正しく陰性とした割合を半分ずつ平均した値も併記しました。これはバランス精度(balanced accuracy)で、件数の多い側だけを当てて高得点になるのを避けられます。
しきい値の選び方は、次の3通りです。いずれも検証データの正解と予測確率を使い、候補となる境目ごとの成績を比べました。
- F1最大:適合率と再現率をまとめた点数が最も高くなるしきい値を選びます。
- 陽性側と陰性側を同じ重さで評価:陽性を拾う割合から、陰性を誤って陽性とする割合を引いた差を最大にします。この差をYouden’s Jと呼び、バランス精度の最大化と同じ位置を選ぶ基準です。
- コスト最小:見逃し件数と誤検知件数に、それぞれの損失の重さを掛けて足し、最小になるしきい値を選びます。今回は見逃し1件を誤検知1件の5倍として計算しました。
学習・しきい値の選択・最終評価に使うデータを分けた
実験には、scikit-learnの make_classification で作った合成データを使いました。1回あたり5,000件、入力となる特徴量は20個で、少数派の割合を5%・10%・25%・50%の4水準に設定しています。実データは使っていません。
比較したのは、特徴量を重み付けして足し合わせた値から確率を求めるロジスティック回帰と、条件分岐を重ねた決定木を順に追加して学習するLightGBMです。ロジスティック回帰では、学習データで求めた平均と標準偏差を使って特徴量の尺度を揃えました。モデル設定やデータ生成の細部は、後半の「詳しい検証条件」にまとめています。
データは、陽性と陰性の割合をおおむね保ちながら3つに分けました。この分け方を層化分割と呼びます。学習用に50%、しきい値を選ぶ検証用に25%、最後の評価用に25%を割り当て、同じ学習済みモデルの予測確率に対して、判定の境目だけを変えて比較しました。
以下の表の成績は、データ生成と分割の乱数の設定(シード)を変えた20回の平均です。各回で検証データからしきい値を選び、その回のテストデータで0.5の場合との差を測っています。
少数派5〜25%ではF1が改善し、同じ割合でもモデルによって差があった
最初に、検証データでF1が最大になるしきい値を選んだ場合と、0.5で固定した場合を比べます。表の数値はテストF1の差で、プラスなら調整後のほうが高かったことを表します。割合の増加率ではなく、0〜1の点数同士を引いた値です。
| データ(少数派) | ロジスティック回帰 | LightGBM |
|---|---|---|
| 5% | +0.140 [+0.102, +0.180] | +0.084 [+0.059, +0.110] |
| 10% | +0.080 [+0.048, +0.114] | +0.039 [+0.028, +0.050] |
| 25% | +0.050 [+0.034, +0.068] | +0.008 [+0.005, +0.011] |
| 50% | +0.008 [+0.002, +0.013] | -0.000 [-0.002, +0.001] |
角括弧は、20回分の結果から推定した平均改善量の幅(95%信頼区間)です。計算方法は後半の補足に分けました。LightGBMの少数派50%ではこの幅に0が含まれ、改善を確認できませんでした。「調整しても必ず同じ結果になる」と確かめたわけではありません。
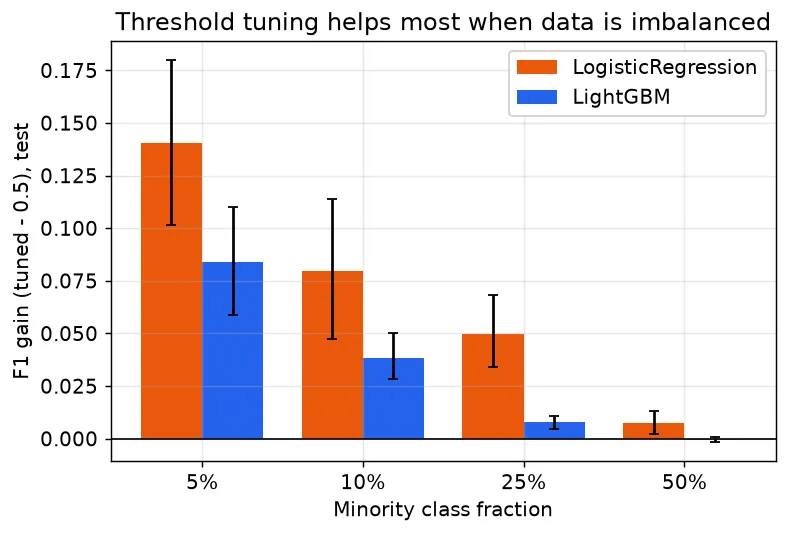
両モデルとも、少数派の割合が小さい条件ほど改善幅が大きくなりました。ただ、少数派25%でも、ロジスティック回帰とLightGBMでは改善幅が大きく異なります。少数派の割合は調整を試す手がかりになりますが、それだけで改善量は決まりません。
モデルの違いを考える補助として、陽性の予測確率が陰性より高くなるように並べられているかを表すROC-AUCも測りました。高いほど順位付けが良く、以下ではAUCと略します。少数派10%ではLightGBMが0.949、ロジスティック回帰が0.849で、ほかの水準でもLightGBMのほうが高い値でした。
順位付けの良さが改善幅の違いに関係した可能性はあります。ただし、出力された確率が実際の陽性割合とどれだけ合うかは評価しておらず、AUCの差だけから原因を特定することはできません。
少数派10%のLightGBMでは、再現率の改善とともに適合率が下がった
F1の改善だけでは、見逃しと誤検知のどちらが変わったのか分かりません。少数派10%のLightGBMで、3つの選択基準と0.5固定を比較すると、次のようになりました。
| しきい値 | F1 | 適合率 | 再現率 | バランス精度 |
|---|---|---|---|---|
| 0.5(既定) | 0.719 | 0.903 | 0.602 | 0.797 |
| F1最大(約0.21) | 0.758 | 0.819 | 0.712 | 0.846 |
| Youden’s J(約0.02) | 0.680 | 0.564 | 0.867 | 0.893 |
| コスト最小(約0.04) | 0.730 | 0.655 | 0.832 | 0.889 |
表の「約0.21」などは、各回で選んだしきい値の平均です。この平均値を全データに一律適用して測った成績ではありません。
F1最大のしきい値では、実際の陽性を拾えた割合が約6割から約7割へ増えました。一方、陽性という予測が当たった割合は下がっています。F1が上がっても、増えた誤検知への対応が負担になるなら、そのしきい値が運用に合うとは限りません。
Youden’s J最大では、再現率とバランス精度が4条件で最も高くなりましたが、適合率の低下が大きく、F1は0.5固定より低い値でした。コスト最小もF1最大より再現率を高くする側の結果です。見逃しを重く見る場合は、実際の損失に合う重みを決めて比較する必要があります。
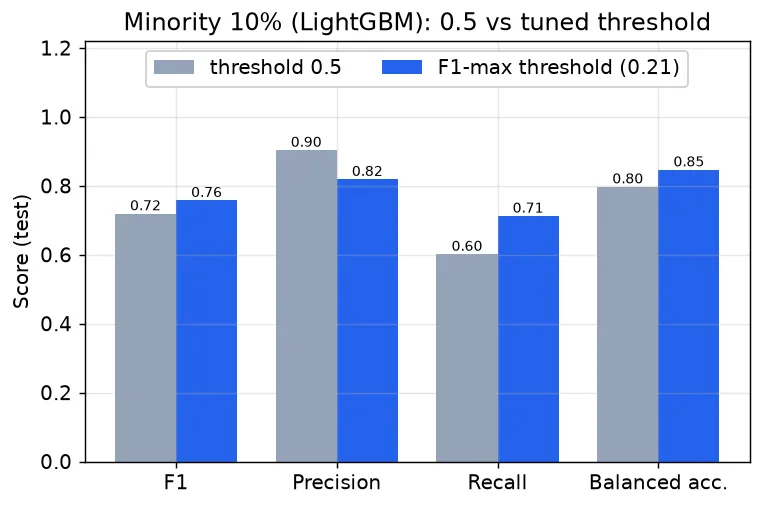
この比較では、AUCはどの選び方でも0.949です。同じ予測確率を使っているため、しきい値を変えてもデータの並び順は変わりません。AUCだけを確認していては、見逃しと誤検知の変化を把握できないのはこのためです。
ロジスティック回帰では、調整後も陽性の約4割を見逃した
同じ少数派10%のロジスティック回帰では、0.5固定の適合率は0.740でしたが、再現率は0.331にとどまりました。陽性という予測は比較的よく当たる一方、実際の陽性を3分の1ほどしか拾えていなかったことになります。これも20回の平均です。
検証データでF1最大のしきい値を選ぶと、しきい値の平均は約0.25となり、再現率は0.563、F1は0.447から0.527へ上がりました。それでも陽性の4割強は見逃したままです。F1の改善を確認した後も、残る見逃しの量を確かめる必要があります。
少数派50%のLightGBMでは、F1の改善を確認できなかった
陽性と陰性が半々の条件では、LightGBMのF1最大しきい値の平均は約0.447でした。テストF1は0.9282から0.9279で、0.5固定を上回る改善は確認できませんでした。ロジスティック回帰には+0.008の改善があり、「均衡データなら調整は不要」と一律には言えません。
しきい値ごとのF1の変化を見ると、0.5の近くにどれだけ改善の余地があるかを確認できます。図3は、LightGBMの1回分の検証データで描いた曲線です。表にある20回のテスト平均とは区別してください。
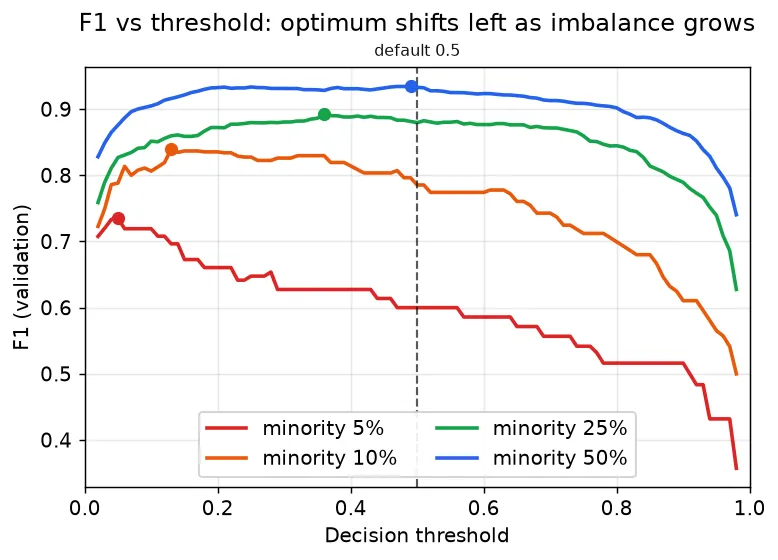
この回では、少数派50%の曲線は0.5付近で平らで、少数派5%は0.05付近が最も高くなりました。確認したいのは、最大になる位置だけでなく、0.5との差がどれだけあるかです。しきい値の数値が離れていることだけで、調整の価値は判断できません。
テストデータでしきい値を選ぶと、F1を過大評価した
しきい値をテストデータで直接選んだ場合も、比較用に測りました。少数派10%のLightGBMでは、検証データで選んだ場合のテストF1は0.758でしたが、テストデータ上でF1を最大にするしきい値を選ぶと0.777になりました。
この約0.02の差には、テストデータに含まれる偶然の偏りに合わせてしきい値を選んだ影響が含まれます。後者は選択にも使ったデータでの成績なので、新しいデータで得られる改善量とは扱えません。なお、この差は今回の生成条件・分割・20回平均での結果です。データ量が違う場合や別のデータで同程度になるとは限りません。
モデルの学習を終えていても、しきい値を選ぶ作業では正解データを使います。最後の評価まで未使用にするテストデータを、この選択に使わないことが、性能を過大評価しないための条件です。
自分のデータでしきい値を調整する手順
-
少数派の割合と、0.5での成績の確認
陽性がどれくらい少ないかを確認し、検証データでの適合率と再現率から誤検知・見逃しの現状を把握します。不均衡が強いときは調整を試す候補になりますが、同じ割合でも改善幅はモデルによって変わりました。再現率だけで調整の是非を決めることもできません。
-
許容できる誤りに合った基準の選択
適合率と再現率をまとめた点数で比べるならF1、陽性側と陰性側を同じ重さで評価するならYouden’s Jを候補にします。見逃しと誤検知の損失に差があるなら、コスト基準で比較します。今回は見逃しを5倍としましたが、その重みを自分の運用へそのまま移す必要はありません。
まず調整の手順自体を試す場合は、サンプル実装のF1最大化で0.5固定との差を確認できます。運用に採用する基準は、許容する見逃しと誤検知に合わせて決めます。
-
検証データでのしきい値決定
モデルの学習に使わなかった検証データで予測確率を求め、決めた基準が最も良くなるしきい値を選びます。本文の平均しきい値をコピーするのではなく、自分のデータで選び直します。
-
未使用のテストデータでの比較
0.5固定と選んだしきい値を比較し、目的の指標が改善したか、見逃しや誤検知が許容範囲かを確認します。この結果を見てしきい値を再調整すると、そのテストは未使用の評価データではなくなります。
サンプル実装
検証データでF1最大のしきい値を選び、テストで0.5固定と比べる最小の実装です。コード内では学習用をtrain、検証用をval、最終評価用をtestと表記しています。Xは特徴量、yは正解ラベルで、陽性が1、陰性が0に対応します。stratify=yは分割前後の陽性割合を保つための指定です。
predict_probaは各クラスの予測確率を返し、[:, 1]で陽性の確率を取り出します。検証用の p_val から候補ごとの適合率・再現率としきい値を precision_recall_curve で求め、F1が最大になる候補を選びます。テスト用の p_te は、そのしきい値を評価する段階で使います。
サンプルは本体実験とデータ生成の設定が一部異なります。本体では n_redundant=4・class_sep=0.9 を指定していますが、サンプルでは指定していません。表や図の数値をそのまま出すコードではなく、選択と評価を分ける手順を確かめるためのものです。
# 検証データでF1最大しきい値を選び、テストで0.5と比較する
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.metrics import (precision_recall_curve, f1_score,
                             precision_score, recall_score, balanced_accuracy_score)
from lightgbm import LGBMClassifier

# 少数派10%の不均衡データ(weightsで割合を変えられる)
X, y = make_classification(n_samples=5000, n_features=20, n_informative=8,
                           weights=[0.9, 0.1], random_state=42)

# train / val / test に層化分割(valでしきい値を決め、testで評価)
X_tr, X_tmp, y_tr, y_tmp = train_test_split(X, y, test_size=0.5,
                                            stratify=y, random_state=42)
X_val, X_te, y_val, y_te = train_test_split(X_tmp, y_tmp, test_size=0.5,
                                            stratify=y_tmp, random_state=42)

clf = LGBMClassifier(n_jobs=1, random_state=0, verbose=-1)
clf.fit(X_tr, y_tr)
p_val = clf.predict_proba(X_val)[:, 1]
p_te = clf.predict_proba(X_te)[:, 1]

# valの予測確率でF1最大しきい値を選ぶ(ここがリーク回避の要)
prec, rec, thr = precision_recall_curve(y_val, p_val)
f1 = np.divide(2 * prec[:-1] * rec[:-1], prec[:-1] + rec[:-1],
               out=np.zeros(len(thr)), where=(prec[:-1] + rec[:-1]) > 0)
t_best = thr[int(np.argmax(f1))]

# testで0.5と調整後を比較
def report(name, t):
    yhat = (p_te >= t).astype(int)
    print(f"{name}(t={t:.3f}): F1={f1_score(y_te, yhat):.3f} "
          f"適合率={precision_score(y_te, yhat):.3f} "
          f"再現率={recall_score(y_te, yhat):.3f} "
          f"バランス精度={balanced_accuracy_score(y_te, yhat):.3f}")

report("既定0.5", 0.5)
report("F1最大", t_best)precとrecの末尾には、対応するしきい値を持たない値が1組追加されるため、[:-1]で除いて長さを揃えています。np.divideの指定は、適合率と再現率がともに0のときのゼロ除算を避けるためです。
サンプルの実行結果と、本体実験との違い
既定0.5(t=0.500): F1=0.800 適合率=0.967 再現率=0.682 バランス精度=0.840
F1最大(t=0.318): F1=0.796 適合率=0.928 再現率=0.698 バランス精度=0.846
この分割では再現率が上がった一方、F1はわずかに下がりました。サンプルは本体実験よりクラスを分けやすい生成設定で、0.5固定でも適合率が高く出ています。データの設定と分割の両方が異なるため、本文の平均改善量と直接比較して原因を一つに絞ることはできません。
検証データで最良だったしきい値が、テストでも必ず0.5を上回るわけではありません。本体では生成と分割を20回変えて平均を確認しましたが、自分のデータでも調整後の成績を未使用のデータで測る必要があります。
自分のデータに差し替える場合も、陽性と陰性のラベルを確認し、しきい値の選択には検証用の予測だけを使います。このサンプルのランダム分割が適さない時系列データなどでは、分割方法も用途に合わせて変更してください。
適用範囲と限界
- 少数派5〜50%の合成2値分類で見た傾向です。実データ、5%未満の極端な不均衡、多クラス分類での改善量は測っていません。設定した少数派割合はデータ生成時の指定で、正解ラベルを一部ランダムに割り当て直す処理(
flip_y=0.01)も含むため、実際の割合とはわずかにずれることがあります。 - 同じ陽性割合でも、モデルの順位付けや出力確率によって効果は変わります。「陽性が1割未満なら必ず改善する」といった境界は、この実験からは決められません。
- コスト基準は、見逃しを誤検知の5倍とした1設定だけです。ほかの重みでの最適なしきい値は比較していません。
- 予測確率を実際の陽性割合に近づける確率の較正や、クラス重み・再サンプリングによる不均衡対策との併用は測っていません。これらを加えた場合の改善幅を、今回の結果からは判断できません。
詳しい検証条件
データ生成には make_classification を使い、n_samples=5000・n_features=20・n_informative=8・n_redundant=4・n_clusters_per_class=2・flip_y=0.01・class_sep=0.9 としました。少数派割合は weights で指定し、生成と分割には42〜61の20シードを使っています。
ロジスティック回帰は学習データで StandardScaler を適合させ、同じ変換を検証・テストデータへ適用しました。LogisticRegression(max_iter=1000, random_state=0) と LGBMClassifier(n_jobs=1, random_state=0, verbose=-1) を使い、ハイパーパラメータの探索はしていません。
当初は8,000件・30シードで設計していましたが、実行環境のCPU負荷により5,000件・20シードへ変更し、LightGBMは単一スレッドで実行しました。少数派の水準・評価指標・しきい値の選び方は変更していません。
しきい値の探索と、平均改善量の推定方法
- F1最大しきい値は
precision_recall_curve、Youden’s J最大とコスト最小はroc_curveから候補を求め、検証データ上で選びました。ROCは、しきい値ごとの「陽性を拾う割合」と「陰性を誤って陽性とする割合」の関係を表します。AUCはその曲線の下の面積です。 - 信頼区間は、各シードでのF1の差(調整後 − 0.5固定)20個を重複を許して取り出し直し、その平均を10,000回計算するパーセンタイル・ブートストラップで求めました。中央95%の範囲を示し、乱数の設定は0です。これはデータ生成・分割を変えたときの平均改善量の不確実性で、次の1回の成績が入る範囲ではありません。
- 図3だけはseed=42の検証データを使い、しきい値0.02〜0.98を0.01刻みで調べた曲線です。図中の点はその範囲でF1が最大になった位置を示します。
- テストでしきい値を選んだ比較用の値は、テストの予測確率と正解を使って直接F1を最大化して算出しました。未使用データでの性能として報告するための値ではありません。
まとめ
調整後のしきい値を採用するかは、F1の改善だけで決めず、残る見逃しと増える誤検知が許容できるかで判断します。0.5固定との比較結果に適合率と再現率も残しておけば、何を改善し、何を許容する変更なのかを説明できます。
全体の正解率だけでは不均衡データの成績を判断しにくい理由は、正解率と少数派の見逃しを比較した記事でも扱っています。