
学習済みモデルはファイルへ保存して、本番環境で読み込んで使います。Pythonでよく使われるのは、オブジェクトをそのままファイル化するpickleと、同じことをscikit-learn向けに扱いやすくしたjoblibです。運用を続けていれば、いつかscikit-learn自体を新しくする日が来ます。
このときまず心配になるのは、古いファイルが開けなくなることだと思います。実際にscikit-learnは、異なるバージョンで保存したモデルの読み込みを保証していません(Model persistence)。ただしこの注意書きだけでは、ファイルが開けないのか、警告が出るだけなのか、予測結果まで変わるのかは分かりません。
厄介なのは3つ目です。読み込みに失敗すればエラーで気づけますが、読み込めたうえで予測がわずかに動いた場合、例外はどこにも出ません。確率が小数第7位で変わっただけでも、0.5を境に合否を決めている処理なら、結論が入れ替わる行が出ます。
そこでscikit-learn 1.5.2で学習した2つのモデルを1.9.0で読み込み、pickle・joblib・skops・ONNXの4形式で何がどこまで変わるのかを測りました。
先に結論
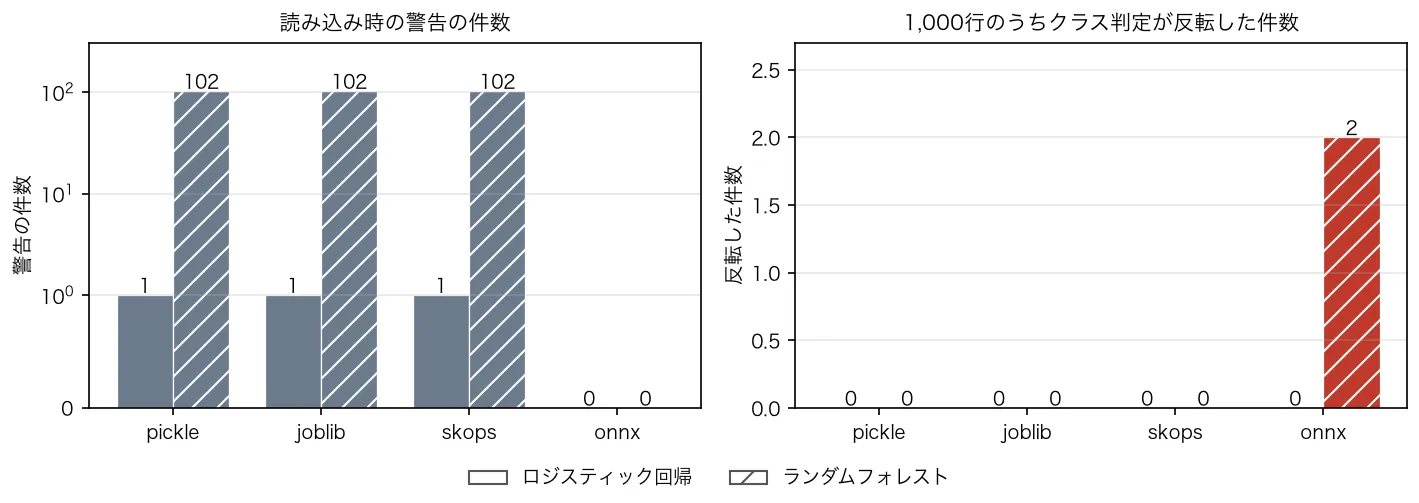
- 1.5.2から1.9.0へ移した8通りはすべて読み込みに成功。pickle・joblib・skopsは予測確率の差が0.0で、保存時と違うバージョンで読んだと知らせる警告(
InconsistentVersionWarning)も出た - ONNXだけは警告が出ないまま、ランダムフォレストで1,000件中2件、確率0.5を境にした判定が反転
- この反転はscikit-learnのバージョン違いによるものではない。別マシンの対照実験では、同一バージョン内でも同数が反転しており、差は変換と推論の経路で先に生じていた
- 同じONNXファイルでも、推論に使うスレッド数を変えると反転件数が動く。移行の合否は確率の最大差ではなく、本番と同じ実行条件でのクラス判定で決める
- 読み込み時に許可していない型を拒否できるskops(pickleより安全性を重視した保存形式)でも、予測確率と警告はpickle・joblibと同じ
- 検証範囲は1.5.2から1.9.0への1組み合わせ。合成データ4,000件、ロジスティック回帰とランダムフォレストの2モデル、照合は1,000件
4つの保存形式の役割と、この記事で見る2つの数値
比べたのはpickle・joblib・skops・ONNXの4つです。並べて書くと同じ用途の選択肢に見えますが、担っている役割はそれぞれ違います。
pickleはPython標準の方法で、オブジェクトの状態をそのままファイルにします。joblibも同様にscikit-learnのモデルを保存でき、実務ではこちらを使う場面も多いところです。skopsは、読み込み時に許可していない型を拒否できる形式で、pickleより安全性を重視しています。ONNX(Open Neural Network Exchange)だけは性格が異なり、Pythonのモデルそのものを保存するのではなく、別の実行エンジンで推論できる中間表現へ変換します。変換の動機になりやすい推論速度は、LightGBMで単発・一括の推論速度を比べた検証で別に測っており、そちらでも変換後の確率には最大3.19e-07の差が残りました。
読むのに要るのは、predict_probaのような予測確率を見た経験と、0.5などの閾値で最終判定を出す処理のイメージだけです。以降は、この2つの数値を追いかけます。
- 確率の最大差: 照合した1,000件のうち、保存側の予測確率から最も大きく動いた幅
- クラス反転: 確率0.5以上を陽性とする判定が、保存側と入れ替わった件数
もう1つ、結果表に出てくるInconsistentVersionWarningは、異なるscikit-learnで保存されたモデルを読み込んだことを知らせる警告です。読み込めたことは伝えてくれますが、互換性や予測の一致を保証するものではありません。
2つの環境を用意して、同じモデルを4形式で運んだ
保存側にscikit-learn 1.5.2、読み込み側に1.9.0の仮想環境を作り、実際にバージョンを跨がせています。make_classificationで生成した4,000件・12特徴量の合成データのうち、3,000件で学習し、残る1,000件で予測を照合しました。
モデルは2種類です。係数を使って予測するLogisticRegressionと、100本の決定木の結果を集約するRandomForestClassifierを選び、構造が単純なモデルと複雑なモデルで挙動が分かれるかを見ました。
照合の基準は、保存側で計算しておいた予測確率です。読み込み後の値との最大絶対差と、判定が入れ替わった件数を数えます。なお、pickle・joblib・skopsには元のfloat64(倍精度の小数)入力を、ONNXには変換時の仕様に合わせたfloat32入力を渡しているため、4形式がまったく同じ計算経路を通る比較ではありません。ONNXの推論はスレッド数を1に固定して回しており、それ以外の条件は記事の後半へ置きます。
実測前に危ないと思っていたのは、pickleとjoblibのほうでした。バージョンを跨ぐと数値が静かに動き、ONNXのような専用形式なら安全に運べる、という予想です。
8通りとも読み込めて、pickle・joblib・skopsは1件も差が出なかった
まず、ファイルが開けないという事故は起きませんでした。保存形式とモデルの8条件すべてで読み込みに成功し、pickle・joblib・skopsは保存側と完全に同じ確率を返しています。少なくともこの組み合わせでは、移行前に確認すべきは「読めるかどうか」ではありません。
| モデル | 形式 | 読めたか | 警告数 | 警告の種類 | 確率の最大差 | クラス反転 |
|---|---|---|---|---|---|---|
| logreg | pickle | ○ | 1 | InconsistentVersionWarning | 0.0 | 0 |
| logreg | joblib | ○ | 1 | 同上 | 0.0 | 0 |
| logreg | skops | ○ | 1 | 同上 | 0.0 | 0 |
| logreg | onnx | ○ | 0 | — | 1.45e-07 | 0 |
| rf | pickle | ○ | 102 | 同上 | 0.0 | 0 |
| rf | joblib | ○ | 102 | 同上 | 0.0 | 0 |
| rf | skops | ○ | 102 | 同上 | 0.0 | 0 |
| rf | onnx | ○ | 0 | — | 6.56e-07 | 2 |
差が0.0だったからといって、この3形式が将来のバージョンでも一致するとは言えません。警告が出ている以上、読み込みに成功したことを合格の根拠には使えないためです。警告の件数がモデルによって2桁違う点は、監視の設計に効いてくるので後の節で扱います。
予想は逆で、黙って判定を変えたのはONNXだった
危ないと踏んでいたpickle系は数値が動かず、代わりに動いたのはONNXでした。しかも警告は1件も出ません。ランダムフォレストの最大差は6.56e-07で、小数第7位に現れる大きさです。それでも1,000件中2件は、0.5の反対側へ移りました。
反転した行は、元の予測確率が判定境界の0.5に極めて近い位置にありました。ONNXへ変換して推論する構成なら、境界付近にデータが集まる業務ほど同じ入れ替わりが起きえます。したがって、移行テストで「確率の最大差が1e-6以下なら合格」といった基準だけを使うと、判定の不一致は素通りします。確率の差が小さいことと、最終判定が一致することは別の話です。
同じONNXファイルなら、バージョンを跨いでも予測は1件も変わらなかった
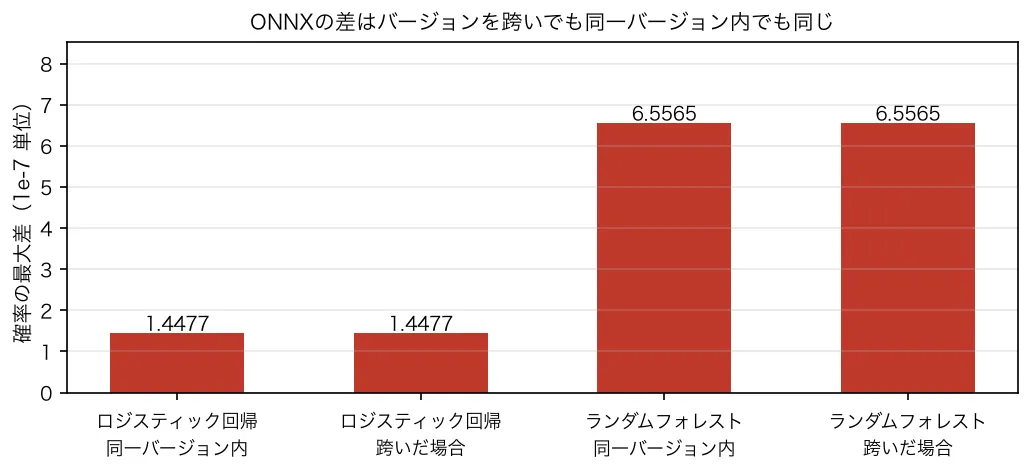
上の差をscikit-learnのバージョン違いへ帰属するには、同一バージョン内の比較が要ります。ONNXの推論を実行するonnxruntimeはscikit-learnのモデルを読み込まないため、変換済みのファイルが同じなら、読み込み側のscikit-learnだけを変えても出力は変わらない可能性があるからです。
そこで別のApple M1・macOS環境にscikit-learn 1.5.2と1.9.0を用意し、同じONNXファイル、同じ入力、同じ基準予測を使って、読み込み側の環境だけを入れ替えました。
| 比較 | logreg の最大差 | logreg の反転 | rf の最大差 | rf の反転 |
|---|---|---|---|---|
| 同一バージョン内(1.5.2 対 1.5.2) | 1.4477e-07 | 0 | 6.5565e-07 | 2 |
| 跨いだ場合(1.5.2 → 1.9.0) | 1.4477e-07 | 0 | 6.5565e-07 | 2 |
集約した2つの数値が揃っただけではありません。1,000件の予測確率をfloat64のバイト列にして計算したSHA-256も一致しました(ロジスティック回帰は611eaf2599d369ab…、ランダムフォレストは87bcb1c338eb262f…)。同一マシンなら、scikit-learnのバージョンを跨いでもONNXの予測配列は変わらなかったということです。
そして同じ反転は、同一バージョン内の比較でも起きています。反転はバージョン違いより前、ONNXへ変換して推論する経路で生じていました。 つまりONNXを照合すべき時期は、scikit-learnを更新するときではなく、モデルを変換した直後です。
証明できたのは、Apple M1上の2条件が一致したところまでです。切り分けには本編と別に学習したモデルを使っており、機種をまたいだ一致は主張できません(詳しくは後半の検証条件に書きました)。ここから「ONNXは不正確」と一般化することもできません。
スレッド数を変えると、同じファイルでも反転件数が動いた
もう1つ、実行条件の影響も測りました。同じmacOS環境でONNXファイルと入力を固定し、onnxruntimeが1回の推論に使うスレッド数(intra_op_num_threads)だけを変えています。
| スレッド数 | rf の最大差 | rf の反転 |
|---|---|---|
| 1 | 6.5565e-07 | 2 |
| 2 | 2.3127e-07 | 2 |
| 4 | 1.3351e-07 | 1 |
| 既定(onnxruntime に任せる) | 1.3351e-07 | 1 |
ランダムフォレストの反転は、1スレッドの2件から4スレッドと既定設定の1件へ移りました。ロジスティック回帰はすべての条件で最大差1.4477e-07、反転0のまま動きません。
100本の木の出力を並列に合計すると計算順序が変わり、浮動小数点の下位桁が動いた可能性があります。木を集約しないモデルで変化しなかった事実とも整合しますが、この機序自体は検証していません。観測から確実に言えるのは、モデルファイルとライブラリのバージョンを固定しても、推論設定が違えば判定結果は一致しない場合があることです。
監視するのは警告の数ではなく、種類のほう
InconsistentVersionWarningは、ロジスティック回帰で1件、ランダムフォレストで102件でした。100本の木を含む構造が件数に反映された可能性はありますが、警告を出した部品ごとの記録は残していないため、内訳は断定できません。それでもモデル構造によって件数の桁が変わる以上、「100件を超えたら異常」といった一律のしきい値には向きません。
件数が当てにならない理由は、もう1つあります。この記事のサンプル実装を検証していたとき、pickleファイルを閉じ忘れたことでResourceWarningが混ざり、件数が1から2、102から103へ増えました。無関係な警告が数に乗るわけです。監視やテストでは総数ではなく、InconsistentVersionWarningが含まれるかを種類で確認するほうが確実です。
移行のときに何を照合するか
出発点は、旧環境で基準値を残しておくこと。 テストデータに対する予測確率と最終判定を、バージョンを上げる前に保存します。新環境だけで予測を計算し直しても、更新前との差は測れません。
読み込みの成功は、合格判定に使わない。 pickle・joblib・skopsを読み込んだら、例外の有無に加えて警告の種類を記録し、そのまま次の照合へ進みます。
合否の線は、確率の最大差ではなく判定の一致に引く。 実際に使う閾値で判定が何件変わるかを数えてください。今回のランダムフォレストは、小数第7位の差でも2件が入れ替わりました。
ONNXを使うなら、照合は変換した直後に。 元のモデルとの判定の突き合わせは、本番と同じonnxruntimeのバージョン、CPU、スレッド数で行ってください。onnxruntime自体のバージョン差はこの記事で測っていないため、実行エンジンを更新するときは別の照合が要ります。
skopsへ移す理由は、読み込み時の安全性。 今回の予測確率と警告はpickle・joblibと同じでした。任意コード実行を避けたいなら有効ですが、バージョン互換性が保証されるからではありません。pickle・joblibを続けるなら、環境を固定するか、新環境で再学習して基準値と照合する形になります。
詳しい検証条件
ここから先は、結果を点検したい読者向けの条件です。
保存側の仮想環境にはscikit-learn 1.5.2を入れ、そこで学習したモデルを4形式で書き出しました。同時に、検証用1,000件に対する予測確率も同じ場所へ書き出し、これを基準値にしています。読み込み側は1.9.0の環境で、同じ入力を各形式へ流して差を集計しました。
- 確率の最大差は、基準値との差の絶対値を1,000件分求めた最大値
- クラス反転は、確率0.5以上を陽性としたときに保存側と判定が食い違った件数
- ONNXの推論では
intra_op_num_threadsを1に固定(既定のままだと結果が変わることは上の表のとおり) - 掲載した数値は、実行時に保存したログの集計値
ONNXへ渡す入力は、変換時の仕様に合わせてfloat32へ落としています。他の3形式は元のfloat64のままなので、ONNXの差には入力の精度低下と実行時の丸めの両方が乗っている可能性があります。
バージョン違いの切り分けとスレッド数の比較は、本編とは別のApple M1・macOS環境で行いました。この環境では、本編と同じコードと同じ乱数の種でモデルを学習し直しています。
同じ種を使っても、機種が違えば学習結果は揃いませんでした。2台のランダムフォレストは1,000件中73件で予測が異なり、最大差は0.02です。原因は特定していません。したがって、対照実験とサンプル実装で本編と同じ最大差・反転数が出たことは、集約した数値が揃ったという意味であって、予測配列そのものの一致ではありません。
適用範囲と限界
- scikit-learn 1.5.2から1.9.0への1組み合わせだけを測っています。ほかの組み合わせ、特にメジャーバージョンを跨ぐ場合の結果は保証できません
- 対象は
LogisticRegressionとRandomForestClassifierだけです。前処理を含むPipeline、勾配ブースティング、外部ライブラリのモデルは未検証です - numpyも保存側の2.0.2から読み込み側の版へ変わっているため、pickle・joblib・skopsの挙動をscikit-learnだけに帰属できません
- onnxruntimeは全実験で1.28.0に固定しており、onnxruntime自体のバージョン違いは未検証です。 実行エンジンを更新するときは、別途予測を照合する必要があります
- ONNXについて確認できたのは、Apple M1上の同一バージョン内とバージョンを跨ぐ条件で予測配列が一致したことまでです。変換時のfloat32化と実行時の丸めが、それぞれどの程度影響したかは分離していません
- 対照実験はApple M1でのみ行い、本編のIntel Xeonでは同一バージョン内を測っていません。切り分けには別のマシンで学習し直したモデルを使っているため、2台の予測配列の一致は確認していません(機種間の差は前節のとおりです)
- 読み込み時間、ファイルサイズ、メモリ使用量は比較していません
サンプル実装
2つの仮想環境が要ります。旧バージョンで保存し、新バージョンで読み直します。1つのファイルで、引数によって保存側と読み込み側を切り替えます。
"""scikit-learn のバージョンを跨いでモデルを読み直すと、何が起きるか。

**2つの仮想環境が要る。**
  旧環境: pip install "scikit-learn==1.5.2" numpy==2.0.2 joblib skops skl2onnx onnx
  新環境: pip install scikit-learn joblib skops onnxruntime numpy pandas

  旧環境で:  python sample_drift.py save ./artifacts
  新環境で:  python sample_drift.py load ./artifacts

見るのは「読めたか」だけではない。警告だけ出して黙って予測が変わることが
いちばん怖いので、予測確率の最大差とクラス反転数まで測る。
"""

import json
import os
import pickle
import sys
import warnings

import joblib
import numpy as np
import sklearn


def save(out):
    """旧環境で実行。モデルを4形式で保存し、基準の予測確率も残す。"""
    from sklearn.datasets import make_classification
    from sklearn.ensemble import RandomForestClassifier
    from sklearn.linear_model import LogisticRegression

    os.makedirs(out, exist_ok=True)
    X, y = make_classification(n_samples=4000, n_features=12, n_informative=6,
                               random_state=0)
    Xte = X[3000:]
    np.save(os.path.join(out, "X_test.npy"), Xte)

    models = {
        "logreg": LogisticRegression(max_iter=1000).fit(X[:3000], y[:3000]),
        "rf": RandomForestClassifier(n_estimators=100, random_state=0).fit(
            X[:3000], y[:3000]),
    }
    ref = {}
    for name, m in models.items():
        ref[name] = m.predict_proba(Xte)[:, 1].tolist()
        with open(os.path.join(out, f"{name}.pkl"), "wb") as f:
            pickle.dump(m, f)
        joblib.dump(m, os.path.join(out, f"{name}.joblib"))
        import skops.io as sio
        sio.dump(m, os.path.join(out, f"{name}.skops"))
        from skl2onnx import to_onnx
        onx = to_onnx(m, Xte[:1].astype(np.float32), options={id(m): {"zipmap": False}})
        with open(os.path.join(out, f"{name}.onnx"), "wb") as f:
            f.write(onx.SerializeToString())

    with open(os.path.join(out, "reference.json"), "w") as f:
        json.dump({"sklearn_version": sklearn.__version__,
                   "numpy_version": np.__version__, "reference_proba": ref}, f)
    print(f"保存完了 sklearn={sklearn.__version__} numpy={np.__version__}")


def load(art):
    """新環境で実行。4形式を読み直し、基準との差を測る。"""
    import pandas as pd

    Xte = np.load(os.path.join(art, "X_test.npy"))
    with open(os.path.join(art, "reference.json")) as f:
        ref = json.load(f)
    rows = []

    def compare(name, fmt, loader):
        rec = {"モデル": name, "形式": fmt}
        with warnings.catch_warnings(record=True) as w:
            warnings.simplefilter("always")
            try:
                proba = loader()
            except Exception as e:
                rows.append({**rec, "読めた": "×", "警告数": len(w),
                             "警告の種類": f"{type(e).__name__}"})
                return
            rec["警告数"] = len(w)
            rec["警告の種類"] = ";".join(sorted({x.category.__name__ for x in w})) or "—"
        base = np.array(ref["reference_proba"][name])
        rows.append({**rec, "読めた": "○",
                     "確率の最大差": float(np.max(np.abs(proba - base))),
                     "クラス反転": int(np.sum((proba >= 0.5) != (base >= 0.5)))})

    for name in ("logreg", "rf"):
        def pk(n=name):
            # with で閉じる。開きっぱなしにすると ResourceWarning が警告数に混ざる
            with open(os.path.join(art, f"{n}.pkl"), "rb") as f:
                return pickle.load(f).predict_proba(Xte)[:, 1]
        compare(name, "pickle", pk)
        compare(name, "joblib", lambda n=name: joblib.load(
            os.path.join(art, f"{n}.joblib")).predict_proba(Xte)[:, 1])

        def sk(n=name):
            import skops.io as sio
            p = os.path.join(art, f"{n}.skops")
            # 信頼できない型は既定で拒否される。保存元が自分なので許可して読む
            return sio.load(p, trusted=sio.get_untrusted_types(file=p)
                            ).predict_proba(Xte)[:, 1]
        compare(name, "skops", sk)

        def ox(n=name):
            import onnxruntime as ort
            so = ort.SessionOptions()
            so.intra_op_num_threads = 1
            s = ort.InferenceSession(os.path.join(art, f"{n}.onnx"), so,
                                     providers=["CPUExecutionProvider"])
            o = np.asarray(s.run([s.get_outputs()[-1].name],
                                 {s.get_inputs()[0].name: Xte.astype(np.float32)})[0])
            return o[:, -1] if o.ndim > 1 and o.shape[1] > 1 else o.ravel()
        compare(name, "onnx", ox)

    print(f"保存時 sklearn={ref['sklearn_version']} / 読込時 sklearn={sklearn.__version__}")
    print(f"検証 {len(Xte)} 行\n")
    print(pd.DataFrame(rows).to_string(index=False))


if __name__ == "__main__":
    (save if sys.argv[1] == "save" else load)(sys.argv[2])
このコードで欠かせないのは、保存側で基準の予測確率を残す処理です。新環境で基準値まで計算し直すと、新環境内の比較になり、バージョンを跨いだ差を測れません。
Apple M1 の Mac(Python 3.11.15、保存側 scikit-learn 1.5.2 / 読込側 1.9.0)で実行した結果です。
実行結果
保存時 sklearn=1.5.2 / 読込時 sklearn=1.9.0
検証 1000 行

   モデル     形式  警告数                      警告の種類 読めた       確率の最大差  クラス反転
logreg pickle    1 InconsistentVersionWarning   ○ 0.000000e+00      0
logreg joblib    1 InconsistentVersionWarning   ○ 0.000000e+00      0
logreg  skops    1 InconsistentVersionWarning   ○ 0.000000e+00      0
logreg   onnx    0                          —   ○ 1.447660e-07      0
    rf pickle  102 InconsistentVersionWarning   ○ 0.000000e+00      0
    rf joblib  102 InconsistentVersionWarning   ○ 0.000000e+00      0
    rf  skops  102 InconsistentVersionWarning   ○ 0.000000e+00      0
    rf   onnx    0                          —   ○ 6.556511e-07      2
掲載コードを別のCPUと組み直した旧環境で実行しても、警告数、確率の最大差、クラス反転数は8条件すべてで本編の表と一致しました。表示されるONNXの差は、丸め前で1.447660e-07と6.556511e-07です。
ただし、ここで一致したのは表にある集約値です。学習したモデルは機種間で揃っておらず、ロジスティック回帰の最大差も9桁目より後では一致しません。同じ集約値を再現できても、学習済みモデルや予測配列が同一だとは判断できません。
バージョンを上げる日より、変換した日に照合する
1組み合わせ・2モデルという狭い範囲での話ですが、1.5.2から1.9.0への移行で予測が動いたのは、危ないと思っていたpickleやjoblibではなくONNXでした。しかも、その差はバージョンを上げたせいではありません。同じファイルを同じマシンで動かす限り出力は変わらず、判定を分けていたのは変換と推論の側です。
だとすれば、照合を入れる場所も変わります。移行の可否を決めるのは確率の最大差ではなく、本番と同じ実行条件で数えたクラス判定の一致です。pickleとjoblibについては、読み込み時に警告という形で知らせが届くので、その種類を記録して照合へ進めば足ります。
残っているのは、実行エンジンそのものを更新した場合です。今回はonnxruntimeを1つの版に固定していたため、ここは測れていません。同じ枠組みで基準値と突き合わせれば確かめられるので、次に手をつけるならこの条件です。