
不正利用の検知や不良品の判別では、当てたい側のデータが全体の数%しかないことがあります。こういうデータで最初に迷うのが、クラスの偏りそのものに手を入れるかどうかです。少数派を人工的に増やす SMOTE、少数派の取りこぼしを重く扱うクラス重み、多数派を間引くアンダーサンプリング。候補は並びますが、どれも入れれば良くなると決まっているわけではありません。
そこで、何も手を入れずに学習したモデルを基準に置き、4つの対策がその基準を超えられるかを測りました。少数派の比率を 10% から 1% まで下げていけば、どこかで対策が効き始める境目があるはずだと思っていたからです。
境目は出てきませんでした。少数派が薄くなるほど、対策と無処置の差はむしろ開いていきます。
結論: 平均PR-AUCで無処置を超えた対策は1つもなかった
- SMOTE・クラス重み・アンダーサンプリング・オーバーサンプリングの4対策は、合成データ4水準でも実データ1件でも、無処置の平均 PR-AUC(少数派を予測の上位へどれだけ集められたかを表す指標)を一度も上回れなかった。
- 差は不均衡が強いほど広がる。少数派10%では無処置とクラス重み・複製の間に明確な差がなく、1%では4対策すべてが無処置に届かない。
- アンダーサンプリングは学習が全水準で最速。その代わり、犠牲になる PR-AUC も全水準で最大。
- 迷ったら、無処置のまま LightGBM(決定木を順に足す学習手法)で PR-AUC を測るのが出発点。対策はそのスコアを実際に超えられたときにだけ足す。
- 適用条件: LightGBM既定パラメータ、少数派1〜10%の合成データ4水準と、公開データ集pmlbのhypothyroid(少数派4.571%)1件。主指標はPR-AUC。
この記事で比べる5つの処置と、採点に使う指標
不均衡データとは、予測したいクラスの件数がもう一方より大幅に少ないデータです。このあとの表は縦に5つの処置、横に4つの不均衡度が並ぶ形をしていて、行の名前が何を指すかで読み方が決まります。各対策は、決定木を順に足して予測を改善する LightGBM へ渡す学習データか、学習時の損失の扱いを次のように変えます。
- 無処置:クラス分布を変えず、そのまま学習する
- クラス重み:少数派を間違えたときの損失を重くするため、学習 fold の「多数派件数 ÷ 少数派件数」を LightGBM の
scale_pos_weightに渡す - アンダーサンプリング:多数派を少数派の件数まで減らす
- SMOTE:少数派の近くにある点同士を補間し、人工的な学習データを作る
- オーバーサンプリング:少数派を複製して件数をそろえる
採点の中心に置いたのは PR-AUC です。モデルが返す少数派らしさの確率で全件を並べたとき、本当の少数派をどれだけ上位へ集められたかを1つの値にまとめた指標で、高いほど良い読みになります。多数派ばかりを予測しても高く出る Accuracy では、対策の良し悪しを判断しにくいためです。どれほど当てにならないかは正解率と他の指標を並べて測った検証にあり、少数派1%のデータでは、多数派を出すだけのダミー分類器でも正解率が99.00%に届きました。
Recall(本当の少数派を何割拾えたか)と Precision(少数派と予測したうち何割が当たりか)は、確率をどこで区切って少数派と判定するか、つまり閾値で動きます。固定した閾値で運用するときに別途確認する指標なので、今回は記録にとどめました。
何を確かめたか
比べたのは、無処置、クラス重み、SMOTE、単純なオーバーサンプリング、アンダーサンプリングの5条件です。少数派比率を 10% から 1% まで変えた合成データ4水準と、実データ1件を使いました。分類器は主に LightGBM の既定値で、最も極端な少数派1%の条件だけ、ロジスティック回帰でも同じ5条件を回しています。
件数を変える3方法は、交差検証の各回で学習に使う部分だけへ適用しました。評価部分まで加工すると、人工的に作った点や複製した点を相手に採点することになり、本来のクラス比率での性能を測れません。
データの生成条件、乱数、統計の手順は、後半の「詳しい検証条件」にまとめてあります。
不均衡度が上がるほど、無処置の優位が広がる
少数派が減るにつれて有利な対策が入れ替わると予想し、その境目を探しました。しかし合成データの4条件では順位の逆転が起きず、無処置がすべての列で最も高い平均 PR-AUC となりました。少数派が何%だからこの対策、という決め方は、少なくともこの4水準では成り立ちません。表の太字が各条件の最高値です。
| 処置 | 1:9(少数派10%) | 1:19(少数派5%) | 1:49(少数派2%) | 1:99(少数派1%) |
|---|---|---|---|---|
| 無処置 | 0.930 | 0.864 | 0.720 | 0.558 |
| クラス重み | 0.928 | 0.858 | 0.677 | 0.444 |
| SMOTE | 0.925 | 0.851 | 0.679 | 0.494 |
| オーバーサンプリング(複製) | 0.928 | 0.857 | 0.673 | 0.416 |
| アンダーサンプリング | 0.869 | 0.714 | 0.388 | 0.192 |
少数派 10% では、無処置とクラス重み、単純な複製の間に明確な差を確認できませんでした。SMOTE との差 0.005、アンダーサンプリングとの差 0.061 は補正後も残っています。少数派がさらに減ると無処置がほかの4方法を上回り、1:99 条件ではアンダーサンプリングとの差が 0.366 まで広がりました。
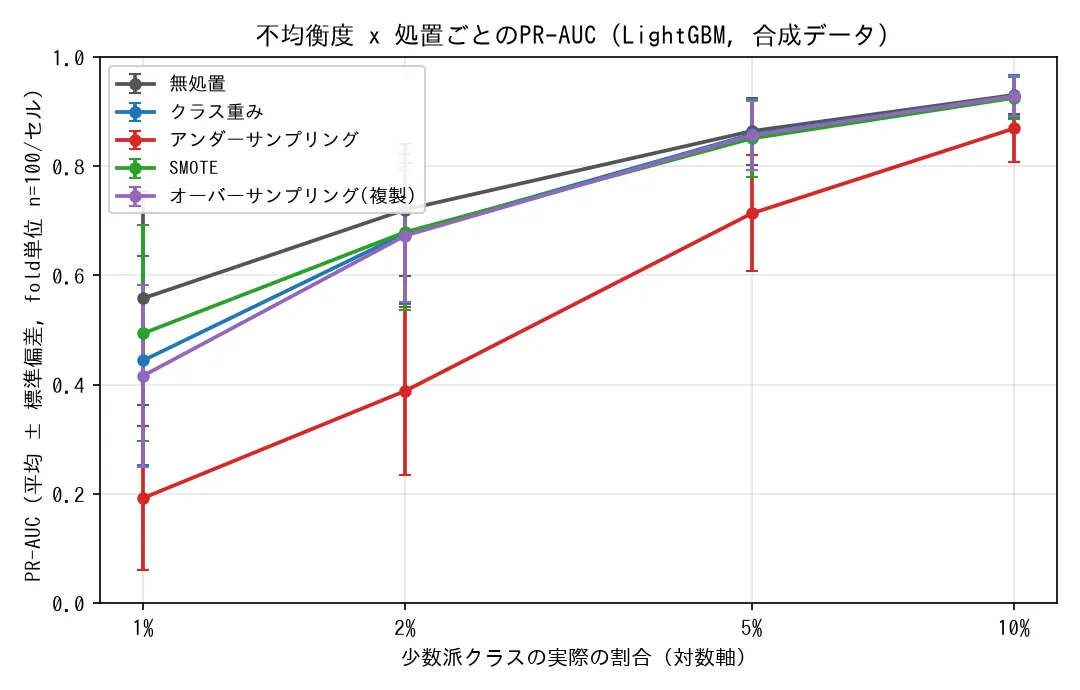
無処置が上回った原因は直接検証していないため、ここからは結果に基づく解釈です。クラス重みは間違いの重さを変え、SMOTE と複製は少数派の件数を増やしますが、元の特徴量に新しい観測情報を追加するわけではありません。LightGBM が元の分布から作った分類境界に対し、こうした変更が別の境界を選ばせた可能性があります。
SMOTEが複製に勝ったのは、最も極端な不均衡だけ
少数派を補間する SMOTE と、そのまま複製するオーバーサンプリングのどちらを選ぶかは、多くの条件では悩む意味がありませんでした。明確な差が残ったのは、最も極端な 1:99 条件だけです。
以降の表の「差の確認」は、複数の比較を考慮した後も差が残ったかを表します。○は差を確認できた組み合わせ、―は今回のデータでは明確な差を確認できなかった組み合わせです。―は「差がない」と証明した意味ではありません。比較の相手側にあたる行には「(基準)」と入れています。
| 不均衡度 | 平均差(SMOTE−複製) | 差の確認 |
|---|---|---|
| 1:9 | -0.003 | ― |
| 1:19 | -0.006 | ― |
| 1:49 | +0.006 | ― |
| 1:99 | +0.078 | ○(SMOTEが高い) |
1:99 条件では、各 fold の学習部分に含まれる少数派が約40件まで減り、SMOTE が複製を +0.078 上回りました。それ以外の3条件では差の向きがそろわず、補正後の差も確認できません。1:9 条件のある fold では学習時間が SMOTE 0.17 秒、複製 0.16 秒で、少なくともこの計測では補間に追加の時間がかかっています。
アンダーサンプリングは最速、その代わり精度の犠牲も最大
アンダーサンプリングは全条件で PR-AUC が最も低く、無処置との差は 1:9 の -0.061 から 1:99 の -0.366 へ広がりました。一方、学習に使う件数が減るため、処理時間はすべての条件で最短です。速さを買う代わりに順位の質を差し出す取引になっている、と読める結果です。
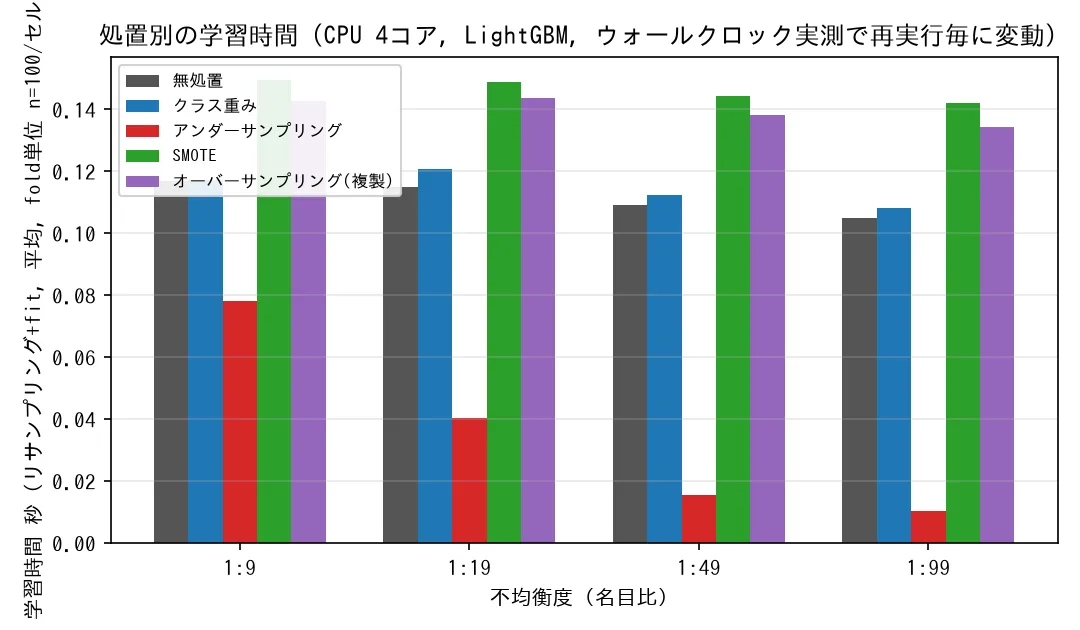
1:99 条件では、学習 fold に少数派が約40件しかなく、多数派も同数まで減らすと学習データは約80件になります。同じ fold で無処置が使うのは4,000件なので、木が分岐を学ぶ材料も大幅に失われます。これが精度低下の一因とは考えられますが、件数以外の影響と分けた検証は行っていません。
| 処置 | 学習時間(1:9水準・ある1fold) |
|---|---|
| 無処置 | 0.14秒 |
| クラス重み | 0.12秒 |
| アンダーサンプリング | 0.08秒(最短。ただし PR-AUC は最下位) |
| SMOTE | 0.17秒 |
| オーバーサンプリング | 0.16秒 |
表は1 fold の一例で、条件や乱数によって変動します。どの処置も1秒に満たない規模なので、1回あたりの絶対差はごく小さい値です。短縮時間が積み上がるのは、交差検証やチューニングで何十回も学習するときに限られます。
ロジスティック回帰でも、1:99水準では無処置が全対策を上回った
LightGBM だけに生じる結果かを確かめるため、最も極端な 1:99 条件では分類器をロジスティック回帰へ替え、同じ5方法を比較しました。ここでも無処置が最も高く、アンダーサンプリングが最も低い順序は変わりませんでした。木モデル特有の現象として片付けられない、ということです。
| 処置 | ロジスティック回帰 平均PR-AUC | LightGBM 平均PR-AUC(参考、同一1:99水準) |
|---|---|---|
| 無処置 | 0.385 | 0.558 |
| SMOTE | 0.266 | 0.494 |
| クラス重み | 0.241 | 0.444 |
| オーバーサンプリング(複製) | 0.240 | 0.416 |
| アンダーサンプリング | 0.178 | 0.192 |
ロジスティック回帰の無処置は 0.385 で、LightGBM の 0.558 より低い値です。それでも、次に高い SMOTE の 0.266 とは +0.119 の差がありました。線形モデルで確認したのは 1:99 条件だけなので、ほかの少数派比率でも同じ順序になるかは未検証です。
実データ1件でも順位は同じ、ただし上位3つは区別できない
実データの比較は一度やり直しています。最初の実行では、特徴量が完全に一致する重複行が学習 fold と評価 fold の両方に入り、学習時に見た行を評価にも使うデータリークが起きていました。交差検証より前に重複を除くよう処理を直し、残った3,085件(少数派 4.571%)ですべて測り直しています。
| 処置 | 平均PR-AUC(n=20) | 差の確認 |
|---|---|---|
| 無処置 | 0.832 | (基準) |
| クラス重み | 0.828 | ― |
| SMOTE | 0.829 | ― |
| オーバーサンプリング(複製) | 0.821 | ○(無処置が高い、差は小さい) |
| アンダーサンプリング | 0.746 | ○(無処置が大きく高い) |
合成データほど分かりやすい結果ではありません。実データでは、無処置 0.832 に対してクラス重み 0.828、SMOTE 0.829 となり、この2方法との明確な差は確認できませんでした。少数派比率が近い合成データの 1:19 条件では無処置が4方法を上回っており、差の出方が一致していません。実データは1件だけなので、データの性質による違いか、標本のばらつきかは切り分けられません。
SMOTEを入れると個別の予測も変わる
実データ3,085件のうち、無処置と SMOTE で閾値 0.5 の予測が異なったのは33件、全体の約1%でした。平均 PR-AUC が 0.832 と 0.829 で近くても、実際に正例と判定する対象は完全には一致しません。分類境界が動いた理由までは調べていないため、どちらの判定が実務上よいかは Recall、Precision、誤判定の内容と合わせて確認する範囲です。
対策を採用するかは、この順で決める
- 無処置のまま、つまりクラス比率にも損失の重みにも手を入れずに学習し、PR-AUCの基準値を作る
- クラス重みや SMOTE は各 fold の学習部分だけに適用し、評価部分は元の分布に保つ
- すべての方法を同じ分割で評価し、乱数を変えても基準値との差が続くか確かめる
- 固定した閾値で判定する場合は、PR-AUC と分けて Recall・Precision・誤判定コストを見る
- アンダーサンプリングでは、短縮できた学習時間と失った精度を並べて採否を決める
採用するのは、対策後の指標が無処置の基準値を上回り、その差が分割を変えても続いた場合です。少数派比率だけを根拠に方法を決めたり、データを均衡させたこと自体を改善とみなしたりはしません。
手順2を守らずSMOTEを分割前へ当てると、交差検証のスコアは実力と無関係に上がります。データリーク5パターンを測った検証では、この経路の盛れ幅が+0.24で5パターン中最大でした。前処理の順序だけを変えて測り直した検証でも、分割前のSMOTEは木モデルで0.1を超えています。
手順4で閾値を固定して運用する場合は、その手前でモデルが返す確率そのものが実際の割合とずれていることがあります。予測確率のキャリブレーションを実測した検証では、GaussianNBの確率のずれ(ECE)が較正で0.078から0.017まで縮む一方、順位づけ(ROC-AUC)はほとんど動きませんでした。ただしあちらは正例が約40%のほぼ均衡なデータでの実測で、少数派1%での効き目は測っていません。
詳しい検証条件
分類器は LightGBM で、パラメータは既定値のままです。各モデルが返した正例確率から PR-AUC を計算しました。Recall・Precision・F1 は閾値 0.5 のまま記録しています。ROC-AUC も参考値にとどめ、不均衡データでの差が見えやすい PR-AUC を判断の中心に置いています。
合成データは make_classification で5,000件・20列を生成し、そのうち10列が正解ラベルの判別に役立つ設定です。少数派比率を 10.0%・5.0%・2.0%・1.0% に変え、実データには機械学習用データセット集 PMLB の hypothyroid 1件を使いました。実データ側の少数派比率は操作していません。
合成データには、正解ラベルを誤った値へ入れ替えるラベルノイズを加えていません。make_classification の既定値では1%のラベルが反転し、少数派比率が低いほど狙った比率からずれやすいためです。
反復は、合成データの4種類の少数派比率、5つの処置、20通りの乱数、5分割交差検証の組み合わせです。5分割交差検証では、データを5つに分け、4つで学習して残り1つで評価する手順を入れ替えながら繰り返します。合成データでは生成と分割の乱数を変え、実データでは同じデータに対する分割だけを20通りに変えました。副次的に、最も極端な1:99水準だけ分類器をロジスティック回帰に差し替え、同じ5処置を比べています。
数値は保存した実行ログから集計しました。同じ乱数で作った5分割の結果は互いに独立ではないため、まず5回の平均を1点へまとめ、乱数20通りから得た20点を方法間で比べています。比較する組み合わせが多いほど偶然の差も見つかりやすくなるので、その影響を補正した p 値で判定しました。
読み飛ばし可: 統計手法・全ペア検定表(合成データ40ペア・実データ10ペア・ロジスティック回帰10ペア)
推測の単位は、各データシードで5fold平均を1点に集約したn=20の対応ありペアです。差の検定はWilcoxon符号順位検定、比較数の多さの補正はBonferroni法を主報告としHolm法も併記しました。信頼区間はこの20点を再標本化したブートストラップ(B=10,000、seed=42)で、評価サンプルに対する推定のばらつきを表します(実行時間のばらつきではありません)。以下の「p値(Bonferroni/Holm)」は補正後の値で、0.05を下回れば「有意(差を確認できた)」です。
合成データ(data_seed単位n=20、Bonferroni主報告/Holm併記)
| 不均衡度 | 処置A | 処置B | 平均差(A−B) | 差の95%CI | p値(生) | p値(Bonferroni) | 有意 | p値(Holm) | 有意 |
|---|---|---|---|---|---|---|---|---|---|
| 1:9 | 無処置 | クラス重み | +0.0020 | [+0.0004, +0.0037] | 0.01208 | 0.4832 | False | 0.1208 | False |
| 1:9 | 無処置 | アンダーサンプリング | +0.0614 | [+0.0510, +0.0727] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:9 | 無処置 | SMOTE | +0.0054 | [+0.0029, +0.0081] | 0.0004826 | 0.0193 | True | 0.007238 | True |
| 1:9 | 無処置 | オーバーサンプリング | +0.0022 | [+0.0009, +0.0035] | 0.00486 | 0.1944 | False | 0.05487 | False |
| 1:9 | クラス重み | アンダーサンプリング | +0.0594 | [+0.0499, +0.0694] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:9 | クラス重み | SMOTE | +0.0034 | [+0.0016, +0.0053] | 0.004221 | 0.1688 | False | 0.05487 | False |
| 1:9 | クラス重み | オーバーサンプリング | +0.0002 | [-0.0013, +0.0017] | 0.9563 | 1 | False | 1 | False |
| 1:9 | アンダーサンプリング | SMOTE | -0.0559 | [-0.0650, -0.0475] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:9 | アンダーサンプリング | オーバーサンプリング | -0.0592 | [-0.0698, -0.0494] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:9 | SMOTE | オーバーサンプリング | -0.0033 | [-0.0056, -0.0009] | 0.02958 | 1 | False | 0.2662 | False |
| 1:19 | 無処置 | クラス重み | +0.0059 | [+0.0034, +0.0087] | 8.202e-05 | 0.003281 | True | 0.001558 | True |
| 1:19 | 無処置 | アンダーサンプリング | +0.1507 | [+0.1293, +0.1724] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:19 | 無処置 | SMOTE | +0.0135 | [+0.0072, +0.0203] | 0.0004826 | 0.0193 | True | 0.007238 | True |
| 1:19 | 無処置 | オーバーサンプリング | +0.0077 | [+0.0047, +0.0106] | 0.0002098 | 0.008392 | True | 0.003567 | True |
| 1:19 | クラス重み | アンダーサンプリング | +0.1448 | [+0.1238, +0.1658] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:19 | クラス重み | SMOTE | +0.0076 | [+0.0010, +0.0144] | 0.08969 | 1 | False | 0.6279 | False |
| 1:19 | クラス重み | オーバーサンプリング | +0.0018 | [-0.0024, +0.0057] | 0.4091 | 1 | False | 1 | False |
| 1:19 | アンダーサンプリング | SMOTE | -0.1372 | [-0.1551, -0.1193] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:19 | アンダーサンプリング | オーバーサンプリング | -0.1430 | [-0.1645, -0.1215] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:19 | SMOTE | オーバーサンプリング | -0.0058 | [-0.0125, +0.0004] | 0.165 | 1 | False | 0.9897 | False |
| 1:49 | 無処置 | クラス重み | +0.0435 | [+0.0319, +0.0552] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:49 | 無処置 | アンダーサンプリング | +0.3320 | [+0.3061, +0.3582] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:49 | 無処置 | SMOTE | +0.0411 | [+0.0267, +0.0567] | 2.67e-05 | 0.001068 | True | 0.0005341 | True |
| 1:49 | 無処置 | オーバーサンプリング | +0.0475 | [+0.0342, +0.0623] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:49 | クラス重み | アンダーサンプリング | +0.2885 | [+0.2619, +0.3167] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:49 | クラス重み | SMOTE | -0.0024 | [-0.0158, +0.0121] | 0.5459 | 1 | False | 1 | False |
| 1:49 | クラス重み | オーバーサンプリング | +0.0041 | [-0.0123, +0.0219] | 0.8695 | 1 | False | 1 | False |
| 1:49 | アンダーサンプリング | SMOTE | -0.2909 | [-0.3175, -0.2656] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:49 | アンダーサンプリング | オーバーサンプリング | -0.2844 | [-0.3168, -0.2516] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:49 | SMOTE | オーバーサンプリング | +0.0064 | [-0.0118, +0.0251] | 0.3488 | 1 | False | 1 | False |
| 1:99 | 無処置 | クラス重み | +0.1139 | [+0.0947, +0.1353] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:99 | 無処置 | アンダーサンプリング | +0.3659 | [+0.3282, +0.4017] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:99 | 無処置 | SMOTE | +0.0642 | [+0.0411, +0.0865] | 0.0001335 | 0.005341 | True | 0.002403 | True |
| 1:99 | 無処置 | オーバーサンプリング | +0.1419 | [+0.1136, +0.1730] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:99 | クラス重み | アンダーサンプリング | +0.2520 | [+0.2124, +0.2925] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:99 | クラス重み | SMOTE | -0.0497 | [-0.0783, -0.0198] | 0.004221 | 0.1688 | False | 0.05487 | False |
| 1:99 | クラス重み | オーバーサンプリング | +0.0281 | [+0.0001, +0.0574] | 0.05317 | 1 | False | 0.4254 | False |
| 1:99 | アンダーサンプリング | SMOTE | -0.3017 | [-0.3470, -0.2569] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:99 | アンダーサンプリング | オーバーサンプリング | -0.2240 | [-0.2645, -0.1838] | 1.907e-06 | 7.629e-05 | True | 7.629e-05 | True |
| 1:99 | SMOTE | オーバーサンプリング | +0.0778 | [+0.0463, +0.1094] | 0.0002098 | 0.008392 | True | 0.003567 | True |
実データ(hypothyroid、重複行除去後、data_seed単位n=20、Bonferroni主報告/Holm併記)
| 処置A | 処置B | 平均差(A−B) | 差の95%CI | p値(生) | p値(Bonferroni) | 有意 | p値(Holm) | 有意 |
|---|---|---|---|---|---|---|---|---|
| 無処置 | クラス重み | +0.0035 | [-0.0017, +0.0083] | 0.165 | 1 | False | 0.4949 | False |
| 無処置 | アンダーサンプリング | +0.0853 | [+0.0734, +0.0971] | 1.907e-06 | 1.907e-05 | True | 1.907e-05 | True |
| 無処置 | SMOTE | +0.0026 | [-0.0036, +0.0086] | 0.3884 | 1 | False | 0.7768 | False |
| 無処置 | オーバーサンプリング | +0.0105 | [+0.0052, +0.0157] | 0.001986 | 0.01986 | True | 0.01191 | True |
| クラス重み | アンダーサンプリング | +0.0819 | [+0.0691, +0.0941] | 1.907e-06 | 1.907e-05 | True | 1.907e-05 | True |
| クラス重み | SMOTE | -0.0008 | [-0.0077, +0.0056] | 1 | 1 | False | 1 | False |
| クラス重み | オーバーサンプリング | +0.0070 | [+0.0021, +0.0123] | 0.01923 | 0.1923 | False | 0.09617 | False |
| アンダーサンプリング | SMOTE | -0.0827 | [-0.0949, -0.0710] | 1.907e-06 | 1.907e-05 | True | 1.907e-05 | True |
| アンダーサンプリング | オーバーサンプリング | -0.0749 | [-0.0856, -0.0637] | 1.907e-06 | 1.907e-05 | True | 1.907e-05 | True |
| SMOTE | オーバーサンプリング | +0.0078 | [+0.0020, +0.0138] | 0.03277 | 0.3277 | False | 0.1311 | False |
ロジスティック回帰(1:99水準のみ、data_seed単位n=20、Bonferroni主報告/Holm併記)
| 処置A | 処置B | 平均差(A−B) | 差の95%CI | p値(生) | p値(Bonferroni) | 有意 | p値(Holm) | 有意 |
|---|---|---|---|---|---|---|---|---|
| 無処置 | クラス重み | +0.1442 | [+0.1202, +0.1690] | 1.907e-06 | 1.907e-05 | True | 1.907e-05 | True |
| 無処置 | アンダーサンプリング | +0.2073 | [+0.1761, +0.2383] | 1.907e-06 | 1.907e-05 | True | 1.907e-05 | True |
| 無処置 | SMOTE | +0.1191 | [+0.0979, +0.1418] | 1.907e-06 | 1.907e-05 | True | 1.907e-05 | True |
| 無処置 | オーバーサンプリング | +0.1455 | [+0.1210, +0.1710] | 1.907e-06 | 1.907e-05 | True | 1.907e-05 | True |
| クラス重み | アンダーサンプリング | +0.0631 | [+0.0460, +0.0807] | 1.907e-06 | 1.907e-05 | True | 1.907e-05 | True |
| クラス重み | SMOTE | -0.0252 | [-0.0356, -0.0153] | 3.624e-05 | 0.0003624 | True | 0.0001087 | True |
| クラス重み | オーバーサンプリング | +0.0012 | [-0.0012, +0.0038] | 0.2455 | 1 | False | 0.2455 | False |
| アンダーサンプリング | SMOTE | -0.0883 | [-0.1136, -0.0643] | 1.907e-06 | 1.907e-05 | True | 1.907e-05 | True |
| アンダーサンプリング | オーバーサンプリング | -0.0619 | [-0.0785, -0.0455] | 1.907e-06 | 1.907e-05 | True | 1.907e-05 | True |
| SMOTE | オーバーサンプリング | +0.0264 | [+0.0160, +0.0375] | 4.768e-05 | 0.0004768 | True | 0.0001087 | True |
実データ(hypothyroid)の各処置の平均PR-AUCと95%信頼区間(data_seed単位n=20)
| 処置 | 平均PR-AUC(n=20) | 95%信頼区間 |
|---|---|---|
| 無処置 | 0.832 | [0.825, 0.838] |
| クラス重み | 0.828 | [0.822, 0.834] |
| SMOTE | 0.829 | [0.824, 0.834] |
| オーバーサンプリング(複製) | 0.821 | [0.815, 0.827] |
| アンダーサンプリング | 0.746 | [0.734, 0.758] |
データはpmlb(コミット7c1f4bd)から取得し、特徴量が完全一致する重複行を除いてから使いました。取得元のコミットは固定し、取得時の来歴も実行ログに残しています。
適用範囲と限界
実データは hypothyroid(少数派 4.571%)の1件だけです。合成データも make_classification の20列という1種類に固定し、ラベルノイズを入れていません。特徴量の数、クラスの重なり、誤ったラベルの割合が変われば、対策の順位も変わる可能性があります。
主な分類器は、チューニングしていない LightGBM です。ライブラリを替えたときの傾向はGBDT3種を実測比較した記事にあり、数万件まで増えると既定設定での精度差はほぼ消えました。ロジスティック回帰は 1:99 条件だけで、ランダムフォレストやニューラルネットは比較していません。ADASYN や Borderline-SMOTE など、SMOTE から派生した方法も対象外です。
1:99 条件では、各 fold の評価部分に含まれる少数派が10件しかなく、PR-AUC 自体が分割によって動きやすくなります。少数派の評価件数は 1:49 で20件、1:19 で50件、1:9 で100件です。平均値だけでなく、乱数を変えたときの幅も確認する前提になります。
Recall・Precision・F1 は記録しましたが、閾値を変えた比較は行っていません。学習時間も CPU 4コアの単一環境で測った経過時間なので、別の環境で同じ秒数になるとは限りません。
サンプル実装
最小デモ:無処置・クラス重み・SMOTEを比べる
最小デモは、同じ学習・評価データを使って、無処置、クラス重み、SMOTE の3条件を比べます。各モデルが評価データへ返した正例確率から PR-AUC を計算し、SMOTE は学習データだけへ適用します。少数派約5%の合成データで、比較手順を手元で確認するためのコードです。
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.metrics import average_precision_score
from lightgbm import LGBMClassifier
from imblearn.over_sampling import SMOTE

# 少数派5%程度の不均衡データを作る
X, y = make_classification(n_samples=2000, weights=[0.95, 0.05], random_state=42)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, stratify=y, test_size=0.2, random_state=42
)

# 無処置
clf = LGBMClassifier(random_state=42, verbosity=-1)
clf.fit(X_train, y_train)
proba = clf.predict_proba(X_test)[:, 1]
print("無処置 PR-AUC:", average_precision_score(y_test, proba))

# クラス重み(多数派件数/少数派件数をscale_pos_weightに渡す)
n_pos, n_neg = (y_train == 1).sum(), (y_train == 0).sum()
clf_cw = LGBMClassifier(random_state=42, verbosity=-1, scale_pos_weight=n_neg / n_pos)
clf_cw.fit(X_train, y_train)
proba_cw = clf_cw.predict_proba(X_test)[:, 1]
print("クラス重み PR-AUC:", average_precision_score(y_test, proba_cw))

# SMOTE(学習データにのみ適用する)
X_res, y_res = SMOTE(k_neighbors=5, random_state=42).fit_resample(X_train, y_train)
clf_sm = LGBMClassifier(random_state=42, verbosity=-1)
clf_sm.fit(X_res, y_res)
proba_sm = clf_sm.predict_proba(X_test)[:, 1]
print("SMOTE PR-AUC:", average_precision_score(y_test, proba_sm))
完全版:5処置をまとめて比べる
完全版ではアンダーサンプリングとオーバーサンプリングを加え、5条件を同じ評価関数へ渡します。入力する合成データは最小デモと同じです。
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.metrics import average_precision_score
from lightgbm import LGBMClassifier
from imblearn.over_sampling import SMOTE, RandomOverSampler
from imblearn.under_sampling import RandomUnderSampler

# 少数派5%程度の不均衡データを作る
X, y = make_classification(n_samples=2000, weights=[0.95, 0.05], random_state=42)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, stratify=y, test_size=0.2, random_state=42
)


def fit_and_score(X_tr, y_tr, scale_pos_weight=None):
    # 処置ごとの学習データでLightGBMを学習し、テストのPR-AUCを返す
    clf = LGBMClassifier(
        random_state=42, verbosity=-1,
        scale_pos_weight=scale_pos_weight if scale_pos_weight else 1.0,
    )
    clf.fit(X_tr, y_tr)
    proba = clf.predict_proba(X_test)[:, 1]
    return average_precision_score(y_test, proba)


results = {}

# 無処置
results["無処置"] = fit_and_score(X_train, y_train)

# クラス重み
n_pos, n_neg = (y_train == 1).sum(), (y_train == 0).sum()
results["クラス重み"] = fit_and_score(X_train, y_train, scale_pos_weight=n_neg / n_pos)

# アンダーサンプリング(多数派を少数派の件数まで削減)
X_under, y_under = RandomUnderSampler(random_state=42).fit_resample(X_train, y_train)
results["アンダーサンプリング"] = fit_and_score(X_under, y_under)

# SMOTE(少数派の近傍を補間して合成)
X_smote, y_smote = SMOTE(k_neighbors=5, random_state=42).fit_resample(X_train, y_train)
results["SMOTE"] = fit_and_score(X_smote, y_smote)

# ランダムオーバーサンプリング(少数派を複製)
X_over, y_over = RandomOverSampler(random_state=42).fit_resample(X_train, y_train)
results["オーバーサンプリング"] = fit_and_score(X_over, y_over)

for name, pr_auc in results.items():
    print(f"{name}: PR-AUC={pr_auc:.4f}")
このデモは1回の分割だけで学習・評価するため、20通りの乱数と5分割交差検証を集計した本文とは条件が異なります。実行時に無処置と対策の順位が入れ替わっても、本文の再現に失敗したとは限りません。結論まで検証する場合は、分割の乱数を変えた交差検証へ拡張し、平均とばらつきを比べます。
まず無処置で測る
不均衡データを見つけても、対策を前提に学習パイプラインを組む必要はありません。無処置のモデルを最初に作れば、SMOTE やクラス重みが本当に改善を加えたかを判断する基準ができます。今回の合成データと実データでは、その基準を超えた対策がありませんでした。
境目を探しに行って手ぶらで戻ってきた形なので、逆の結果が出る条件も気になります。自分のデータへ持ち出す前に確かめたいのは、ラベルの誤りが混じったときにも同じ順位になるかどうかです。今回はその条件を外して測っており、少数派の比率以外にどこまで順位が動くのかは、まだ手元にありません。
出典:実データはpmlb (Penn Machine Learning Benchmarks)(コミット7c1f4bd、2026-07-19取得、MITライセンス)経由で取得したhypothyroidデータセットです。元データはR. Quinlan, “Thyroid Disease,” UCI Machine Learning Repository, 1986(https://doi.org/10.24432/C5D010)によるもので、CC BY 4.0の下で提供されています。取得後、特徴量が完全一致する重複行を除くなどの前処理をしています。
本記事は医療データセットをML手法比較のベンチマークとして利用したもので、医療的助言・診断を目的としません。