
表形式のデータで分類モデルを作ったあと、「なぜこの予測になったのか」を人に説明する場面があります。LightGBM のように決定木をたくさん積み上げるモデルは精度を出しやすい一方、どの特徴量が予測をどちらへ動かしたのかを、モデルの構造そのものから読み取るのは簡単ではありません。
学習済みのモデルへ、あとから説明を付ける方法もあります。ただし浅い決定木で置き換える代理モデルは、本体との一致率を測った検証では人が読める深さ3で条件により平均0.61〜0.84にとどまりました。行ごとの寄与を出す手法にも手法差があり、SHAPとLIMEを比べた検証では第1位の特徴が一致したのは33.3〜46.1%です。
そこで候補になるのが、最初から説明しやすい形で学習する EBM(Explainable Boosting Machine)です。特徴量ごとの効果を足し合わせて予測するので、各特徴量の働きをモデルの中身から追えます。では、その読みやすさと引き換えに何を失うのか。実データ3件で分類精度(正例を負例より上位に並べられる度合いを0から1で表す ROC-AUC。0.5付近なら当て推量、1に近いほど順位が正確)を比べると、差はどちらの向きも0.012以下でした。大きく開いたのは、1回の学習にかかる時間のほうです。
先に結論
- 公開データセット3件(adult / magic / phoneme)のROC-AUCは、EBMがLightGBMを2件で上回り、1件で下回った。差はいずれも0.012以下(adult +0.011、magic +0.004、phoneme -0.008)。
- 説明しやすさの対価が出たのは精度ではなく学習時間。1回の学習の平均(全21セル、桁の比較用)はEBMが73.00秒、LightGBMが0.116秒。評価データを一括で1回予測する時間は逆向きで、EBM 0.0059秒に対しLightGBM 0.0362秒。
- 3つの特徴量が同時にそろって初めて現れる関係が真の構造を支配する合成データでは、EBMは0.509と当て推量に近い水準まで低下。同じデータでLightGBMも0.887から0.739へ下がるが、そこで踏みとどまる。
- 適用条件は、全モデルとも各ライブラリの既定値のまま、学習2,000件・列数5〜14、乱数の初期値は0/1/2の3つ、1スレッド固定。チューニング後と、これより大きい規模は未測定。
EBMとLightGBMは、予測の組み立て方が違う
この先の表には、EBM(既定)、EBM(加法のみ)、LightGBM、ロジスティック回帰という4つの列が並びます。読み分けの手がかりになるのは、それぞれが予測を組み立てる方法の違いです。
EBM は、特徴量ごとに「値が変わると予測がどちらへ動くか」を表す曲線を学習します。予測するときは、各特徴量の曲線が出した値を足し合わせ、最後に確率へ変換します。足し算で組み立てるため、どの特徴量が予測を押し上げ、どれが押し下げたのかを項ごとに確認できます。
ただし、足し算だけでは表せない関係もあります。ある特徴量が大きく、かつ別の特徴量が小さいときにだけ現れる関係が典型で、これを交互作用と呼びます。EBM は2つの特徴量の組み合わせを表す項(交互作用項)を既定で自動的に追加しますが、3つ以上が同時にそろって初めて現れる関係は、既定の設定では守備範囲の外です。
同じ特徴量とラベルを受け取る LightGBM は、決定木を順に足しながら前の木の誤りを埋めていく勾配ブースティングの実装です。分岐を重ねることで複雑な関係も表せる代わりに、木が数百本になると、そのまま人が読む用途には向きません。
比較には補助の条件を2つ足しました。EBM(加法のみ)は交互作用項を作らない設定で、交互作用項が精度と計算時間にどれだけ効いたかを切り分けます。ロジスティック回帰は、単純な線形関係だけでどこまで予測できるかを見るための基準です。
なお、この記事で言う「説明しやすさ」は、学習後に別の手法で説明を付けられるかではなく、モデル自体の項を読めるかどうかに限ります。
実データ3件と、交互作用を強めた合成データで比べた
実データと合成データを両方使ったのは、EBM の精度が下がったときに理由を切り分けるためです。
実データには、機械学習用データセット集 PMLB の phoneme(5列、5,404件)、magic(10列、19,020件)、adult(14列、48,842件)を使いました。各データからクラス比率を保ったまま2,000件を学習用に抽出し、残りから最大5,000件を評価に回しています。phoneme は残りの3,404件すべてが評価対象です。
合成データでは、正解を決める信号の置き場所だけを4段階で動かしました。特徴量ごとの効果で表せる状態から、3特徴量の組み合わせだけに信号がある状態までです。分類問題そのものの難しさは変えておらず、正解の確率を知っている場合に到達できる ROC-AUC の上限は 0.902〜0.915 に収まっています。EBM の精度が下がったときに、単に難しいデータへ変わったのか、モデルが3特徴量の関係を表現できなかったのかを区別するための設計です。
測ったのは、ROC-AUC、1回の学習時間、推論時間、そしてモデルを構成する部品の数です。部品の数は EBM では項の数、LightGBM では木と葉の数を指し、人が確認する対象の多さを比べるための代用にすぎません。実際に説明を理解できたかどうかを直接測る指標ではないので、そのつもりで読んでください。
全モデルとも各ライブラリの既定値のまま、乱数の初期値(seed)を 0 / 1 / 2 の3通り変えて回しました。データの分割やスレッド数といった条件は、後半の「詳しい検証条件」にまとめています。
実データ3件では、精度の差はどちらの向きも0.012以下だった
EBM に置き換えても、精度はほとんど変わりませんでした。adult と magic では EBM が LightGBM を上回り、phoneme だけが下回っています。
この規模のデータでは、精度を理由に EBM を外す判断も、EBM を選ぶ判断も難しいということです。選定の決め手は、精度以外へ移ります。
| データ(列数) | EBM(既定) | EBM(加法のみ) | LightGBM | ロジスティック回帰 | LightGBMとの差(3seedの幅) |
|---|---|---|---|---|---|
| adult(14列) | 0.905 | 0.906 | 0.893 | 0.853 | +0.011(+0.011〜+0.012) |
| magic(10列) | 0.914 | 0.895 | 0.910 | 0.835 | +0.004(+0.003〜+0.005) |
| phoneme(5列) | 0.925 | 0.889 | 0.934 | 0.810 | -0.008(-0.012〜-0.006) |
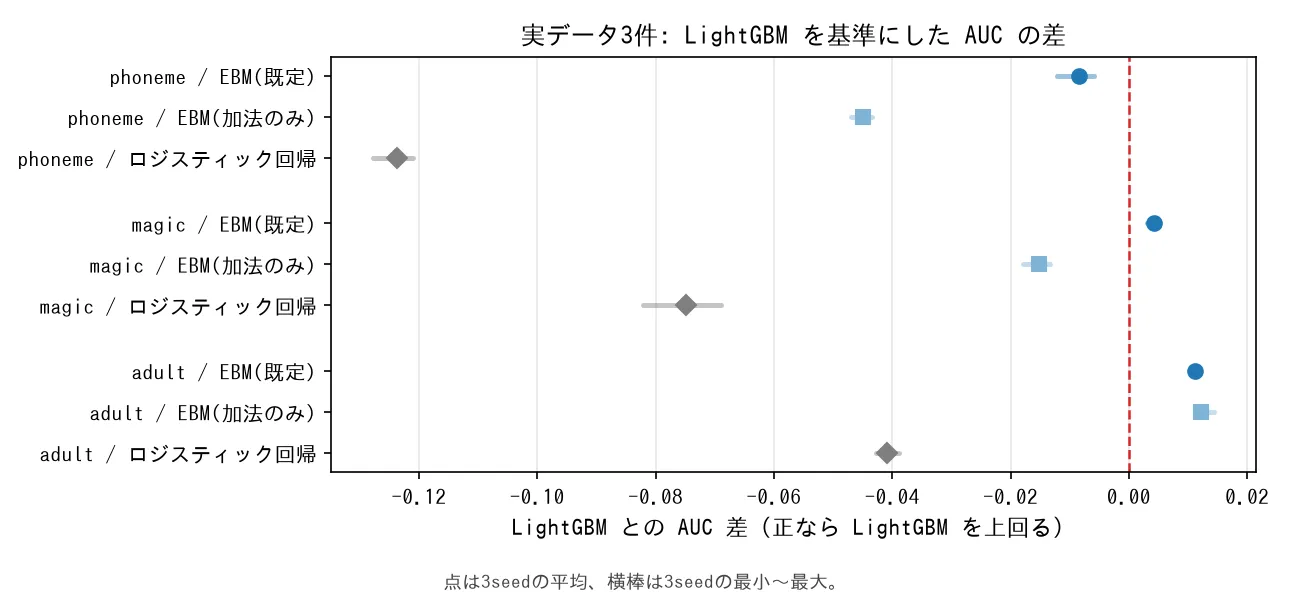
差の絶対値は3件とも 0.012 以下で、向きは乱数の初期値を変えた3回すべてで一致しました。3件のうち2件で EBM が上に出たのは、実験前の見込みとは違う結果です。中小規模の実データなら両者の差は小さく、3つ以上の特徴量が絡む関係が支配する条件(このあとの合成データ)では EBM が下回ると予想していました。後半は当たった一方、実データでは予想より EBM 側へ振れ、説明しやすさの代償を精度の低下としては確認できていません。
ここで言えるのは、3データ・3回・既定値同士では差が小さかったところまでです。EBM のほうが高精度だ、と読める結果ではありません。
精度が並んでも、学習時間は2〜3桁違った
精度で差がつかなかったぶん、違いは別の場所に出ました。1回の学習にかかる時間です。
学習時間の差は、同じ待ち時間で試せる条件数へ直結します。EBM が1回1分を超えるなら、5分割の交差検証だけでも数分かかり、パラメータ探索まで含めた負担はさらに増えます。
次の表は、合成4条件と実データ3件を合わせた全21セルの平均と範囲です。
| モデル | 学習の平均 | 学習の最小〜最大 | 推論の平均 |
|---|---|---|---|
| EBM(既定) | 73.00秒 | 38.29〜117.87秒 | 0.0059秒 |
| EBM(加法のみ) | 8.53秒 | 2.45〜18.86秒 | 0.0034秒 |
| LightGBM | 0.116秒 | 0.064〜0.166秒 | 0.0362秒 |
| ロジスティック回帰 | 0.0077秒 | 0.0055〜0.0161秒 | 0.0012秒 |
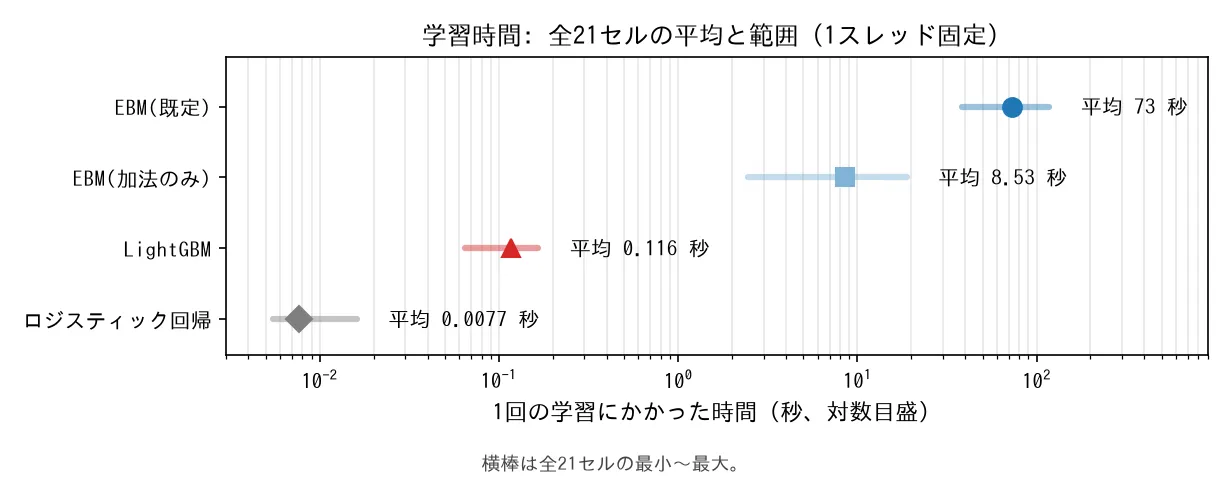
平均どうしを割ると、EBM の既定値は LightGBM のおよそ600倍です。最小と最大から機械的に作った比なら、約230〜1,800倍まで広がります。
どちらの倍率も参考値です。実験の後半に同じマシンで別の処理が走り、EBM の一部の計測値が膨らんでいます(magic の3回は 75.0 秒、92.7 秒、114.3 秒)。代表2条件を別の時間帯に測り直すと元の値と数%以内で一致したものの、その際もマシンを完全には占有できていません。倍率のもとになる最小値と最大値も同じ条件同士の比較ではないため、ここから読めるのは2〜3桁の差があったことまでです。以降、学習時間は桁の比較にだけ使い、秒単位の差は読みません。ROC-AUC は乱数の初期値から再現される値なので、この負荷の影響を受けません。
推論は逆向きでした。評価データ(3,404〜5,000件。セルごとに異なる)を一括で1回予測したときの時間は、EBM が 0.0059 秒、LightGBM が 0.0362 秒です。マシン負荷は処理時間を長くする方向に働くため、EBM が速いという順序を負荷だけで説明するのは難しいと考えられます。項ごとの値を参照して足す EBM の計算方法とは整合しますが、ライブラリ内部の処理までは追っていないので、ここは結果からの解釈です。
3特徴量が同時に効く合成データでは、EBMが0.509まで落ちた
3つ以上の特徴量がそろって初めて現れる関係だけが正解を決めるデータでは、EBM の精度が当て推量に近い水準まで落ちました。LightGBM も下がりますが、崩れ方はゆるやかです。
EBM の精度が LightGBM より大きく低いとき、この形の関係を取りこぼしていないか疑う手掛かりになります。表の左端にある「高次交互作用の割合」は、3つ以上の特徴量がそろって初めて現れる関係が真の構造に占める割合で、EBM が作る交互作用項の数とは別物です。太字は各行の最高値、右端は正解の確率から求めた到達可能な上限を指します。
| 高次交互作用の割合 | EBM(既定) | EBM(加法のみ) | LightGBM | ロジスティック回帰 | 達成可能な上限 |
|---|---|---|---|---|---|
| 0.00 | 0.903 | 0.904 | 0.887 | 0.793 | 0.915 |
| 0.35 | 0.811 | 0.810 | 0.832 | 0.729 | 0.905 |
| 0.70 | 0.694 | 0.693 | 0.782 | 0.649 | 0.902 |
| 1.00 | 0.509 | 0.508 | 0.739 | 0.506 | 0.913 |
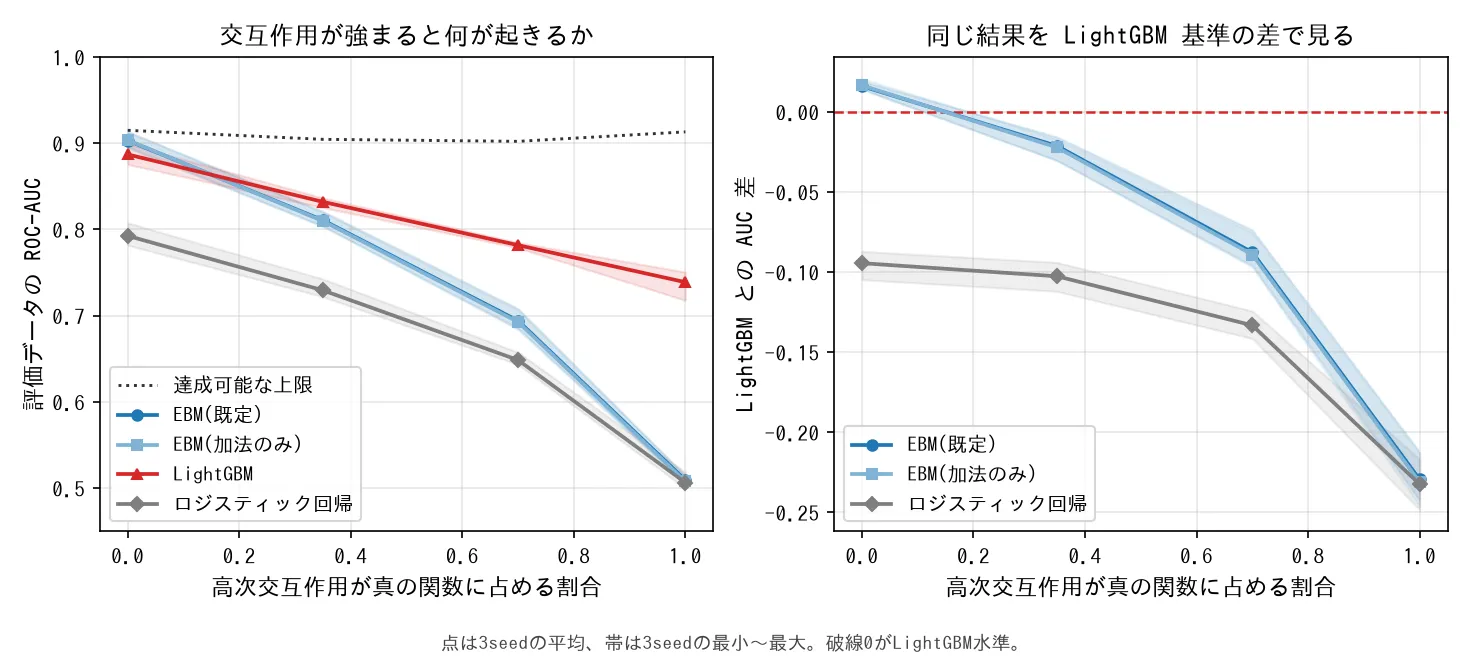
上限が4条件でほぼ変わらないことから、データ全体が難しくなったわけではないと分かります。動かしたのは、特徴量ごとの曲線を足す形で信号を表せるかどうかだけです。
LightGBM との差は、割合 0.00 では EBM が +0.016 上でしたが、0.35 で逆転し、1.00 では -0.229 まで開きました。この向きは3回の実行すべてで一致しています。EBM が下がること自体は実験設計から予想できたものの、割合 1.00 では非線形なモデルである EBM と線形モデルのロジスティック回帰が、0.509 と 0.506 でほぼ並びました。
この条件では、正解を決める信号が3特徴量の積と符号の積だけにあります。1特徴量だけの効果にも2特徴量の組み合わせにも信号が現れないため、EBM が既定で作る2特徴量の交互作用項では届きません。LightGBM は木の分岐を重ねて3特徴量の関係を近似できたと考えられますが、個々の分岐までは調べていないので、ここも解釈です。
割合 1.00 のような構造が現実のデータにどの程度あるかは、この実験では分かりません。確認できたのは、3つ以上の特徴量の組み合わせだけに予測の手掛かりがある場合、EBM の表現力がそのまま精度の上限になることです。
交互作用項は、足す価値のあるデータとないデータに分かれた
EBM の既定値と、交互作用項を持たない条件を比べると、追加した項が精度に寄与したかを確認できます。結果はデータではっきり分かれました。
既定のまま使うのではなく、交互作用のあり・なしを同じデータで一度は比べておくと、追加の計算時間が見合うかを判断できます。
| データ | 交互作用項によるAUCの増分 | 学習時間(加法のみ → 既定) |
|---|---|---|
| phoneme | +0.037 | 13.8秒 → 108.6秒 |
| magic | +0.019 | 10.7秒 → 94.0秒 |
| adult | -0.001 | 11.1秒 → 43.7秒 |
| 合成(4水準) | -0.0005 〜 +0.0016 | 2.6〜10.1秒 → 59.9〜69.0秒 |
adult では2特徴量の交互作用項を42個作っても精度が上がらず、3回とも横ばいか、わずかに下がりました。対照的に、phoneme の +0.037 は、実データで観測した EBM と LightGBM の差より大きな改善です。合成データで増分が4条件とも 0.002 未満だったのは、正解を決めるのが3特徴量の関係であり、2特徴量の項を追加しても表現できないためです。
右の列は、前節と同じ理由で桁の違いとして読んでください。交互作用項の探索が学習時間へ強く効くことは、1,000件・10列の予備計測でも出ています。交互作用を無効にすると 91.9 秒から 5.7 秒へ短縮しました。
EBMが選んだ項の内訳
平均の ROC-AUC だけでは、どの交互作用項が予測へ影響したのか分かりません。そこで同じ条件をもう一度学習し、EBM が作った項を、学習データ上で予測を動かした平均量が大きい順に並べました。このときの評価 AUC は元の実行と小数6桁まで一致しています。
adult の上位は marital-status(0.760)、age(0.517)、capital-gain(0.488)、education-num(0.453)と続き、上位8項はすべて1特徴量だけの効果でした。一方、phoneme の上位8項には Aa & Dcl(0.687)、Aa & Ao(0.390)、Ao & Iy(0.320)という3つの交互作用項が入っています。交互作用項による AUC の増分が adult では -0.001、phoneme では +0.037 だったことと対応する内訳です。
読む対象の数は、EBMの最大56項に対しLightGBMは3,100葉
モデルを人が確認するときの対象数として、EBM の項と LightGBM の木・葉を数えました。
| データ(列数) | EBMの項数 | 内訳 | 交互作用項の重要度シェア | LightGBM |
|---|---|---|---|---|
| adult(14列) | 56 | 主効果14 + 交互作用42 | 15.7% | 100本 / 3,100葉 |
| magic(10列) | 40 | 主効果10 + 交互作用30 | 27.2% | 100本 / 3,100葉 |
| phoneme(5列) | 15 | 主効果5 + 交互作用10 | 42.7% | 100本 / 3,100葉 |
| 合成(10列) | 40 | 主効果10 + 交互作用30 | 12.0〜43.1% | 100本 / 3,100葉 |
LightGBM の100本・3,100葉は、既定の木と葉の数から決まるため、今回のデータ間では一定です。EBM は列数に応じて項が増えますが、最も多い adult でも56項でした。EBM なら項ごとの曲線を順に確認できる一方、3,100個の葉を持つ LightGBM の構造を個別に確認するのは現実的ではありません。
ただし、EBM の重要度は学習データ上で予測を動かした平均量であり、未知のデータに対する精度への貢献ではありません。合成データの割合 1.00 では、重要度の 43.1% が交互作用項に付いたにもかかわらず、評価データの ROC-AUC は 0.509 でした。重要度が高い項を見つけても、それだけで予測に役立つ関係だとは判断できません。
置き換えを決めるのは、精度差ではなく時間と説明の使い道
ここから先は、学習2,000件・列数5〜14で、どのモデルも既定値のまま測った範囲から言えることです。評価指標が近いだけでは、EBM を選ぶ理由になりません。学習時間を許容でき、項ごとの曲線を確認することが実際の説明やモデル点検に役立つ場合に、LightGBM から置き換える意味が生まれます。手元のデータでは、次の順序で確かめると判断材料がそろいます。
- 同じデータ分割で両者の評価指標を比べる。今回は3件とも差が0.012以下で、勝ち負けの向きもデータで入れ替わった
- EBM を1回学習し、待てる時間か見積もる。21セル平均は73.00秒対0.116秒で、5分割の交差検証だけでも数分に届く
- 交互作用項のあり・なしを比べる。増分は phoneme の +0.037 から adult の -0.001 まで割れ、学習時間は10秒台から数十秒〜100秒超へ伸びた
- 精度が大きく下がるなら、3つ以上の特徴量が絡む関係を疑う。合成データでは EBM が0.509と、線形モデルの0.506に並ぶところまで落ちた
- 最後に曲線と上位項を見て、説明に使える内容か確かめる。adult は56項、phoneme は15項で、LightGBM の3,100葉とは確認の手間が違う
詳しい検証条件
合成データは、互いに独立した特徴量10列から作りました。正例になりやすさを決める式には、特徴量ごとの曲線を足す成分と、3特徴量を掛け合わせる成分を入れ、後者の割合を 0.00 / 0.35 / 0.70 / 1.00 の4段階に変えています。割合 0.00 は個々の特徴量だけで信号を表せる状態、1.00 は3特徴量の組み合わせだけに信号がある状態です。2成分のばらつきをそろえてから混ぜたため、本文で触れた到達可能な上限は 0.902〜0.915 の範囲に収まりました。
実データは、各データからクラス比率を保ったまま2,000件を学習用に抽出し、残りから最大5,000件を評価に回しています。残りがそれより少ない phoneme だけは 3,404 件すべてを評価に使いました。計算時間をそろえるための縮小で、全モデルに同じ分割を渡しています。
この評価件数の処理は、最初の実行で ValueError が出た後に追加したものです。当初のコードが評価用に必ず 5,000 件残ると仮定していたためで、修正後は分割件数と正例の割合を確認してから、すべての条件を最初から実行し直しました。
比較した4条件は次のとおりです。
- EBM(既定):
ExplainableBoostingClassifier()の既定値。特徴量数の3倍を上限として、2特徴量の交互作用項を自動で作る(phoneme は5列なので、作れる10通りすべて) - EBM(加法のみ):
interactions=0とし、特徴量ごとの項だけを使う。交互作用項の効果と計算時間を切り分けるための条件 - LightGBM(既定)
- ロジスティック回帰(標準化つき)
ハイパーパラメータは各ライブラリの既定値を使い、どのモデルもチューニングしていません。片方だけ設定を探して有利にすることを避けるためです。既定から変えたのは次の5点で、モデルの精度を上げるための調整ではありません。
- 乱数の種(seedに合わせる。全モデル共通)
- 1スレッド固定の指定(EBMとLightGBM。時間の計測条件を揃えるため)
- ログの抑制(LightGBM)
interactions=0(加法のみ条件だけ。この条件の定義そのもの)- 反復の上限(ロジスティック回帰。既定のままだと収束の警告が出るため)
標準化はロジスティック回帰の内側でのみ行い、データ分割・seed・評価指標は全条件で共通にしました。
もっとも、「既定値」の中身はモデルごとに異なります。EBM はデータを取り直しながら14回学習し、その結果を平均する仕組みを初期設定で持つ一方、LightGBM は100本の木を最後まで追加し、早期終了を行いません。ここでの処理時間には、この違いも含まれます。GBDT のライブラリ同士を既定値で比べた結果はGBDT3種の実測比較にまとめています。
乱数の初期値は 0 / 1 / 2 の3通りです。合成データの生成、実データの抽出と分割、モデルの初期化まで同じ初期値を使い、合成4条件と実データ3件を合わせて、1モデルにつき21回学習しました。EBM 内部の学習回数を減らすと約3倍速くなることは予備計測で分かっていましたが、精度にも影響しうる設定を EBM だけ変えないため、データ規模と初期値の数を抑えています。
表には、保存した実行ログから計算した3回の平均を載せています。差や増分は丸める前の値から求めたため、表に表示された数値を引いた結果と末尾が1だけ異なる場合があります。初期値が3通りと少ないので統計的検定は行わず、差の向きについては3回すべてで一致したかを確認しました。
読み飛ばし可: 合成データの作り方・データの取得元・時間の計測条件
- 合成データの真のロジットは
3.0 * ( sqrt(1-alpha) * z_add + sqrt(alpha) * z_int )。z_addは x0からx4 の非線形関数の和、z_intは2.0*x0*x1*x2 + 1.5*sign(x3)sign(x4)sign(x5)で、いずれも20万件・seed=12345 の参照サンプルで標準化してから混ぜています。特徴量が独立な標準正規なので、3次の積と符号の積は主効果にも2次交互作用にも射影が0になります。つまりz_intは、加法モデルでも2次交互作用までのモデルでも原理的に表現できない成分です。合成は学習2,000件・評価4,000件で、学習と評価は別のseedで独立に生成しています。 - 実データはPMLB(コミット
7c1f4bdc)から取得し、取得したファイルのSHA256も記録しました。3件とも欠損なしで目的変数は0/1です。PMLB版はカテゴリ変数が整数エンコード済みで、本実験では全モデルに同じ数値行列を渡しています(カテゴリ指定はどのモデルにも与えていません)。 - 学習時間は
fit()の呼び出しだけをtime.perf_counter()で計測しました。OMP・OpenBLAS・MKLのスレッド数を1に設定し、EBMとLightGBMはn_jobs=1、ロジスティック回帰は既定の単一スレッドで実行しています。つまり全モデルを1スレッドに揃えた計測です。
適用範囲と限界
実データの学習件数は2,000件、列数は5〜14列です。EBM の学習時間を考慮して adult の全 48,842 件は使わず、件数や列数だけを変える実験も行っていません。より大きい、または列の多いデータで、精度と学習時間がどう変わるかはこの結果から判断できません。
全モデルを既定値で比べたため、チューニング後にどちらが伸びるかは未検証です。実データのカテゴリ変数も整数へ変換された値のまま渡しており、EBM の feature_types でカテゴリとして明示した場合は結果が変わる可能性があります。
乱数の初期値は3通りだけで、検定や信頼区間は計算していません。差の向きは3回で一致したものの、0.01前後の差を厳密な効果量として扱える実験ではありません。学習時間にも同じマシンで動いていた別処理の影響があるため、秒単位の比較ではなく桁の違いだけを判断材料にしています。
「解釈しやすさ」そのものも測定していません。EBM の項数と LightGBM の木・葉の数は、確認する部品の多さを表す代用指標です。実際の利用者が曲線を理解できるか、その説明が判断に役立つかは、この記事の評価範囲に含まれません。
サンプル実装
サンプル実装は、同じ学習・評価データを EBM と LightGBM へ渡し、ROC-AUC と学習時間を表示します。EBM については、特徴量ごとの項と交互作用項の数、重要度に占める交互作用項の割合、上位3項も出力します。make_classification の行を自分の特徴量 X と 0/1 の正解ラベル y に置き換えれば、同じ手順で比較できます。
検証環境では、1,500件・8列の例でも EBM の学習に 72.3 秒かかりました。計測条件をそろえるため n_jobs=1 で1スレッドへ固定しており、複数コアを使う場合の時間とは異なります。
"""自分のデータで EBM と LightGBM を突き合わせる最小の実装例。

pip install interpret-core lightgbm scikit-learn

EBM は学習が遅い(この例で数十秒)。小規模なデータで所要時間を確認する。
"""
import time

import numpy as np
from lightgbm import LGBMClassifier
from sklearn.datasets import make_classification
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import train_test_split

from interpret.glassbox import ExplainableBoostingClassifier

# ここを自分のデータ(X: 2次元配列/DataFrame、y: 0/1)に差し替える
X, y = make_classification(
    n_samples=1500, n_features=8, n_informative=5, n_redundant=0, random_state=0
)

X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y
)

# n_jobs=1 は計測条件を揃えるため。他の設定はライブラリの既定値のまま
for name, model in [
    ("EBM", ExplainableBoostingClassifier(random_state=0, n_jobs=1)),
    ("LightGBM", LGBMClassifier(random_state=0, n_jobs=1, verbose=-1)),
]:
    t0 = time.perf_counter()
    model.fit(X_tr, y_tr)
    fit_sec = time.perf_counter() - t0
    auc = roc_auc_score(y_te, model.predict_proba(X_te)[:, 1])
    print(f"{name}: AUC={auc:.4f}  学習{fit_sec:.1f}秒")

    # EBM は「どの項をいくつ作ったか」を数えられる
    if name == "EBM":
        imp = np.asarray(model.term_importances())
        is_pair = np.array([len(t) > 1 for t in model.term_features_])
        share = imp[is_pair].sum() / imp.sum()
        print(f"  項の数: 主効果{(~is_pair).sum()} + 2次交互作用{is_pair.sum()}")
        print(f"  重要度に占める交互作用項の割合: {share:.1%}")
        top = np.argsort(-imp)[:3]
        for i in top:
            print(f"  上位項: {model.term_names_[i]} (重要度 {imp[i]:.3f})")
上のコードを quickstart_ebm.py として保存し、必要なライブラリを入れて実行します。
pip install interpret-core==0.7.8 lightgbm==4.7.0 scikit-learn==1.9.0
python quickstart_ebm.py
利用するパッケージを interpret ではなく interpret-core としたのは、検証環境でフル版の依存パッケージをビルドできなかったためです。interpret-core には付属の可視化 UI が含まれませんが、EBM の学習と、コード内で行っている項の読み出しは動作します。検証環境での出力は次のとおりです。
EBM: AUC=0.9788  学習72.3秒
  項の数: 主効果8 + 2次交互作用24
  重要度に占める交互作用項の割合: 51.7%
  上位項: feature_0006 (重要度 1.872)
  上位項: feature_0000 & feature_0006 (重要度 0.941)
  上位項: feature_0001 & feature_0007 (重要度 0.783)
LightGBM: AUC=0.9766  学習0.1秒
このデモには本文と異なる合成データを使っているため、ROC-AUC の値やモデルの順位は本文の結果と比べられません。自分の環境で確認するのは、学習にかかる時間と EBM が作った項の数です。
精度で決まらなかった選択を、何で決めるか
EBM と LightGBM のどちらを選ぶかは、この3データでは精度で決まりませんでした。差は3件とも小さく、向きもデータで入れ替わります。はっきり離れたのは学習時間のほうで、その差は2〜3桁でした。
予想と食い違ったのは、対価が現れた場所でした。実データでは差が小さいと見込んでいたものの、2件で EBM が上回るところまでは予想しておらず、離れたのは待ち時間のほうでした。一方で合成データからは、EBM を検討するときの確認項目が1つ増えました。精度が大きく落ちるなら、3つ以上の特徴量が絡む関係を取りこぼしていないかを疑います。
今回の範囲は、学習2,000件・列数5〜14で、どのモデルも既定値のままです。チューニング後や、もっと大きなデータで同じ関係が続くかは測れていません。EBM にカテゴリ変数を明示した場合も同じです。この3点は手元のデータで確かめる価値があります。