
学習させたモデルに、ある入力の値を少しずつ動かしたら、予測はどう変わるのか。この関係を1本の曲線にして見せる道具が、モデルの中身を確かめるときによく使われます。曲線が右上がりなら、その列が大きいほど予測も上がる、と読むわけです。
代表がPDP(Partial Dependence Plot、部分依存プロット)です。調べたい列だけをいろいろな値へ置き換え、ほかの列はデータのまま残して予測を平均します。scikit-learnから計算でき、モデルの種類を問わず同じ形式の曲線を描けます。
読み取りが怪しくなるのは、その列とよく似た動きをする別の列が一緒に入っているときです。片方が大きい行ではもう片方も大きい、という関係があると、置き換えでできた組み合わせの中に、学習データではほとんど見かけなかったものが混ざります。
対処として挙がるのがALE(Accumulated Local Effects、累積局所効果)です。実際に観測された値の近くで予測がどれだけ動くかを、小さな区間ごとに測って足し合わせます。PDPほど遠くへ値を動かさないぶん、ありえない組み合わせを踏みにくい方法です。
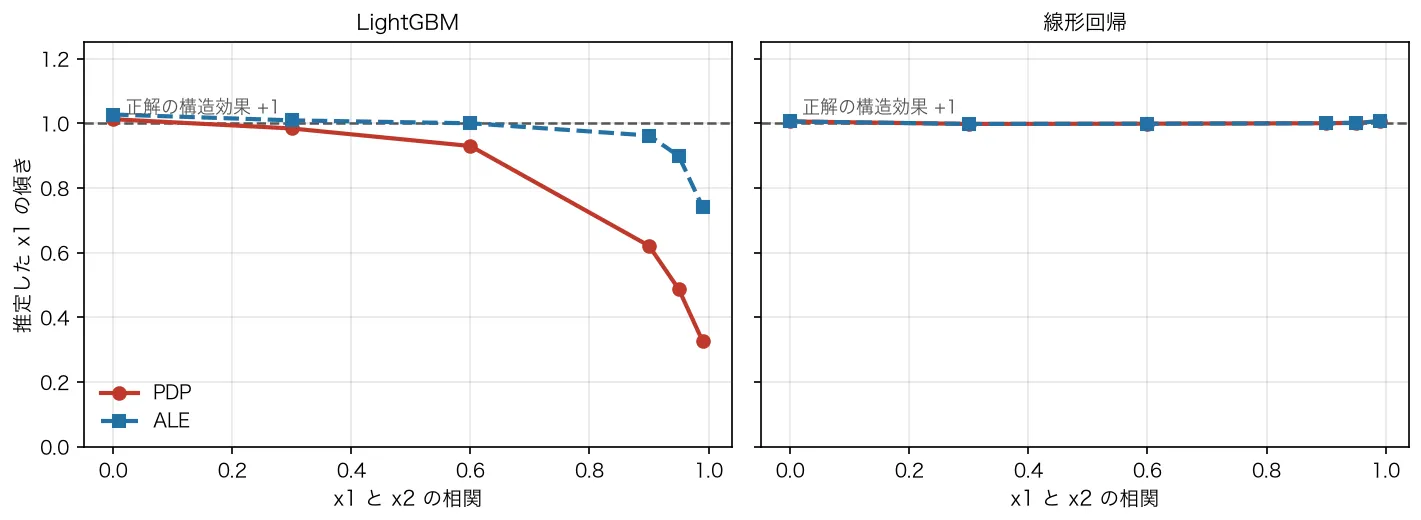
ただし、ALEへ替えれば曲線が正しくなるとは限りません。実データには本当の効果が書かれていないため、2本の曲線を見比べても、どちらが正解に近いかを採点できないのです。そこで、正解を計算で決められる合成データを作り、相関を0から0.99まで上げながら、LightGBMと線形回帰でPDPとALEを比べました。相関0.99まで上げたところで、LightGBMのPDPは+1の効果を正解の3分の1と答えています。
先に結論: 相関0.9を超えるとPDPは正解より小さく出る
- 正解が+1の効果を、LightGBMのPDPは相関0.99で0.3261と見積もった。 正解の約3分の1まで縮む
- 同じ条件のALEは0.7409。PDPよりは正解に近いものの、ALEへ置き換えれば済むとは言えない
- 事前に予想した符号の反転は起きず、PDPもALEも正解と同じ向きを全条件で保った
- ただし読めるのは向きまで。データ上で対象列が大きい行ほど結果も大きいか、という問いにはどちらの曲線も答えない
- 学習データにない組み合わせを見る割合が0.7730まで上がっても、線形回帰のPDPは縮まなかった。 縮み方を決めるのは、PDPの計算方法とモデルの組み合わせ
- 測ったのは加法・線形の合成データ、1条件5,000件、LightGBMと線形回帰の2種。交互作用や実データは範囲の外
PDPとALEは何を入力し、どのような曲線を返すのか
入力はどちらも同じで、学習済みモデルと特徴量データです。返ってくるのも同じ形で、横軸に特徴量の値、縦軸に予測への効果を置いた曲線になります。違うのは、その曲線を作るためにどの範囲の予測を計算するかです。
| 手法 | 曲線の作り方 | 読み取れること | 曲線だけでは分からないこと |
|---|---|---|---|
| PDP | 対象列をグリッド上の値へ置き換え、全行の予測を平均する | ほかの列をデータ中の値に保ったまま、対象列を動かしたときの平均的なモデル応答 | 置き換え後の組み合わせが学習データに存在したか |
| ALE | 対象列を小区間に分け、各区間内での予測差を順に足し合わせる | 観測データの近くで対象列が変わったときのモデル応答 | モデルが本来のデータ生成過程を正しく学べたか |
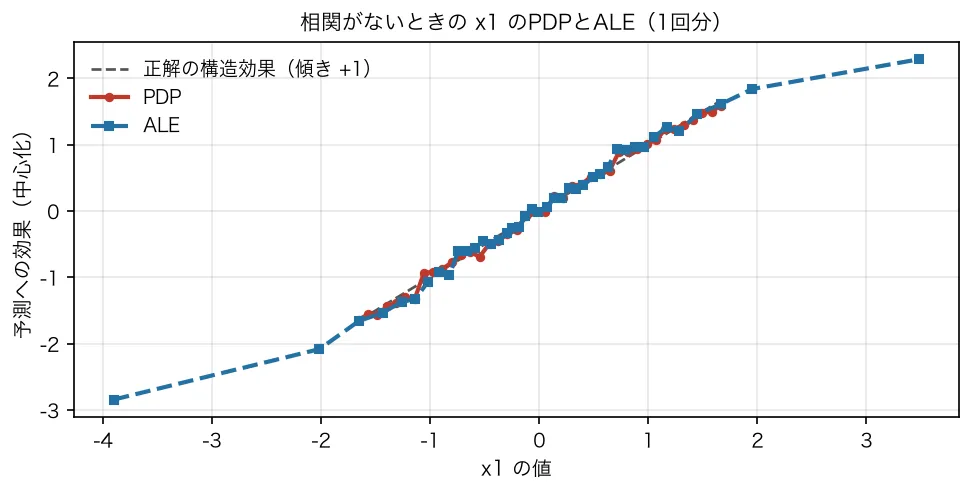
両方に共通するのは、説明の対象が学習済みモデルの反応だという点です。ある特徴量を変えれば現実の結果がどう変化するかという因果効果や、値が大きいデータ同士を比べた差を、そのまま表すわけではありません。この区別が、次に決める採点の基準にも関わってきます。
「対象列の効果」には正解が2つある。採点したのは片方だけ
2本の特徴量x1とx2へ指定した相関を持たせ、結果をy = 1 * x1 - 2 * x2 + 雑音で作りました。関係のない特徴量を3本加え、1条件あたり5,000件を生成しています。
この設計だと、「x1の効果」という言葉が2通りに読めます。
| 確認したいこと | この実験での値 | 意味 |
|---|---|---|
x2を同じ値に保ち、x1だけを1増やしたときの変化(構造効果) | +1 | データを作った式でx1へ設定した効果 |
実際のデータ上で、x1が1大きい行同士を比べた平均差(観測上の効果) | 1 - 2×相関 | x1と一緒に動くx2の影響も含んだ差 |
2つは相関が強いほど離れます。たとえば相関0.9では、構造効果が+1のままなのに対し、観測上の効果は-0.8です。この記事はPDPとALEを構造効果+1にどこまで近づくかで採点しました。観測データ上の関連を知りたい読者にとっては、+1を再現できても問いへの正解になりません。
採点は曲線そのものではなく、x1の5〜95パーセンタイルを直線1本に要約した傾きで行います。傾きが1なら大きさまで一致し、正なら向きが一致している、という読み方です。同じく構造的な寄与を正解に置き、相関する特徴量が重要度の側で何を崩すかはPermutation Importanceとdrop-columnの比較で測っています。
相関は0、0.3、0.6、0.9、0.95、0.99の6水準としました。モデルにはLightGBMと、加法・線形の関係をそのまま表現できる線形回帰を使っています。データ生成と学習の乱数を変えて各条件を5回測り、平均だけでなく試行ごとの範囲も見ました。傾きの当てはめ方やライブラリの設定は、後半の「詳しい検証条件」にあります。
もう1つ、PDPが学習データから離れた組み合わせを評価する割合(以降は外挿割合)も測っています。グリッド上のx1と実データのx2を組み合わせ、x1を決めたときに想定されるx2の範囲から大きく外れた組を数えた値です。PDPの曲線が、見たことのない組み合わせの上にどれだけ乗っているかを表します。
相関を強めると、LightGBMのPDPは正解より寝た直線を描いた
相関を上げていくと、LightGBMで描いたPDPの直線はだんだん寝ていきました。正解の傾きは+1のままなのに、曲線からはそれより小さい効果に見える状態です。
LightGBMを使うなら、相関の強い列のPDPの傾きを「1増えると予測がどれだけ動くか」の値として読むと、効果を小さく見積もることになります。
| 相関 | PDPの傾き | ALEの傾き | 構造効果との誤差(PDP) | 同(ALE) | PDPが外挿領域を見る割合 |
|---|---|---|---|---|---|
| 0.00 | 1.0123 | 1.0268 | 0.0152 | 0.0268 | 0.0027 |
| 0.30 | 0.9837 | 1.0087 | 0.0188 | 0.0116 | 0.0064 |
| 0.60 | 0.9294 | 0.9997 | 0.0706 | 0.0159 | 0.0375 |
| 0.90 | 0.6207 | 0.9619 | 0.3793 | 0.0381 | 0.3360 |
| 0.95 | 0.4865 | 0.8983 | 0.5135 | 0.1017 | 0.5082 |
| 0.99 | 0.3261 | 0.7409 | 0.6739 | 0.2591 | 0.7730 |
差が急に開くのは、相関0.6と0.9の間です。0.6までは正解との差が0.07程度でしたが、0.9では0.38まで広がりました。相関0.99の傾きは正解の約3分の1です。
ALEは同じ0.99でも7割台を保っています。ただし+1には戻っておらず、相関が極端に強い条件ではALEの側にも過小評価が残りました。
5回の試行を並べても、この差は消えません。相関0.90のPDPは0.5712〜0.6641、ALEは0.9101〜0.9968で、範囲が重なりませんでした。0.99でもPDPが0.2895〜0.3717、ALEが0.5844〜0.8557で、やはり離れています。特定の乱数条件だけで生じた差ではない、ということです。
予想していた符号の反転は、60回とも起きなかった
実験の前に立てていたのは、「相関が強いとPDPが効果の向きを反転させ、ALEと符号が食い違う」という見込みでした。これは外れました。PDPとALEの傾きは全60回で正となり、構造効果+1と同じ向きを保ちました。傾きが3分の1まで落ちた相関0.99でも、符号は変わっていません。
向きが合っていたのは、ほかの特徴量を同じ値に保ってx1だけを動かす構造効果に対してです。「x1が大きい行ほどyも大きいか」という観測データ上の関係は、別の話になります。相関0.9での観測上の効果は-0.8ですから、問いを取り違えると向きを逆に読むことになります。
大きさのほうは、向きほど安心できません。PDPの傾きを特徴量どうしの比較に使うと、相関の強い列を小さく評価する可能性があります。
学習データにない組み合わせを同じだけ見ても、線形回帰のPDPは縮まなかった
ここまでの結果は、「PDPは学習データにない組み合わせを評価するから危ない」という説明で片づけたくなります。ところが、データと相関をそのままにしてモデルだけ線形回帰へ替えると、PDPの傾きは1.0前後のまま動きませんでした。
外挿の割合を数えるだけでは足りません。同じ割合でも、モデルによって曲線が縮む場合と縮まない場合があります。
外挿割合はデータとグリッドだけで決まるため、2つのモデルで同じ値になります。相関を上げるとこの割合は0.7730まで上がりました。
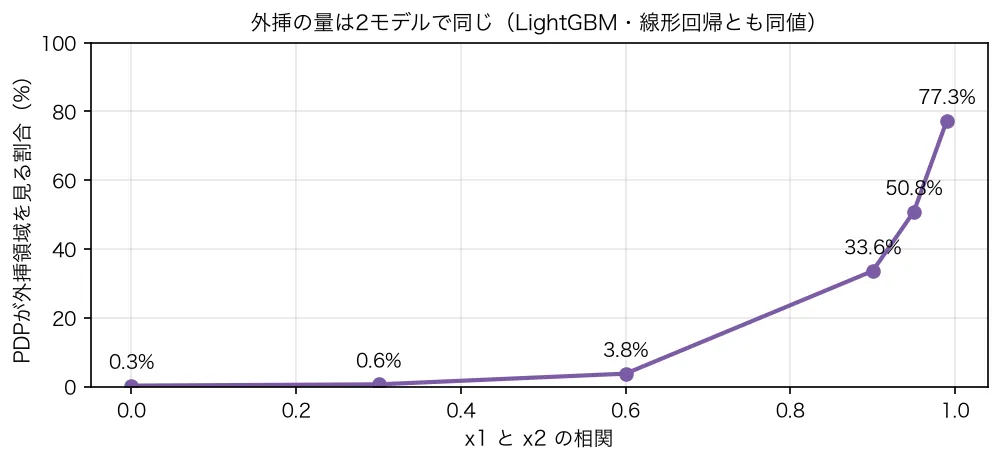
同じ外挿割合に対する線形回帰の結果が、次の表です。
| 相関 | PDPの傾き(5本平均) | 同(1回ごとの範囲) | ALEの傾き | PDPが外挿領域を見る割合 |
|---|---|---|---|---|
| 0.00 | 1.0054 | 0.9875〜1.0195 | 1.0054 | 0.0027 |
| 0.30 | 0.9977 | 0.9789〜1.0186 | 0.9977 | 0.0064 |
| 0.60 | 0.9984 | 0.9734〜1.0252 | 0.9984 | 0.0375 |
| 0.90 | 0.9999 | 0.9501〜1.0517 | 0.9999 | 0.3360 |
| 0.95 | 1.0011 | 0.9305〜1.0736 | 1.0011 | 0.5082 |
| 0.99 | 1.0058 | 0.8480〜1.1660 | 1.0058 | 0.7730 |
PDP列とALE列が全行で同じ値なのは、線形回帰では対象列を動かしたときの応答がどこでも一定だからです。曲線の作り方が違っても、同じ傾きの直線に行き着きます。
平均が正解に張りついている一方で、1回ごとの傾きは相関0.99で0.8480〜1.1660まで散っています。系統的に小さく出ることと、1回の推定が安定していることは別で、線形回帰で満たされたのは前者だけでした。
では原因はモデルの側にあるのかというと、そこも1つに絞れません。LightGBMを固定してPDPからALEへ替えると、相関0.90の傾きは0.6207から0.9619へ近づきます。同じモデルでも計算方法を変えれば結果が動くわけで、モデルだけを犯人にはできないのです。
確認できたのは、PDPの計算方法とモデルの応答の組み合わせによって減衰量が変わる、というところまでです。LightGBMが外挿領域で返した値なのか、相関する列への効果の割り当てなのか、その両方なのかは分離できていません。ALEも相関0.99で0.7409まで落ちたため、外挿だけに原因を絞る根拠もありません。
手元のデータでPDPとALEを確認する順番
最初に決めるのは手法ではなく、知りたい効果のほうです。 ほかの特徴量を同じ値に保ったモデル応答を見たいのか、データ上の平均的な関連を見たいのか。PDPとALEが読めるのは前者だけで、観測上の関連や因果効果を直接返す道具ではありません。
曲線を描く前に、対象列とほかの列の相関を見ておきます。 ただし相関0.6や0.9を固定の判定基準には使えません。今回の水準は比較条件の一例で、実務のしきい値として流用できるものではないからです。
PDPの傾きをそのまま効果量として報告するなら、先に同じモデルでALEも描く。 相関0.90のLightGBMでは、PDPが0.62、ALEが0.96で、5回の試行の範囲も重なりませんでした。差が大きければ、PDPの数値を効果の大きさとして使わない判断になります。
曲線1本で安定性まで決めない。 学習データや乱数条件を変えて描き直します。今回の線形回帰は平均こそ+1付近でしたが、試行ごとの幅は広がりました。
PDPとALEが大きくずれた列は、単独で解釈できるかを疑います。 相関する列を個別に読むのが難しければ、削除や統合も選択肢に入ります。その場合も解釈図だけで決めず、モデル性能への影響を別に評価します。
詳しい検証条件
本線で使った傾きは、区間内の曲線に最小二乗で当てはめた直線の係数です。表の誤差は各試行で|傾き - 1|を計算してから5回で平均しているため、平均傾きと1との差とは一致しない場合があります。
外挿領域の判定に使ったしきい値は3標準偏差です。x1を決めたときのx2は平均が相関×x1、標準偏差がsqrt(1 - 相関^2)の正規分布に従うので、そこから3標準偏差を超えた組を外挿として数えました。モデルの予測値は一切使いません。
モデルと集計の詳しい条件
- LightGBMは木300本、学習率0.05、
n_jobs=1です。線形回帰はscikit-learnのLinearRegressionを使いました。 - PDPはscikit-learnの
partial_dependence、ALEはPyALE 1.2.0で計算し、グリッド数は40です。 - 相関6水準 × 乱数5条件 × モデル2種の60回を記録しました。
- 数値は小数第4位まで丸めています。
適用範囲と限界
- 加法・線形の生成過程に限った結果です。 交互作用や非単調な関係を入れたときに、符号の反転や曲線の局所的な変化が起きるかは検証していません。
- 曲線を傾き1本へ要約しています。 区間ごとに向きが変わる曲線では、同じ採点方法を使えません。
- 採点したのは
x1の傾きだけです。 PDPが相関の強い列を小さく評価した結果、特徴量の順位が実際に入れ替わるかは測っていません。 - 相関させたのは2変数だけです。 3列以上の相関、多重共線性、カテゴリ変数、欠測値は対象外です。
- モデルはLightGBMと線形回帰の2種類です。 ほかの木モデルやニューラルネットワークが同じ変化を示すかは分かりません。LightGBMの設定も1通りに固定しています。
- 係数の比、雑音、サンプル数も固定しました。
x2の効果はx1の2倍、雑音の標準偏差は1、1条件5,000件です。記事内の相関水準を実務上のしきい値として流用できません。 - LightGBMで減衰した原因は分離できていません。 外挿領域での予測と、相関する列への効果の割り当てを別々に検証する実験は行っていません。
相関を変えてPDPとALEを採点するコード
次のコードは、相関を変えた合成データを入力としてLightGBMと線形回帰を学習し、PDPとALEの傾き、構造効果+1との誤差、外挿割合を出力します。どの実データでも使える診断関数ではなく、本文の比較を再現するための実装です。
"""相関する特徴量のもとで PDP と ALE が何を復元するかを、正解つきで採点する。

生成過程: y = 1*x1 - 2*x2 + eps、(x1, x2) の相関を rho で操作する。
正解は2つある。
  構造効果   : x2 を止めて x1 を1動かしたときの変化 = +1(rho によらない)
  観測上の効果: x1 が1大きい個体の平均的な差 = 1 - 2*rho(rho>0.5 で符号が反転)
どちらへ寄るか、そして PDP がデータの無い領域を見る割合を測る。
実行: python sample_pdp.py (所要 3 分程度)
"""

import numpy as np
import pandas as pd
from lightgbm import LGBMRegressor
from PyALE import ale as pyale
from sklearn.inspection import partial_dependence
from sklearn.linear_model import LinearRegression

B1, B2, N, GRID = 1.0, -2.0, 5000, 40
RHOS = [0.0, 0.3, 0.6, 0.9, 0.95, 0.99]
SEEDS = [0, 1, 2, 3, 4]
FEATURES = ["x1", "x2", "z1", "z2", "z3"]


def make_data(rho, seed):
    rng = np.random.default_rng(seed)
    x12 = rng.multivariate_normal([0.0, 0.0], [[1.0, rho], [rho, 1.0]], size=N)
    X = pd.DataFrame(np.column_stack([x12, rng.normal(size=(N, 3))]), columns=FEATURES)
    y = B1 * X["x1"] + B2 * X["x2"] + rng.normal(0, 1.0, N)
    return X, y.to_numpy()


def slope(xs, ys, lo, hi):
    """曲線の傾きを最小二乗で直線1本に要約する。"""
    m = (xs >= lo) & (xs <= hi)
    A = np.column_stack([xs[m], np.ones(m.sum())])
    return float(np.linalg.lstsq(A, ys[m], rcond=None)[0][0])


def offmanifold(X, grid_x1, rho):
    """PDP が評価する (グリッドの x1, 実データの x2) の組のうち、
    実際の分布から外れている割合。x1 を与えたときの x2 は
    平均 rho*x1・標準偏差 sqrt(1-rho^2) なので、3標準偏差超えを外と数える。"""
    sd = np.sqrt(max(1e-12, 1.0 - rho**2))
    x2 = X["x2"].to_numpy()
    off = sum(int((np.abs(x2 - rho * g) > 3.0 * sd).sum()) for g in grid_x1)
    return off / (len(grid_x1) * len(x2))


rows = []
for rho in RHOS:
    for seed in SEEDS:
        X, y = make_data(rho, seed)
        lo, hi = np.percentile(X["x1"], [5, 95])
        for name, model in (
            ("LightGBM", LGBMRegressor(n_estimators=300, learning_rate=0.05,
                                       verbose=-1, random_state=seed, n_jobs=1)),
            ("LinearRegression", LinearRegression()),
        ):
            model.fit(X, y)
            pdp = partial_dependence(model, X, features=["x1"],
                                     grid_resolution=GRID, kind="average")
            gx = np.asarray(pdp["grid_values"][0], dtype=float)
            a = pyale(X=X, model=model, feature=["x1"], grid_size=GRID,
                      include_CI=False, plot=False)
            rows.append({
                "モデル": name, "rho": rho,
                "PDPの傾き": slope(gx, np.asarray(pdp["average"][0], dtype=float), lo, hi),
                "ALEの傾き": slope(np.asarray(a.index, dtype=float),
                                 np.asarray(a["eff"], dtype=float), lo, hi),
                "外挿割合": offmanifold(X, gx, rho),
            })
    print(f"rho={rho} 完了", flush=True)

d = pd.DataFrame(rows)
d["構造効果との誤差(PDP)"] = (d["PDPの傾き"] - B1).abs()
d["構造効果との誤差(ALE)"] = (d["ALEの傾き"] - B1).abs()
d["符号が正解と一致(PDP)"] = np.sign(d["PDPの傾き"]) == np.sign(B1)

print(f"\n正解の構造効果は rho によらず {B1:+.0f} / シード{len(SEEDS)}本の平均")
print(d.groupby(["モデル", "rho"]).mean(numeric_only=True).round(4).to_string())
線形回帰を対照として残す理由
LightGBMだけを実行すると、外挿割合の上昇とPDPの傾き低下が同時に起きたことしか分かりません。同じデータとPDPを線形回帰でも試すことで、外挿割合が同じでも系統的な過小評価が起きない条件と比較できます。
PyALEは実行時にContinuous feature detected.という情報ログを出します。x1を連続値として扱ったことを知らせる表示で、エラーではありません。
本文の表はIntel XeonとLinuxによる実測です。次の出力はApple M1、macOS、Python 3.11.15で再実行した結果です。LightGBMの傾きが相関0.99で0.3261まで落ちるところも、線形回帰の6行がいずれも0.99〜1.01に収まるところも、そのまま再現しました。
実行結果
正解の構造効果は rho によらず +1 / シード5本の平均
                       PDPの傾き  ALEの傾き    外挿割合  構造効果との誤差(PDP)  構造効果との誤差(ALE)  符号が正解と一致(PDP)
モデル              rho
LightGBM         0.00  1.0123  1.0268  0.0027         0.0152         0.0268            1.0
                 0.30  0.9837  1.0087  0.0064         0.0188         0.0116            1.0
                 0.60  0.9294  0.9997  0.0375         0.0706         0.0159            1.0
                 0.90  0.6207  0.9619  0.3360         0.3793         0.0381            1.0
                 0.95  0.4865  0.8983  0.5082         0.5135         0.1017            1.0
                 0.99  0.3261  0.7409  0.7730         0.6739         0.2591            1.0
LinearRegression 0.00  1.0054  1.0054  0.0027         0.0103         0.0103            1.0
                 0.30  0.9977  0.9977  0.0064         0.0101         0.0101            1.0
                 0.60  0.9984  0.9984  0.0375         0.0135         0.0135            1.0
                 0.90  0.9999  0.9999  0.3360         0.0308         0.0308            1.0
                 0.95  1.0011  1.0011  0.5082         0.0453         0.0453            1.0
                 0.99  1.0058  1.0058  0.7730         0.1065         0.1065            1.0
線形回帰の「1回ごとの範囲」は平均前の5値から求めた値なので、この集計出力には出てきません。
相関する列では、PDPとALEを両方描いてから読む
PDPとALEを選ぶ前に決めることがあります。知りたいのがモデルの構造的な応答なのか、観測データ上の関連なのかです。後者であれば、どちらの曲線もそのまま答えになりません。
構造的な応答を読む場合、今回のLightGBMではALEのほうが正解に近くなりました。それでも相関0.99ではALEに過小評価が残っています。相関する列があればALEへ機械的に置き換えるのではなく、同じモデルで両方の曲線を描き、データを変えたときの安定性まで確認するのが、この実測から言える判断です。記事内の相関0.6や0.9を一般的なしきい値にはせず、手元のモデルとデータで差を測ることになります。
まだ測れていないのは、交互作用や非単調な関係を入れたときの挙動です。今回は加法・線形の生成過程だけを使ったため、曲線の一部だけ向きが変わるような崩れ方は捉えられません。次に確かめたいのはそこで、事前の予想が外れた理由が設計の単純さにあった可能性も、まだ残っています。