
テーブルデータのところどころが空欄(欠損値)になっていると、多くのモデルはそのままでは学習できません。手っ取り早いのは、その列の平均か中央値をまとめて入れて穴を埋めてしまうやり方です。実際、最初に書くコードはたいていこれになります。
一方でscikit-learnには、他の列の情報を使ってもっと丁寧に埋める道具も入っています。近い行を探して埋める KNNImputer と、列どうしの回帰を繰り返して埋める IterativeImputer(MICE)です。「単純な穴埋めより、他の列の情報を使って埋めた方がよい」という助言もよく見かけます。手元のコードをそちらへ書き換えるかどうかは、判断の分かれるところです。
補完手法の紹介では、埋めた値がどれだけ正確かが物差しになります。ただ、実務で効いてほしいのはその先です。丁寧に埋めたぶん、最後に出てくる予測精度はどれだけ上がるのでしょうか。KNNImputer は全行との距離を計算するので、軽い処理でもありません。そこで、平均や中央値の単純な穴埋めから、補完せずそのまま渡す選択肢まで、6通りを同じ土俵に乗せて測りました。
先に結論
- 中央値補完から
KNNImputerや MICE へ替える価値を決めるのは、補完手法よりも、そのあとに学習する予測モデル(下流モデル)。補完はそのままで下流だけを線形モデルからLightGBMに替えると、中央値補完との差は公開データ2種(magicとwind)でそれぞれ5.4倍、4.0倍縮む - 効くことがあるのは線形モデルと距離ベースのモデルで、LightGBMではほとんど動かない。「もっと正確に埋めれば下流の精度も上がる」も、今回測った範囲のLightGBMでは成り立たず。埋めた値の誤差を3割以上減らしても、得点はほぼそのまま
- 手の込んだ手法が理屈どおりに効くとも限らない。MICEは、想定どおり効くはずのMAR(他の列の値で欠けやすさが決まる欠損)でかえって中央値補完を下回り、追試でも原因は特定できなかった。どのデータで効くかを回す前に見当づける手がかりも、今回の範囲では見つからず
- 迷ったらまず中央値補完。LightGBMなら補完せずNaNのまま渡す手もある。
KNNImputerは中央値補完の100倍以上の時間がかかるので、線形モデルや距離ベースのモデルを使うときに絞る - 当てはまる範囲は、連続値だけの2データセット(magicとwind、各4,000件・10〜11列)に欠損を人工的に注入した実測。下流モデルはロジスティック回帰とRidge・LightGBM・k近傍法の3系統
比べた6通りの埋め方と、欠け方の3分類
比べた埋め方は6通りです。名前は違っても、違うのは「空いたセルに何を入れるか」の一点だけなので、そこだけ押さえれば表は読めます。
SimpleImputerの平均と中央値: 列ごとの代表値で埋める、最も素朴なやり方です。この記事では中央値補完を基準に置きます。SimpleImputerのadd_indicator=True: 中央値で埋めたうえに「その値はもともと欠けていた」という0/1の列(欠損フラグ)を足してくれます。KNNImputer: 欠けている行に似た行を近傍から探し、その値の平均で埋めます。IterativeImputer(MICE): 欠けている列を他の列から回帰で予測して埋める操作を、列を替えながら繰り返します。- LightGBMのネイティブ欠損処理: 補完そのものを省く選択肢です。NaNを渡すと、分岐のたびに欠損値を左右どちらへ送るかを学習します。
欠け方の呼び分けも先に置いておきます。この分野では3つに分けて扱うのが定石で、MCAR は完全にでたらめに欠ける場合です。MAR は他の列の値によって欠けやすさが決まる場合で、ある観測所の風速が強い日は別の観測所の記録が落ちやすい、といった形を指します。MNAR は欠けている列自身の値で欠けやすさが決まる場合で、大きい値ほど記録されにくい、といった形です。
精度は、分類が ROC-AUC(正例を負例より上位に並べられる度合いを0から1で表す指標。高いほど良い)、回帰が RMSE(予測が実測からどれだけ外れたかの平均的な大きさ。低いほど良い)で測りました。
性格の違う2つのデータで、埋め方だけを差し替えて測った
使ったデータは性格の違う2つです。magicは大気チェレンコフ望遠鏡の観測像からガンマ線と背景ノイズを見分ける2値分類で、連続値10列を使います。windはアイルランドの12観測所の日次風速から、ある観測所の風速を当てる回帰で、こちらは連続値11列。どちらもPMLBから取得し、固定シードで4,000件に部分抽出しました。
2つとも元データに欠損がありません。だからこそ「どこがどう欠けたか」を設計して注入し、欠損なしの状態を基準に使えます。列数の多いデータ(58列)も取得しましたが、MICEの計算が重くなるため今回は見送りました。
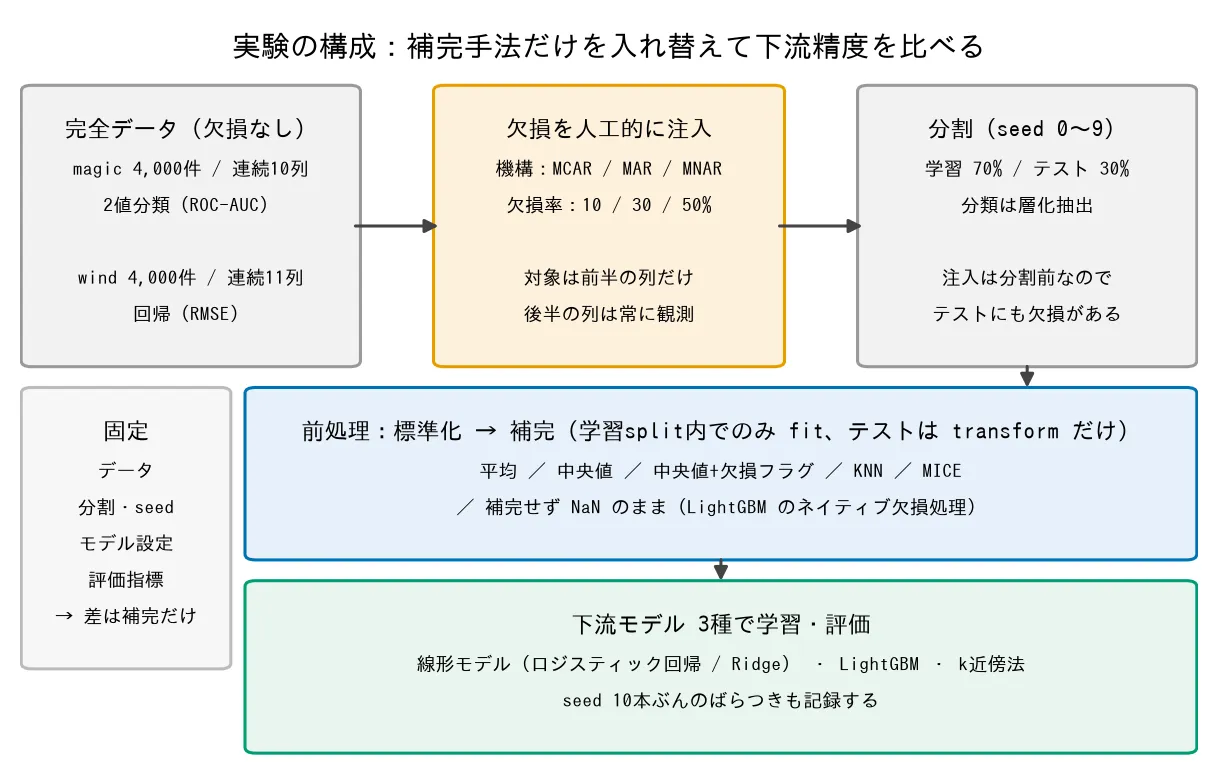
振った条件は、補完6通り × 下流モデル3系統 × 欠損機構3種 × 欠損率3水準 × データ分割のシード10本です。下流モデルは、ロジスティック回帰とRidgeによる線形モデル、LightGBM、k近傍法。補完のルールは学習データ側だけで決め、テスト側にはそれを当てはめるだけにしています。
着手する前の予想はこうでした。MICEは「他の列の値によって欠けやすさが決まる」タイプの欠損を想定した手法だと理解していたので、その条件で最も効くだろう、と。回してみると、そこがいちばん当たりませんでした。
なお、この記事のMICEは複数回の補完を統合する本来の多重代入ではなく、1回の補完結果をそのまま下流へ渡す使い方です。欠損の作り方や差の判定手続きは、後半の「詳しい検証条件」にまとめました。
効き目を決めていたのは、補完手法ではなく下流モデルだった
同じ補完手法でも、そのあとに何を置くかによって、効いたり効かなかったりします。順序としては、まず下流モデルを決め、それから補完に手間をかけるかを考えるのが実際的でした。ここから3つの角度で見ていきます。
線形モデルで開いた差が、LightGBMでは4倍から5倍縮んだ
下の表は、KNNImputer とMICEを中央値補完と比べた18セル(機構3 × 欠損率3 × 2手法)の集計です。magicはROC-AUC、windはRMSEの差で、どちらも正なら中央値補完より良いという向きに揃えてあります。中央値は向きを外して大きさだけを見た値で、最大と最小は符号をつけたままの値です。「差を確認できたセル」は、シード10本から求めた95%信頼区間が0を跨がなかったセルを指します。
| データ / 下流モデル | 差が正のセル | 差を確認できたセル(向きは問わない) | 差の大きさの中央値(絶対値) | 差の最大(符号つき) | 差の最小(符号つき) |
|---|---|---|---|---|---|
| magic / 線形モデル(ROC-AUC) | 13/18 | 15/18 | 0.0079 | +0.0232 | -0.0182 |
| magic / LightGBM(ROC-AUC) | 9/18 | 5/18 | 0.0015 | +0.0035 | -0.0078 |
| magic / k近傍法(ROC-AUC) | 14/18 | 10/18 | 0.0034 | +0.0066 | -0.0043 |
| wind / 線形モデル(RMSE) | 18/18 | 18/18 | 0.0555 | +0.0873 | +0.0284 |
| wind / LightGBM(RMSE) | 13/18 | 5/18 | 0.0139 | +0.0407 | -0.0151 |
| wind / k近傍法(RMSE) | 17/18 | 16/18 | 0.0482 | +0.0936 | -0.0140 |
補完はそのままで下流だけを線形モデルからLightGBMに替えると、差の大きさは4倍から5倍以上縮みます(magicで5.4倍、windで4.0倍)。いちばん一貫していたのはwindの線形モデルで、機構と欠損率をまたいで18セルすべての符号が正に揃いました。単一のセルの差の大きさより、この揃い方を強い証拠だと考えています。
対するLightGBMの差の大きさ(中央値)は、magicで0.0015 ROC-AUC、windで0.0139 RMSEでした。欠損なしで学習したLightGBMの値がmagic 0.9200、wind 3.5269なので、それぞれ0.2%と0.4%にあたります。つまりLightGBMでは、補完手法の選択は欠損なしスコアの0.2〜0.4%を動かす程度の判断になります。
距離ベースのk近傍法は、その中間に落ち着きました。windでは16セルで差を確認できて線形モデルに近い一方、magicでは差が正のセルが14あっても、確認できたのは10セルどまりです。手の込んだ補完が効きやすい側のモデルではあるものの、windほど揃ってはいません。
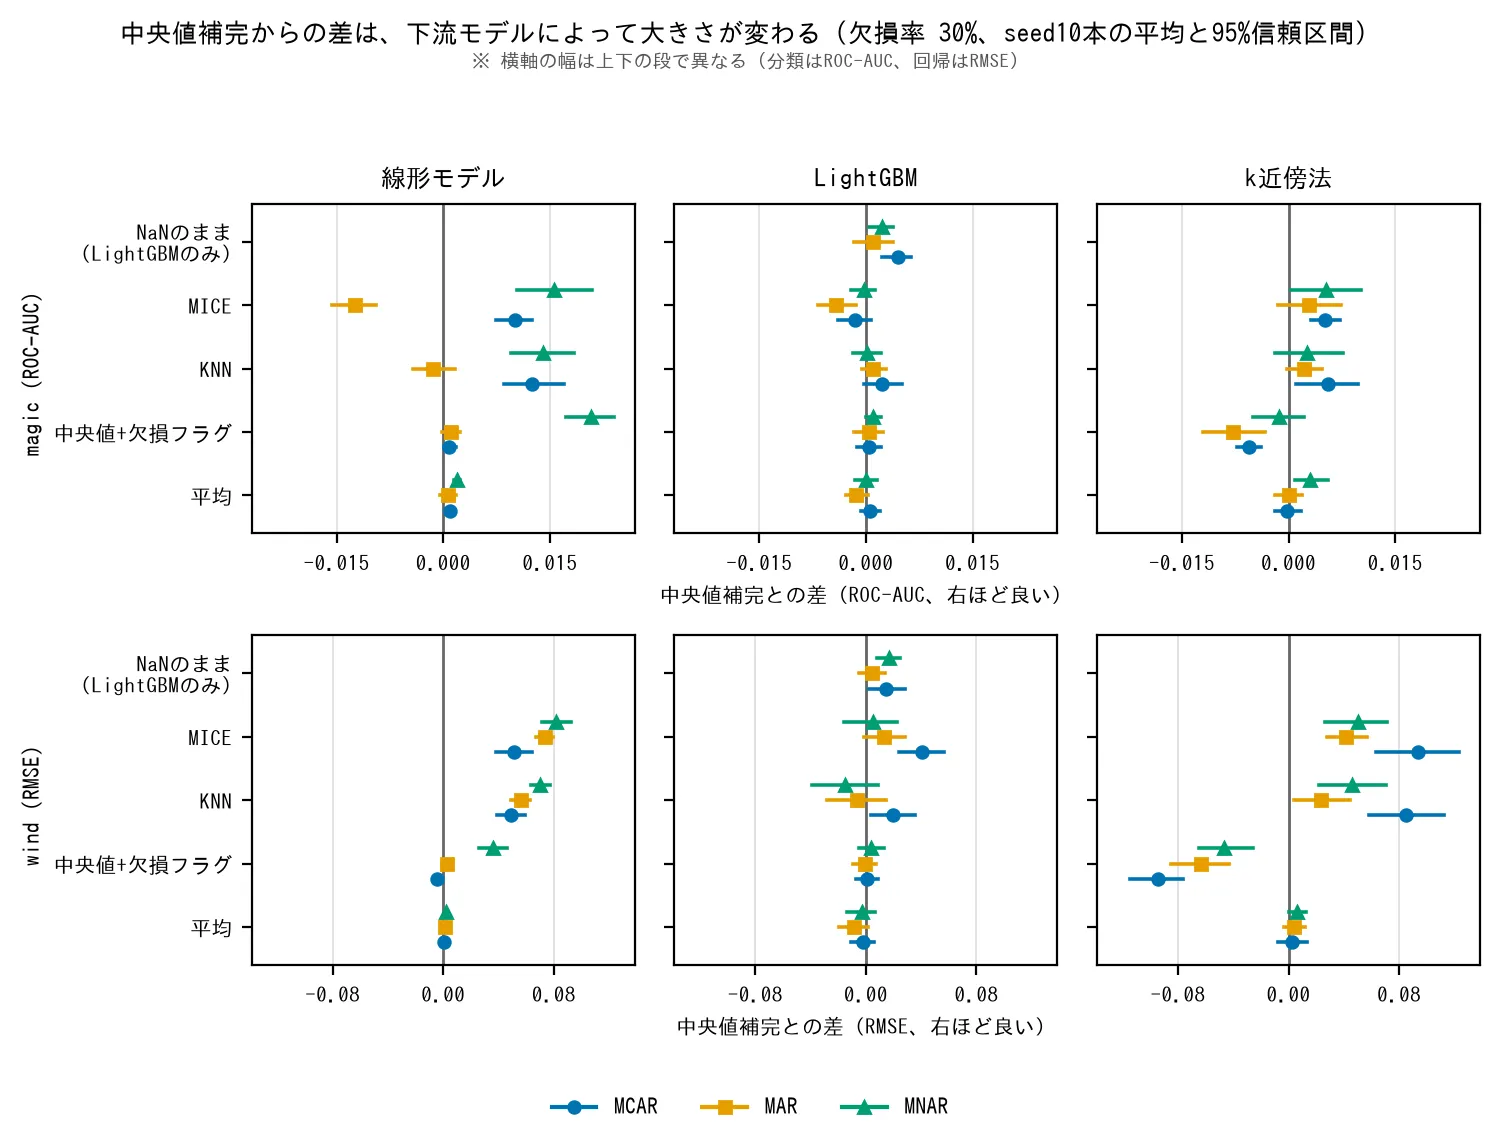
この図は一度作り直しています。最初はパネルごとに横軸が自動で決まっていて、LightGBMのごく小さい差が線形モデルの差と同じ幅で描かれていました。それでは「LightGBMでも同じくらい差がある」と読めてしまいます。行の中で横軸を共有する形に直しました。
モデルで差が変わる理由は、値の使い方にあります。線形モデルは各行の値をそのまま係数に掛けるので、埋めた値のずれが予測へ直接乗ります。一方の決定木は特徴量を閾値で切って使うため、埋めた値が多少ずれても分岐の振り分けが変わらない場面が多いのだと考えられます。ここは実測から導いた解釈で、機序そのものを測ったわけではありません。
限定もはっきりしています。magicの線形モデルは18セル中13セルでしか正にならず、「線形モデルなら手の込んだ補完が効く」とまでは言えません。データによります。
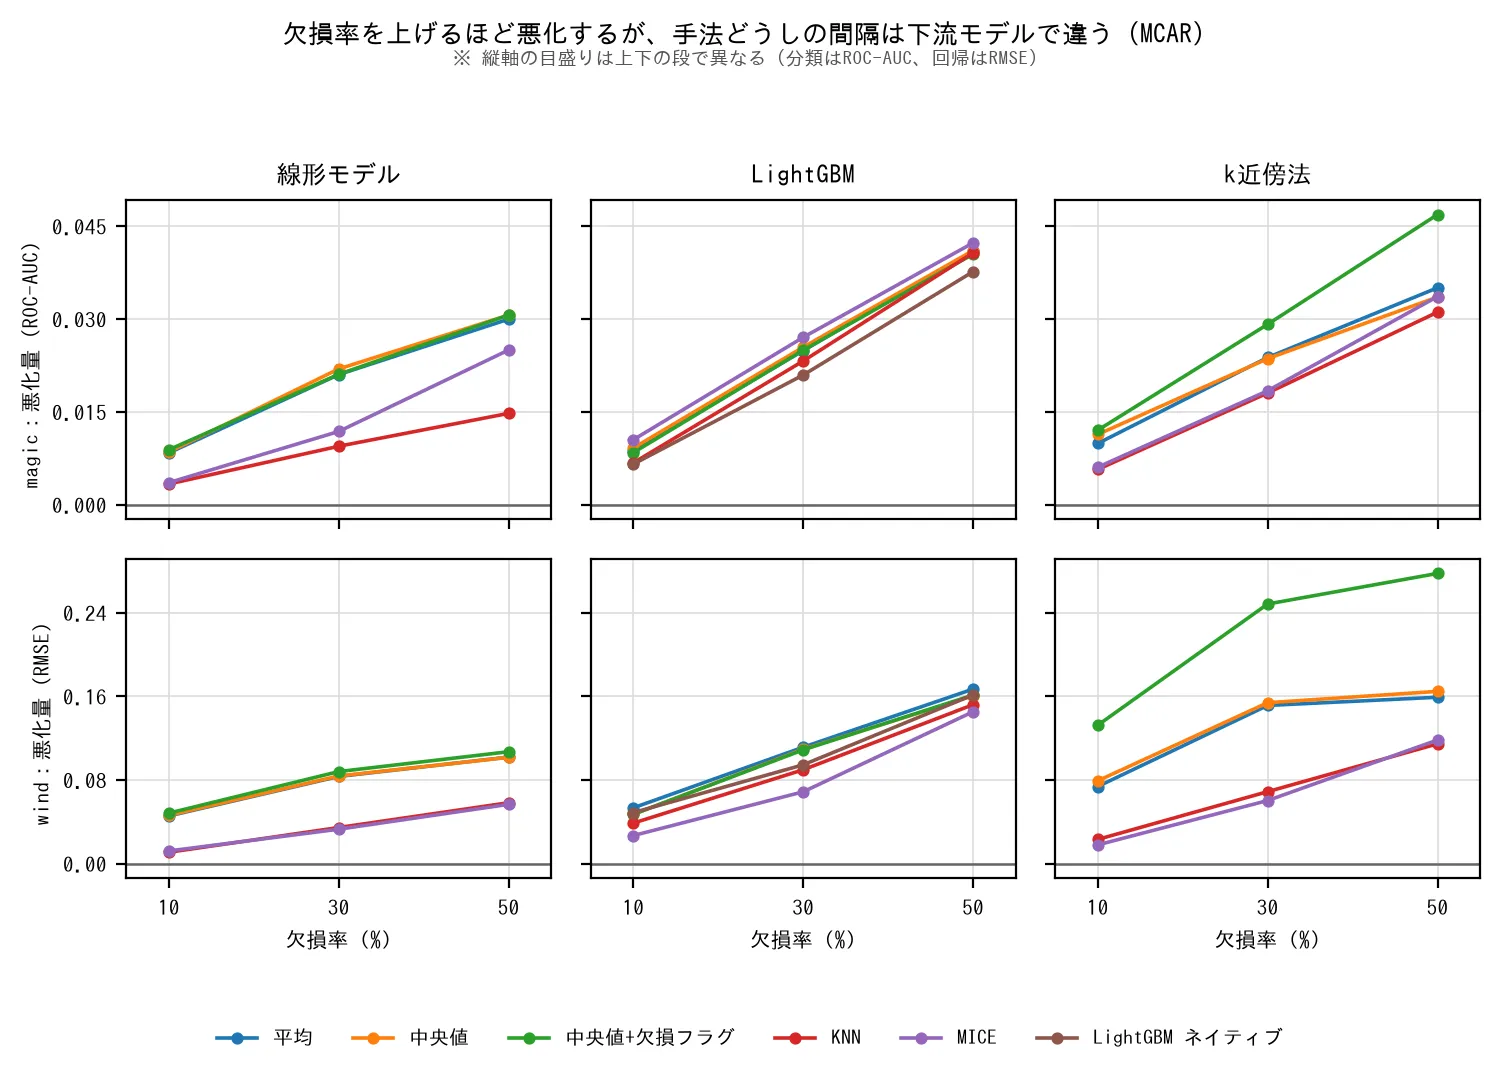
欠損率を上げても、この構図は変わりませんでした。次の図はMCARの場合です。欠損率を10・30・50%と上げると、どのデータ・どの下流モデルでも欠損なしからの悪化は広がります。それでもLightGBMのパネルでは、どの欠損率でも6手法の線が束になったままでした。
埋め方を替えても、LightGBMでは失った分の6割までしか戻らない
補完手法を選ぶことで、欠損で失った分をどれだけ動かせるのか。中央値補完を使ったときの悪化量を分母、手法を替えたときに動く幅(最良の手法と最悪の手法の差)を分子にした比を出しました。この比を手法選択で動く幅の比と呼びます。たとえば欠損によって0.02下がった条件で、最良の手法と最悪の手法の差が0.01なら0.5です。
これを2データ × 機構3 × 欠損率3 × モデル3の全54条件で取りました。下流モデル1つあたりは、2データ × 機構3 × 欠損率3 = 18条件です。
手法選択で動く幅の比は、LightGBMでは18条件すべてで0.6倍未満でした。埋め方をどう替えても、取り返せるのは多くて失った分の6割まで、ということです。一方、線形モデルとk近傍法には1倍を超える条件があり、最大は2.088倍(magicのMAR・50%欠損)。そこでは手法選びが、欠損そのものの損失より大きく効いています。
読み飛ばし可: 手法選択で動く幅の比の全範囲と、比べた手法数の非対称
- 54条件での範囲は、LightGBMが0.083から0.574、線形モデルが0.373から2.088、k近傍法が0.334から1.446です。中央値はそれぞれ0.267、0.662、0.599でした。
- この比が3モデルの中で最も小さかったのは、LightGBMの18条件のうち17条件です(例外はmagicのMNAR・50%欠損)。線形モデルとk近傍法のどちらが大きいかは条件によって入れ替わるので、3者の順位までは言えません。
- 分子は各条件で使える手法すべての最大と最小の差なので、NaNのまま渡す条件を持つLightGBMだけ6手法、他は5手法という非対称があります。3モデル共通の5手法で測り直すとLightGBMの比はさらに小さくなり(最小0.083が0.044、中央値0.267が0.218)、向きは変わりません。
補完の誤差を3割以上減らしても、LightGBMの得点はほとんど伸びなかった
予想と食い違ったのはここです。KNNImputer とMICEは、埋めた値そのものの誤差を中央値補完より確かに減らしています。30%欠損での削減率は次のとおりで、どの組み合わせでも36%以上減りました。
| データ / 欠損機構 | KNNの誤差削減 | MICEの誤差削減 |
|---|---|---|
| magic / MCAR | 53.6% | 49.4% |
| magic / MAR | 50.2% | 36.5% |
| magic / MNAR | 44.0% | 36.3% |
| wind / MCAR | 51.4% | 55.5% |
| wind / MAR | 60.9% | 66.3% |
| wind / MNAR | 52.9% | 59.3% |
それなのに、同じ実行で得た下流LightGBMの得点は、中央値補完から0.0015 ROC-AUC(magic)しか動きません。埋め方の正確さと最終的な精度が、連動しなかったということです。
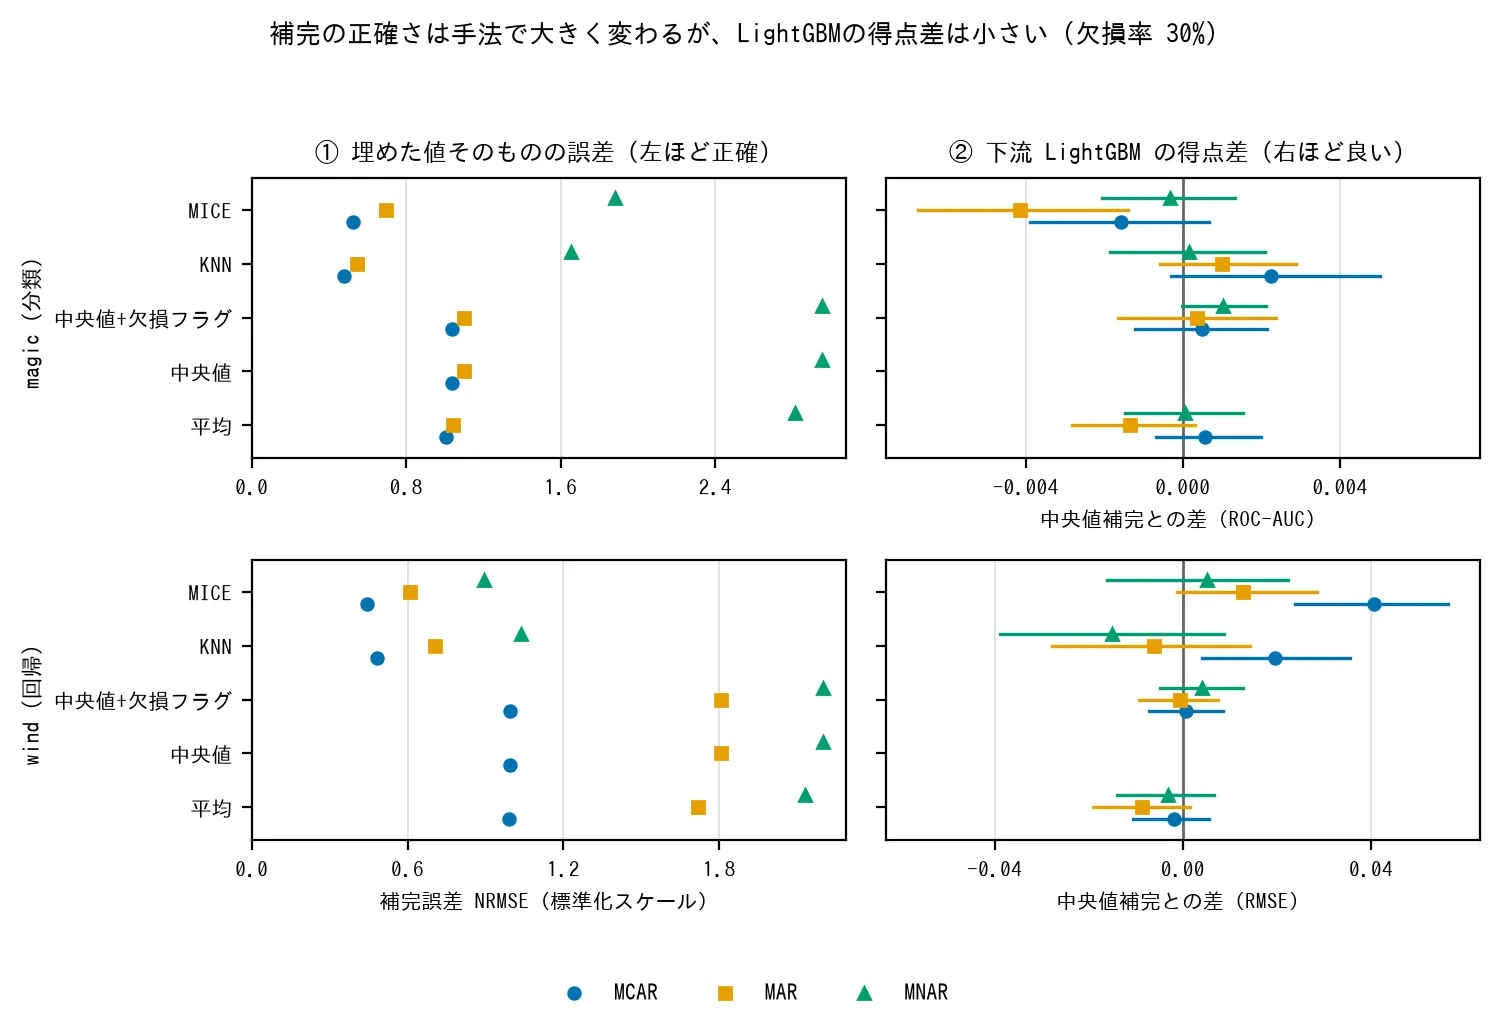
この2つの見方を同じ実行の中で並べられたことが、今回いちばん重く見た証拠です。「LightGBMで差が小さいのは、埋め方が甘いからでは」という疑いに、実測で答えられるからです。少なくともLightGBMについては、補完の精度を上げる方向に労力を注いでも見返りは小さいと考えてよさそうです。この読みが届く範囲は、今回の2データセット・4,000件規模までです。
「もともと得点が高いから動く余地がないだけでは」も確かめました。magicのLightGBMは欠損なしで0.9200なので、天井に近くて動きようがない、という見方はありえます。そこで欠損そのものが奪う量を線形モデルと比べたところ、MCARの30%欠損ではLightGBMの方が大きく失っていました(magicで0.0255対0.0219、windで0.1093対0.0838)。欠損の影響を受けていないのではなく、受けた損失を補完手法の選択では取り返せない、という読み方になります。
もっとも、この向きが出るのは18条件のうち11条件です。magicのMNARでは3つの欠損率とも線形モデルの方が大きく失っているので、ここはMCARに限った話として受け取ってください。
欠損の出方が変わると、最も効く手法が入れ替わった
同じデータ・同じモデルでも、欠損の出方が変わると最も効く手法が入れ替わりました。次はmagicの線形モデル、欠損率30%での中央値補完との差です(列ごとの最大値を太字にしています)。
| 補完手法 | MCAR | MAR | MNAR |
|---|---|---|---|
| 平均 | +0.0009 | +0.0006 | +0.0020 |
| 中央値+欠損フラグ | +0.0009 | +0.0010 | +0.0208 |
| KNN | +0.0125 | -0.0014 | +0.0140 |
| MICE | +0.0101 | -0.0124 | +0.0156 |
MNARで最も効いたのは中央値+欠損フラグでした。中央値補完との差は、欠損率10%で+0.0246、30%で+0.0208、50%で+0.0130です。値が大きい行ほど欠けるという設定なので、「欠けたという事実」そのものが予測に効く情報を持ちます。フラグ列はそれを線形モデルに直接渡す働きをします。同じmagicの線形モデルでも、MCARでは3水準ともプラスマイナス0.001以内。こちらはほとんど動きませんでした。
予想が外れたのはMAR × MICEです。MICEはMARを想定した手法だと理解していたので、この組み合わせで最も効くと考えていました。実際には中央値補完を下回り、しかも欠損率を上げるほど悪化が広がりました(10%で-0.0036、30%で-0.0124、50%で-0.0182)。同じmagicの線形モデルでもMCARとMNARでは正なので、機構によって符号が反転しています。
原因として、条件付き平均で埋めると値のばらつきが潰れるのではないかと考えました。そこで sample_posterior=True(事後分布からサンプルする設定)で測り直したところ、全54条件のうち52条件で既定より悪化。magicの線形モデル × MARも、30%欠損で-0.0124から-0.0200へと悪化が広がりました。この推測は支持されず、原因は特定できていません。手の込んだ手法が理屈どおりの条件で効くとは限らない、という実例として残しておきます。
中央値+欠損フラグにも死角がありました。距離ベースのモデルには不利で、windのk近傍法では、MCAR・30%欠損で-0.0944 RMSEと大きく下回ります。フラグ列が距離計算に加わること自体が不利に働くためです。補完のあとにもう一度標準化を挟んで、フラグ列の重みを上げた構成でも測ってみました。不利はさらに広がりました(magicのk近傍法で0.8363から0.8250、windのk近傍法で3.6106から3.7860)。この追試はMAR・30%欠損・シード0の1条件だけなので、差の大きさは点推定として見てください。
欠け方の見当がつかないうちは手法の順位を決め打ちできない、というのがこの節で言えるところです。
補完を省く道: NaNのまま渡すのは最速、欠損30%で行ごと捨てると学習データは1〜3割
補完しないという選択肢は2つあります。LightGBMにNaNをそのまま渡す道と、欠損のある行を丸ごと捨てる道です。今回の設定では、前者は速さと精度の両方で有利に出て、後者は学習データの残り方が問題になりました。
NaNのまま渡す選択肢は最も速く、magicの全条件で測定値が上回った
補完せずNaNのまま渡した条件を中央値補完と比べると、magicでは9条件すべてで測定値が高くなりました(+0.0002から+0.0045 ROC-AUC、うち7条件で差を確認できました)。windでは9条件中7条件で高く、下回った2条件も-0.0016 RMSE以内です。精度の面では、今回の範囲で中央値補完に劣る理由が見当たりません。
速度の差はもっとはっきりしています。4,000件のうち学習split 2,800行でのfitと、両splitのtransformにかかる時間を5回測った中央値です。
| 補完手法 | magic | wind | 中央値補完比 |
|---|---|---|---|
| 補完しない(NaNのまま) | 0.003秒 | 0.003秒 | 0.4倍 |
| 平均 | 0.005秒 | 0.005秒 | 0.8倍 |
| 中央値 | 0.006秒 | 0.006秒 | 1.0倍 |
| 中央値+欠損フラグ | 0.006秒 | 0.007秒 | 1.0〜1.1倍 |
| MICE | 0.30秒 | 0.34秒 | 50〜54倍 |
| KNN | 0.72秒 | 0.77秒 | 120〜121倍 |
絶対値は1秒未満なので、1回きりなら気になりません。効いてくるのは、交差検証やパラメータ探索で前処理を何十回も回すときです。KNNImputer は全行との距離を計算するので、行数が増えれば差はさらに開くと考えられます(規模を振った計測はしていないので、機序からの推測です)。
なおこの選択肢はLightGBM専用で、線形モデルとk近傍法にはNaNを渡せません。
欠損30%だと、欠損のない行は1〜3割しか残らない
「面倒なので欠損のある行は捨てる」という手も現場ではよく採られます。今回の設定で、学習splitに1つも欠損がない行がどれだけ残るかを数えました。幅は欠損機構3種のあいだの範囲です。
| 欠損率 | magic | wind |
|---|---|---|
| 10% | 59〜62% | 53〜67% |
| 30% | 17〜18% | 12〜32% |
| 50% | 2〜3% | 2〜13% |
1列あたりの欠損率が3割でも、欠損しうる列が5列も6列もあれば、そのすべてが同じ行でそろう確率は急速に小さくなります。欠損率が3割の場面では、学習データを1〜3割まで削ってでも実装を単純にしたいのか、という判断になります。
減り方は欠損機構でも違いましたが、その現れ方はデータで割れました。windでは3つの欠損率とも最も速く減るのはMCARで、MARとMNARではむしろ多く残ります(30%欠損でMCAR 12.2%に対し、MAR 32.2%、MNAR 31.0%)。相関の強い列が同じ行でまとめて欠けるので、欠損が行方向に固まるためだと考えられます。
magicはそうなりませんでした。10%欠損ではwindと同じくMCARが最も少ないものの、30%欠損では3機構がほぼ並びます(シード10本のうち順序が揃ったのは5本)。50%欠損ではMNARの1.8%がMCARの3.2%を下回りました。
なお完全ケース削除そのものは、条件として評価していません。テスト行は落とせない(全行に予測を返す必要がある)ので、学習から評価まで通る戦略にならないと判断しました。上の割合は診断として測った値です。
どのデータで効くかを、回す前に見当づける手がかりは見つからなかった
手の込んだ補完が効くかどうかを、実際に回す前にデータの性質から予想できれば手間が省けます。今回の範囲では、その手がかりが見つかりませんでした。有力だと考えていた説明が、追加で測り直したときに崩れたからです。補完が18セルすべてで効いたwindと、13セルにとどまったmagic。この違いが何で決まるのかは、本実験では特定できていません。
最初に立てた見当は「欠けた列を、常に観測される列から復元できるかどうか」でした。欠損しうる列を常に観測される列だけから線形回帰で予測すると、決定係数(1に近いほど他の列から言い当てられ、0なら手がかりがない)はwindが0.712、magicが0.166です。windなら他の観測所の風速から欠けた値をかなり復元でき、magicはそうではない、という筋書きです。
ところがこの値は、補完器が実際に使う情報とずれていました。KNNImputer もMICEも、常に観測される列だけでなく、部分的に観測されている他の欠損しうる列も使うからです。そこで補完器が実際に到達した精度を、同じ決定係数の物差しで測り直しました。両データとも0.7前後まで届いています。0.166という読みは、magicの補完器が届く精度を4倍以上低く見積もっていたことになります。
順序も逆でした。観測列だけの決定係数ではwindが大きく上回るのに、KNNが実際に到達した精度は3機構ともmagicの方が同等以上です。
到達した精度で効き目を説明できるかも見ました。補完手法の差が最も大きく出る線形モデルでは、説明できません。到達した精度と中央値補完からの差を18セルで並べ、順位相関(並び順の揃い方。1で完全一致、0なら無関係、負なら逆向き)を取ると、0の近くか、むしろ負です。下流をLightGBMやk近傍法にすると中程度の正の相関が出るので、説明できないのは線形モデルに限った話になります。それでも、手法選びが最も効くモデルで説明できないのなら、手がかりとしては使えません。
したがって、決定係数を測って効き目を予想する手順は、この実験からは勧められません。効き目がデータによって変わること自体は確かなので、事前に当たりをつける方法は持ち越しの課題になります。
読み飛ばし可: 決定係数と順位相関の実測値
- 常に観測される列だけからの決定係数: windが0.712、magicが0.166。欠損を入れていない完全データ4,000件にそのまま当てはめた値で、分割も交差検証もしていません。
- 補完器が実際に到達した精度(テストsplitの欠損セルについて、真値の分散を基準にした決定係数。30%欠損・シード10本平均): KNNはmagicがMCARで0.772・MARで0.722、windがMCARで0.760・MARで0.654。
- 観測列だけの決定係数はmagicがwindを0.546下回るのに、実際に到達した精度はKNNでは3機構ともmagicの方が同等以上(+0.006から+0.067)と順序が逆になります。MICEではwind有利のままなので、逆転は手法にもよります。
- 到達した精度と中央値補完からの差の順位相関(18セル): 線形モデルはmagicが-0.059、windが-0.340。下流をLightGBMにするとmagic 0.544 / wind 0.534、k近傍法ではmagic 0.492 / wind 0.622と中程度の正でした。
実務では、下流モデルを決めてから補完に手をかける
迷ったら中央値補完から始めて、そこからの差だけを見る: 今回の範囲でLightGBMを使うなら、手の込んだ補完に替えて動く幅は欠損なしスコアの0.2〜0.4%規模でした。効くかどうかを自分の環境で確かめるときは、下流モデルを固定したまま補完だけを差し替え、シードを何本か振って中央値補完との差を見ます。この記事の実測もその手順で回しています。
LightGBMの第一候補は、補完を省いてNaNのまま: magicの全条件とwindのほぼ全条件で中央値補完と同等以上、下回った条件もごく小さい幅にとどまり、処理は6通りで最も速い水準でした。ただし同じ決定木ベースでも、XGBoostとCatBoostのネイティブ欠損処理は別の実装で、今回は測っていません。
線形モデルや距離ベースのモデルでは、当たれば大きいが読めない賭けになる: KNNImputer やMICEのことです。当たった側のwindの線形モデルでは、中央値補完との差の中央値0.0555 RMSEは欠損なしスコア3.4615の1.6%にあたります。外れた側のmagicでは正になったセルが7割にとどまり、MARではMICEが中央値補完を下回りました。距離ベースのk近傍法でも同じ割れ方です。
欠損の理由そのものが情報になりそうなら、中央値+欠損フラグ: 値が大きいほど欠けるMNARの設定でmagicの線形モデルにはっきり効き、処理は中央値補完とほぼ同じ速さでした。ただし同じMNARでも下流をLightGBMにすると動きは小さく、3つの欠損率で-0.0007から+0.0014、差を確認できたのは50%欠損だけです。距離ベースのモデルにはフラグ列が距離計算に加わるぶん不利なので、使う下流モデルとセットで判断してください。
詳しい検証条件: 欠損の作り方と、差の判定手続き
欠損は分割より前の完全データに注入しました。データの生まれ方として扱うので、テスト側にも欠損があります(推論のときにも値が欠けている、という現実の設定です)。欠損させるのは前半の半分の列だけで(magicは5列、windは6列)、残りの列は常に観測されます。行ごとの欠損確率はロジスティック関数で決めました。MCARは一定、MARは常に観測される別の列の値、MNARはその列自身の値に応じて欠けやすくしています。
補完はすべて学習split内でfitしています。データを学習用とテスト用に分けたうち、学習側だけを見て補完のルール(列の中央値や近傍の探し方)を決める、という意味です。標準化から補完までをPipelineにまとめ、テスト側は決まったルールを当てはめるだけ(transform)にしました。同じ前処理結果を3つの下流モデルで共有しているので、モデル間の差は下流モデルだけに由来します。
補完を分割の外でfitしてしまうリークがスコアをどれだけ盛るかは、前処理を交差検証の前に当てた場合を4種類で測った検証で扱っています(欠損補完は、数千件・欠損率15%の範囲では差を確認できませんでした)。この記事は正しくfitした前提で手法どうしを比べたものです。
条件の水準は、欠損率が10・30・50%、欠損機構がMCAR・MAR・MNARの3種、データ分割のシードが0から9の10本で、生スコアは2,940行になりました。下流モデルのハイパーパラメータは固定し、条件のあいだで動かしていません。
数値はすべて、実際に実行して保存したログを集計したものです。独立単位はデータ分割のシード10本。同じシード内での中央値補完との差を取り、その10本から重複を許して10,000回引き直す方法(ブートストラップ)で95%信頼区間を出しました。差の向きは正なら中央値補完より良いに揃えています(回帰はRMSEの符号を反転)。区間が0を跨がなければ「差を確認できた」、跨ぐなら「明確な差を確認できなかった」と書きます(後者は「差がない」と証明したわけではありません)。
読み飛ばし可: 欠損注入の詳細・反復回数・標準化の位置・モデル設定・補完誤差の定義・取得元
- 欠損確率を決めるとき、駆動する値は順位を経由して標準正規に直してから使い、平均欠損確率が目標の10・30・50%に一致するよう切片を解いています。実際に生じた対象列の欠損率は0.092から0.509の範囲でした。
- MICE(
IterativeImputer)は既定のmax_iter=10で「収束条件に達していない」という警告が出ます。これで過小評価していないかが気になったので10・20・30で測り直したところ、magicの線形モデルで0.7990 / 0.7987 / 0.7986と差は4桁目でした。読者が実際に使う既定値のまま本実験に入っています。 - 標準化は補完より前に置きました。
StandardScalerはNaNを無視して平均と分散を計算しNaNを保持するので、この順にするとKNNImputerの距離計算とMICEの回帰が特徴量の尺度に左右されません。欠損フラグの0/1列は標準化されないまま下流へ渡ります。 - モデル設定は
LogisticRegression(max_iter=2000)、Ridge(alpha=1.0)、LGBMClassifier/LGBMRegressor(n_estimators=300, learning_rate=0.05, num_leaves=31)、KNeighborsClassifier/KNeighborsRegressor(n_neighbors=15)です。補完はKNNImputer(n_neighbors=5)、IterativeImputer(max_iter=10)。 - 信頼区間はシード単位の対応差に対するブートストラップ(B=10,000、seed=42)で、データ分割と欠損注入の乱数をシード10本ぶん振り直したときのばらつきを表します。対象データは固定の4,000件なので、別のデータを引いてきた場合のばらつきは含みません。補完処理の所要時間のばらつきでもありません。
- 補完誤差は、学習splitの統計で標準化したスケールのうえで、テストsplitの欠損セルだけを対象に、欠損しうる列を横断してプールして求めた二乗平均平方根です(学習split側の補完誤差は測っていません)。
- 所要時間の表の倍率は、丸める前の秒数から計算しています。表示した秒数どうしを割った値とはわずかにずれます。
- データはPMLB(Penn Machine Learning Benchmarks)から取得しました。magicの原典はUCIのMAGIC Gamma Telescope、windの原典はアイルランド12観測所の日次風速(1961-1978)です。取得時のハッシュも実行ログに残しています。
適用範囲と限界
- 適用範囲は、連続値の特徴量だけを持つ4,000件・10〜11列のデータです。カテゴリ変数を含むデータ、もともと欠損があるデータ、時系列は測っていません。件数や列数が変われば、補完の効き目も所要時間の比も変わりえます。
- 欠損は人工的に注入したもので、機構と強さ(ロジスティック関数の傾き2.0)は設計値です。実データの欠損がこの形に従う保証はありません。
- 欠損は分割より前に注入しているので、テスト側にも欠損があります。学習時だけ欠損があって推論時は値が揃っている、という設定は測っていません。
- 下流モデルのハイパーパラメータは固定です。補完手法ごとに調整すれば順位は動きえます。
- 補完器そのもののハイパーパラメータも探索していません(
KNNImputer(n_neighbors=5, weights='uniform')、IterativeImputer(max_iter=10)の既定値のまま)。近傍数や反復回数を変えれば、補完の精度も下流の差も動きえます。 - MICEは1回の補完結果をそのまま下流へ渡す使い方で、複数回実行して統合する多重代入は測っていません。
- ネイティブ欠損処理はLightGBMのみです。XGBoostとCatBoostは別の実装なので、そのまま当てはめられません。
- 補完の所要時間はこの実行環境での値で、他の環境での相対比を保証するものではありません。
手元で動かす: magicのMAR・欠損率30%で6通りを比べる
本文と同じ条件(magic・MAR・欠損率30%・シード0から2)を切り出した実装です。データ取得から欠損の注入、リークのない補完、2モデルでの評価までが1本で通ります。取得は自動なので、そのまま実行できます。load_data を差し替えれば手元のデータで同じ比較ができ、RATE と MECH を書き換えれば欠損率と機構を振れます。
"""欠損値補完の手法を、リークなしで比べる最小の実装例。

pip install scikit-learn lightgbm pandas numpy scipy
python quickstart.py
"""
import gzip
import io
import urllib.request

import numpy as np
import pandas as pd
from scipy.stats import norm
from sklearn.experimental import enable_iterative_imputer  # noqa: F401
from sklearn.impute import IterativeImputer, KNNImputer, SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
import lightgbm as lgb

URL = "https://media.githubusercontent.com/media/EpistasisLab/pmlb/master/datasets/magic/magic.tsv.gz"
RATE = 0.3          # 対象列の欠損率
MECH = "MAR"        # MCAR / MAR / MNAR
SEEDS = [0, 1, 2]


def load_data():
    with urllib.request.urlopen(URL, timeout=180) as r:
        df = pd.read_csv(io.BytesIO(gzip.decompress(r.read())), sep="\t")
    y = df["target"].to_numpy().astype(int)
    X = df.drop(columns=["target"]).to_numpy(dtype=float)
    rng = np.random.default_rng(0)
    idx = np.sort(rng.choice(len(X), 4000, replace=False))
    return X[idx], y[idx]


def rank_normal(v):
    """値を順位経由で標準正規に変換する。分布の歪みに左右されずに欠損の偏りを設計できる。"""
    return norm.ppf((np.argsort(np.argsort(v)) + 0.5) / len(v))


def inject_missing(X, mech, rate, seed, slope=2.0):
    """前半の列にだけ欠損を入れる。後半の列は常に観測され、MAR の駆動変数になる。"""
    rng = np.random.default_rng(1000 + seed)
    n, d = X.shape
    n_miss = int(np.ceil(d / 2))
    Xm = X.copy()
    for j in range(n_miss):
        if mech == "MCAR":
            p = np.full(n, rate)
        else:
            # MAR は他の観測列、MNAR はその列自身の値に応じて欠損しやすくする
            src = X[:, n_miss + (j % (d - n_miss))] if mech == "MAR" else X[:, j]
            z = rank_normal(src)
            lo, hi = -40.0, 40.0
            for _ in range(200):  # 平均欠損率が rate になる切片を二分探索
                mid = (lo + hi) / 2
                if (1 / (1 + np.exp(-(slope * z + mid)))).mean() < rate:
                    lo = mid
                else:
                    hi = mid
            p = 1 / (1 + np.exp(-(slope * z + (lo + hi) / 2)))
        Xm[rng.random(n) < p, j] = np.nan
    return Xm


def make_prep(strategy):
    """標準化してから補完する。StandardScaler は NaN を無視するのでこの順で問題ない。"""
    steps = [("scaler", StandardScaler())]
    if strategy == "mean":
        steps.append(("imp", SimpleImputer(strategy="mean")))
    elif strategy == "median":
        steps.append(("imp", SimpleImputer(strategy="median")))
    elif strategy == "median_indicator":
        steps.append(("imp", SimpleImputer(strategy="median", add_indicator=True)))
    elif strategy == "knn":
        steps.append(("imp", KNNImputer(n_neighbors=5)))
    elif strategy == "mice":
        steps.append(("imp", IterativeImputer(max_iter=10, random_state=0)))
    # native は補完を挟まず NaN のまま LightGBM に渡す
    return Pipeline(steps)


def main():
    X, y = load_data()
    strategies = ["mean", "median", "median_indicator", "knn", "mice", "native"]
    scores = {(s, m): [] for s in strategies for m in ["linear", "gbdt"]}

    for seed in SEEDS:
        Xm = inject_missing(X, MECH, RATE, seed)
        Xtr, Xte, ytr, yte = train_test_split(Xm, y, test_size=0.3, random_state=seed,
                                              stratify=y)
        for s in strategies:
            # 補完器は学習splitだけで fit し、テストは transform だけ通す(リーク防止)
            prep = make_prep(s)
            Ztr = prep.fit_transform(Xtr)
            Zte = prep.transform(Xte)
            models = {"gbdt": lgb.LGBMClassifier(n_estimators=300, learning_rate=0.05,
                                                 n_jobs=1, verbose=-1, random_state=0)}
            if s != "native":  # 線形モデルは NaN を扱えない
                models["linear"] = LogisticRegression(max_iter=2000)
            for kind, model in models.items():
                model.fit(Ztr, ytr)
                auc = roc_auc_score(yte, model.predict_proba(Zte)[:, 1])
                scores[(s, kind)].append(auc)

    rows = []
    for (s, kind), v in scores.items():
        if v:
            rows.append(dict(補完=s, モデル=kind, ROC_AUC平均=round(float(np.mean(v)), 4),
                             標準偏差=round(float(np.std(v, ddof=1)), 4)))
    out = pd.DataFrame(rows).sort_values(["モデル", "ROC_AUC平均"], ascending=[True, False])
    print(f"magic / {MECH} / 欠損率{int(RATE*100)}% / seed{SEEDS}")
    print(out.to_string(index=False))


if __name__ == "__main__":
main()実行手順: 上のコードを quickstart.py として保存し、必要なライブラリを入れて実行します(データを取得するのでネットワークにつながる環境で動かしてください)。
pip install scikit-learn==1.9.0 lightgbm==4.7.0 numpy==2.4.6 pandas==3.0.5 scipy==1.17.1
python quickstart.py
手元で回すと、LightGBMは6手法が0.8994から0.9008の幅に収まり、線形モデルではMICEだけが0.8078と他より低く出ました(中央値補完は0.8261)。実行中に IterativeImputer から「収束条件に達していない」という警告が出ますが、反復回数を10・20・30と変えても結果は4桁目しか動かなかったので、既定のままにしています。本文はこの条件をシード10本で集計しているので数値はそのまま一致しませんが、MICEが線形モデルで下がるという向きは同じです。
まとめ: 補完に手をかける前に、下流モデルを決める
補完手法の選び方は、下流に何を置くかを決めてから考えれば足りそうです。LightGBMを使うなら中央値補完かNaNのまま、線形モデルや距離ベースのモデルなら手の込んだ補完を試す価値がある、という順序で判断できます。
いちばん意外だったのは、MICEが最も効くと予想していたMARの条件で、かえって中央値補完を下回ったことでした。ばらつきが潰れるせいかと考えて事後サンプリングで測り直したら、そちらはもっと悪くなり、推測がきれいに否定されました。原因はまだ特定できていません。windでは効いてmagicでは効き方が揺れた理由も、欠けた列を他の列から復元できるかで説明できると考えていたのに、補完器が実際に到達する精度を測ると見当が外れていました。
次はデータセットを増やして、どんな性質が効き目と結びつくのかを測り直したいところです。カテゴリ変数を含むデータ、もともと欠損があるデータ、多重代入としてのMICEも未測定のまま残っています。下流にLightGBMを置くなら、GBDT3種の実測比較も判断の材料になります。scikit-learnとLightGBMの版が上がったときは、同じ条件で測り直すつもりです。