
機械学習のコードは、うまくいっていなくても動きます。scikit-learnなら数行書いて fit するだけで、それらしい精度が返ってきます。その数字が本来より低いままでも、エラーは出ません。下がっていること自体に気づけないまま、モデルを替えたり列を足したりする方向へ時間を使ってしまいます。
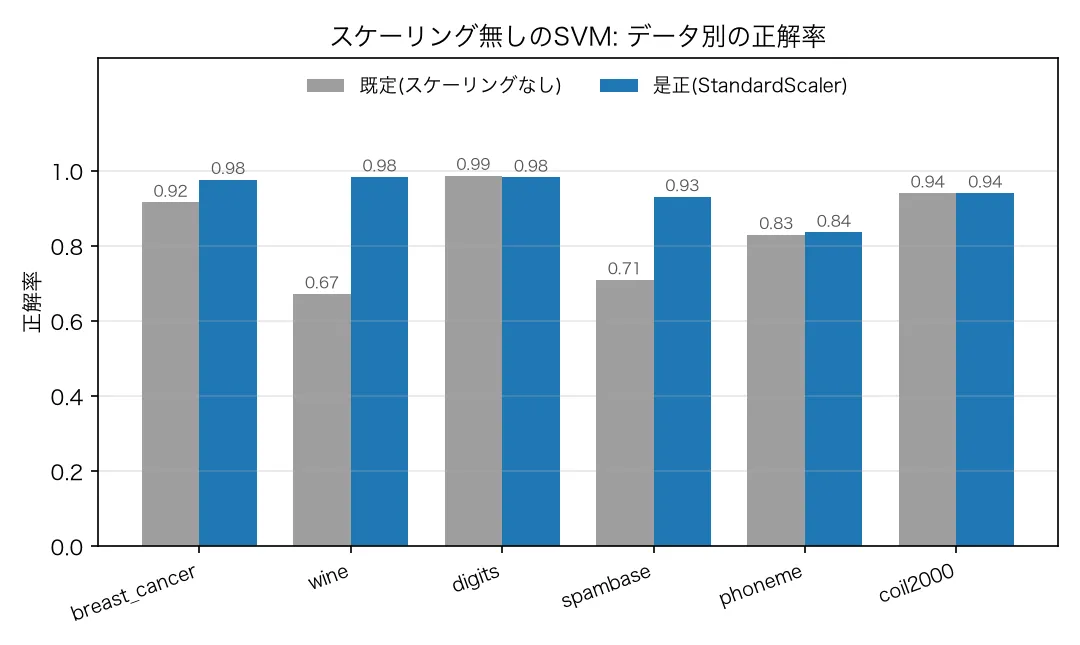
たとえばワイン品種を当てるデータでは、標準化を加えるだけでSVMの正解率が0.672から0.983へ上がりました。ところが同じ手当てを手書き数字のデータに加えると、正解率はわずかに下がります。
そこで、放置されやすい既定を4つ選び、「既定のまま」と「是正した設定」を対にして、性格の違う分類データで回しました。決めたいのは、限られた時間で既定を1つだけ疑うなら、どれから見るのが得かという順番です。効かなかった罠も、効かなかったまま並べます。
先に結論: 標準化を先に、正解率だけで判断しない
- SVM・kNNで精度を最初に疑う候補は「特徴量の標準化忘れ」。スケールがバラバラなワイン品種データでは、標準化するだけでSVM(サポートベクターマシン)の正解率が0.3以上上がった
- ただし既定が全部危険なわけではない。特徴量が元から同じ尺度なら、標準化後の正解率はほぼ変わらないか、わずかに下がった
- 反復回数の上限
max_iter=100は、1000に増やしても正解率の差は最大+0.004。係数は大きく変わっており、予測精度と係数の解釈は分けて判断 - 不均衡データで
class_weightを指定しないのは、正解率では見えない罠。coil2000では少数派179件のうち5件しか拾わないまま、正解率0.939 - 数値特徴量の分類データ6種(178〜3,000件、2〜10クラス)と、scikit-learn 1.9.0のSVM・kNN・ロジスティック回帰での結果。木系モデルと深層学習は対象外
疑ったのは、書かなくても勝手に決まる4つの設定
SVC() や LogisticRegression() のように引数を書かずにモデルを作ると、いくつかの設定が自動で決まります。今回そこから4つを選びました。ロジスティック回帰が max_iter=100 で収束しきらずに出す警告、正則化 C=1.0 の放置、不均衡データでの class_weight 未指定、そして特徴量の標準化忘れです。最後の1つだけは引数ではなく、前処理を挟まないという既定の手順を指します。この4つを選んだのは、既定のまま放置されやすいからです。
標準化(StandardScaler)は、各特徴量を平均0・標準偏差1にそろえる前処理です。SVM(サポートベクターマシン、SVC)とkNN(k近傍法)は点と点の距離を判断に使うため、特徴量のスケールがそろっていないと、値の大きい列に引きずられます。
ロジスティック回帰は線形の分類モデルです。残る3つの既定は、いずれもこのモデルの引数にあたります。
6種類のデータで、既定と是正を同じ分割の上で対にした
使ったのは、性格の異なる分類データ6種です。scikit-learn同梱から、乳がん診断(breast_cancer、569件・2クラス)、ワイン品種(wine、178件・3クラス)、手書き数字(digits、1,797件・10クラス)。pmlb(公開データセット集、MITライセンス)からは、スパム判定(spambase、57列)、音素判定(phoneme、5列)、保険の勧誘応答(coil2000、少数派6%の不均衡)を取得しました。pmlbの3種は計算量を抑えるため、各3,000件を層化抽出しています。
比べたのは、次の4つの既定それぞれの「既定のまま」対「是正」です。データは6種類そろえ、class_weight の罠だけは不均衡寄りの4種類で見ています。測ったのは正解率(当たった割合)で、クラスが偏ったデータでは、各クラスの正解率を平均したbalanced accuracyも併せて見ます。既定と是正は同じ交差検証(データを分けて学習と評価を入れ替えながら繰り返し測るやり方)の分割で対にし、その差を出しました。
- スケーリング: 生の特徴量のまま 対 StandardScalerを前段に入れる(SVMとkNNで別々に測定)
- 未収束: ロジスティック回帰の
max_iter=100(既定。最適化の反復回数の上限)対max_iter=1000 - 正則化: 標準化済みで
C=1.0(既定。正則化の強さで、小さいほど強く効く)対 探索で選んだC(両側とも標準化してCだけを比較) - class_weight: 標準化済みで
class_weight=None(既定。少数派クラスをどれだけ重く扱うかの設定)対class_weight="balanced"(不均衡データが対象)
標準化はいずれも交差検証の内側だけで学習し、テスト分割へ情報が漏れないようにしました。分割の反復数や件数を絞った経緯は、記事後半の「詳しい検証条件」に置いてあります。
なお、ロジスティック回帰にも標準化の対照を入れる予定でしたが、生のデータでの多クラス最適化が重く完走しなかったため外しました。標準化の効果を測れたのはSVMとkNNの2つです。
標準化が大きく効いたのは、列ごとに値の桁が違うデータだった
標準化による改善が大きかったのは、特徴量ごとに値の桁が違うデータです。SVMやkNNを使っているなら、モデルを替える前に列ごとのスケールを確認してください。表のかっこ内は、列ごとの標準偏差がどれだけ散らばっているかを大まかに示したものです。
| データ(特徴量スケールの散らばり) | SVM 既定 | SVM 是正 | kNN 既定 | kNN 是正 |
|---|---|---|---|---|
| wine (中〜大) | 0.672 | 0.983 | 0.686 | 0.966 |
| spambase (大) | 0.709 | 0.931 | 0.784 | 0.900 |
| breast_cancer (極大) | 0.916 | 0.976 | 0.930 | 0.965 |
| digits (小、画素) | 0.987 | 0.983 | 0.986 | 0.975 |
| phoneme (ほぼ均一) | 0.830 | 0.836 | 0.853 | 0.853 |
| coil2000 (不均衡) | 0.940 | 0.940 | 0.936 | 0.935 |
太字は既定と是正のうち値が高いほうで、差を確認できたという意味ではありません。phonemeのkNNは3桁では同じ値になり(実測は0.8532対0.8530)、差の信頼区間も0を含むため太字を付けていません。
wineとspambaseは、特徴量ごとに値の桁が違うデータです。SVMの動径基底関数カーネル(SVCの既定で、2点の距離から近さを測る方法)とkNNは、標準化しないと値の大きい列の影響を受けやすくなります。この2データでは、その影響をそろえたことで正解率が大きく変わりました。
digitsは逆でした。手書き数字は全画素が同じ0〜16の範囲にあり、もともとスケールがそろっています。SVM・kNNとも標準化後にわずかに下がりましたが、低分散の画素を引き伸ばしたことが原因かどうかは、この実験では分離していません。5列すべてが近い尺度のphonemeもほとんど動きませんでした。
coil2000のSVMは標準化の前後とも0.940です。ただし、この値は多数派の割合とほぼ一致しており、少数派を拾えているかは正解率だけでは分かりません。正解率が変わらないことだけで、標準化が無害だったとは判断できません。
収束警告が出ていても、正解率はほとんど動かなかった
ロジスティック回帰を生のデータで学習すると、max_iter=100(既定)ではよく「収束しませんでした」という警告が出ます。今回も6データ中5つで警告が出て、反復回数は上限の100で打ち切られていました。警告が出なかったのはphonemeだけで、こちらは11回で収束しています。
反復を1000まで増やしても、正解率の差は最大+0.004にとどまりました。正解率だけを上げたい場面では、警告への対応を最優先にする根拠は得られていません。
| データ | max_iter=100 | max_iter=1000 | 正解率の差 |
|---|---|---|---|
| breast_cancer | 0.945 | 0.949 | +0.004 |
| wine | 0.947 | 0.949 | +0.003 |
| spambase | 0.923 | 0.926 | +0.003 |
| digits | 0.962 | 0.963 | +0.001 |
| phoneme | 0.770 | 0.770 | +0.000 |
| coil2000 | 0.938 | 0.938 | +0.000 |
差の信頼区間(同じ条件で測り直したときに差が収まる見込みの範囲)は、6データすべてで0を含みました。反復を10倍にしても、正解率の改善は確認できません。なお1000回でもbreast_cancer・wine・spambaseは上限に張り付いており、警告そのものは消えていません。ここで測ったのは反復回数を増やす効果であって、収束させた場合の効果ではありません。
係数(各特徴量の重み)は、正解率とは別の動きをしました。breast_cancerでは、100回と1000回の係数ベクトルに約6割の相対差があります。最適化が途中で止まっていても正解率は近かった、という観測までがこの実験で分かる範囲です。係数が変わっても予測結果が近かった理由は分離していません。
係数の値そのものを解釈したい場合や、確率・損失まで安定させたい場合は、正解率が近いことを理由に警告を放置できません。標準化やソルバーの変更も含め、収束を確認してから値を読みます。
標準化後のC調整では、正解率の改善を確認できなかった
ロジスティック回帰の正則化の強さC=1.0を、0.01〜100の5候補から選び直すと精度が上がるかも調べました。両条件を標準化し、探索も学習データの内側だけで行っています。それでも6データのうち改善を確認できたものはなく、wineの測定値は-0.006でした。この下落も信頼区間が0を含むため、探索が悪化させたとは判断していません。
Cの調整が無意味だという話ではありません。データや指標によっては効きます。今回の6データは、既定で回してから調整しても遅くない側だった、ということです。
不均衡データでは、正解率が高いほうが少数派を捨てていた
最後は、少数派が6%しかないcoil2000のような不均衡データです。ここは他と毛色が違います。正解率だけを見ると、class_weight を既定のままにするのが「正解」に見えます。
| 指標 | 既定(None) | 是正(balanced) |
|---|---|---|
| 正解率 | 0.939 | 0.700 |
| balanced accuracy | 0.516 | 0.649 |
既定の正解率には中身があります。「ほぼ全員を多数派だと予測」して稼いだ数字です。各クラスの正解率を平均したbalanced accuracyは0.516で、2クラスの片方をすべて外したときの0.5に近い値でした。class_weight="balanced" にすると正解率は0.700まで下がりますが、balanced accuracyは0.649に上がります。少数派を拾うぶん、多数派を取りこぼす、というトレードオフです。
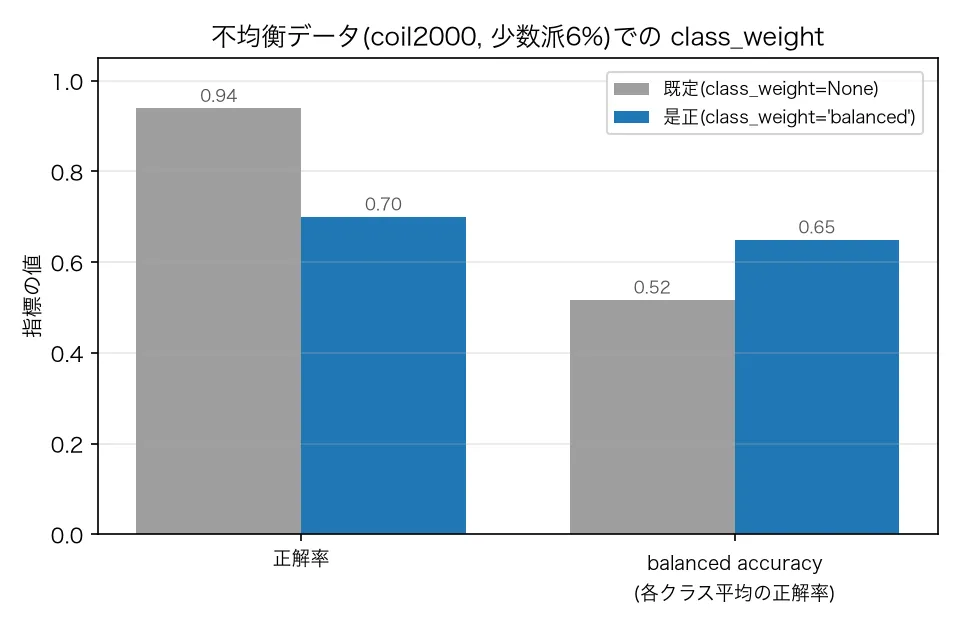
少数派を当てたいのか、全体の正解率を上げたいのかは、既定で回す前に決めておく必要があります。決めないまま回すと、高いほうの数字だけが目に入ります。
class_weightは4データで比較しました。coil2000の改善が最大でしたが、残る3データの伸びはクラス比の順には並びません。
| データ | 少数派の割合 | balanced accuracy 既定 | balanced | 差 |
|---|---|---|---|---|
| coil2000 | 6.0% | 0.5164 | 0.6491 | +0.1327 |
| phoneme | 29.3% | 0.6701 | 0.7461 | +0.0760 |
| spambase | 39.4% | 0.9160 | 0.9240 | +0.0080 |
| breast_cancer | 37.3% | 0.9703 | 0.9706 | +0.0003 |
クラス比はclass_weight="balanced"を試すきっかけにはなりますが、改善幅までは決まりません。手元のデータでは、少数派の再現率やbalanced accuracyを実際に比較する必要があります。
件数で数え直すと、既定が何を捨てているかが見える
平均の指標だけでは、既定がどれだけ少数派を捨てているかが伝わりにくいので、coil2000で少数派クラスの取りこぼしを数えました。少数派は全179件です。既定(class_weight=None)が正しく当てられたのは179件中わずか5件(少数派の再現率2.8%)でした。class_weight="balanced" にすると108件(60.3%)まで増えます。
少数派の検出という観点では、既定設定はほとんど機能していませんでした。このデータのように少数派を見つけることが目的なら、全体の正解率だけではモデルを選べません。
正解率で比べられる是正では、スケーリングだけが突出した
正解率で測った是正効果を、1枚の表にまとめます。class_weightは、正解率で比べると少数派を拾う改善を逆向きに評価してしまうため外しました。各セルは「是正−既定」の正解率差で、列内で最も精度を上げた値を太字にしています。
| 罠(是正の内容) | breast_cancer | wine | digits | spambase | phoneme | coil2000 |
|---|---|---|---|---|---|---|
| スケーリング(SVM) | +0.061 | +0.312 | -0.005 | +0.221 | +0.006 | +0.000 |
| スケーリング(kNN) | +0.035 | +0.280 | -0.010 | +0.116 | -0.000 | -0.001 |
| max_iter 100→1000 | +0.004 | +0.003 | +0.001 | +0.003 | +0.000 | +0.000 |
| 正則化 C調整 | -0.001 | -0.006 | -0.001 | +0.002 | -0.000 | +0.002 |
行によって出発点はそろっていません。スケーリングの2行は生の特徴量、max_iterの行は生データを各1,500件、正則化の行は両側とも標準化済みで比べています。大小の傾向は見られますが、差どうしを割って「スケーリングは正則化の何倍得か」とは言えません。
スケーリングの差が大きいのは、wine・spambase・breast_cancerの3データです。digitsとcoil2000の列にも太字は付きますが、値は+0.001と+0.002で、どちらも差の95%信頼区間が0を含みます。列内の1位という表示だけで、実務上の効果があるとは判断できません。
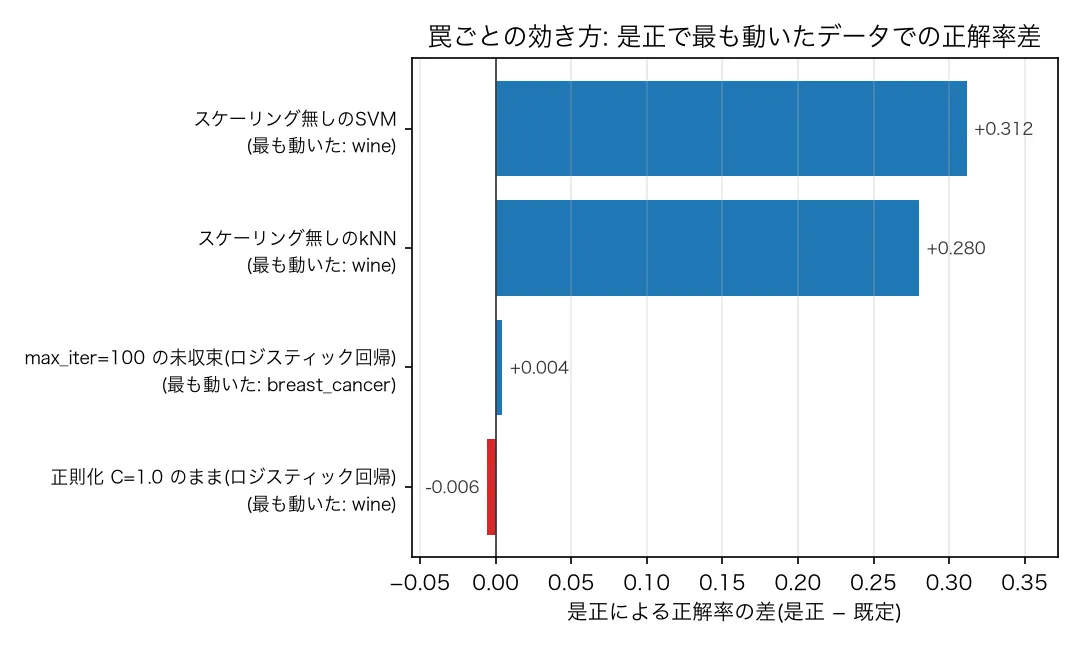
この順位が成り立つのは、使うモデルが距離や内積を見るタイプ(SVM・kNN・線形モデルの一部)で、かつ特徴量のスケールがそろっていないときです。同じ4つを別のモデルに当てれば、順位は変わりえます。
手元のデータで、どれから疑うか
最初に見るのは、列ごとのスケール差: 標準偏差の桁が違うなら、SVM・kNNでは標準化あり・なしを同じ交差検証で比べます。スケール差は試す優先度を決める目印で、改善幅を予測する値ではありません。
少数派を当てたいなら、正解率だけで選ばない: class_weight="balanced"を試し、balanced accuracyや少数派の再現率を既定設定と並べます。全体の正解率が高くても、この2つが低ければ少数派を拾えていません。
収束警告は、用途を分けて対応: 正解率だけを見る比較では、max_iterを増やしても改善を確認できませんでした。一方、係数を解釈する場合や確率・損失まで扱う場合は、標準化やソルバーの変更も含めて収束を確認します。ロジスティック回帰に対する標準化の精度差は、今回完走できず測っていません。
Cの調整は、伸び悩んでからで間に合う: 標準化したうえでの C=1.0 は、これらのデータでは悪くない初期値でした。既定で回し、精度が伸び悩んでから調整しても遅くありません。
詳しい検証条件
評価はすべて、層化5分割交差検証を2回繰り返した10スコアの平均です。既定と是正は同じ分割の上で対にし、差(是正−既定)の95%信頼区間をt分布で求めています。本文ではその区間を、0をまたぐかどうかの判定にだけ使いました。掲載した値は、罠とデータの組み合わせごとに保存した実行ログから集計しています。
読み飛ばし可: 再現の細部と縮小の記録
- 正則化の是正は入れ子交差検証で、内側3分割のグリッド探索(C=0.01〜100の5点)で選んだCを外側で評価しました。
- 未収束の比較は生の(標準化していない)データで行い、対象は各1,500件に抑えました。生の悪条件データでは反復が重く、時間を抑えるための縮小です。
- ロジスティック回帰の反復上限は、正則化・class_weightでは1000、未収束の比較では100対1000です。
- 当初は「スケーリング無しのロジスティック回帰」も対照として入れる設計でしたが、生の悪条件データでの多クラス最適化が重く完走しなかったため外しました。そのため標準化の効果を測れたのはSVMとkNNだけで、ロジスティック回帰でのスケール感度は今回測れていません。
- 共有CPUで完走させるため、反復回数とデータ件数を上記のとおり縮小しました。縮小前の全条件は完走していないため、同じ傾向になるかは確認できていません。
判断に使った主な95%信頼区間です。
| 比較 | データ | 差 | 95%信頼区間 |
|---|---|---|---|
| スケーリング(SVM) | wine | +0.312 | +0.279〜+0.344 |
| スケーリング(SVM) | digits | -0.005 | -0.009〜-0.001 |
| max_iter 100→1000 | breast_cancer | +0.004 | -0.006〜+0.015 |
| max_iter 100→1000 | digits | +0.001 | -0.001〜+0.003 |
| 正則化 C調整 | wine | -0.006 | -0.014〜+0.003 |
| 正則化 C調整 | coil2000 | +0.002 | -0.001〜+0.004 |
| class_weight (balanced accuracy) | coil2000 | +0.1327 | +0.1073〜+0.1582 |
| class_weight (balanced accuracy) | phoneme | +0.0760 | +0.0644〜+0.0876 |
| class_weight (balanced accuracy) | spambase | +0.0080 | +0.0026〜+0.0134 |
| class_weight (balanced accuracy) | breast_cancer | +0.0003 | -0.0065〜+0.0070 |
適用範囲と限界
- 適用範囲: 数値特徴量の分類データ6種(178〜3,000件、2〜10クラス)での傾向です。生のカテゴリ変数が多いデータや、木系モデル・深層学習では検証していません。
- スケーリングの結果は、特徴量のスケールがそろっているかによって変わりました。自分のデータではスケール差を確認したうえで、標準化あり・なしを同じ分割で比べます。
- 未収束・正則化の比較は、計算量を抑えるため生データ側や件数を絞っています(pmlbの3種は3,000件、未収束の比較は1,500件)。全件や別のソルバー、より広い探索では結果が動く余地があります。
- 標準化以外のスケーリング(MinMaxやRobustScaler)は比べていません。前処理の選択肢としてどれが良いかは、この実験の範囲外です。
- class_weightのトレードオフは指標の選び方の問題です。どの指標を最適化すべきかは業務目的で決まるので、そこはこの実験の外にあります。
スケーリングの罠が自分のデータで効くか確かめるコード
手元のデータで「スケーリング忘れ」の罠が効くかを確かめる最小の実装です。scikit-learn同梱のワインデータ(3クラス)を使うので、ダウンロードは要りません。標準化は交差検証の内側だけで学習するようPipelineに入れ、テスト分割へ情報が漏れないようにしました。load_wine の行を手元のXとyの用意に書き換えれば、同じ比較が回ります。
あわせて、特徴量のスケールがどれだけ散らばっているかを、標準偏差の最大÷最小で表示します。この比は、桁違いの列があることに気づくための目印です。
"""スケーリング忘れの罠を、既定 vs StandardScaler で確かめる完全版。"""
from sklearn.datasets import load_wine
from sklearn.model_selection import RepeatedStratifiedKFold, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
from sklearn.neighbors import KNeighborsClassifier

# 自分のデータで試すなら、この行を特徴量Xとラベルyの用意に書き換える
X, y = load_wine(return_X_y=True)

# 特徴量のスケール差に気づく目安(改善幅を予測する値ではない)
stds = X.std(axis=0)
stds = stds[stds > 0]
print(f"特徴量の標準偏差の最大/最小 = {stds.max() / stds.min():.0f}")

cv = RepeatedStratifiedKFold(n_splits=5, n_repeats=2, random_state=42)
models = {
    "SVM": SVC(),
    "kNN": KNeighborsClassifier(),
}
for name, clf in models.items():
    # 既定: 生の特徴量のまま
    plain = cross_val_score(clf, X, y, cv=cv, scoring="accuracy").mean()
    # 是正: 標準化を前段に入れる(fold内で学習)
    scaled = cross_val_score(make_pipeline(StandardScaler(), clf), X, y, cv=cv, scoring="accuracy").mean()
    print(f"{name}: 既定={plain:.3f}  標準化あり={scaled:.3f}  差={scaled - plain:+.3f}")
実行結果(このワインデータでの一例)
特徴量の標準偏差の最大/最小 = 2530
SVM: 既定=0.672  標準化あり=0.983  差=+0.312
kNN: 既定=0.686  標準化あり=0.966  差=+0.280
このデータでは標準偏差の比が2530で、標準化後の正解率も0.3前後上がりました。
比の大きさと伸びの大きさは一致しませんでした。今回の6データで比が最大だったのはbreast_cancerの215171ですが、正解率の伸びは+0.061です。比が85分の1だったwineでは+0.312まで伸びました。標準偏差の比は比較を始める目印であり、標準化を採用する判定値ではありません。
まとめ: 今回の条件で注意が必要だった既定は2つ
4つの既定を6データで並べました。正解率をはっきり下げていたのはスケーリング忘れだけで、しかも特徴量のスケールがバラバラなときに限られます。
ただし、これで危ない既定を数え終えたことにはなりません。class_weightの未指定は正解率をむしろ上げるので、この物差しでは引っかかりません。coil2000では高い正解率の裏で、少数派をほとんど拾えていませんでした。正解率という1本の物差しで4つを並べると、この罠だけが安全な側に落ちます。
収束警告の有無と正解率への影響も分けて考える必要があります。今回、反復回数を増やしても正解率の改善は確認できませんでしたが、係数は大きく変わっていました。
今回の範囲の外には、生のカテゴリ変数が多いデータや、木系・深層学習のモデルが残っています。既定の効き方はモデルの種類で変わるので、そこは同じ4つを当て直して測るところからになります。