
前回、データリーク5パターンの検証で、標準化と欠損補完を「やってはいけない順番」で回しました。手元の成績はほとんど動きませんでした。手順としては避けるべきなのに、数値には表れなかったのです。
成績を測るのに使ったのが交差検証(CV)です。データをK個に分け、1つを答え合わせ用、残りを学習用として、担当を入れ替えながらスコアを測ります。
やってはいけない順番、というのは、欠けている値を埋めたり使う列を絞ったりという下ごしらえを、分割より前に全データへ当てることです。答え合わせ用に取っておいたはずのデータの情報が、その段階で学習側へ流れ込みます。コードはエラーを出さずに動き、手元の成績だけが本来より良く出ることがあります。
では、ラベルとの関係が強い列だけを残す特徴選択や、件数の少ないクラスを合成データで補うSMOTEでも、影響は小さいのでしょうか。標準化・欠損補完・特徴選択・SMOTEを交差検証の前に処理した場合と、各分割の学習データだけで処理した場合を比べ、CVがどれだけ変わるかを測りました。学習に使っていない別データの成績も取り、CVだけが高く見えていないかを確かめます。
先に結論: 同じ手順ミスでも、影響が出る条件と出ない条件に分かれた
- 前処理はPipelineへ入れ、交差検証の分割ごとに学習データだけへ当てるのが安全
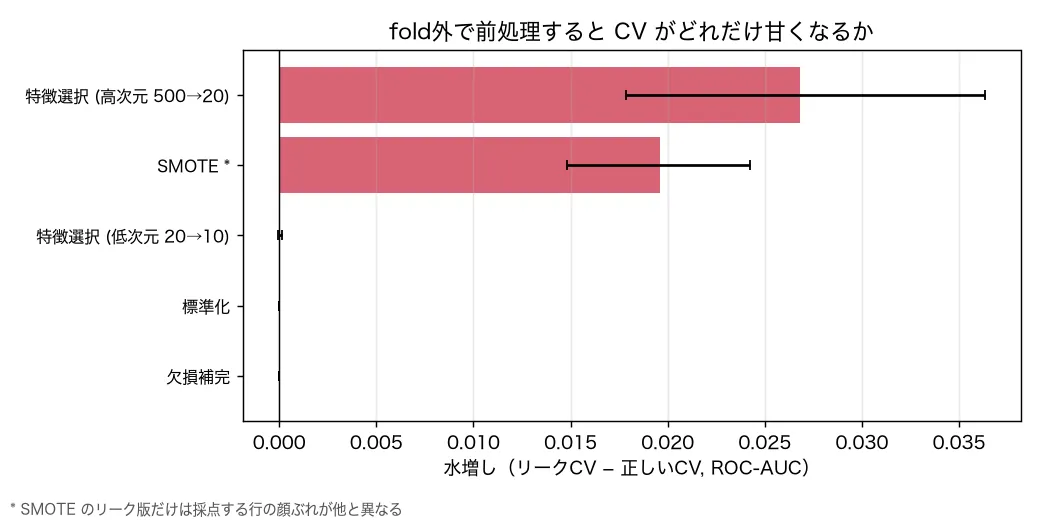
- 水増し(正しい手順で回したCVとの差)が目立ったのは、列数の多いデータでの特徴選択と、分割前のSMOTE。標準化と欠損補完では差を確認できず
- SMOTEの水増しは分類器で変わり、木モデル2種では0.1超。線形モデル1種だけを見ると小さく見える
- ラベルと何の関係もない乱数だけのデータでも、分割前に列を選ぶと、本来0.5のはずのスコアが平均0.673へ
この記事の「水増し」は、正しい手順のCVとの差
この記事で何度も出てくる水増しは、リーク版のCVから正しい版のCVを引いた差です。スコアはすべてROC-AUCで測ります。0.5がランダム相当で、1に近いほど正例を負例より上位に並べられています。前処理そのものは、名前を見て何をする処理か思い浮かべば十分です。
比べるのは、同じ前処理の当て方2通りです。分割前の全データへまとめてfitしたものをリーク版、各foldの学習部分だけにfitし直したものを正しい版と呼びます。foldは交差検証で切り分けた1組分のデータのことです。fitの位置を分割の内側に保つには Pipeline(前処理とモデルを1つにまとめる仕組み。CVの各foldで前処理を学習部分だけにfitし直してくれます)を使います。行を増やすSMOTEだけはscikit-learnのPipelineでは扱えないので、imbalanced-learnの同名の仕組みを使いました。
この引き算が成り立つのは、標準化・欠損補完・特徴選択では同じデータを使い、fitの位置だけを変えているからです。SMOTEだけは検証foldに合成行が混じるため、水増しに採点対象の変化も含まれます。
もう一つ、学習にも交差検証にも使わず取り分けておいた1,000件での成績を、以下では「真値」と呼びます。1,000件から推定した値なので誤差はあります。なお、前回の記事の「盛れ幅」は正しい版ではなく真値と比べた差で、今回の水増しとは別の量です。
判定の言葉づかいも決めておきます。シード10個で測った差の分布から95%信頼区間を求め、区間が0を含まなければ「水増しを確認できた」、0を含めば「確認できなかった」と書きます。後者は水増しが無いと証明したわけではありません。
漏れる情報が違う5条件を並べた
比べたのは次の5条件です。特徴選択だけは、列数の違いで挙動が変わるかを見たかったので2条件に分けました。
前処理で使う値や判断は、本来、各foldの学習データだけから決める必要があります。交差検証の前に全データへ当てると、その段階で検証foldの情報も見てしまいます。漏れる情報は前処理ごとに違います。
- 標準化(StandardScaler): 各列を平均0・分散1に揃えます。決めるのは各列の平均と標準偏差で、ラベルは見ません。分割前に計算すると、この2つの統計量に検証foldの値が入り、変換後の特徴量を通じて学習側へ伝わります。
- 欠損補完(SimpleImputer): 欠けている値を、その列の平均で埋めます。埋めるのに使う平均が全データから計算されるので、標準化と同じ経路で検証foldの値が混ざります。
- 特徴選択・低次元(SelectKBest, 20列から10列): ラベルとの関連が強い列を上位k個だけ残します。ここで決めるのは「どの列を残すか」で、上の2つと違ってラベルを見て決めます。全データのラベルで選ぶと、検証foldの正解を見て列を決めたことになり、選ばれた列は検証foldでも当たりやすくなります。
- 特徴選択・高次元(SelectKBest, 500列から20列): 同じ手法を、列がサンプル数に比べて多いデータへ当てます。選ぶ余地が広いほど、検証foldの正解に合う列を拾いやすくなるはずです。
- SMOTE: 少数クラスの点を、近くにある少数クラスの点との間に合成して増やす不均衡対策です。決めるのは合成する点の位置で、ラベルを見て行そのものを増やします。分割前に当てると、検証fold側の点から作った合成点が学習側に入ります。なお、正しく各foldの学習部分だけへ当てたときにSMOTEが精度を上げるかどうかは別の問題で、不均衡データの対策を比べた検証では無処置のLightGBMが実データで一度も負けませんでした。
ラベルを見て値を作る前処理には、カテゴリをカテゴリごとの目的変数平均で置き換えるターゲットエンコーディングもあります。分割前に全データで平均を計算したときの影響は別の検証で実測しており、目的変数と無関係な乱数カテゴリでも、条件によって交差検証AUCが0.795まで上がりました。
分類器はまずロジスティック回帰に固定しました。前処理の種類だけを変数にするためで、標準化の影響を受けやすい線形モデルなので、標準化のリークがあるなら見えるはずだという読みもありました。
データの作り方、シード、信頼区間の求め方は、記事後半の「詳しい検証条件」にまとめてあります。
水増しは前処理と分類器で0.000から0.1超まで分かれた
同じ手順ミスでも、影響の大きさは前処理で二極に分かれました。標準化と欠損補完、それに列数の少ないデータでの特徴選択では、fitの位置を分割の前へ動かしてもCVはほとんど動きません。列数の多いデータでの特徴選択と、分割前のSMOTEでだけ水増しが残りました。
○は偶然を割り引いても水増しが残った条件、―は残らなかった条件です。
| 前処理 | リークCV | 正しいCV | 真値 | 水増し | 判定 |
|---|---|---|---|---|---|
| 標準化(StandardScaler) | 0.9036 | 0.9036 | 0.9072 | 0.000 | ― |
| 欠損補完(SimpleImputer) | 0.9007 | 0.9007 | 0.9033 | 0.000 | ― |
| 特徴選択・低次元(20列から10列) | 0.8991 | 0.8991 | 0.9041 | 0.000 | ― |
| 特徴選択・高次元(500列から20列) | 0.8390 | 0.8122 | 0.8196 | +0.027 | ○ |
| SMOTE(注) | 0.8532 | 0.8336 | 0.8464 | +0.020 | ○ |
(注)SMOTEのリーク版だけは、検証foldに合成した行が混じるため、採点する行の顔ぶれが他の条件と同じではありません。
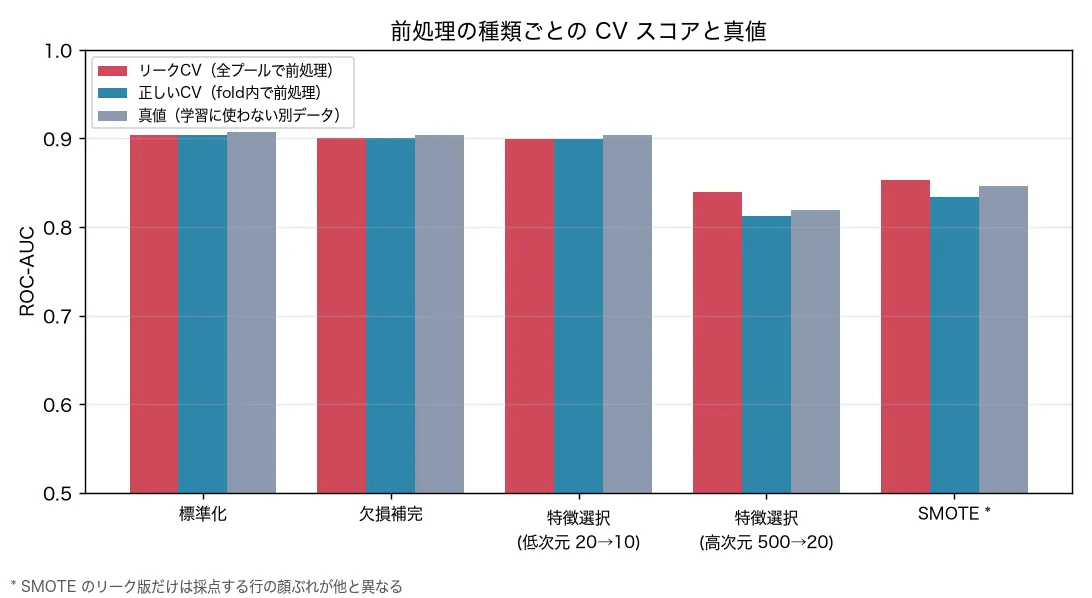
上3条件では、リーク版と正しい版のCVが小数第3位まで一致しています。真値だけがそれより0.003〜0.005高いのですが、これはリークによるものではありません。
読み飛ばし可: 真値がCVより少し高い理由
学習に使えるデータがfoldの中で5分の4に減るせいではありません。標準化の条件で、採点する相手を固定して学習量だけを変えると、差は0.001以下でした。同じ条件で学習プールと取り分けたデータを引き直すと差は縮み、ランダムフォレストでは消えます。引き直したあとはどちらも0を含む区間で、確認できる差ではありません。
標準化と欠損補完は、交差検証の前にfitしてもCVはほとんど動かなかった
この3条件でCVがほとんど動かなかったのは、情報が漏れていないからではありません。漏れる量が小さいからです。
数千件あれば、全プールで測った平均・分散と、各foldの学習部分だけで測ったそれは、小数点以下まで見てもほとんど同じ値になります。ほぼ同じ値で変換するのだから、fitの位置を分割の前へ動かしても結果は変わりません。
低次元の特徴選択(20列から10列)も同じでした。20列のうち12列がラベルと関係を持つので、選ばれる顔ぶれが安定しています。
ここで動かしたのはfitの位置だけで、補完のやり方は列の平均で埋めるSimpleImputerに固定しています。補完手法そのものを替えたときの効き目は下流のモデルで変わり、KNN・MICEの欠損値補完を実測した検証では、線形モデルでは差が残る一方、LightGBMは埋めた値の誤差を3割以上減らしても得点がほとんど動きませんでした。
特徴選択は、列の選択肢が多い条件で崩れた
同じSelectKBestでも、2,000件・500列から20列を選ぶ条件でだけCVが持ち上がりました。リーク版のCVは0.8390、fold内で選択した版は0.8122で、差は平均0.027です。20列から10列を選ぶ低次元では、同じ手法でも水増しを確認できていません。
ここで切り分けが崩れました。ラベルを見ない標準化と欠損補完は影響が小さく、ラベルを見る特徴選択とSMOTEは大きく水増しする、と分けて考えていたのです。ところが低次元の特徴選択も、同じように列をラベルで選んでいます。高次元と低次元を分けたのは見るかどうかではなく、列数と件数の比だと考えています。
列がサンプル数に比べて多いと、ラベルと本当に関係のある列はごく一部で、大多数の無関係な列のなかに「たまたま今回のラベルと相関した列」が紛れ込みます。全プールでラベルを見て上位20列を選ぶと、そうした偶然の相関を持つ無関係な列が選ばれます。その相関は検証foldのラベルにも部分的に効いているので、検証foldでも当たっているように見えます。
fold内で選んだ版は0.8122で、真値0.8196との差は0.0074でした。
SMOTEは採点対象をそろえても水増しが残った
リーク版のCVは0.8532、fold内で適用した版は0.8336で、差は0.020です。ただし検証foldに合成行が含まれます。元データ由来の行だけで比べるとリーク版のCVは0.8415に下がり、差は0.008でした。真値0.8464との差は0.007で、今回の反復ではこの差を区別できていません。
分割前に全データへ当てると、ある点から作った合成点と、その元になった実点が、分割後に別々のfoldへ散らばります。検証foldのなかに学習foldの点に由来する合成点が混じるため、モデルはそれを言い当てやすくなります。
書きかけていたのは、むしろ逆の話でした。fold内のSMOTEではCVが真値をやや下回る、という逆転です。学習プールと真値用のデータを引き直すと、その差は−0.0128から+0.0060へ符号ごと変わりました。条件によらない性質とは言えないので、この主張は落としました。
SMOTEの水増しは木モデルで0.1を超えた
ここまではロジスティック回帰です。SMOTEのリークは合成点の近傍を言い当てる経路なので、局所的な形を表現できるモデルでは大きく出る可能性があります。データも分割も前処理もそのままに、分類器だけを差し替えて測り直しました。数値はいずれも水増し(リークCV − 正しいCV)です。
| 前処理 | ロジスティック回帰 | ランダムフォレスト | 決定木 |
|---|---|---|---|
| 標準化 | 0.000 | 0.000 | 0.000 |
| 欠損補完 | 0.000 | 0.000 | +0.001 |
| 特徴選択・低次元 | 0.000 | 0.000 | +0.001 |
| 特徴選択・高次元 | +0.027 | +0.014 | +0.012 |
| SMOTE(注) | +0.020 | +0.105 | +0.128 |
(注)SMOTEの行には、上の表と同じく採点する行の顔ぶれが変わるぶんが混ざります。元データ由来の行だけで採点し直すと0.008/0.104/0.116で、ランダムフォレストではほぼ変わらず、決定木でも1割ほどしか減りません。
ランダムフォレストのリーク版はCVが0.9928、正しい手順では0.8874、取り分けておいた1,000件では0.9043です。正しい手順と比べて0.105、取り分けたデータと比べても0.088高く出ていました。元データ由来の行だけで比べても0.104と0.116が残るので、木モデルではこの差のほとんどがリークです。線形モデルで小さく見えたのは、決定境界が直線なので合成点の周りだけを覚え込めないためだと考えられます。
高次元の特徴選択は逆に、木モデルでは0.012〜0.014と半分ほどに縮みました。標準化・欠損補完・低次元の特徴選択は、木モデルへ替えても最大0.0012(決定木の低次元特徴選択)にとどまります。偶然を割り引いても残ったのは決定木の欠損補完の0.0008だけで、どちらも採用の判断を変える大きさではありません。
前処理の名前だけで危険度を決められない、というのがこの節の結論です。同じ分割前SMOTEが、線形モデルでは0.020、決定木では0.128でした。
ラベルと関係のある列が1つもないデータでも、交差検証前の特徴選択でCVは0.673まで上がった
列もラベルも完全にランダムで、本物の関係が一切ないデータ(1,000件・1,000列、真のROC-AUCは0.5)を1条件だけ用意しました。全プールから20列を選んでからCVを回すと、CVのROC-AUCは平均0.673(あるシードでは0.694)です。各foldの内側で選んだ正しい版は0.492、取り分けておいたデータでは0.501でした。
特徴選択が検証foldのラベルを覗き見て、偶然そのラベルに合う列を選び出した結果です。実力がゼロのデータでも、CVの数字だけを見ていれば、そこそこ当たっているモデルに見えます。
実務では前処理をPipelineへ入れ、下がった分を別データで裏取りする
前処理はPipelineの中、交差検証のsplitは外側 標準化・欠損補完・特徴選択にはscikit-learnのPipeline、行を増やすSMOTEにはimbalanced-learnのPipelineを使います。仕組みは違っても、各foldの学習データだけで前処理する点は同じです。
書き直してCVが下がっても、下がった幅がそのまま本来の性能との差になるとは限らない 変更前のスコアにリークが乗っていた可能性は疑ってよいのですが、実力のほうは、学習に使っていない別データであらためて見積もります。
列数が多いデータではSelectKBestをsplitより前でfitしない Pipelineの中へ置きます。今回の2,000件・500列の条件では、20列を選ぶと0.027の水増しが出ました。同じく列を選ぶSelectFromModelも置き場所は同じですが、今回測ったのはSelectKBestだけです。
SMOTEは各fold内で適用し、検証データは元のクラス分布のままにする imbalanced-learnのPipelineに入れます。今回の木モデルでは、採点対象を元データ由来の行にそろえても0.104と0.116の水増しが残りました。
詳しい検証条件: データの作り方と判定の手続き
ここまでの数値は、条件ごとに実行して保存したログを集計したものです。設計の中身を順に書きます。
使ったデータは、scikit-learnのmake_classificationで作った合成2値分類データです。標準化・欠損補完・低次元の特徴選択には、学習プール4,000件・20列のデータを使いました。ラベルと本当に関係があるのは8列で、4列はその組み合わせです。欠損補完の条件では、先頭8列の15%を欠損させています。
高次元の特徴選択には、学習プール2,000件・500列のデータを使いました。ラベルと関係があるのは5列だけです。SMOTEには、少数クラスが1割ほどの不均衡データを使っています。いずれも同じ生成呼び出しから行方向に切り出し、学習に使わない1,000件を別に取り分けました。さらに、列もラベルも無関係な1,000件・1,000列のデータを1条件だけ用意しました。
独立単位はデータ分割のシード10個(42〜51)で、各シードで5分割交差検証の平均を取り、その10シードの平均を条件ごとに報告します。差の判定には、10シードの差の分布からブートストラップで95%信頼区間を求めています。
読み飛ばし可: シード・分類器・信頼区間の設定
- データ分割シードは42〜51の10個。各条件のデータ生成も同じシードに連動させ、学習プールと真値用の1,000件は同一の生成呼び出しから行方向に分けています(別シードで作り直すと分布そのものが変わり、同一分布からの新規サンプルにならないため)。
- 分類器は
LogisticRegression(max_iter=2000)で固定。特徴選択はSelectKBest(f_classif)、SMOTEはimbalanced-learnの既定設定です。 - 信頼区間は、シード単位の差(リーク版 − 正しい版)10個を再標本化するブートストラップ(B=10,000、seed=42)です。表しているのはデータ生成と分割の反復に対するばらつきで、実行時間のばらつきではありません。10個の再標本化なので区間は狭めに出ます。0付近の差は結論に使いません。
適用範囲と限界
- 合成データでの結果です。実データのクラス構造や欠損の起き方では、水増しの大きさは変わりえます。
- 条件ごとに列数・件数・クラス比・難易度が違います。水増しの絶対値は注意する条件を探す目安であり、前処理どうしの厳密な順位ではありません。
- 分類器ごとに土台のスコアも違います(同じSMOTE条件で真値は0.79〜0.90)。線形モデルと木モデルの開きは採点対象をそろえても残りましたが、倍率や木モデル2種の大小は厳密に比較できません。試したのは3種で、勾配ブースティングは未測定です。
- 標準化と欠損補完で差が出なかったのは、件数が数千・欠損率15%という範囲での結果です。件数が少ない・欠損が多い状況では、補完のリークが表に出る余地が残ります(今回は未測定)。
- 特徴選択はf_classifによる単変量選択のみを試しました。埋め込み型や再帰的特徴除去では挙動が変わりえます。
- fold内SMOTEでCVが真値を下回る逆転は、上で述べたとおり引き直すと符号が変わるため主張していません。水増しのほうは同じ引き直しでも変わりませんでした(高次元の特徴選択は0.027から0.026、SMOTEは0.020から0.020)。
手元で動かす: 高次元の特徴選択で水増しを再現する
次のコードでは、列数の多いデータで特徴選択を交差検証の前に行う場合と、Pipelineで各foldの内側に入れる場合を比べます。合成データもコード内で作るため、データの取得は不要です。make_classificationの行を手元のデータに差し替えれば、同じ比較ができます。
"""交差検証の前に特徴選択をやるとCVに水増しが出ることを確認する完全版デモ。"""
import numpy as np
from sklearn.datasets import make_classification
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import StratifiedKFold, train_test_split
from sklearn.pipeline import Pipeline

# 列数が多く、ラベルと無関係な列が大半のデータ(500列中5列だけが関係する)
X, y = make_classification(
    n_samples=3000, n_features=500, n_informative=5, n_redundant=0,
    n_clusters_per_class=1, class_sep=0.6, flip_y=0.1, random_state=42,
)
# 学習プールと、学習に使わない評価用データに分ける
X_pool, X_hold, y_pool, y_hold = train_test_split(
    X, y, test_size=1000, stratify=y, random_state=42
)

skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

# リーク版: 分割前の全プールで特徴選択してから交差検証
sel = SelectKBest(f_classif, k=20).fit(X_pool, y_pool)
Xs = sel.transform(X_pool)
naive = []
for tr, va in skf.split(Xs, y_pool):
    clf = LogisticRegression(max_iter=2000).fit(Xs[tr], y_pool[tr])
    naive.append(roc_auc_score(y_pool[va], clf.predict_proba(Xs[va])[:, 1]))

# 正しい版: 特徴選択をPipelineに入れ、各foldの内側でfitする
correct = []
for tr, va in skf.split(X_pool, y_pool):
    pipe = Pipeline([
        ("select", SelectKBest(f_classif, k=20)),
        ("clf", LogisticRegression(max_iter=2000)),
    ])
    pipe.fit(X_pool[tr], y_pool[tr])
    correct.append(roc_auc_score(y_pool[va], pipe.predict_proba(X_pool[va])[:, 1]))

# 真値: 正しい手順で全プールに学習し、学習に使っていないデータで評価
final = Pipeline([
    ("select", SelectKBest(f_classif, k=20)),
    ("clf", LogisticRegression(max_iter=2000)),
]).fit(X_pool, y_pool)
true_auc = roc_auc_score(y_hold, final.predict_proba(X_hold)[:, 1])

print(f"リークCV(全プールで選択): {np.mean(naive):.4f}")
print(f"正しいCV(fold内で選択)  : {np.mean(correct):.4f}")
print(f"真値(学習に使っていないデータ): {true_auc:.4f}")実行手順: 上のコードをquickstart_leak.pyとして保存し、必要なライブラリを入れて実行します。
pip install scikit-learn==1.9.0 numpy==2.4.6
python quickstart_leak.py
手元で回すと、リーク版のCVが0.7655、正しい版が0.7175、評価用データが0.7084になりました。
データの作り方は本文の高次元条件と同じ設定ですが、本文では生成した行をそのまま順に切り分けているのに対し、ここではクラス比をそろえたランダム分割を使っており、シードも1つだけです。そのため水準は一致しません(本文の0.8390は10シードの平均で、同じシード42だけを見ると0.7611です)。単発の値ではなく、リーク版だけが高いという向きを見てください。
読み飛ばし可: シードごとの振れ幅
水増しは同じシードのなかでfitの位置だけを変えた差なので、水準の振れは差し引かれます。それでもシードごとに0.006から0.052まで動きました。その平均が本文の0.027で、この1回の実行では0.048です。
今回の判断
交差検証の前に前処理したときの影響は、一律ではありませんでした。標準化・欠損補完・低次元の特徴選択では差を確認できず、高次元の特徴選択では、無関係な列から偶然の相関を拾える余地がスコアを押し上げていました。
SMOTEについては、ロジスティック回帰だけを見て影響は小さいと結論しかけました。木モデルへ替えると、採点対象を元データ由来の行にそろえても差はほとんど縮みません。線形モデル1種の結果だけでは判断できないと分かりました。