
予測の誤差を平均で見ると十分に小さいのに、めったに出ない大きな値の行だけ、予測が低く出ることがあります。多くの行が中央付近に集まり、少数だけが右へ長く伸びるデータでは、その少数での失敗が全体の平均に埋もれてしまうためです。
この記事では、右端にある少数の大きな値を「高値側」と呼びます。分布の裾に当たる部分なので、表や図の見出し、実験条件の名前では短く「裾」と書きます。
高値側を当てたい場面では、該当する行を外れ値として削除するわけにはいきません。学習時の重みを増やす、該当行を複製する、分位点回帰へ替える、目的変数を対数変換する。対処の候補はいくつも挙がります。ところが高値側の誤差が下がっても、残りの大多数で誤差が増えれば、モデル全体として改善したとは限りません。
もう一つ引っかかったのが、高値側の選び方です。実測値が大きかった行には、もともと高くなりやすい行だけでなく、偶然上振れした行も含まれます。そのため、高値側で予測が低かったという事実だけでは、すべてをモデルの失敗と断定できません。そこで合成データでは各行の本来の平均値が分かることを利用し、その値をそのまま返す理論上の基準も同じ条件で評価して、選び方によって避けられない下振れとモデルの誤差を分けました。
先に結論
- 稀な高値を改善した方法は、今回の比較ではすべて全体RMSEが悪化。 高値側だけを見て方法を選ばず、高値側MAEと全体RMSEを対にして判断する
- 最初に試す候補は、高値側への重み付け。 合成データの上位5%で高値側MAEが35.0%低下、全体RMSEは16.1%増加。分位点回帰より交換が小さい
- 分位点回帰は、評価範囲によって改善と悪化が入れ替わる。 住宅価格データの上位20%ではMAEが20.0%増
- 補正なしの対数変換は、合成データと住宅価格データの両方で高値側が悪化。 住宅価格データの上位5%ではMAEが23.5%増
- 適用条件: LightGBMの既定設定のまま、合成データと住宅価格データ1件で8条件を20回ずつ比較。条件別のチューニングや不均衡回帰の専用手法は含まない
この記事の表に出てくる言葉
このあとの表には「裾のMAE」「分位点 q=0.90」といった行と列が並びます。LightGBMなどで回帰モデルを一度学習し、学習用とテスト用に分けて誤差を測ったことがあれば、そのまま読み進められます。
- 裾(高値側)と
p・tau: 学習データの目的変数を大きい順に並べ、上位何%かを高値側とみなします。その割合がp、境界の値がtauです。今回は上位20%から1%まで振りました。 - MAE(平均絶対誤差): 誤差の絶対値の平均。全行を同じ重さで数えるので、高値側の成績を測るのに使います。
- RMSE(二乗平均平方根誤差): 誤差を2乗して平均し、平方根を取った値。大きな外れに強く反応するため、全体の成績を測るのに使います。
- 分位点回帰: 平均ではなく「値の何%が下に収まる水準」を狙う学習方法。
q=0.90なら、90%が下に来る高さを予測します。 - recall(再現率)とprecision(適合率): 実際に高値だった行のうち、予測値も境界
tauを超えた割合がrecall。高値と予測した行のうち、実際にも高値だった割合がprecisionです。
LightGBMの条件だけを変え、高値側と全体を同時に測った
比較した方法は次の8通りです。L2はLightGBMの通常の回帰設定で、誤差を2乗して大きな外れを強く数えます。
| 方法 | 学習時に変えること | 注意点 |
|---|---|---|
| L2(基準) | 誤差の2乗を小さくする | LightGBMの既定設定です |
| L1 | 誤差の絶対値を小さくする | 大きな誤差の影響をL2より抑えます |
| Huber | 小さな誤差と大きな誤差の扱いを分ける | 境目となるalphaの値で結果が変わります |
| 対数変換 | 目的変数を圧縮してから学習する | 元の尺度へ戻す際の補正は今回加えていません |
| 重み付け | 高値側の行を強く反映する | 高値側と残りの合計重みを1:1にしました |
| リサンプリング | 高値側の行を複製する | 高値側と残りの件数を1:1にしました |
| 分位点回帰 q=0.90 | 狙う分位点をq=0.90にする | 平均より高い予測へ寄ります |
| 分位点回帰 q=0.95 | 狙う分位点をq=0.95にする | q=0.90より高い予測へ寄ります |
主な検証対象は、12特徴・24,000件の合成データです。特徴量から判別できる一部の行だけ目的変数へ値を加え、高値側の割合を20%・10%・5%・2%・1%へ変えました。実データには、PMLB(公開データセットをまとめた配布リポジトリ)の住宅価格データ574_house_16Hを使っています。22,784行・16特徴量で、目的変数が右へ偏る度合いを表す歪度は3.76です。
合成データでは高値側そのものの発生率を変えましたが、実データではデータを固定したまま、評価する範囲を上位20%から1%まで動かしています。この2つは同じ操作ではありません。 前者は学習に使える高値の行数も一緒に減り、後者は同じモデルを別の切り口で採点しているだけです。
測ったのは、高値側のMAE、全体のRMSE、そして高値側のrecallとprecisionです。各条件は乱数の初期値(seed)を変えて20回繰り返し、同じ回のL2との差を集計しました。境界の決め方や合成データの生成条件は、後半の「詳しい検証条件」にまとめています。
二乗誤差では、稀になるほど高値側の過小予測が広がった
LightGBMの通常設定であるL2で学習すると、高値側の予測はそろって低く出ました。上下にばらついた結果ではなく、一方向へずれています。高値側の誤差を見るときは、絶対値の平均だけでなく、符号を残した平均も並べてください。 大きさだけを見ていると、ずれが片側へ寄っているのか、単にばらついているのかを区別できません。
次の表の「裾の符号付き平均誤差」は、各行の予測値から実測値を引き、その平均を取ったものです。値が負なら、高値側を平均的に低く予測しています。
| 裾の希少度 p | 裾のMAE | 裾の符号付き平均誤差 | 全体RMSE | 裾のrecall | テストの裾件数 |
|---|---|---|---|---|---|
| 20% | 3.847 | -3.208 | 3.124 | 0.672 | 1,447.7 |
| 10% | 4.370 | -3.880 | 2.653 | 0.535 | 724.3 |
| 5% | 4.786 | -4.494 | 2.249 | 0.413 | 359.7 |
| 2% | 5.320 | -5.236 | 1.887 | 0.275 | 147.4 |
| 1% | 5.739 | -5.719 | 1.704 | 0.182 | 73.6 |
符号付き平均誤差はすべて負で、裾のMAEとほぼ同じ大きさでした。上振れと下振れが相殺された結果ではなく、高値側の多くを低く予測しています。p=1%では平均5.7の過小予測となり、合成時に加えた値12の半分近くに達しました。実際に高値だった行のうち、予測値も境界を超えた割合は18.2%です。
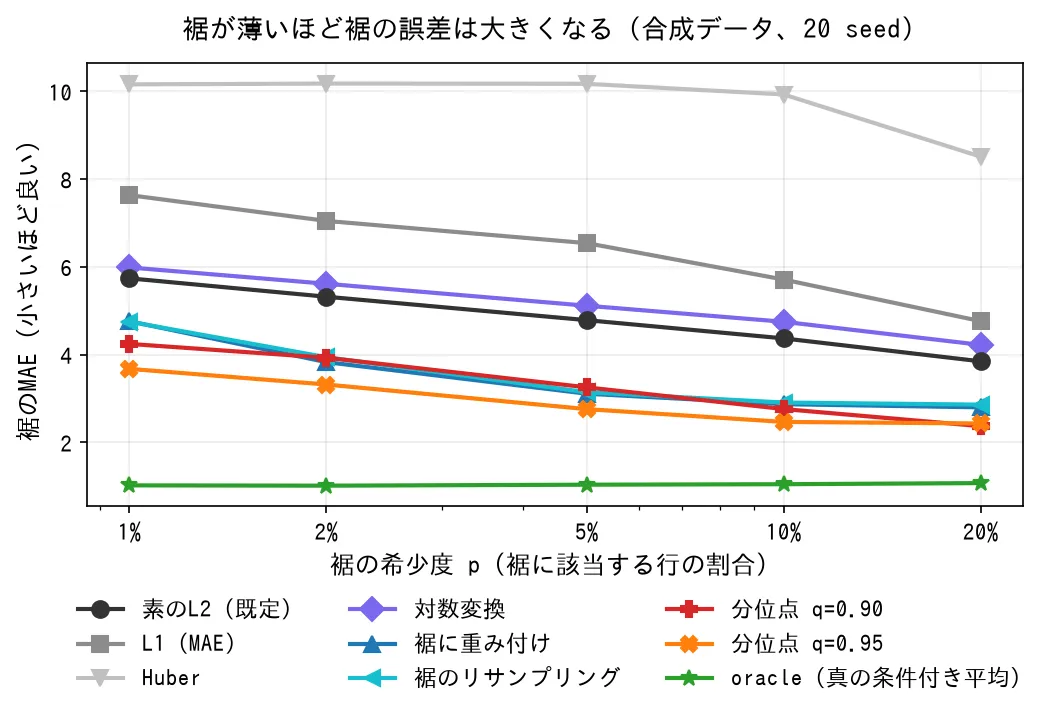
ここで比較しているのは、高値側の発生率そのものを変えた合成データです。発生率を下げると学習に使える高値の行も減るため、図1だけから希少度と誤差の因果関係を切り分けることはできません。
理論上の基準と比べても、モデルの過小予測は大きかった
実測値が大きい行を選ぶと、偶然の上振れも混ざります。そのため、各行が本来取りやすい平均値を正確に予測できたとしても、選ばれた行の実測値より予測値は少し低くなります。合成データでは本来の平均値が分かるので、その値をそのまま予測する理論上の基準(oracle)とL2を比べました。
| 裾の希少度 p | oracleの裾MAE | oracleの符号付き平均誤差 | 素のL2の裾MAE |
|---|---|---|---|
| 20% | 1.072 | -0.184 | 3.847 |
| 5% | 1.036 | -0.300 | 4.786 |
| 1% | 1.020 | -0.429 | 5.739 |
高値側の選び方によって生じるoracleの平均誤差は-0.18〜-0.43で、L2の-3.21〜-5.72より大幅に小さい値でした。今回観測したL2の過小予測は、高値側の選び方だけでは説明できません。 避けられない下振れがどれくらい効くのか分からないまま設計に入れた基準線でしたが、実測すると桁が違いました。
この比較は、データに残るばらつきと高値側へ加えた幅の関係にも左右されます。今回は約1.4のばらつきに対して12を加えており、両者の差は約8.5倍でした。ノイズがより大きいデータではoracle側の平均誤差も増える可能性があるため、ここでの切り分けは今回の生成条件に限られます。
高値側を改善した4条件は、すべて全体RMSEを増やした
高値側を良くする方法を入れると、その分だけ全体の誤差が増えました。高値側のMAEが減ったのは、重み付け、リサンプリング、2種類の分位点回帰の4つで、この4条件はどれも全体RMSEが上がっています。採用するかどうかは、下がった高値側MAEと上がった全体RMSEを並べて決めます。 片方だけを眺めていると、大多数の行で静かに損をしている状態に気づけません。
次の表は、合成データのp=5%について、同じseedのL2との差を取ってから平均したものです。
| 条件 | 裾のMAE | 裾の変化率 | 全体RMSE | 全体の変化率 |
|---|---|---|---|---|
| 素のL2(基準) | 4.786 | 0% | 2.249 | 0% |
| L1(MAE) | 6.542 | +36.7% | 2.530 | +12.5% |
| Huber(既定delta) | 10.173 | +112.6% | 3.390 | +50.7% |
| 対数変換 | 5.115 | +6.9% | 2.230 | -0.9% |
| 裾に重み付け | 3.109 | -35.0% | 2.610 | +16.1% |
| 裾のリサンプリング | 3.143 | -34.3% | 2.595 | +15.4% |
| 分位点 q=0.90 | 3.254 | -32.0% | 3.383 | +50.4% |
| 分位点 q=0.95 | 2.758 | -42.4% | 4.476 | +99.0% |
高値側のMAEを1%改善するために増えた全体RMSEは、重み付けで0.46%、分位点q=0.95で2.33%でした。q=0.95は高値側のMAEが最も低いものの、全体への影響は重み付けより大きくなります。高値側MAEが最小の条件が、交換の点でも最良とは限りません。
対数変換の全体RMSEを除き、表の差はseed間のばらつきの3倍以上あり、20回すべてで増減の向きも一致しました。対数変換による全体RMSEの差だけはばらつきより小さく、変化を確認できていません。
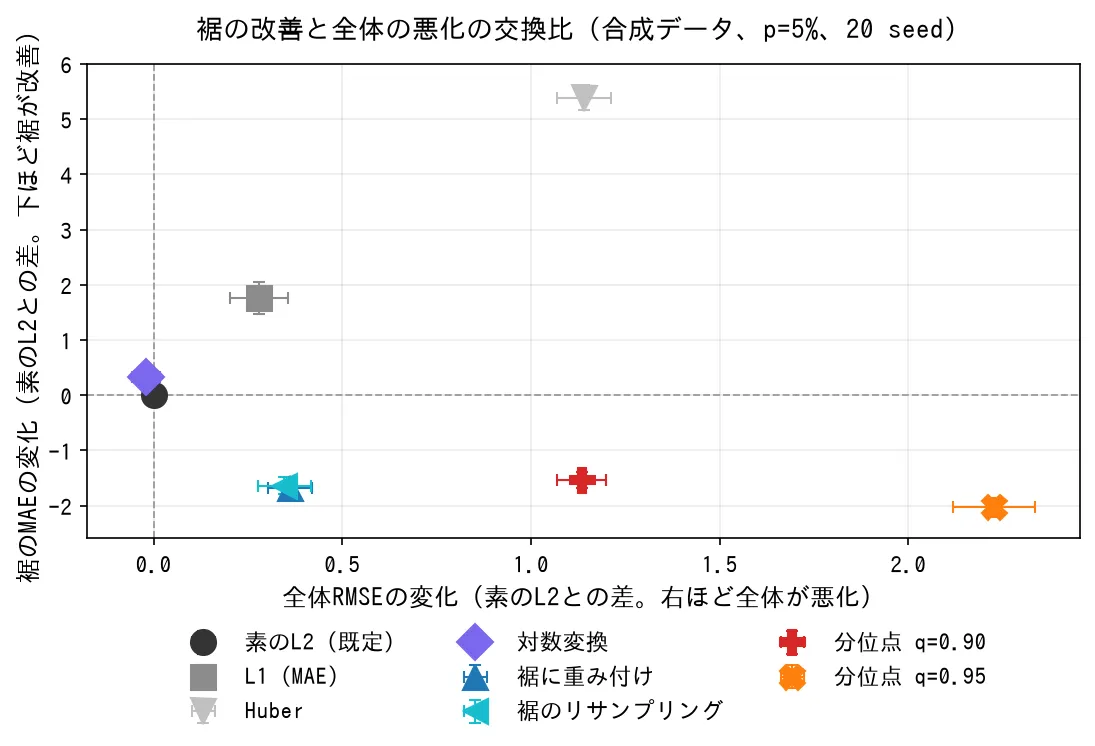
図2の横軸は全体RMSE、縦軸は高値側MAEの変化率なので、左下ほど交換の小さい条件です。重み付けとリサンプリングは左下に近く、分位点回帰は全体RMSEの増加が大きい右側へ移ります。HuberとL1では、高値側と全体の両方が悪化しました。
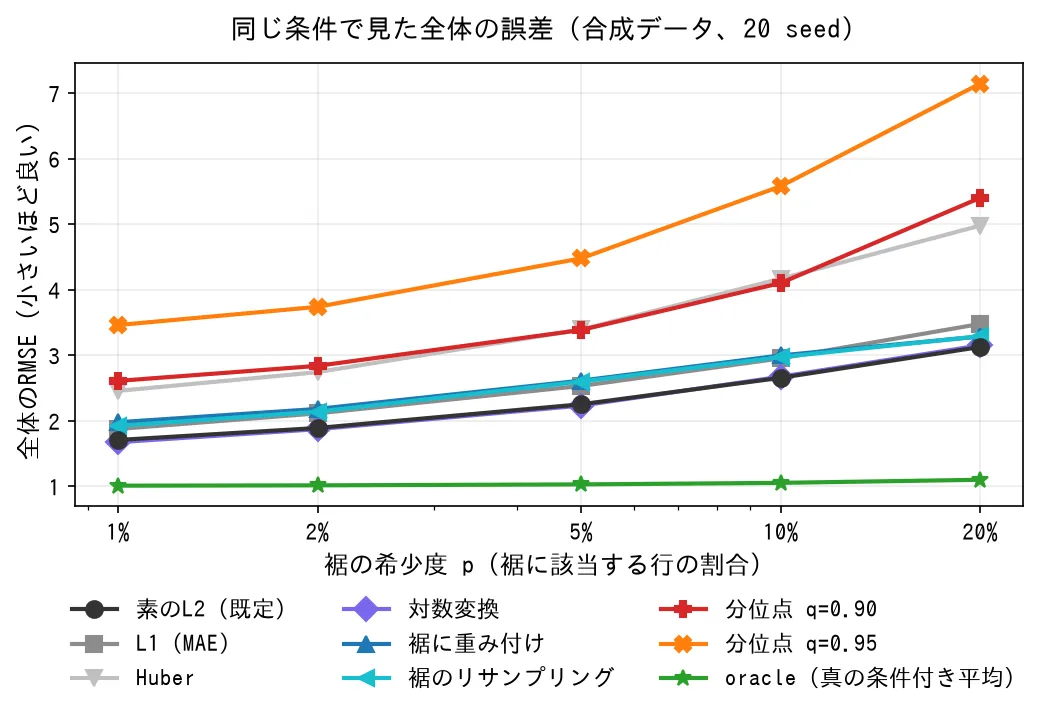
高値側の発生率pを上げると大きな値の行が増えるため、全体RMSEはどの条件でも高くなります。条件どうしを比べる際は、同じpの列だけを見る必要があります。分位点回帰q=0.95の増加が特に大きく、p=20%ではL2の3.124に対して7.144でした。
重み付けとリサンプリングの差は確認できなかった
重み付けとリサンプリングは、どちらも学習時に高値側の影響を強める方法です。「裾:裾以外 = 1:1」に強さをそろえて比べると、裾のMAEの差は0.034でした。
当初は条件ごとのばらつきと平均差を比べていましたが、ほかの条件と同じくシードごとの対応差で計算し直しました。対応差の標準偏差は0.067で平均差0.034より大きく、重み付け側に符号がそろったのも20回中12回。2条件が等しいと示したわけではないものの、選択の根拠にできる差は確認できませんでした。
高値側へ加える幅を6から25へ変えても、交換の向きは同じだった
p=5%に固定し、高値側へ加える幅を6(通常部分の標準偏差の1.32倍)、12(2.65倍)、25(5.52倍)へ変えました。表の左側は高値側MAE、右側は全体RMSEです。
| 跳ね上がり幅 | 裾MAE 素のL2 | 裾MAE 重み付け | 裾MAE q=0.95 | 裾MAE oracle | 全体RMSE 素のL2 | 全体RMSE 重み付け | 全体RMSE q=0.95 |
|---|---|---|---|---|---|---|---|
| 6 | 2.328 | 1.752 | 1.652 | 0.963 | 1.672 | 1.764 | 3.655 |
| 12 | 4.786 | 3.109 | 2.758 | 1.036 | 2.249 | 2.610 | 4.476 |
| 25 | 10.926 | 5.027 | 5.370 | 1.114 | 3.712 | 4.802 | 6.412 |
加える幅が大きくなるにつれてL2の高値側MAEは増えましたが、oracleは0.963から1.114の範囲に収まりました。取り除けないばらつきが同じだけ増えたのではなく、L2と理論上の基準との差が広がっています。ただし木の本数は既定の100本に固定しており、損失や重みの影響とモデル容量の不足までは切り分けていません。
全体RMSEの順位は3水準で共通し、重み付けはL2をわずかに上回り、分位点q=0.95では大きく増えました。高値側MAEだけなら重み付けとq=0.95の順位が入れ替わりますが、全体への影響まで含めると、3水準とも重み付けのほうが交換を小さく抑えています。
補正なしの対数変換では、高値側MAEが増えた
右に歪んだ目的変数への定番の対処として条件に入れたので、悪化する方向へ振れるとは見込んでいませんでした。補正なしの対数変換は、合成データのp=5%で裾のMAEを4.786から5.115(+6.9%)へ増やしています。住宅価格データでも同じ向きで、データセットの単位のまま76,145から94,070(+23.5%)へ悪化しました。
合成データでは全体RMSEがほぼ動きません(-0.9%)。全体を保ったまま、高値側だけが少し悪くなる形です。実データはもっとはっきりしていて、高値側と同時に全体RMSEも30,662から33,337(+8.7%)へ増えました。「全体は保ったまま高値側も直る」という都合のよい選択肢ではなかった、というのが今回の結果です。
測定したのは、log1pで目的変数を変換して学習し、予測後にexpm1でそのまま元の尺度へ戻す実装です。対数上の平均を単純に戻すと元の尺度では低めになりやすく、これは再変換バイアス(retransformation bias)と呼ばれます。Duanのsmearing推定量などの補正は試していないため、対数変換そのものではなく、補正なしの実装に対する結果として扱う必要があります。同じ再変換バイアスが予測合計をどこまで下げるかと、スミアリング補正を加えた結果は、ゼロが多い件数・金額の目的関数を比べた検証で測っています。ゼロが93%の実データでは、補正なしの予測合計が実測合計の0.5%まで下がりました。
recallの改善だけでは、高値予測の精度を判断できない
高値側を当てにいく条件ほど、実際の高値を拾えた割合(recall)は上がります。ただし同時に、高値と予測した行の当たり具合(precision)は下がりました。見逃しを減らしたぶん誤検知が増えていないか、2つを対にして確認します。
| 条件 | recall | precision |
|---|---|---|
| 素のL2 | 0.413 | 0.785 |
| L1(MAE) | 0.268 | 0.828 |
| 対数変換 | 0.386 | 0.826 |
| 裾に重み付け | 0.671 | 0.559 |
| 裾のリサンプリング | 0.665 | 0.567 |
| 分位点 q=0.90 | 0.723 | 0.519 |
| 分位点 q=0.95 | 0.802 | 0.471 |
q=0.95では実際の高値の80.2%を検出できた一方、高値と予測した行が実際にも高値だった割合は47.1%です。予測全体を高めに寄せればrecallだけは上がりやすいので、この列だけを見て高値予測が良くなったとは言えません。
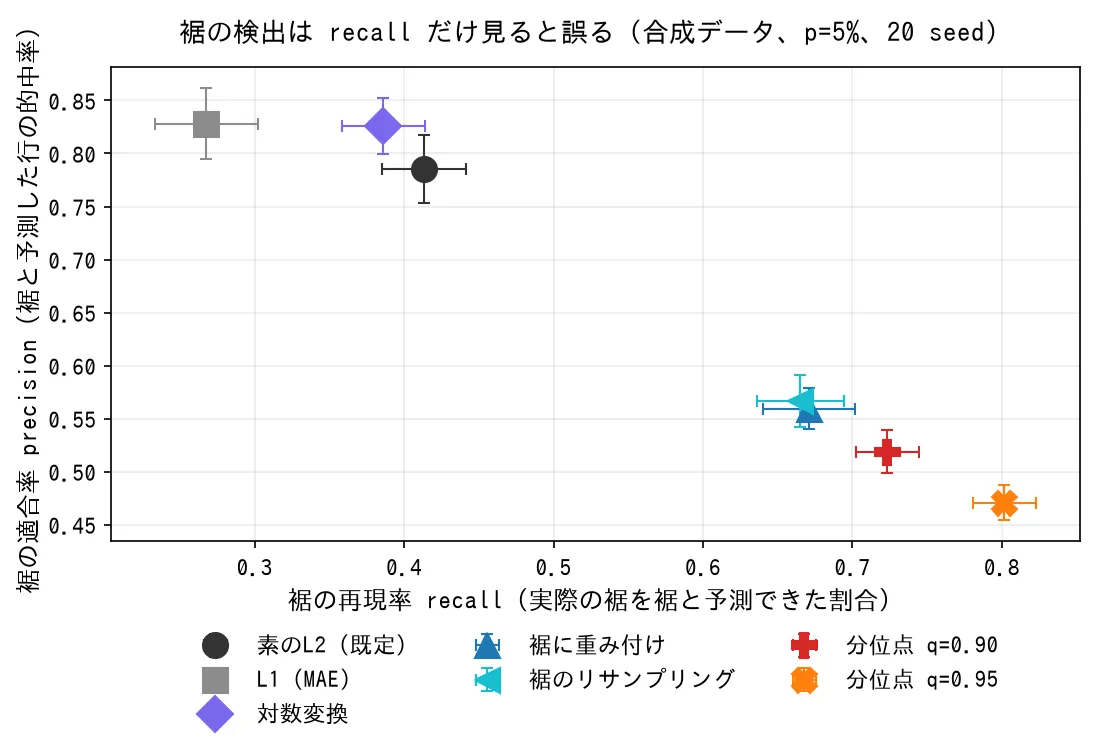
Huberはこの図に入っていません。20回すべてで高値と予測した行が0件になり、precisionを計算できなかったためです。
既定Huberでは高値予測が0件となり、alphaを上げると改善した
合成データのp=5%では、Huberの裾MAEは素のL2より112.6%増えました。既定値では、合成データのp=10%以下と実データの全水準で、高値と予測した行が0件でした。 0件でなかったのは合成データのp=20%だけで、それでも高値側を拾えた割合は0.045にとどまります。
既定値の影響を確かめるため、LightGBMのalphaに対応する境目を0.9 / 2 / 5 / 10 / 20の5水準で追加測定しました。この値は、小さな誤差と大きな誤差の扱いを切り替える位置です。対象は合成データのp=5%、シード0〜4で、既定値0.9の高値側MAEは5回平均で10.047でした。
| Huberのdelta | 裾のMAE(seed 0-4の5回平均) | 裾と予測した行数 | recall |
|---|---|---|---|
| 0.9(既定) | 10.047 | 0.0 | 0.000 |
| 2.0 | 7.593 | 68.0 | 0.153 |
| 5.0 | 4.870 | 179.2 | 0.390 |
| 10.0 | 4.655 | 204.6 | 0.422 |
| 20.0 | 4.698 | 203.4 | 0.428 |
境目を5〜10へ上げると、高値側MAEは同じ5シードで測ったL2の4.723と同程度まで下がりました。加えた値12に対して既定値0.9が小さく、高値側の誤差を強く反映できなかったという解釈と整合します。調整後のHuberはほかの条件と同じ20シードでは比較していないため、順位までは判断できません。
平均MAEが改善しても、大きく外れる行は残った
平均の差は、1行ごとに何が起きているかまでは映しません。合成データのseed=0、p=5%(tau=9.61)で、テストの高値側を実測値の大きい順に並べた上位5行です。
| 順位 | 実測y | 素のL2 | 裾に重み付け | 分位点 q=0.95 |
|---|---|---|---|---|
| 1 | 24.37 | 11.11 | 14.81 | 14.29 |
| 2 | 23.33 | 11.37 | 11.57 | 15.64 |
| 3 | 23.08 | 21.10 | 19.58 | 24.49 |
| 4 | 22.62 | 8.97 | 12.86 | 15.44 |
| 5 | 22.42 | 20.31 | 19.48 | 21.81 |
最大の実測値24.37に対して、L2の予測は11.11でした。重み付けでは14.81、分位点q=0.95では14.29まで上がったものの、なお10近い差が残ります。3番目の行ではL2でも23.08に対して21.10まで予測できており、高値側の中でも誤差は一様ではありません。4番目の行のように、重み付け後も実測22.62に対して12.86にとどまるケースもありました。
平均MAEの改善は、高値側の全行が同じ程度まで改善したことを意味しません。 採用前には集計値に加え、誤差の大きい行と誤差分布も確認します。
住宅価格データでは、評価範囲によって分位点回帰の向きが変わった
合成データで良かった条件が、実データでも同じ向きに効くとは限りませんでした。特に分位点回帰は、上位20%を見るか上位1%を見るかで改善と悪化が入れ替わります。分位点回帰を使うなら、qは狙う範囲ごとに測り直してください。 別の条件で良かった値をそのまま持ち込むと、過大予測へ振れる場合があります。
住宅価格データ(22,784行)にも同じ評価を適用しました。数値はデータセットの単位のままです。実データでは真の条件付き平均が分からないため、oracleの基準線はありません。以下にp=5%、テスト側で高値側に入った350件の結果を示します。
| 条件 | 裾のMAE | 裾の変化率 | 全体RMSE | 全体の変化率 |
|---|---|---|---|---|
| 素のL2 | 76,145 | 0% | 30,662 | 0% |
| 対数変換 | 94,070 | +23.5% | 33,337 | +8.7% |
| 裾に重み付け | 58,728 | -22.9% | 37,462 | +22.2% |
| 分位点 q=0.90 | 63,002 | -17.3% | 40,981 | +33.7% |
| 分位点 q=0.95 | 64,816 | -14.9% | 50,219 | +63.8% |
住宅価格データでも、重み付けは分位点回帰より小さい全体RMSEの増加で、高値側MAEを改善しました。 リサンプリングも重み付けに近く、裾のMAEは59,124、全体RMSEは37,009です。
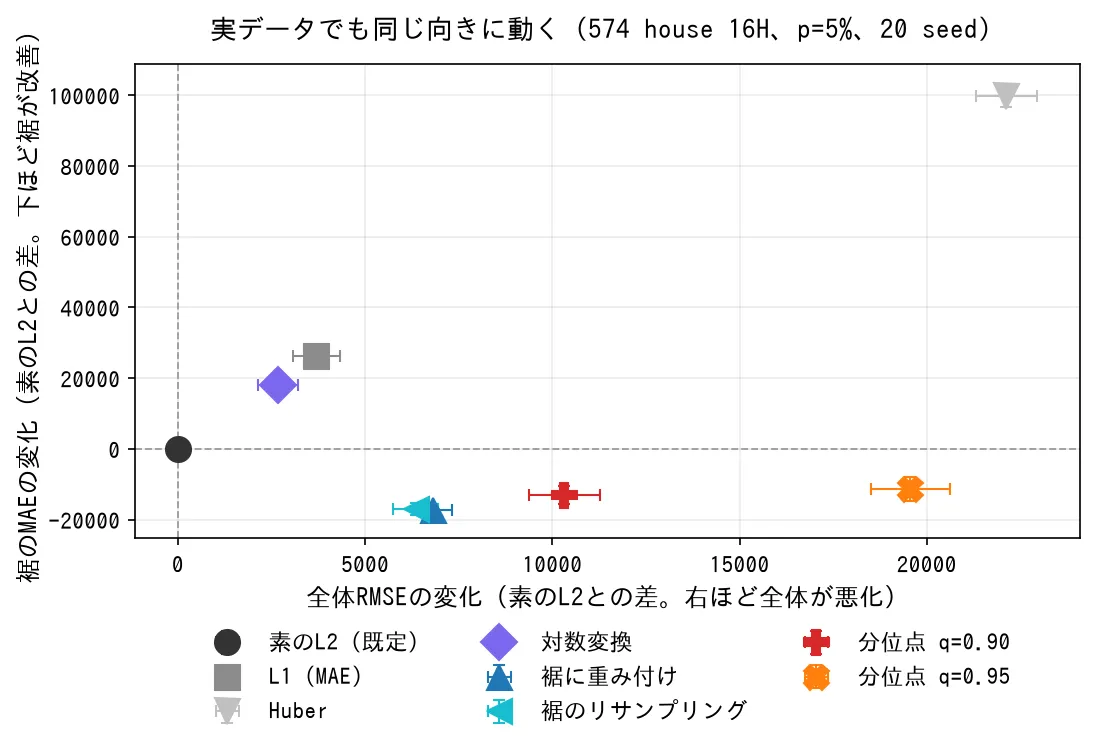
同じデータでも、高値側の範囲を変えると順位が入れ替わりました。以下は評価対象だけを上位20%・5%・1%へ変えたときの裾のMAEです。テスト側で高値側に入った行は、順に平均1,374.5件、350件、67.5件でした。
| 条件 | 上位20% | 上位5% | 上位1% |
|---|---|---|---|
| 素のL2 | 40,289 | 76,145 | 172,198 |
| 対数変換 | 45,140 | 94,070 | 215,762 |
| 裾に重み付け | 37,805 | 58,728 | 132,119 |
| 分位点 q=0.90 | 48,339 | 63,002 | 122,839 |
| 分位点 q=0.95 | 56,338 | 64,816 | 105,420 |
上位20%のq=0.90はL2より20.0%悪化し、符号付き平均誤差も+21,190と過大予測でした。同じ範囲で重み付けは改善し、リサンプリングも38,156と近い値です。一方、上位1%では分位点回帰の高値側MAEが最も低くなります。合成データのp=20%ではL2の3.847に対してq=0.90が2.370だったため、同じ「上位20%」でも合成データと実データで結果の向きが逆でした。
損失だけを変える条件では、全体RMSEは高値側の切り方に左右されず、どの水準でもp=5%の表と同じ値です。重み付けは学習時の高値側の定義が変わるため、上位1%で39,364(+28.4%)となりました。リサンプリングも同様に水準ごとに変わります。上位1%で裾MAEが最も低かったq=0.95の全体RMSEは50,219(+63.8%)でした。
実データの上位20%は、合成データのように段差を持つ集団ではなく、目的変数が比較的大きい行の集合です。q=0.90が過大予測になったのは、この構造差が影響した可能性があります。ただし、これは観測結果に基づく解釈であり、原因を直接測定したものではありません。
高値側を直したいとき、どこから手を付けるか
対策へ進む前に、次の3つをこの順で片付けます。
- 範囲を決めて、対策前の2つの値を測る。 先に決めるのは範囲です。上位何%を高値側とするか。そのうえで高値側MAEと全体RMSEを同じテストデータで測り、基準として残します。上位20%と上位1%では対象となる行の性質が違い、同じ方法でも結果が変わりました。
- どこまで動かしたいかと、許容できる交換幅を決める。 高値側MAEをどれだけ下げたいか、そのために全体RMSEの増加をどこまで許せるかを、基準値を見ながら決めます。今回の8条件には、両方が同時に改善した方法はありませんでした。
- 重み付けから試し、基準値からの変化を見る。 学習データの高値側へ重みを付けるところから始めます。今回の比較では分位点回帰より全体RMSEの増加を抑えられました。ただし、リサンプリングとの差は確認できていません。
ほかの方法へ広げるときは、手法ごとに気をつける点が変わります。
分位点回帰は評価範囲ごとにqを振り直す。 狙う範囲を決めてから、その範囲ごとにqを変えます。同じ住宅価格データでも上位20%と上位1%で順位が変わったため、一つのqをそのまま流用しません。
対数変換は、戻し方まで含めて1条件。 元の尺度へ戻す方法を込みで評価します。今回測った補正なしの実装は悪化しましたが、補正を加えた場合までは検証していません。
Huberは既定値だけで結論を出さない。 高値側の誤差幅に合わせてalphaを動かします。高値と予測した行が0件なら、MAEやRMSEだけでなく、この設定も見直す対象です。
詳しい検証条件
高値側は、学習データの目的変数yから求めた境界値tau以上の行と定義しました。たとえば上位5%を調べる場合は、学習データの95パーセンタイルを境界にします。テストデータは境界の計算やリサンプリングには使わず、同じデータ分割では8条件すべてを共通の高値側で評価しています。
合成データでは、特徴量から判別できる一部の行だけ目的変数へ値を加えました。通常部分の標準偏差4.53に対して、主な比較で加えた値は12です。上昇幅は6・12・25の3段階でも追加確認しました。
各条件は、乱数の初期値を変えてデータ生成または分割から20回繰り返しています。統計的検定は行わず、差の方向が20回で安定しているか、平均差が繰り返し間のばらつきより十分大きいかを確認しました。
読み飛ばし可: 再現用のパラメータと、実施済みの再現性チェック
- 分割は学習70 : テスト30。LightGBMは既定パラメータのまま(木100本)で、条件ごとの個別チューニングはしていません。スレッド数は1に固定しました。
- 合成データの観測ノイズは標準偏差1で、高値側へ加える値にも標準偏差1のばらつきを加えました。取り除けないばらつきは合計で約1.4です。
- 合成データでは、各行の真の条件付き平均をそのまま返す理論上の基準(実験コード上の
oracle)も同じ方法で評価しました。 - 重み付けとリサンプリングは、高値側と残りの影響が1:1になるよう強さをそろえました。分位点回帰のqは高値側の割合に連動させず、0.90と0.95へ固定しています。
- 最初に取得した実データ候補は目的変数の上限に4.7%が集中し、上位5%がほぼ同じ値になっていたため不採用としました。
- 跳ね上がり幅は主掃引で12に固定し、別途 p=5% のもとで6 / 12 / 25 の3水準を掃引しました。跳ねていない部分の標準偏差4.53は2,000万件のモンテカルロで求めた値です。
- 裾を潜在的な「本当に跳ねた行」で定義するか、観測された y の分位点で定義するかは迷った点です。実務では前者が見えないので後者を採りました。合成データでの両者の一致率は診断値として残していて、p=1%で0.990、p=20%で0.930でした。
- 決定性の確認として、seed=3・p=5% のセルを別プロセスで再実行し、保存済みの値と1e-9未満で一致することを確認しています。
- 内部整合の確認として、跳ね上がり幅の掃引の12のセルと、希少度の掃引の p=5% のセルは同じ条件になるはずなので突き合わせ、主要指標が完全一致(最大絶対差0.0)することを確認しています。
適用範囲と限界
今回の結論が効くのは、右に裾を持つ表形式データの回帰を、LightGBMの既定同士で比べた範囲です。採用の判断を変えうる制約を、重い順に挙げます。
- 実データは住宅価格の1データセットのみです。 合成データと実データで分位点回帰の向きが割れたことからも分かるとおり、データが変われば効き方の符号まで変わりえます。
- 対策の強さは1点ずつしか振っていません。重みは「裾:裾以外 = 1:1」だけ、分位点はq=0.90とq=0.95だけで、狙う高値側の薄さを変えてもqは動かしていません。中間の強さなら交換比が変わる可能性がありますが、測っていません。
- 木の本数などのモデル容量は、既定の100本に固定しています。 基準のモデルに学習不足が残っていないかは確認していないので、「高値側を当てるには全体を犠牲にするしかない」とまでは言えません。容量側の設定は高値側と全体を同時に動かしうるため、この交換を受け入れる前に確認する余地があります。
- 対数変換で測ったのは補正なしの逆変換のみ、Huberのdelta走査は5回のseedによる診断のみです。どちらも他条件と同じ20回の枠組みには乗せていません。
- 高値側を分類器で先に見つけてから回帰する二段構成や、不均衡回帰の専用手法は今回の比較に含まれていません。
手元のデータで高値側と全体を測るコード
次のコードでは、L2、重み付け、分位点回帰の3条件を同じ学習・テスト分割で比較し、高値側MAEと全体RMSEを一度に出力します。外部データは不要です。手元のデータへ移す際は、合成データを作る部分だけを自分のXとyへ置き換えられます。
"""稀な高値(裾)をどれだけ外すかを、全体の誤差と一緒に測る最小の例。

必要なもの: pip install numpy pandas scikit-learn lightgbm
実行: python quickstart.py
"""
import numpy as np
import pandas as pd
from lightgbm import LGBMRegressor
from sklearn.model_selection import train_test_split

P_TAIL = 0.05  # 裾の希少度(上位5%を裾とする)
SEED = 0

# --- 稀に大きく跳ねるデータを作る ---
rng = np.random.default_rng(SEED)
n, d = 24000, 12
X = rng.standard_normal((n, d))
bulk = 3 * X[:, 0] + 2 * X[:, 1] - 1.5 * X[:, 2] + 2 * np.sin(2 * X[:, 3]) + 1.5 * X[:, 4] * X[:, 5]
rare_score = 1.2 * X[:, 6] + 0.8 * X[:, 7] ** 2 + 1.5 * X[:, 8] * X[:, 9]
z = (rare_score >= np.quantile(rare_score, 1 - P_TAIL)).astype(int)  # 稀少レジーム
y = bulk + rng.normal(0, 1, n) + z * (12 + rng.normal(0, 1, n))
X = pd.DataFrame(X, columns=[f"x{i}" for i in range(d)])

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=SEED)

# --- 裾の定義: 学習splitの分位点だけで決める(テストは使わない) ---
tau = np.quantile(y_tr, 1 - P_TAIL)
tail_tr = y_tr >= tau
tail_te = y_te >= tau
print(f"裾の閾値 tau={tau:.2f} / 学習の裾 {tail_tr.sum()}件 / テストの裾 {tail_te.sum()}件")

# --- 裾の合計重み = バルクの合計重み になる重み ---
w = np.ones(len(y_tr))
w[tail_tr] = (~tail_tr).sum() / tail_tr.sum()

params = dict(n_estimators=100, random_state=SEED, n_jobs=1, verbose=-1)
models = {
    "素のL2": (LGBMRegressor(objective="regression", **params), None),
    "裾に重み付け": (LGBMRegressor(objective="regression", **params), w),
    "分位点 q=0.90": (LGBMRegressor(objective="quantile", alpha=0.90, **params), None),
}

rows = []
for name, (model, weight) in models.items():
    model.fit(X_tr, y_tr, sample_weight=weight)
    pred = model.predict(X_te)
    err = pred - y_te
    rows.append({
        "条件": name,
        "裾のMAE": np.abs(err[tail_te]).mean(),
        "全体のRMSE": np.sqrt((err ** 2).mean()),
        # 負なら裾を過小予測している(平均へ引かれている)
        "裾の平均誤差": err[tail_te].mean(),
        "裾のrecall": (pred[tail_te] >= tau).mean(),
        "裾のprecision": tail_te[pred >= tau].mean() if (pred >= tau).any() else float("nan"),
    })

print(pd.DataFrame(rows).round(3).to_string(index=False))上のコードをquickstart.pyとして保存し、次のコマンドで実行します。
pip install numpy==2.4.6 pandas==3.0.5 scikit-learn==1.9.0 lightgbm==4.7.0
python quickstart.py
実行結果(このコードの出力)
裾の閾値 tau=9.64 / 学習の裾 840件 / テストの裾 368件
        条件  裾のMAE  全体のRMSE  裾の平均誤差  裾のrecall  裾のprecision
      素のL2  4.550    2.211  -4.247     0.457        0.771
    裾に重み付け  3.134    2.636  -2.438     0.682        0.548
分位点 q=0.90 3.290 3.429 -1.340 0.772 0.525この出力は1回分なので、本文の20回平均とは一致しません。閾値もtau=9.61ではなく9.64です。このコードは24,000件の分位点で高値側を5%に切り、本文の実験では大きな標本から先に求めた固定閾値を使っているため、同じシードでも対象行がわずかに入れ替わります。数値そのものを本文と比べる用途には向きませんが、高値側の平均誤差が負であることと、高値側MAEが下がった条件で全体RMSEが増えることは、この1回でも確認できます。
まとめ: どこから手を付け、次に何を測るか
高値側の予測を直したいなら、最初に比べる価値があったのは重み付けです。今回の条件での話ですが。分位点回帰は、より大きく改善する場合があります。ただし評価範囲によっては悪化へ転じました。狙う範囲ごとにqを検証する前提でなければ、候補に残せません。
この交換を受け入れる前に確かめたいのが、基準モデル側に残っている余地です。今回はモデル容量を既定値に固定しており、木の本数などを見直せば高値側と全体が同時に動く可能性は消えていません。次に測るとしたらここからです。サンプルコードのデータ生成部分を自分のXとyへ置き換えると、同じ比較から始められます。
同じLightGBMの分位点回帰を、点予測ではなく予測区間として使ったときの実測は、90%予測区間のカバレッジを測った検証にあります。LightGBMの既定挙動そのものは、GBDT3種の実測比較で比較しています。