
モデルを2つ試し、テストデータで少しだけ成績の良いほうを採用したくなることがあります。ただ、その差にはモデルの違いだけでなく、どのデータを学習と評価に割り当てたかも関わります。同じ元データでも、分け直すと順位が変わるなら、最初の1回だけでは結果の安定性が分かりません。
分け方を変えるために使うのが、乱数の設定値であるseed(シード)です。train_test_splitのrandom_stateを変え、各モデルを同じ分割で比べ直すと、差の大きさと順位の入れ替わりを確認できます。繰り返す目的は、都合の良いseedを探すことではなく、分割にどれだけ結果が左右されるかを測ることです。
XGBoostとLightGBMをAdultデータで120回比較すると、データを少なくした条件では、平均の成績差が広がったのに順位は入れ替わりやすくなりました。 さらに訓練用と評価用の件数を別々に変えたところ、今回の組み合わせでは評価用を減らしたときに順位が大きく不安定になっています。この違いを手がかりに、手元の比較で何を記録し、どこまで結論にできるかを考えます。
先に結論
- 訓練件数を固定して評価を14,653件から600件へ減らすと、LightGBMの勝率は99.2%から66.7%へ下がりました。訓練だけを減らした場合は98.3%で、同じ「データを減らす」でも結果が異なりました。
- 平均の成績差だけでは、順位の安定性は判断できません。同じ分割で測ったモデル間の差を残し、そのばらつきと、逆転した回数を合わせて確認します。
- 反復で順位が安定していたことと、今後は1回だけで判断してよいことは別です。 今回の比や勝率から、別のデータにも通用する合格ラインは決められません。
AUCは順位付け、正解率は分類結果の当たり方を測る
主に比べたのは、片方のクラスに属するデータへ、もう片方より高い予測スコアを付けられているかです。この順位付けを測る指標をROC-AUCといい、以後はAUCと略します。1に近いほど良く、ランダムに並べたときの基準は0.5です。スコアが高い順に対象を並べる性能を比べられますが、分類した後の見逃しや誤検知の件数までは分かりません。
予測したクラスが正解と一致した割合も測りました。これは正解率(accuracy)で、コードではpredictの結果を使います。AUCが良くても、クラスを決める境目が目的に合わなければ正解率が最も高くなるとは限りません。また、正解率は見逃しと誤検知をどちらも1件の誤りとして数えるため、損失の違いは反映しません。
この記事の「勝率」は、120回の比較のうち、そのモデルのAUCが3モデル中で最大になった割合です。予測が当たった割合でも、新しいデータでそのモデルが勝つ確率でもありません。正解率で決めた1位は、後半で別に扱います。
同じ分割で3モデルを比較し、120回分の差を残す
XGBoostとLightGBMは、条件分岐を重ねた決定木を順に追加して学習する勾配ブースティングの実装です。比較の基準として、特徴量を重み付けして足し合わせた値から確率を求めるロジスティック回帰(LogisticRegression)も加えました。ロジスティック回帰では、特徴量の尺度を揃える標準化を学習データだけで求め、評価データにも同じ変換を適用しています。
データは、機械学習の比較用データを集めたpmlbのAdultです。国勢調査を基に年収が5万ドルを超えるかを分類するデータで、48,842件・14特徴量を使いました。原典のAdultにはカテゴリ変数も含まれますが、今回はpmlbで数値化済みの特徴量をそのまま入力しています。
各回でクラスの割合をおおむね保ちながら、学習用70%と評価用30%へ分けました。この方法を層化分割と呼びます。全件を使う条件に加え、seedごとに2,000件を層化抽出してから同じ割合で分ける小標本条件も用意しました。分割とモデルのrandom_stateには0〜119を渡し、各条件で120回比較しています。
モデル設定は反復の途中で変えず、各回の評価用データは3モデルで共通です。同じ分割での「LightGBMのAUC − XGBoostのAUC」を1つの差として残すことで、分割の難しさを揃えて比較できます。
最初の2条件では学習用と評価用が同時に減るため、あとから件数を別々に変える4条件と、モデルのseedだけを変える確認を追加しました。追加計測は別の機械で実行したので、初回と同じ計算になる条件を120回分照合しています。設定や照合結果の細部は末尾の補足にまとめました。
全件では119回、小標本では97回LightGBMが1位だった
全件を使った条件では、LightGBMのAUCが120回中119回最大でした。2,000件の条件では97回となり、残る23回はXGBoostが1位です。ロジスティック回帰は、どちらの条件でも3モデル中の1位にはなりませんでした。
| モデル | 全件 AUC平均 | 全件 勝率 | 小標本 AUC平均 | 小標本 勝率 |
|---|---|---|---|---|
| LightGBM | 0.9284 | 99% | 0.8922 | 81% |
| XGBoost | 0.9268 | 1% | 0.8880 | 19% |
| LogisticRegression | 0.8531 | 0% | 0.8493 | 0% |
勝率は整数に丸めています。全件の上位2モデルは平均AUCが近いものの、同じ分割での差はほぼ毎回LightGBM側に出ました。対してロジスティック回帰との差は大きく、全件では両モデルとも120回すべてでAUCが上回っています。
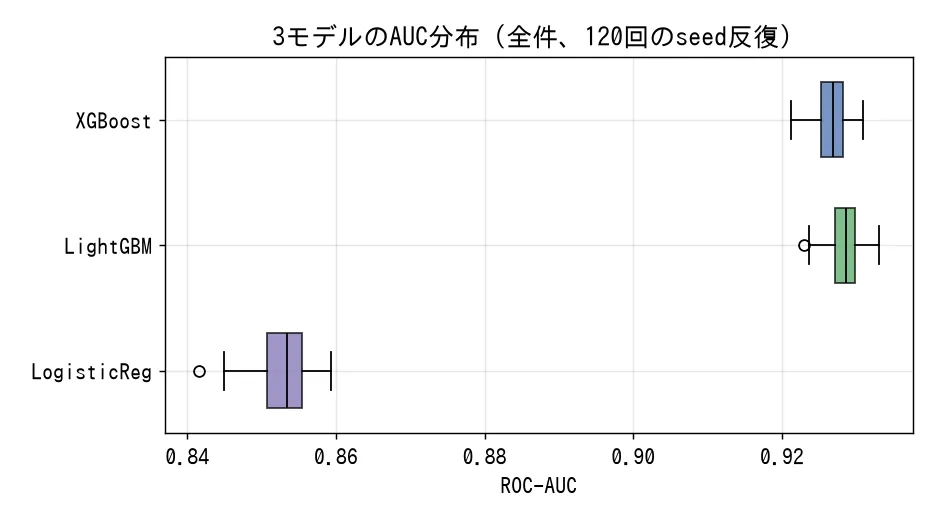
図1はモデルごとの点数の広がりです。範囲が重なっているだけでは、同じ分割でどちらが上だったかは分かりません。順位の安定性を調べるには、次のように分割ごとのペアの差を見る必要があります。
小標本では平均差が広がっても、逆転が増えた
LightGBMからXGBoostを引いたAUC差の平均は、全件の+0.0015に対して、小標本では+0.0041でした。平均差が大きいのに逆転も増えたのは、差のばらつきがそれ以上に大きくなったためです。
ばらつきは、各回の差が平均の周りにどれくらい広がるかを表す標準偏差で確認しました。全件では0.0007、小標本では0.0054です。平均差の大きさをこの標準偏差で割ると、2.3から0.77へ下がります。これはモデルごとの点数の標準偏差ではなく、同じ分割で測ったモデル間の差の標準偏差です。
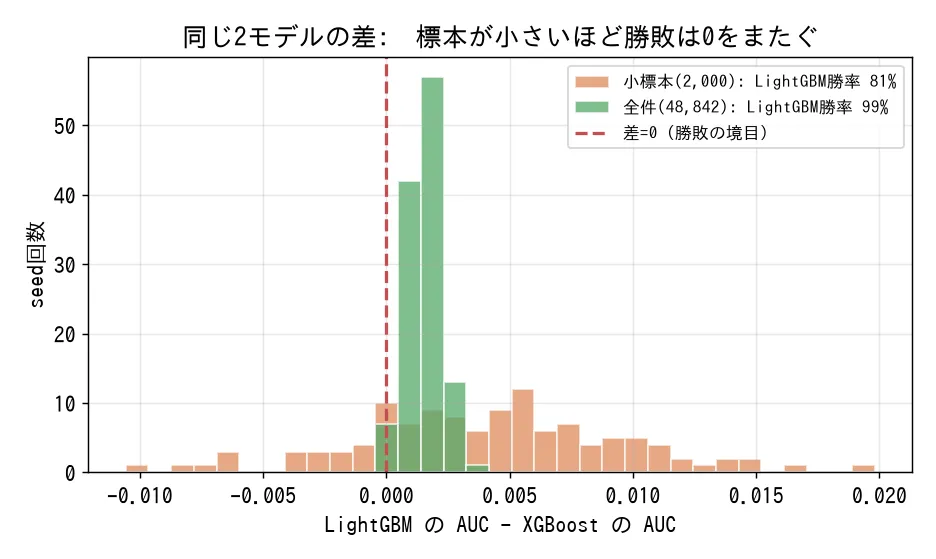
図2で0より小さい回は、LightGBMとXGBoostの順位が逆転した回です。全件でも1回ありましたが、小標本では23回あり、単に「差が0をまたいだか」だけでは両条件を区別できません。
全件で唯一逆転したseed 22では、XGBoostのAUCが0.9288、LightGBMが0.9287で、丸める前の差は0.00016でした。この1回だけならXGBoostが上という報告になります。119回対1回という内訳は、分割を繰り返したからこそ確認できたものです。
設計時には、上位2モデルの勝率が50%付近まで分かれるかも確認項目にしていました。実際には小標本でもLightGBMが約8割を占め、同程度の頻度で勝つ結果にはなっていません。
評価件数だけを減らすと、順位の逆転が大きく増えた
2,000件の条件は、訓練1,400件と評価600件を同時に小さくしています。順位の変化にどちらが関わったかを確かめるため、訓練件数と評価件数を別々に変える4条件を追加しました。
seedごとに全体を一度だけ7対3へ分け、その訓練部分から1,400件、評価部分から600件を取り出しています。小さい集合を大きい集合の一部にすることで、件数以外の違いを抑えて比較しました。条件Dは先に2,000件を抽出した前節とはデータの取り方が違うため、件数が同じでも結果は一致しません。
| 条件 | 訓練 | 評価 | 平均差 | 差の標準偏差 | 平均差÷標準偏差 | LightGBM勝率 |
|---|---|---|---|---|---|---|
| A | 34,189 | 14,653 | +0.0015 | 0.0007 | 2.32 | 99.2% |
| B | 34,189 | 600 | +0.0016 | 0.0035 | 0.46 | 66.7% |
| C | 1,400 | 14,653 | +0.0038 | 0.0018 | 2.08 | 98.3% |
| D | 1,400 | 600 | +0.0037 | 0.0052 | 0.71 | 73.3% |
評価だけを減らしたA→Bでは、平均差はほぼ同じ水準でも、差の標準偏差が大きくなりました。訓練件数が多いままでも、評価600件では順位が安定しなかった点が、この追加比較の重要な結果です。
訓練だけを減らしたA→Cでも、差のばらつきは増えています。ただ、平均差も広がったため、平均差÷標準偏差はAに近い水準にとどまりました。訓練件数がばらつきに影響しなかったわけではありません。 今回は、評価を減らす場合と同じ方向に勝率が下がらなかったという結果です。
当初の集計は標準偏差だけを並べていましたが、それではCのばらつきが増えても勝率があまり変わらない理由を説明できませんでした。平均差を標準偏差で割る列を追加すると、4条件では比の大きい順と勝率の高い順が一致しました。比は結果を読み解く補助になりますが、比の値だけから勝率を一意に求められると確認したわけではありません。
ばらつきを分散で比較した結果
標準偏差を2乗した値を分散と呼びます。評価件数を減らしたときの差の分散はA→Bで28.0倍、C→Dで8.0倍でした。訓練件数を減らした場合もA→Cで7.6倍、B→Dで2.2倍になっています。
A→Cでは平均差も2.5倍に広がりました。平均差とばらつきを同じ尺度で比較するため、本文の表では分散ではなく標準偏差で割っています。
比較の基準にしたロジスティック回帰でも、相手によって逆転はあった
全件ではロジスティック回帰と他の2モデルに大きな差がありましたが、小標本ではXGBoostとの平均AUC差が0.0388、差の標準偏差が0.0154となりました。120回中1回は、ロジスティック回帰がXGBoostを0.0037上回っています。
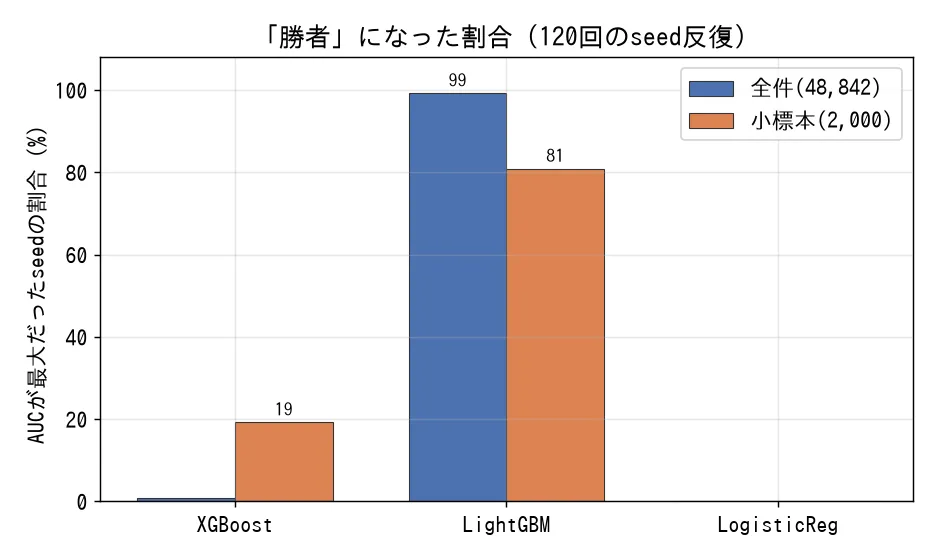
ロジスティック回帰が3モデル中で1位にならなかったことと、XGBoostを一度も上回らなかったことは別です。候補全体の1位の回数に加え、採用を迷っている2モデルの差を直接確認すると、この違いを把握できます。
分割固定・モデルseed変更の30回では、AUCは変わらなかった
ここまでの120回では、データを分けるseedとモデルのrandom_stateを一緒に変えています。どちらが結果に関わったかを確認するため、分割をseed 0で固定し、モデル側だけ0〜29へ変えました。全件・小標本の両条件で、3モデルとも30回すべて同じAUCでした。
逆にモデル側を固定し、抽出・分割のseedを変えると、30回すべてでAUCが異なりました。標準偏差は全件で0.0022〜0.0025、小標本で0.0136〜0.0147です。これらはモデルごとのAUCのばらつきで、前節までのモデル間の差のばらつきとは区別します。
この確認ではモデルseedによるAUCの変化は観測されず、抽出・分割を変えた側で変動が出ました。ただし、分割を固定した確認はseed 0での30回です。この結果だけで、あらゆる分割・設定の変動を100%分割由来と断定することはできません。 AUCが同じでも、個々の予測確率まで同一とは限りません。
今回の木モデルは、行や特徴量をランダムに間引く設定を有効にしていません。とはいえ、random_stateがどの処理に関わるかは実装や設定によります。例えばLightGBMの公式パラメータ説明には、特徴量を区間に分ける際のデータ抽出にもseedがあると記載されています。「既定設定なら常にseedが使われない」という一般則にはせず、結果が変わるかを条件ごとに確認します。
AUCと正解率では1位が異なり、正解件数の差は小さかった
AUCで1位になったモデルと、正解率で1位になったモデルが一致しない回は、全件で13回、小標本で42回ありました。正解率では全件のXGBoostが12回、小標本のロジスティック回帰が5回1位になっています。これらの回数には同点時の処理も含まれ、集計では同点のモデルを配列の先頭順に1つ選んでいます。
1位が一致しなかった回に限ると、LightGBMとXGBoostの正解率差の絶対値は、中央値で全件0.00027、小標本0.00500でした。評価件数を掛けると、正解した件数の差はそれぞれ4件分と3件分です。これは正解数の差であって、2モデルで予測ラベルが異なった件数ではありません。
具体的には、全件のseed 13でLightGBMのAUCは0.9284、XGBoostは0.9273でしたが、正解率はXGBoostが0.8728、LightGBMが0.8724でした。正解率差は0.00041、正解件数では6件分です。同じ分割で測っても、スコアの順位付けと分類結果の正しさではモデルの順序が異なりました。
差が数件分だからといって、運用上も同等とは判断できません。 どの対象を誤ったかや、誤りの損失はこの集計では確認していません。数値上の1位だけでなく、その差が採用理由になる大きさかも別に判断します。
手元のデータで順位の安定性を確認する手順
-
評価指標と採用条件の決定
スコアの順位付けを比べるならAUC、分類結果の当たった割合を比べるなら正解率など、目的に合う指標を先に決めます。どの程度の差なら変更する価値があるかも考え、結果を見てから都合の良い指標へ切り替えないようにします。
-
データ分割の設計
各モデルを同じ訓練・評価データで比較できるようにします。ランダムな層化分割は今回の比較条件であり、時系列や同じ対象の重複記録があるデータには、その構造に合った分け方が必要です。
-
分割ごとの成績とペアの差の保存
まずはサンプルの100回設定で、分割を変えて比較する手順を試せます。各回の指標値、モデル間の差、seedを残してください。100回がどの問題にも十分だと検証したわけではなく、反復回数は計算時間と結果の安定性を見て検討します。
-
平均差・ばらつき・逆転割合の確認
同じ分割での差から平均と標準偏差を求め、差が正・負・0だった回数も確認します。平均的に良いモデルがあっても、一部の分割で逆転するなら、その頻度を併記します。比が1未満だから「同等」とする、といった一律の線引きはしません。
-
採用判断と最終評価の分離
平均差の実務上の大きさと、分割による変動の両方を基に候補を判断します。この反復結果を使ってモデルを選ぶなら、そのデータは選択用です。最終成績を報告するための未使用データは別に確保します。選択と最終評価を分ける考え方は、scikit-learnの評価手順でも説明されています。
手元のデータで差と逆転割合を出すコード
scikit-learn同梱の乳がん診断データ569件を使い、データの追加取得なしで比較手順を試すコードです。実行にはNumPy、scikit-learn、XGBoost、LightGBMが必要で、検証に使った版は記事末の検証環境に記載しています。Adultとは別のデータなので、モデルの順位や差が本文と一致することを確かめる例ではありません。
Xは特徴量、yは正解ラベルです。stratify=yでクラスの割合を保って分割し、predict_probaの2列目からラベル1の予測確率を取り出してAUCを計算します。モデルごとの配列には、同じ順序で各seedの成績が入ります。
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from lightgbm import LGBMClassifier
from xgboost import XGBClassifier

# 手元のデータで試すなら、この行をX・yの読み込みに置き換える
X, y = load_breast_cancer(return_X_y=True)

N_SEEDS = 100  # 分割を変えて比較する回数
names = ["XGBoost", "LightGBM", "LogisticRegression"]


def build(name, seed):
    if name == "XGBoost":
        return XGBClassifier(n_jobs=1, random_state=seed, verbosity=0)
    if name == "LightGBM":
        return LGBMClassifier(n_jobs=1, random_state=seed, verbose=-1)
    return make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000, random_state=seed))


aucs = {n: [] for n in names}
for seed in range(N_SEEDS):
    # 分割seedとモデルseedに同じ値を渡す
    Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, stratify=y, random_state=seed)
    for name in names:
        m = build(name, seed)
        m.fit(Xtr, ytr)
        aucs[name].append(roc_auc_score(yte, m.predict_proba(Xte)[:, 1]))

auc = {n: np.array(aucs[n]) for n in names}

# 勝者(AUC最大のモデル)がseedごとにどれだけ入れ替わるか
mat = np.column_stack([auc[n] for n in names])
winners = [names[i] for i in mat.argmax(axis=1)]
print("勝者になった割合:")
for n in names:
    print(f"  {n:20s} {winners.count(n):3d}/{N_SEEDS}")

# 上位候補ペアの差を、大きさとばらつきの比で見る
d = auc["LightGBM"] - auc["XGBoost"]
sd = d.std(ddof=1)
flipped = min(np.mean(d > 0), np.mean(d < 0)) * 100  # 多数派と逆に出たseedの割合

print(f"\nLightGBM - XGBoost の平均差 = {d.mean():+.4f}  差の標準偏差 = {sd:.4f}")
print(f"  平均差 / 標準偏差 = {abs(d.mean()) / sd:.2f}  (大きいほど順位が動きにくい)")
print(f"  多数派と逆に出たseed = {flipped:.0f}%")
print(f" 差の範囲 [{d.min():+.4f}, {d.max():+.4f}]")dには各回の「LightGBM − XGBoost」の差が入り、プラスならLightGBM、マイナスならXGBoostが上回っています。d.mean()は平均差、d.std(ddof=1)は差の標準偏差です。比の計算では平均差の絶対値を使うので、どちらが良かったかは平均差の符号で読みます。
「多数派と逆に出たseed」は、差が正だった割合と負だった割合の小さいほうです。平均差と合わせて読むと、平均的に上回ったモデルと、上回った回数の多いモデルをそれぞれ確認できます。
同点と、標準偏差が0の場合の読み方
argmaxは同点なら最初の要素を返します。コードの1位集計では、XGBoost、LightGBM、LogisticRegressionの順が同点時に優先されます。ペアの逆転割合では差が0の回を正・負のどちらにも数えていないため、同点がある場合はその回数も別に確認してください。
差の標準偏差が0なら、掲載コードの比の計算はゼロ除算になります。その場合は比を判断に使わず、平均差と同点・逆転の回数を確認します。すべて同点の場合でも、このコードの1位集計では先頭モデルに回数が集まる点に注意が必要です。
適用範囲と限界
- Adult 1種を数値化済みの状態で使い、既定設定に近い3モデルを比べた結果です。別のデータ、カテゴリ変数の別の扱い方、設定を調整したモデルの順位は測っていません。
- 120回は同じ元データの分け直しで、評価に同じ行が再登場します。新しいデータを120組集めた比較ではなく、分割に対する安定性を見ています。
- 評価件数を何件まで増やせば順位が安定するかは調べていません。評価600件という値を、別のデータにも通用する十分・不十分の境界にはできません。
- ランダムな行・列抽出を有効にしたモデルや、別のライブラリ版・計算環境でのモデルseedの影響は測っていません。
詳しい検証条件
反復は当初、RandomForestを含む4モデル・200回で設計していましたが、共有4コア環境でマルチスレッド実行が途中終了したため、3モデル・120回・スレッド1に変更しました。初回の計測日は2026-07-26、訓練・評価件数を分けた4条件とモデルseedの確認は2026-08-23です。
モデル設定、追加実験、異なる環境での照合
- 分割は
train_test_split(test_size=0.3, stratify=y, random_state=seed)です。最初の小標本条件はseedごとに層化抽出した2,000件を分割しています。追加4条件は全件を分割した後に訓練用・評価用をそれぞれ小さくしたため、両者の小標本の結果は直接つながりません。 - モデルは
XGBClassifier(n_jobs=1, random_state=seed, verbosity=0)、LGBMClassifier(n_jobs=1, random_state=seed, verbose=-1)、make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000, random_state=seed))です。設定を最適化する探索はしていません。 - AUC差の標準偏差は
ddof=1で計算しています。図2は120個の差の度数分布で、平滑化や分布の当てはめはしていません。モデルseedだけを変えた確認では、AUCの値の種類は1つで、標準偏差1.1e-16〜2.3e-16は同じ値を集計した際の浮動小数点演算の誤差です。 - データの取得元はpmlb(EpistasisLab/pmlb、MITライセンス)のAdultで、原典はUCI Machine Learning Repositoryです。
- 追加計測はApple M1・macOS 15.7.3 arm64で実行し、ライブラリの版は初回のx86_64 Linux環境と同一に固定しました。初回と同じ計算になる条件Aを120回分照合すると、LightGBMとLogisticRegressionのAUC・正解率は全回でビット単位まで一致しました。XGBoostは正解率が全一致、AUCは33回で最大1.28e-8の差がありました。今回扱うAUC差の1e-3〜1e-2より小さく、1位の内訳も1対119で一致したため、並べて比較しています。
まとめ
採用を迷うモデルの比較では、平均的にどちらが良いかと、分割を変えても同じ順位になるかを分けて確認します。順位が安定していても、差が小さければ運用上の利点まで確認できたわけではありません。指標、評価件数、平均差、逆転した回数を一緒に残すと、1回の点数だけでは説明できない判断の根拠を共有できます。