
健康診断の記録を機械学習にかけるとします。同じ人が3年分の行を持っていて、表は1人1行になっていません。ECの購買ログでも、同じ顧客の注文が何件も並びます。
こうしたデータで手元の成績を測るとき、グループを無視して行単位で切り分けると、同じ人の行が学習側と答え合わせ側の両方に入ります。答え合わせに使われるのは、初めて見る人の行ではなく、学習ですでに見た人の別の行です。それでも警告もエラーも出ず、成績はむしろ良くなるので、スコアだけを見ていると分割の問題に気づきにくくなります。
この記事が測るのは、学習に一度も登場しなかった新しい対象への予測性能です。 次に来院する患者、まだ取引のない顧客を当てにいく場面を想定しています。既存の顧客について将来を予測する場面は、使ってよい過去情報も時間順序も別に考える必要があり、今回は測っていません。
手元の成績は交差検証で測ります。データをK個の束に分け、1束を伏せて残りで学習し、伏せた束で答え合わせをします。伏せる束を1つずつずらしてK回繰り返し、K個の成績を平均したものが交差検証の値で、この束1つをfoldと呼びます。束の作り方を決めているのが、交差検証に渡す分割器です。KFoldかStratifiedKFoldかは好みの問題に見えますが、1行が独立な1事例でないデータでは、好みでは済まなくなります。
分割器の選択が効くもう1つの場面が、クラスが大きく偏るデータです。少数派が全体の数%しかないと、機械的にK等分するだけの分け方では、束ごとの少数派の数がそろいません。極端な場合には少数派が1件も入らない束ができます。
この2つは別の問題です。前者は同じ対象の行が学習側と検証側にまたがるかどうか、後者は1つの束が全体の縮図になっているかどうかで、混同すると対処を間違えます。知りたかったのは、ずれの幅がどの桁に来るかです。構造が分かるように仕込んだ合成データを2種類用意して、それぞれ別々に測りました。
先に結論: 甘くなるのはグループ、層化が守るのはfoldの中身
- 同じ対象の行をグループを無視して分けると、新規グループでの評価スコアより高い値が出た。当て具合を表すROC-AUCで、今回の合成データでは平均+0.085
- 対象単位でまとめるGroupKFoldなら、指定したグループが両側にまたがる件数は全シードで0件。CV推定も独立評価スコア付近へ
- クラスが大きく偏るデータで層化が縮めたのは、分割ごとの少数派割合のばらつき(5分の1前後まで)。手元の平均スコアのズレのほうは、今回の信頼区間が0をまたぎ、差の有無を判断できなかった
- 同じ対象の行が複数あり、未知の対象への性能を測るならGroupKFold。グループも時間の制約もない分類ならStratifiedKFoldが基本の候補。KFoldは、グループの分離やクラス比の維持を保証しない
- 測ったのは合成データの2値分類・5分割交差検証、分類器はランダムフォレスト(グループ構造のデータ)とロジスティック回帰(不均衡データ)
比べる分割器は3つ、成績はROC-AUCひとつ
主役はscikit-learnの分割器3つです。KFoldはデータを機械的にK等分するだけ。StratifiedKFoldは各foldのクラス比を全体の比にできるだけ近づけます(これを層化と呼びます)。GroupKFoldは指定したグループの行が同じfoldにまとまるように分け、同一グループが学習側と答え合わせ側へ割れないようにします。
前者2つのように行単位で分ける方法を「グループを無視した分割」、GroupKFoldのようにグループごとまとめる方法を「グループ単位の分割」と呼びます。ここでいうグループは、健康診断の例なら1人の3年分の行にあたるまとまりです。同一ユーザーの複数ログや、名寄せ前の重複行も同じ扱いになります。
分割器を明示しなければ、分類器で目的変数が二値または多クラスの場合、cvに整数やNoneを渡すとStratifiedKFoldが選ばれます。KFoldになるのは、自分で渡したときです。
成績はROC-AUCで測ります。正例を負例より高いスコアで並べられる度合いで、0.5がでたらめと同じ、1が完璧です。
比較の基準には、学習にも交差検証にも一度も使わないデータで測った成績を置き、これを独立評価スコアと呼びます。これも有限のデータで測った推定値であって、真の汎化性能そのものではありません。CVから独立評価を引いた値を差と呼び、正ならCVのほうが高く、負ならCVのほうが低いという向きで使います。
グループの問題とクラス偏りは、別のデータで別々に測る
グループの問題とクラス偏りの問題を1つのデータで同時に測ると、どちらが効いたのか分かりません。そこで合成データを2種類作り、場面を分けました。
1つ目はグループ構造を持たせたデータです。200個のグループがそれぞれ2〜5行を持ち、同じグループの行は互いに酷似します。ラベルはグループ内で共通です。独立評価スコアは、学習に一切登場しない新規120グループで測りました。
2つ目は少数派クラスが6%前後の不均衡データです。学習に使うのは500件と300件の2規模で、独立評価には同じ分布から作った2万件を別に取ってあります。生成パラメータと実測の少数派比は、後半の「詳しい検証条件」に置きました。
比べたのは、1つ目のデータで3つの分割器すべて、2つ目は層化の有無が主題なのでKFoldとStratifiedKFoldの2つです。分類器は、グループ内の行を細かく覚えられるランダムフォレスト(1つ目)と、ロジスティック回帰(2つ目)。分割数はどちらも5で、データ生成のシードを20個振っています。
グループを無視して分けると、新規グループでの評価スコアより高く出た
同じ人の酷似した行が学習側にあると、答え合わせ側の行はもう初めて見る行ではありません。本来テスト時に使えない情報が学習側へ紛れ込み、手元の成績がその分だけ上がります。これがリークです。
独立評価スコアはROC-AUC 0.871でした。表の差はシードごとに引き算してから平均した値で、CV推定も20シードの平均です。いちばん右は、同一グループが学習側と答え合わせ側の両方に現れた数を1foldあたりで数えています。
| 分割器 | CV推定 | 差(CV − 独立評価) | またがりグループ数(1foldあたり) |
|---|---|---|---|
| KFold(層化なし) | 0.956 | +0.085 | 約104 |
| StratifiedKFold(層化あり) | 0.955 | +0.084 | 約103 |
| GroupKFold(グループ単位で分割) | 0.851 | -0.020 | 0 |
この差はグループの混入だけで決まっていません。 CVでは各モデルを学習プールの約8割で学習し、独立評価では全体で学習しているので、学習量の違いと評価データ自体のばらつきも差に含まれます。
高く出た理由は、いちばん右の列に出ています。KFoldとStratifiedKFoldでは1foldあたり約104グループが両側に現れていました。学習プールは全部で200グループですから、毎回その半数強がまたがっていた計算になります。層化はクラス比を揃えるだけでグループには関知しないので、StratifiedKFoldもKFoldとほぼ同じだけ高く出ています。GroupKFoldは混入を全シードで0件に抑え、CV推定は独立評価スコア付近まで下がりました。
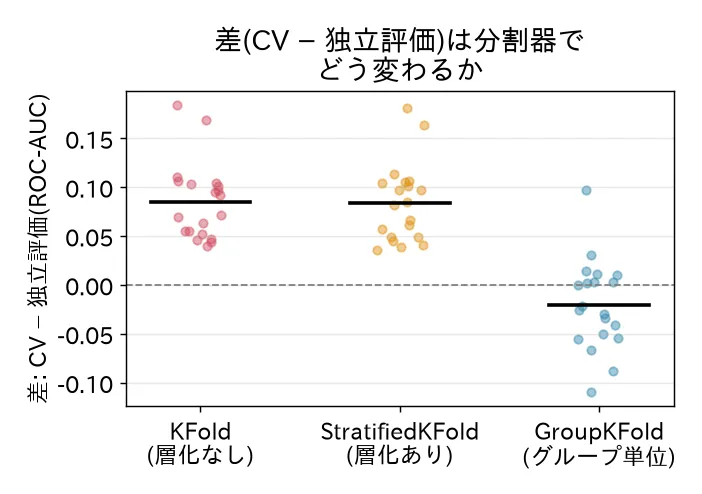
差の幅そのものは条件しだいで動きます。同じシリーズのデータリーク5パターンの検証では、データの作り方もモデルも違うため+0.059でした。どちらもその条件での大きさであって、一般的な目安ではありません。ただ、グループ単位に分ければ同一グループが両側へ割れることは定義上ありえないので、混入が0になる構造のほうは値の大小に関係なく成り立ちます。
独立評価0.753のモデルが、KFoldでは0.937に見えたシード
平均+0.085は20シードをならした値なので、1本を取り出します。差が最も大きかったseed 45では、新規グループでの独立評価スコアがROC-AUC 0.753、交差検証は0.937でした。差にして+0.184です。GroupKFoldなら0.783に収まります。
手元の0.94を見て本番の性能を見積もっていたなら、実際に新しい人へ当てたときの値は0.75前後だったことになります。
不均衡データで層化が守ったのは、平均スコアではなくfoldの中身
少数派6%前後の不均衡データでは、層化の有無で何が変わったのか。「少数派割合の標準偏差」は検証foldの少数派割合について求めた標準偏差、「絶対誤差の平均」は差(CV − 独立評価)の絶対値で、どちらも20シードの平均です。「単一クラスfold」は20シード×5foldの計100foldのうちの件数を数えています。
| 条件 | 少数派割合の標準偏差 | 絶対誤差の平均 | 単一クラスfold |
|---|---|---|---|
| 500件・KFold | 0.0253 | 0.033 | 0 |
| 500件・StratifiedKFold | 0.0038 | 0.031 | 0 |
| 300件・KFold | 0.0261 | 0.032※ | 2 |
| 300件・StratifiedKFold | 0.0059 | 0.027 | 0 |
※単一クラスになったfoldは、学習も評価も行わずに除外して平均しています。300件のKFoldで該当する2シードは4fold平均となり、StratifiedKFoldの5fold平均とは条件が異なります。
検証foldの少数派割合は、層化でそろった
StratifiedKFoldは検証foldの少数派割合のばらつきを、500件でKFoldの0.0253から0.0038まで抑えました。0.0253は割合にして約2.5ポイントの散らばりです。0.0038なら、0.4ポイント弱に収まります。
層化が近づける先は、そのプールの実際の少数派比です。各foldの少数派の数は整数なので完全には一致せず、割り切れない端数はfoldごとに散ります。少数派の件数が分割数より少なければ、層化してもすべてのfoldへ少数派を入れることはできません。次の図は代表シード1本で、この比率は6〜7%でした。この1本ではKFoldが3%から9%まで散らばり、StratifiedKFoldは6〜7%に収まっています。500件の20シード全体では、KFoldが1〜12%、StratifiedKFoldが4〜9%の範囲でした。
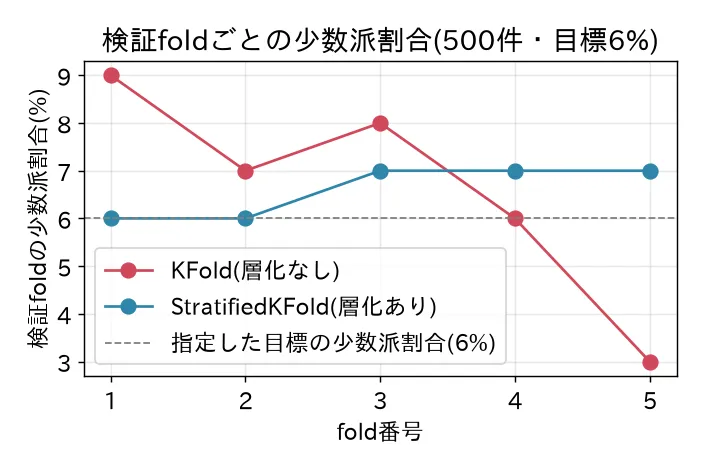
クラス比はそろいました。では、CVと独立評価のずれも小さくなったのでしょうか。
手元の平均スコアのズレには、差を確認できなかった
絶対誤差の差(KFold − StratifiedKFold)は、500件で+0.0019、95%信頼区間が-0.0070〜+0.0109でした。正ならKFoldの絶対誤差が大きいことを表しますが、この区間は0を含んでいます。300件も+0.0053(区間-0.0049〜+0.0144)で同じでした。今回の結果では、層化によって絶対誤差が小さくなったと明確には言えません。 差がないことを示したわけでもありません。表に載せていない各foldのROC-AUCのばらつきも同じ状況です。
誤差の向きのほうは、集計前の見立てを外しました。書き留めていたのは「CVは甘い側に出る」で、根拠にしたのは最初に目を通した1シードの誤差が正だったことです。20シードのうちで符号が混在しているのを見ていませんでした。
符号付きの差(CV − 独立評価)は、500件でKFoldが-0.0173、StratifiedKFoldが-0.0157と、両方式とも平均で低めに出ています。300件はKFoldが-0.0012、StratifiedKFoldが+0.0065で符号が分かれました。不均衡データのCVが一方向へずれるとは言えません。 前の節で高く出たのは、グループがまたがったときの話です。
300件では、層化なしのKFoldが計算できないfoldを作った
層化のもう1つの効き目は、単一クラスfoldの列に出ています。300件・少数派6%前後(20シードの陽性は平均20.0件、10〜32件)では、素のKFoldが検証foldに少数派を1件も含まない単一クラスのfoldを作りました(100foldのうち2件)。StratifiedKFoldは同じ条件で0件です。発生したseed 44とseed 54の陽性は21件と14件で、陽性が特に少ないシードだけで起きたわけではありません。
片方のクラスしかないfoldでは、ROC-AUCを定義できません。ただし定義できないことと、交差検証が止まることは別です。 この記事の環境(scikit-learn 1.9.0)で3通りの呼び出しを試すと、いずれも止まりませんでした。
| 呼び出し | 1.9.0での結果 |
|---|---|
roc_auc_scoreを直接呼ぶ | UndefinedMetricWarningを出してnanを返す |
cross_val_scoreの既定 | 該当foldがnanになるだけで、他のfoldは評価が続く |
cross_val_scoreにerror_score="raise" | 同上。metric自体が例外を投げないため、指定しても止まらない |
止まらないほうが厄介です。返ってきた配列を.mean()すると全体がnanになり、そこでnanmeanへ替えれば、少数派を含まないfoldを黙って捨てた平均が出てきます。なお500件では、どちらの分割器も単一クラスfoldは0件でした。
実務では、まず何を予測したいのかを決める
先に決めるのは、評価したい対象 同じ対象の行が複数あり、未知の対象への性能を知りたいなら、その対象を単位に分けます。健康診断の例なら、人単位です。1人1行で行どうしが独立しているデータなら、未知の対象を当てる場面でもこの手当ては要りません。既存の顧客について将来を予測したいなら、使ってよい過去情報と時間順序を別途考える必要があり、この設定は今回測っていません。
グループも時間の制約もない分類なら、基本の候補はStratifiedKFold クラス比を保つぶん、素のKFoldより条件が安定します。KFoldは、グループの分離もクラス比の維持も保証しません。
分割器を替えて、推定がどれだけ動くかを見る グループの候補列をGroupKFoldに渡し、KFoldのときとCV推定を比べます。分割方法に対する感度の点検で、大きく動いたなら、そのデータでは分割の設計が結論を左右します。
ただし、その差をリークの効果量として読んだり、本番性能の補正値に使ったりはできません。今回の合成データでは、2つの分割器の差(0.105)のほうが独立評価スコアに対する差(0.085)より大きく出ています。GroupKFold自体が独立評価スコアをわずかに下回る側(平均-0.020)へ寄るためで、シードごとに見ると大きさも向きも定まりませんでした。GroupKFoldが防ぐのは、指定したグループが両側にまたがることだけです。 渡し忘れた列によるリークも、前処理を分割の外でかけたことによるリークも、防ぎません。
少数派が数十件のデータでは、層化の有無が計算の可否に効く 層化なしのKFoldは単一クラスのfoldを作ることがあり(今回は300件・100foldのうち2件)、そのfoldのROC-AUCはnanになります。既定では停止しないので、平均を取る前にfoldごとのスコアを確認してください。
グループ構造とクラス偏りが両方あるなら、優先するのはグループ単位の分割 またがりを許すと、層化で得たfold構成の均一さより先に、リークのほうが結論を壊します。両立を狙うStratifiedGroupKFoldという分割器もありますが、今回は測っていません。グループをまたがせない制約があるぶん、クラス比が完全にそろうとも限らない点にも注意してください。
詳しい検証条件: 2つの合成データの作り方と集計
グループ構造のデータは、グループごとに1つ用意した特徴の元になる数値の並び(潜在ベクトル)に小さなノイズを足して、同一グループの行を作っています。ラベルはグループ内で共通で、ラベル境界の係数も学習プールと独立評価用で共通にしました。学習プールは200グループ、独立評価用は学習に一切登場しない新規120グループです。
不均衡データはmake_classificationで作った15次元の2値分類で、少数派クラスの比率を6%に指定しました。6%は生成時の目標値です。実測の少数派比は学習プールの平均で、500件が6.72%(4.4〜8.2%)、300件が6.67%(3.3〜10.7%)でした。独立評価用の2万件は、学習プールと同一のmake_classification呼び出しから行方向に分割して作っています。make_classificationは既定で行を並べ替えてから返すため、この行分割は並べ替え後の先頭と残りを分ける形になります。同一の生成過程から取った別サンプルだ、というところまでが実装で確認できる範囲です。
分割器は、KFoldとStratifiedKFoldをいずれもshuffle=True・random_stateはそのシードの値で作っています。GroupKFoldはn_splitsのみの指定です。統計の独立単位はデータ生成シード(20個)で、各シードで5分割交差検証を回し、シードごとの値の平均と95%信頼区間を出しました。分割器どうしの差は、同じシードの値をペアにしてから計算しています。表と図の値は、この20シードの実行で書き出したログから集計しています。多重比較の補正はしておらず、探索的な比較です。
不均衡データの表に置いた「絶対誤差の平均」は絶対値を取った量なので、甘い側と辛い側を混ぜた大きさであって、偏りそのものではありません。偏りの向きは符号付きの平均のほうで見ています。
読み飛ばし可: ブートストラップ・生成パラメータ・細目の数値
- 不確実性はブートストラップ(B=10,000、seed=42)で「シード単位の値」に対する平均・95%信頼区間として算出。シードを引き直したときにこの平均がどれだけ動きうるかの幅です。
- 不均衡データの生成パラメータは
flip_y=0.01・class_sep=0.9です。 - グループ構造のデータのグループ内ノイズは、潜在ベクトルに対して標準偏差0.35です。
- 乱数シードはデータ生成・モデルとも固定。同一コードの再実行で集計値が一致することを確認しています。
- seed 45の同一グループの混入は、5foldを合わせて延べ529グループです(foldごとに数え直しているので、同じグループが何度も数えられます)。
- 単一クラスfoldが出た2シード(44・54)をまるごと除いて18シードで集計し直すと、300件の絶対誤差はKFoldが0.0277、StratifiedKFoldが0.0224でした。大小関係は変わりませんが、これは感度の確認であって、差があることの根拠にはなりません(18シードでの差の区間も-0.0059〜+0.0156で0をまたぎます)。
- 単一クラスfoldの扱いは、scikit-learnのバージョンと設定で変わります。1.5.2では
roc_auc_scoreの直接呼び出しとerror_score="raise"を付けたcross_val_scoreがValueErrorで停止しましたが、cross_val_scoreの既定はこの版でも停止せず、該当foldにnanが入りました。確認したのは1.9.0と1.5.2の2つだけです。 - 分割器どうしの差(0.105)と独立評価スコアに対する差(0.085)の食い違いは、シードごとに-0.097から+0.109まで動きます。差のほうが広く出たのが20シード中12回、狭く出たのが8回でした。
- 同シリーズのデータリーク5パターンの検証の+0.059は、学習プールの30%の行に微小ノイズ付きの複製行を足したデータでLightGBMを使った結果です。こちらは200グループが2〜5行ずつを持つデータでランダムフォレストなので、条件が違います。
適用範囲と限界
- すべて合成データでの傾向です。実データでは、グループ内の似かた・グループ数・少数派比によって効果の大きさが変わります。今回観測した差の幅や単一クラスfoldの頻度は、そのまま一般化できません。
- 測ったのは、学習に登場しない新規グループへの性能です。既存の対象について将来を予測する設定は扱っていません。時間順序があるデータの分割(
TimeSeriesSplitなど)も範囲外です。回帰・多クラス分類も測っておらず、今回は2値分類だけを扱いました。 - 層化の効果をCV平均のズレで測った部分は、差の95%信頼区間が0をまたぎました(500件で-0.0070〜+0.0109、300件で-0.0049〜+0.0144)。差の有無を判断できていません。必要な標本数を見積もる検出力の分析はしていないので、何シードあれば判定できたかは分かりません。
- 両方の場面に、独立評価とCVの学習量の非対称があります。独立評価用のモデルはプール全体で学習し、CVの各foldのモデルはその5分の4(不均衡データの500件なら400件)で学習しています。GroupKFoldが独立評価スコアをわずかに下回る側(平均-0.020)に寄ったことも、不均衡データのCV平均が低め(500件で-0.017前後)に出たことも、この非対称と整合します。ただし学習量を振った測定はしていないので、機序は確かめていません。グループ数がごく少ないと、この下振れは大きくなりえます。
- 信頼区間は多重比較の補正をしていない探索的な比較です。 補正した場合にどの区間が0を含むようになるかは計算していません。0をぎりぎり外している区間(GroupKFoldの-0.020や500件の符号付き誤差)と、0を大きく外している少数派割合のばらつきの差(+0.0215、95%信頼区間0.0175〜0.0257)を、同じ強さの根拠として扱わないでください。
- 単一クラスfoldの発生は規模と少数派比に依存する実測で、500件では観測されず300件で2件でした。これより小さい/偏るデータでの頻度は外挿になります。
- 分類器は不均衡データがロジスティック回帰、グループ構造のデータがランダムフォレストに限った結果です。別のモデルでは差の幅が変わりえます。グループ内の行を細かく覚えられるモデルほど強く出ると考えられますが、モデルの内部で何が起きているかは測っていません。
手元で動かす: 分割器を替えると何が変わるか
同じ考え方を手元で確かめられる完全なコードです。scikit-learnとNumPyで動き、データは合成なので取得は要りません。前半でグループ構造のデータ(グループを無視して分けるか、グループ単位で分けるかでCV推定がどれだけ変わるか)、後半で不均衡データ(層化の有無で検証foldの少数派割合がどう変わるか)を再現します。
これは1シードのデモで、本文の集計とは別物です。 本文は20シードを振った平均ですが、デモで回すのは乱数の並び1本だけです。再現できるのは分割器の比較と少数派割合の見え方までで、本文の不均衡データのROC-AUC比較そのものは含みません。
"""交差検証の分割器で推定がどれだけ変わるかを合成データで確かめる完全デモ。"""
import numpy as np
from sklearn.datasets import make_classification
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import GroupKFold, KFold, StratifiedKFold, cross_val_score

rng = np.random.default_rng(42)


# グループ構造を持つ合成データ(同一グループの行は互いに酷似する)
def make_grouped(n_groups, id_start, w):
    X, y, g = [], [], []
    for i in range(n_groups):
        z = rng.normal(size=10)                   # グループの潜在ベクトル
        label = int(w @ z + rng.normal() > 0)     # ラベルはグループ内で共有
        for _ in range(int(rng.integers(2, 6))):  # 1グループあたり2〜5行
            X.append(z + rng.normal(scale=0.35, size=10))  # 潜在ベクトル + 小ノイズ
            y.append(label)
            g.append(id_start + i)
    return np.array(X), np.array(y), np.array(g)


w = rng.normal(size=10)
X, y, groups = make_grouped(200, 0, w)        # 学習プール
Xh, yh, _ = make_grouped(120, 100_000, w)     # 新規グループ(独立評価用)

rf = RandomForestClassifier(n_estimators=100, random_state=42, n_jobs=1)
# グループを無視して行単位で分割する交差検証(グループがtrainとtestにまたがりリークする)
kf = cross_val_score(rf, X, y, cv=KFold(5, shuffle=True, random_state=42), scoring="roc_auc")
# グループ単位で分ける交差検証(同一グループは片側だけに入る)
gkf = cross_val_score(rf, X, y, groups=groups, cv=GroupKFold(n_splits=5), scoring="roc_auc")
# 独立評価: プール全体で学習し、学習に一切出ない新規グループで評価
rf.fit(X, y)
holdout_auc = roc_auc_score(yh, rf.predict_proba(Xh)[:, 1])

print(f"KFold(グループ無視) CV = {kf.mean():.3f}")
print(f"GroupKFold          CV = {gkf.mean():.3f}")
print(f"新規グループでの独立評価 = {holdout_auc:.3f}")


# 不均衡データで層化の有無による検証foldの少数派割合を比べる
Xi, yi = make_classification(
    n_samples=500, n_features=15, n_informative=5, n_redundant=3,
    n_clusters_per_class=1, weights=[0.94, 0.06], flip_y=0.01,
    class_sep=0.9, random_state=42,
)
print("\n検証foldごとの少数派割合(%):")
for name, cv in [("KFold     ", KFold(5, shuffle=True, random_state=42)),
                 ("Stratified", StratifiedKFold(5, shuffle=True, random_state=42))]:
    fracs = [round(float(yi[te].mean()) * 100, 1) for _, te in cv.split(Xi, yi)]
    print(f"  {name}: {fracs}")
上のコードを cv_split_demo.py として保存し、必要なライブラリを入れて実行します。
pip install scikit-learn==1.9.0 numpy==2.4.6
python cv_split_demo.py
この合成データは記事本文とは別の乱数の並びなので、絶対値は本文の集計と一致しません。手元(scikit-learn 1.9.0 / NumPy 2.4.6)で実行すると、KFoldのCVが0.962、GroupKFoldが0.872、新規グループでの独立評価が0.922でした。StratifiedKFoldの検証foldの少数派割合は5つとも7.0%でした。KFoldは2.0〜10.0%に散っています。
そろう先が6%ではなく7.0%なのは、weightsで指定した6%が目標値だからです。ラベルを少しだけ反転させるflip_yと乱数のぶれによって、実際の少数派比が目標から動きます。
この出力は固定シードでの1回の結果です。シードを変えれば値は動きますし、KFoldとGroupKFoldの大小がこの1本と同じ向きになる保証もありません。その向きが安定しているかどうかを確かめたのが、本文の20シードです。
まとめ
同じ人の行を分けずに交差検証すると、新しい人へ当てたときの成績より高い値が出ました。今回の合成データでの差は平均0.08前後、20シード中で最大のものはその倍以上です。分割器の選択は好みではなく、何を新しい対象とみなして評価するかの宣言だと考えたほうが安全です。
層化のほうは、平均を補正する道具ではなく、その手前で各foldの構成を整える道具でした。クラス比はそろえても、CVと独立評価のずれが縮まったとは言えていません。
手元で確かめるなら、groupsに渡せそうな列を1つ選び、cvをGroupKFoldへ替えて回すだけです。数字がほとんど動かなければ、少なくともこのデータでは分割の単位が推定を変えていない、というところまでが言えます。動いたなら、分割の設計が結論を左右するデータだったということです。ただし動いた幅そのものは、実際のずれと大きさも向きも一致しません。感度を知る目的にとどめてください。