
Pythonの分析スクリプトには、上から下まで読んで自然なのに間違っている、という種類のものがあります。例外も出ず、テストも通り、手元の採点も高く出る。それでも本番へ載せると精度が落ちます。学習してはいけない情報が学習側へ流れ込み、モデルが答えを覗き見た状態で点数がついているからです。データリークと呼ばれる問題です。
困るのは、コードが壊れていないことです。lintでも型チェックでも捕まらず、数字だけがきれいに嘘をつきます。だから人が読んで見つけるしかないのですが、これが見つけにくい。以前、代表的なリークを合成データに仕込んで、見かけのスコアがどれだけ持ち上がるかを測りました。そのとき用意したリーク版のコードも、1行ずつ見れば自然でした。正しい版との違いは、特徴量から外し忘れた列が1本あるか、分割の仕方が違うか、学習前の加工を分割の前に置いたか、といった目立たない箇所だけです。
ではAIに読ませたらどうか。コードレビューをAIに任せる話は増えていますが、私が探した範囲では、正解が分かっている機械学習の罠を用意して検出率を測った記録は見当たりませんでした。そこで6種類のリークを仕込んだコードを書き下ろし、Claude Codeが何回見抜くかを数えました。
先に結論: 難しくしても検出は落ちず、増えたのは誤検知のほう
- Claude Code(Sonnet 5)は、仕込んだデータリークを70回中69回で、どこがなぜリークになるかまで言い当てた。
- 前処理を一つにまとめる、分割をグループ単位にするといった定番の対策が書かれているのに効いていないコードでも、この6種類ではほぼ取りこぼさない。
- 代わりに、正しく書いたコードをリークだと疑う指摘が出る。件数は少なく、傾向として確定できる規模ではない。
- 対策が書かれていない、見つけやすいほうのコードでも、Haiku 4.5 では取りこぼしが出た。安いモデルに落とすなら検出漏れを見込む。
- 読ませたのは合成データで書き下ろした44〜65行の単体スクリプト24本、リーク6種類、依頼2条件で各3回ずつ。
数えたのは検出と誤検知の2つ
この記事に出てくる回数は2種類です。リークを仕込んだコードで、どの列が・どの処理の順番で・どう学習側へ流れ込むかという筋道まで述べられた回が検出。リークの無いコードを「リークがある」と指摘した回が誤検知です。この筋道のことを、以下では機序と呼びます。
読ませたコードは、1つのリークにつき2本の対で用意しました。リークを仕込んだ版と、それを直した版です。この対の作り方を2通り試しています。易しい版は、対策が書かれていないコードと書かれているコードの対。難しい版では、対策そのものを両方のコードに同じ形で書き、効いているかどうかだけを変えました。
手元の採点には交差検証(データを何組かに分け、一部で学習して残りで採点することを繰り返す手順)を使います。リークが入ると、この採点だけが実力より高く出ます。
モデルはClaude CodeのCLIをヘッドレス(画面を開かず、-p に依頼文を渡して1回だけ実行する形)で呼びました。使ったのはSonnet 5と、比較用のHaiku 4.5です。考える量の設定であるeffortはmediumで固定しています。
読むのに要るのは、機械学習のコードを目で追える程度の知識です。仕込んだリークは6種類あり、どれも何が起きるかを一文で添えてあります。
難度を上げる手は、対策を両方のコードに書くことだった
読ませたのは24本のスクリプトで、モデルと難度の組み合わせは3つです。この形に落ち着くまでに、一度作り直しています。
最初は安いモデルで測るつもりでした。Haiku 4.5で試した手ごたえはちょうどいい難度で、そのまま記事にしようとしていました。ところが同じテストをSonnet 5に投げ直したら、難度が足りず測定器として成立しなくなりました。
そこで、対策が書いてあるのに効いていないコードで測り直すことにしました。表面の手がかりを全部「対策済み」に揃えれば、パターン一致だけのレビューは通らないはずでした。
読ませたのは、この実験のために書き下ろした分析スクリプトです。患者の再入院、店舗の需要予測、住宅の成約といった実務でありがちな題材を模していますが、データはすべて乱数から生成した合成データで、実データではありません。1本あたり44〜65行の単体スクリプトです。
仕込んだリークは6種類で、易しい版と難しい版で同じ機序を使っています。
- 目的変数の派生列が残る(解約予測): 集計レポート用に作った列が、特徴量から除外されないまま残っている
- 時系列をランダム分割(需要予測): 自己相関のある系列にラグ列を与えているのに、時間順を無視して分割している
- 同一個体が分割をまたぐ(再入院予測): 1人が複数回受診した記録で、患者を区別せずに分割している
- 分割前に特徴量を選択(不良検知): 63本のセンサ列から効くものを選ぶ処理を、分割前に全データで行っている
- 分割前にSMOTE(不正検知): 少数派クラスを増やす処理を、分割前に全データへ適用している
- 分割前にカテゴリを集計(成約予測): 市区町村ごとの成約率を全データで計算して特徴量にしている
比べたのは3つの組み合わせです。Haiku 4.5に易しい版、Sonnet 5に易しい版、そしてSonnet 5に難しい版。それぞれで、依頼の仕方2条件 × 12ケース × 3反復を回しました。12ケースはリークを仕込んだ6本と、対になる正しい6本です。依頼は、狙いを言わない「問題があれば指摘してください」と、狙いを言う「データリークがないか確認してください」の2つを用意しました。あわせて、1回あたりの指摘件数、所要時間、費用も記録しています。
測ったのは、リークが入ったコードを指摘できるかどうかだけです。見つけたあとに正しく直せるかは見ていません。ほかに測っていない範囲は、記事末の適用範囲と限界にまとめました。
難しい版でも検出は落ちず、正しいコードへの指摘が増えた
Sonnet 5 は、易しい版でも難しい版でもほぼ取りこぼさなかった
Sonnet 5 は易しい版で36回中36回、機序まで言い当てました。難しい版でも34回中33回です。つまり、対策の名前が正しく書いてあるだけのコードは素通りしませんでした。
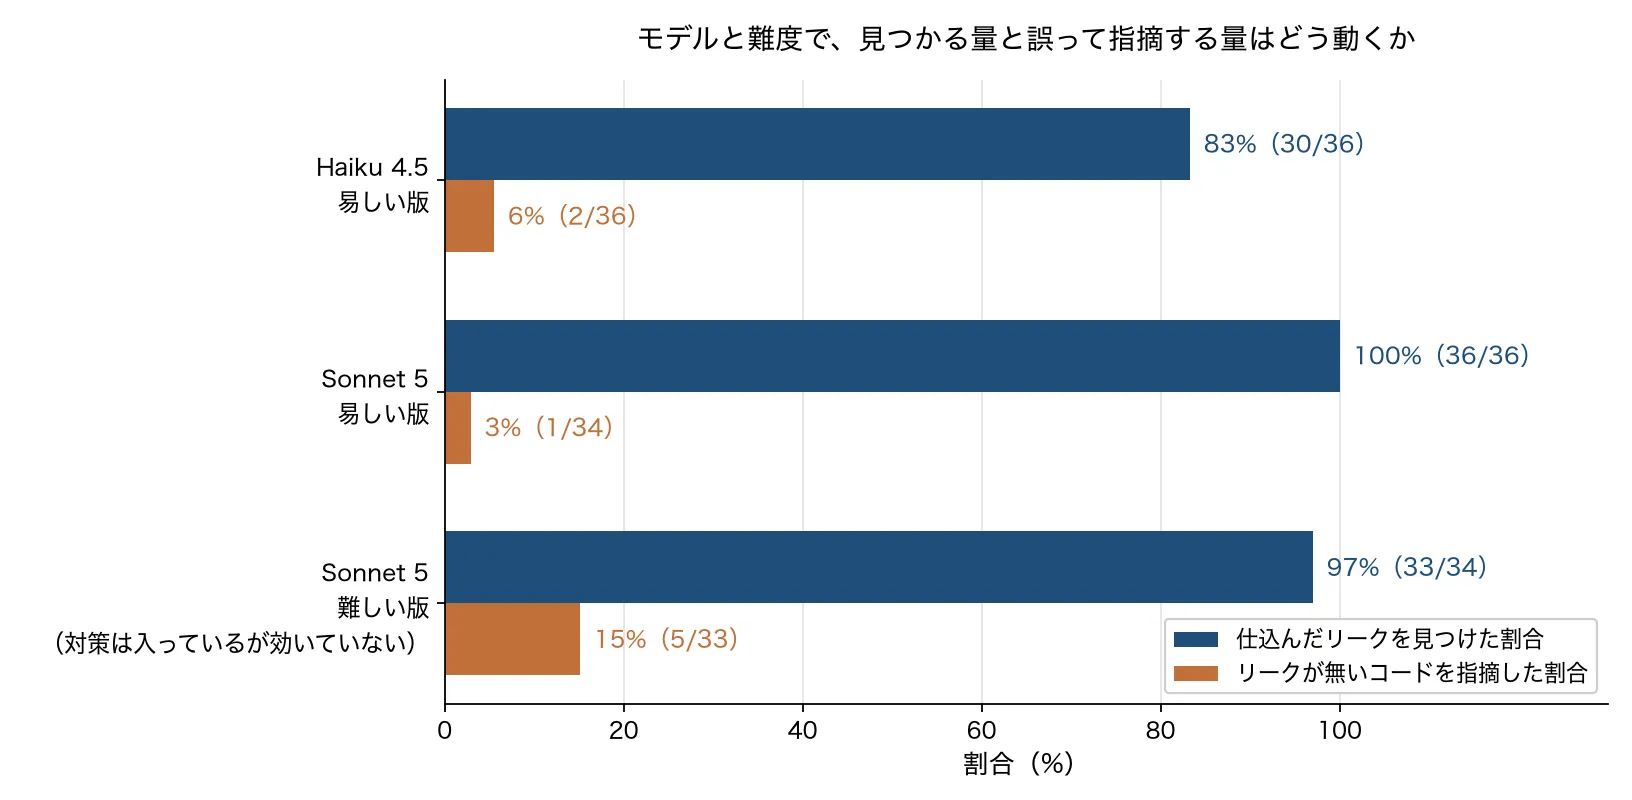
難しい版のリーク側は36通りありますが、判定できなかった2回を事前の規則どおり分母から外しているので、母数は34回です。種類ごとに見ても、判定できた回はほぼすべて一致しています。外れたのは難しい版の時系列パターン(狙いを言う条件)で3回中1回だけでした。
難しい版では落ちると予想していました。StratifiedGroupKFold と書いてあり groups も渡してあるコードなら、目で追う手がかりは全部「対策済み」を指すからです。その予想は外れました。
対策が書かれているのに効いていないコードも見抜いた
見抜き方が具体的でした。難しい版への指摘から3つ引きます。いずれも、対策の名前そのものは正しく書いてある版です。
groupsにvisit_idを使っているが、実際は同一patient_idが複数のvisit_id(複数回の受診記録)を持つため、同じ患者のデータが学習側と検証側に分かれて混入し、CVスコアが実際の性能より高く出る。
data.csvはdate列が時系列順にソートされていないのに、行の並び順を前提とするTimeSeriesSplitをそのまま適用しているため、学習フォールドに検証期間より未来のデータが混入しCVスコアが実際の性能より高く出る。
state_codeはchurned(目的変数)から直接生成した列だが、DROP_COLSに含まれず特徴量として学習に使われるため、CVスコアが不当に高くなるリークが発生する。
対策の名前に引きずられず、その対策が実際に何をしているかまで降りて読んでいます。2番目は、コードだけでは判断できず、データファイルの中身まで確認しないと言えないことです。
深く読む分、まれに時間が振り切れる
難しい版の平均は25秒でしたが、正しく書かれた時系列のコードを「リークがないか確認して」と頼んだ回だけ、5分の実行上限に達して打ち切りになりました。これは難しい版の72通りのうち1回で、同じケースの残り5回は正常に終わっています。打ち切りになった回のログは残っていませんが、同じケースの別の回では実際にデータ本体を読みにいっていました。
検出から外した1回は、リークだと言いながら別の機序を述べていた
機械照合では難しい版も34回中34回でしたが、文面を人手で読み直して1回を外しました。時系列パターンの、狙いを言う条件の1回です。
特徴量 units_roll7 が data.csv 側でどのように計算されているか不明であり、未来の値を含む中心化ローリングウィンドウ等で作成されていると各行の特徴量に未来情報が漏れ、TimeSeriesSplit で分割しても実質的なリークとなる可能性がある。
この回が挙げたリークの指摘はこれ1件だけで、仕込んだ機序(行が日付順に並んでいないまま TimeSeriesSplit を使っている)に触れていません。照合語がたまたま当たっていました。しかも同じ内容の指摘を、私はリークの無いコードの側では誤検知として数えています。同じ発言を、リーク版では正解、クリーン版では誤りと数えるのは非対称なので、検出から外しました。
機械で照合できる範囲には限界がある、というのがここでの実感です。語の一致は機序の一致を保証しません。
正しく書いたコードを疑う指摘が出た
難しくしても検出は落ちませんでした。代わりに測定値が動いたのは、正しく書いたコードを疑う回数のほうです。Sonnet 5 の易しい版では34回中1回、難しい版では33回中5回でした。実務で言えば、指摘が来ても手を入れる箇所が無い、という空振りが混じる状態です。
母数が30回台なので、この差を統計的に主張できる水準ではありません。件数として読んでください。中身を全部読むと、性格の違う2種類が混じっています。
推測に基づく誤りが3回ありました。うち2回は時系列のクリーン版で、「units_roll7 が当日以降の値を含む非因果的な移動平均になっている可能性があり、その場合ラベルの情報が特徴量に混入する」という趣旨の指摘です。実際にはこの列は1日ずらしてから移動平均を取っており、各行は自分より前の値しか見ていません。ただしその作り方は、レビュー対象のスクリプトからは確認できません。元の系列もCSVに入っていないので、レビューする側には確かめる手段が無い状態です。もう1回は別種の外れで、時間構造を持たない不正検知のデータに対して「時系列由来と思われる列をシャッフルしている」と述べたものでした。
事実だが影響しない指摘が2回です。成約率のクリーン版で、「city_sold_rate は分割前にデータ全体から集計されている」と指摘されました。これは事実です。ただしモデル自身が「現状feature_colsには含まれていないため直接スコアには影響しない」と書き添えています。将来この列を特徴量に混ぜたら危険だ、という指摘です。
事前に決めた採点規則は「リークの無いコードでリークだと分類したら誤検知」と機械的なので、結果を見てから規則は動かしていません。ただし後者2回を前者と同じ「誤検知」として読むと、実態より厳しく見えます。
易しいほうのテストを Haiku 4.5 で回すと取りこぼしが出た
易しい版をHaiku 4.5で回すと、36回中30回でした。取りこぼした6回のうち5回は同一個体が分割をまたぐパターンに集中し、狙いを明示した3回はいずれも指摘ゼロを返しています。特定の機序だけが丸ごと抜ける形で、全体が薄く落ちるのとは違う崩れ方です。
Sonnet 5は同じコードで36回中36回なので、モデルの差がそのまま出た形です。難しい版はSonnet 5でしか測っていないので、Haikuが難しい版でどうなるかは分かりません。1回あたりの費用は、Claude Codeが各回に返す額(API料金換算)でHaikuが0.035ドル、Sonnetが0.125ドルでした。
依頼の仕方で変わったのは、指摘の総数だった
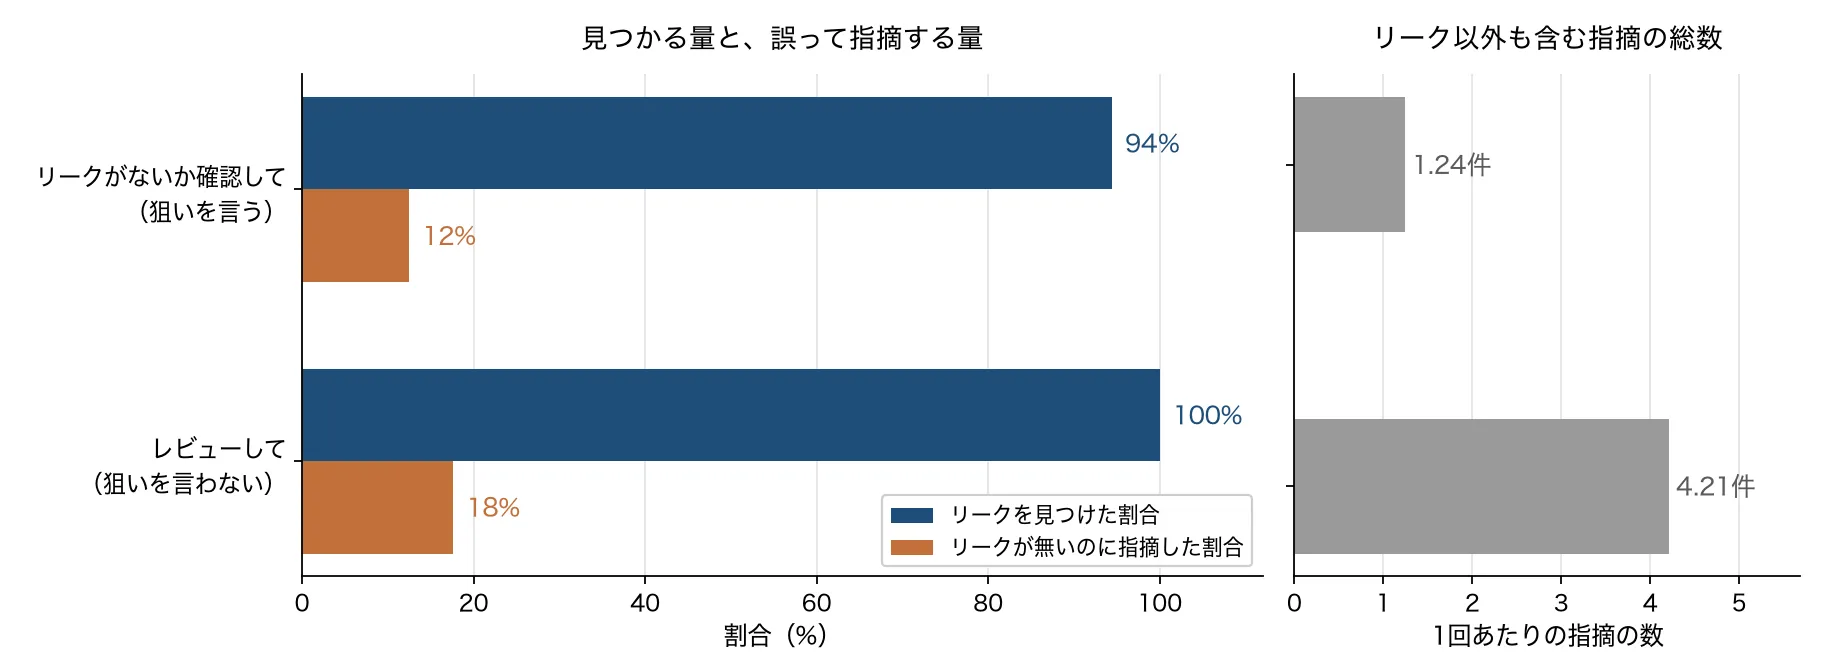
検出は狙いを言わない条件が16回中16回、言う条件が18回中17回でした。外したのは1回で、この回数では検出の差も確認できません。除外の入り方が条件で偏っているため、母数は条件ごとに16〜18回で揺れます。誤検知は狙いを言わない条件が17回中3回(18%)、言う条件が16回中2回(12%)で、この回数では差を確認できません。
はっきり変わったのは指摘の量です。1回あたりの指摘は、狙いを言わないと4.21件、狙いを言うと1.24件でした。リークの話に絞って頼むと、それ以外のことを報告しなくなります。裏を返すと、普段のレビューでは、リーク以外の指摘が一緒に返ってくるということでもあります。今回で言えば、閉じていないファイルハンドル、握りつぶされた例外、非効率な行ループなどが毎回のように挙がりました。
Sonnet 5を起点にし、最初の数回は指摘の中身を目で確かめる
今回のような単体スクリプトのリーク検出なら、Sonnet 5を最初の候補にできます。6種類×2難度で、外したのは70回中1回でした。ただし、最初の数回は指摘の中身まで目で確かめます。モデルではなくeffortを動かした場合の効き方は、5段階のeffortを120回のコードレビューで比べた検証で測っており、待ち時間と出力量は一貫して増えた一方、バグ検出率の差は確定できませんでした。
モデルをHaiku 4.5へ落とすなら、検出漏れを見込みます。同じ易しい版で取りこぼしが出ており、しかも同一個体のパターンに偏っていました。費用差は1回あたり0.09ドルでした。
狙いを言うかどうかは、何を受け取りたいかで決められます。変わるのは指摘の総数です。Sonnet 5 では、難しい版が1回あたり4.21件から1.24件へ、易しい版が4.15件から1.75件へ減りました。Haiku 4.5 の易しい版でも3.14件から0.56件へ減っています。減り方は測った組み合わせで違うので、比率ではなく件数で見てください。リークだけを見たいなら明示し、コード全体の問題を拾いたいなら言わないほうが得られる情報は多くなります。ただし今回はどちらの依頼でも、出力形式の指示にリークの項目と定義文が入っています。リークに何も触れない依頼で同じ結果になるかは測っていません。
由来の見えない列には、指摘が向くことがあります。前処理を別ファイルに書いているなら、レビューに出すときは特徴量を作った場所も一緒に渡してください。作り方をたどれる状態なら、モデルが推測で埋める余地が減ります。留保つきの指摘(「〜の可能性がある」)は特に自分で確かめる、という運用も一緒に決めておくと安全です。
なお、ここで検出対象にしたリークが交差検証のスコアを実際にどれだけ甘くするかは、データリーク5パターンを測った検証で別に測っています。分割前のSMOTEでは+0.24、標準化・欠損補完の順序ミスでは差を確認できませんでした。
詳しい検証条件: 難度の作り方と、検出の数え方
難しい版は「対策を両方に書く」ことで作った
易しい版は、対策が書かれていないコードと書かれているコードの対でした。難しい版では、対策そのものは両方のコードに同じ形で書き、効いているかどうかだけを変えます。TimeSeriesSplit も StratifiedGroupKFold も Pipeline も、リークを仕込んだ版とそうでない版の両方に、同じ形で書いてあります。
- 除外リストの取りこぼし: 学習に渡さない列を集合で宣言しているのに、目的変数を言い換えただけの数値列がその集合から漏れている
- 並んでいない行に
TimeSeriesSplit: 時間を考慮する分割を使っている。ただし読み込んだCSVが日付順に並んでおらず、位置で切る分割が実質ランダム分割になる groupsに一意なID: まとまり単位で切るStratifiedGroupKFoldに渡しているのが行ごとに一意な受診IDで、まとまりが1行ずつになっているPipelineの手前で事前選抜: 前処理と列の絞り込みをPipelineに入れ、foldごとに学習側だけで選んでいる。ただしその手前で、全データを見て63本から10本へ粗く絞っているPipelineの手前でSMOTE: SMOTE はPipelineの内側にあるものの、その手前で全データにもSMOTEを掛けており、合成した行が学習側と検証側にまたがる- レポート用の集計列が残る: ターゲットエンコーディング(カテゴリを、そのカテゴリの成約率などの数値に置き換える手法)を、入れ子の分割(学習側をさらに分けて、その中だけで集計する)まで使ってfold内から作っている。ただしレポート用に全データで計算した成約率の列が、特徴量に残っている
いずれも実務で起きる形です。対のコードの差は、6本のうち4本が1行だけです。
ただし、易しい版との差をすべて「難度の効果」として読むことはできません。リーク側の見せ方だけでなく、クリーン版にも手を入れた箇所があるからです(成約率の版については適用範囲と限界を参照してください)。
正解ラベルは実測で裏づけた
「これはリークだ」と決めつけずに、24本すべてを実際に実行して、リーク版のほうがスコアを盛ることを確認しました。数値はROC-AUC(0.5が当てずっぽう、1.0が完璧)で、リーク版から直した版を引いた差です。この差を、以下では盛れ幅と呼びます。
| 仕込んだリーク | 易しい版の盛れ幅(ROC-AUC差) | 難しい版の盛れ幅(ROC-AUC差) |
|---|---|---|
| 目的変数の派生列が残る | +0.41 | +0.41 |
| 時系列をランダム分割 | +0.07 | +0.05 |
| 同一個体が分割をまたぐ | +0.51 | +0.51 |
| 分割前に特徴量を選択 | +0.06 | +0.05 |
| 分割前にSMOTE | +0.34 | +0.34 |
| 分割前にカテゴリを集計 | +0.06 | +0.17 |
ここで注意したいのは、盛れ幅の大小をリークの種類どうしで比べられないことです。6つのデータはそれぞれ独立に作っており、生成の仕方しだいで盛れ幅は動きます。この表は「どのリークが危険か」の順位ではなく、「24本それぞれで、たしかにスコアが盛れている」ことの確認として読んでください。
検出を簡単にしすぎない工夫
コードには答えの手がかりを残さないようにしました。「誤った実装」のようなコメントや変数名を入れないのはもちろん、リーク版と直した版の差をリークの箇所だけに限り、未使用のimportが残らないことも機械で確認しています。本番の測定に入る前の試し打ちで、片方の版だけが使っていないライブラリをimportしていたところ、モデルがそれを手がかりに正解を推測してきたためです。
実務のコードらしい別の問題も前後に足してあります。例外を握りつぶす except、閉じないファイル、非効率な行ループなどで、リークが多数の指摘候補の1つになるようにしました。この追加は両方の版へ同じ文字列を入れているので、対の差は変わりません。
依頼文は、狙いの一文だけを入れ替えた
依頼の仕方は「このディレクトリの analyze.py をレビューして、問題があれば指摘してください」という狙いを言わない依頼と、「学習データと評価データの混入(データリーク)がないか確認してください」という狙いを言う依頼の2条件です。出力形式の指示は両条件で一字一句同じにしました。ただしその指示にはカテゴリの候補一覧が含まれ、中にリークの項目とその定義文が入っています。つまり狙いを言わない条件は、「リークに触れない」条件ではなく「リークを強調しない」条件です。
1回ごとに使い捨ての空ディレクトリで回す
1回ごとにリポジトリの外へ新しい空ディレクトリを作り、そこにコードとデータだけを置いて実行しました。前の回の記憶や、上位ディレクトリの設定が混ざらないようにするためです。実行前には上位に他の設定ファイルが無いことを毎回確認し、アカウント側の外部ツール接続も切っています。コードを実行させると挙動から答えを当てられてしまうので、書き込みと実行は禁止し、参照系だけを許可しました。
照合語だけでは数えきれなかった
判定は自由文の解釈に頼らず、決まった形のJSONで答えさせました。そのうえで、「見つかった」と数えたのは、指摘の文面に仕込んだリークの機序まで述べられていた回です。「リークがある」と言っただけで別の箇所を指した回は含めていません。分類名は見ていません。正しく指摘しながら別の分類に入れてくる回があったからです。
数え方は3層にしました。まず実測前に固定した語で機械照合し、表記ゆれを取りこぼしていたので語を足して照合し直し、最後にリークを仕込んだ側の文面をすべて人手で読み直しました。3層目で外した1回は、本文の該当節に挙げたとおりです。
数え方そのものにも間違いがありました。集計スクリプトに2か所、判定できなかった回を分母に残したまま数える欠陥が残っており、数値を出す直前に見つけています。片方は検出率を100%と88.9%のどちらとも読める状態にしていました。実験の道具を、実験の対象と同じ厳しさで検証しないと、数字はいくらでも動きます。
集計に入っていない7回
216通りのうち、集計に入っていない回が7回あります。JSONを返しきれなかった回が6回(外側の閉じ括弧だけを落とす形が全件)と、5分の実行上限に達して応答が返らなかった回が1回で、3%にあたります。割合の計算に使ったのは残る209回です。
除外は特定のケースに偏っていて、6回のうち2回は同じケース(難しい版の groups に一意なIDを渡す版、狙いを言わない条件)に集中しています。このケースで検出として数えられたのは、残る1回ぶんだけです。ただし外した2回は応答の本文自体が残っており、どちらも仕込んだ機序を正しく述べています。含めても検出の結論は変わりません。
適用範囲と限界: 単体スクリプト6種類で測った値
- 読ませたのは合成データで書き下ろした単体のスクリプトです。実務ではリークが複数ファイルに散り、前処理と学習が離れた場所に書かれます。コードも今回より雑然としているはずで、難度は上がります。
- 測ったのは1種類あたり3回ずつです。種類ごとの割合は3回中の数なので、幅を持って読んでください。誤検知の易しい版と難しい版の差も、この規模で確定できるものではありません。
- 検出はほぼ上限に張り付いています。今回の6種類・この見せ方では取りこぼしがほぼ出ませんでしたが、これは測定の天井に当たった値で、未知の種類に対する見逃し率が低いことまでは意味しません。
- 難度は当方が設計しました。「対策が効いていない」という軸も、その効かせ方も私が決めています。難しい版の1本は、盛れ幅が易しい版と同程度になるよう、モデルに読ませる前に絞り込む列数を調整しました。
- 成約率のクリーン版は、純粋な陰性対照(リークが無いことを確かめるための、正しく書いた側のコード)になっていません。レポート用に全データから集計した列を残す設計にしたため、リークの形をした残骸が指摘されうる状態です。リーク自体は入っておらず交差検証のスコアも変わりませんが、この2回を含めた誤検知率は実態より高く出ます。留保つきの指摘も1件として数えているので、誤検知はもともと厳しめに出る勘定です。
- 「見つかった」の数え方しだいで判定は動きます。分類名だけで数えるか、機械照合だけで済ませるかで、割合は変わりえます。
- 測ったのは検出だけで、修正は測っていません。指摘できることと、正しく直せることは別です。
- 次の条件は測っていません。Sonnet 5 と Haiku 4.5 以外のモデル、
--effort medium以外の設定、大きなコードベースに埋もれたリーク、人間のレビューアとの比較です。 - 出力形式の指示に含めたカテゴリ一覧には、リークの項目と定義文が両条件とも入っています。狙いを言わない条件も、完全に何も知らされていないわけではありません。
自分のコードで検出と誤検知を数える
自分のコードで同じことを試すための最小の検証コードです。リークを仕込んだ版と直した版を1本ずつ用意し、それぞれをレビューさせて結果を並べます。claude コマンドが使える状態で、手元の分析スクリプトを2本並べれば動きます。
"""コードにデータリークがあるかをClaude Codeにレビューさせ、判定を集計する。"""
import json
import os
import re
import shutil
import subprocess
import tempfile
from pathlib import Path

# 見てほしいコードの置き場所。{パス: リークがあるか} で正解を持っておく
CASES = {
    Path("leaky_analysis.py"): True,
    Path("clean_analysis.py"): False,
}
REPETITIONS = 3  # 1本あたりの反復回数。増やすほど安定するが利用枠を消費する

PROMPT = """このディレクトリの {name} をレビューして、問題があれば指摘してください。

確認が終わったら、次の形式のJSONだけを出力してください。JSONの前後に説明を付けないでください。

{{"findings": [{{"category": "<カテゴリ>", "line": <行番号>, "summary": "<一文で>"}}]}}

category は次のいずれかにしてください。
correctness / train_test_leakage / performance / style / security / error_handling / other

train_test_leakage は、学習データと評価データのあいだで情報が混入し、
交差検証のスコアが実際の性能より高く出てしまう問題を指します。

問題が見つからなければ findings を空の配列にしてください。"""


def extract_findings(text: str) -> list | None:
    """応答から findings のJSONを取り出す。括弧の対応を見て切り出す。"""
    # 改行やインデントを挟む形(```で囲まれた {\n "findings": ...})も拾う。
    # 雛形を復唱してから答える回があるので、最後に出てきたものを本回答とみなす
    matches = list(re.finditer(r'\{\s*"findings"', text))
    if not matches:
        return None
    start = matches[-1].start()
    depth = 0
    for i, ch in enumerate(text[start:], start):
        if ch == "{":
            depth += 1
        elif ch == "}":
            depth -= 1
            if depth == 0:
                try:
                    return json.loads(text[start:i + 1]).get("findings")
                except json.JSONDecodeError:
                    return None
    return None


def review_once(source: Path) -> bool | None:
    """1回レビューさせ、リークを指摘したかを返す。判定できなければ None。"""
    # 前の回の記憶や上位ディレクトリの設定を持ち込まないよう毎回作り直す
    workdir = Path(tempfile.mkdtemp(prefix="leak-review-"))
    try:
        shutil.copy(source, workdir / source.name)
        # CLAUDE 系の環境変数とAPIキーを落として実行条件をそろえる
        env = {
            k: v for k, v in os.environ.items()
            if not k.startswith("CLAUDE") and k != "ANTHROPIC_API_KEY"
        }

        try:
            proc = subprocess.run(
                [
                    "claude", "-p", PROMPT.format(name=source.name),
                    "--output-format", "json",
                    "--model", "claude-sonnet-5",
                    "--effort", "medium",
                    "--max-turns", "30",
                    "--allowedTools", "Read",
                    "--disallowedTools", "Bash", "Write", "Edit",
                    "--strict-mcp-config",  # アカウント側の外部ツール接続を止める
                ],
                cwd=workdir, env=env, capture_output=True, text=True, timeout=300,
            )
        except subprocess.TimeoutExpired:
            return None  # 上限に達した回も分母から外す(まれに起きる)
        if proc.returncode != 0 or not proc.stdout.strip():
            return None

        try:
            findings = extract_findings(json.loads(proc.stdout).get("result", ""))
        except json.JSONDecodeError:
            return None
        if findings is None:
            return None
        # カテゴリだけでなく本文も見る(正しく指摘しつつ別カテゴリに入れる場合がある)。
        # ただし「リーク」だけで拾うと「リソースリーク」まで数えてしまうので語を絞る
        for f in findings:
            category = str(f.get("category", "")).lower()
            summary = str(f.get("summary", ""))
            if category == "train_test_leakage":
                return True
            if any(word in summary for word in ("混入", "漏れ込", "データリーク", "CVスコア")):
                return True
        return False
    finally:
        shutil.rmtree(workdir, ignore_errors=True)


def main() -> None:
    for source, has_leak in CASES.items():
        if not source.exists():
            print("%s が見つかりません" % source)
            continue

        results = [review_once(source) for _ in range(REPETITIONS)]
        judged = [r for r in results if r is not None]
        dropped = len(results) - len(judged)

        if not judged:
            print("%s: 判定できた回がありません(%d回とも除外)" % (source.name, dropped))
            continue

        flagged = sum(judged)
        label = "リークあり" if has_leak else "リークなし"
        kind = "見つけた" if has_leak else "誤って指摘した"
        print("%s(%s): %s %d/%d" % (source.name, label, kind, flagged, len(judged)))
        if dropped:
            print("  判定できず分母から除外: %d回" % dropped)


if __name__ == "__main__":
main()正解を書いておけば、照合語に当たったかどうかで検出と誤検知の回数が出ます。CASES に自分のスクリプトを並べ、True / False で正解を持たせてください。判定できなかった回は分母から外し、その回数も一緒に出しています。黙って分母が減ると、割合の意味が変わってしまうためです。応答が返らずに上限へ達する回も起きるので、例外で全体が止まらないようにしてあります。
応答からJSONを取り出す部分を正規表現にしたのには理由があります。モデルは {"findings" と詰めて返すこともあれば、コードフェンスの中に改行とインデントを挟んで返すこともあり、文字列の一致だけで探すと後者を取りこぼします。最後に出てきたものを本回答として拾っているのは、指示した雛形を先に復唱してから答えられたときに先頭を掴まないための予防です。判定をカテゴリ名だけに頼らず本文も見ているのは、正しく指摘しながら別のカテゴリに分類してくる場合があったからです。逆に照合する語を「リーク」まで広げると、「ファイルハンドルが閉じられていない(リソースリーク)」という別の指摘まで拾ってしまいます。この切り出しと、判定できなかった回の扱いは、最初に書いたときはどちらも間違えていました。
自分のコードで使うときも、最初の数回は出力そのものを開いて、判定と中身が合っているか見てください。照合の語をどう決めても、拾いすぎと取りこぼしのどちらかは残ります。この記事で報告した検出の割合も、照合に加えて文面を人手で読み直したあとの値です。
難度を上げても落ちたのは検出率ではなかった
対策の名前が正しく書いてあるコードでも、Sonnet 5 は仕込んだリークをほぼ取りこぼしませんでした。目で追う手がかりを全部「対策済み」に揃えても素通りしません。動いたのは検出ではなく、正しく書いたコードを疑う回数のほうで、易しい版の1回から難しい版の5回へ、件数として増えています。
なぜ正しいコードへの指摘が難しい版で目立ったのかは、推測の域を出ていません。手がかりの少ない列ほど疑われやすい可能性はありますが、前処理が複数ファイルに分かれた実務の形では未測定です。単体スクリプトを見せる限りはレビューの一手目に置ける、というのが今回の射程です。