
はじめに
Claude Codeを使い続けていると、同じ程度の依頼でもトークン消費が大きく変わることがあります。利用枠を節約しようとして、話題が変わるたびに/clearで会話を区切る、出力形式を細かく指定する、読ませるファイルを限定するといった工夫を試している人もいるでしょう。
こうした運用は、Zennの記事やQiitaの記事でも紹介されています。難しいのは、1回だけの結果では効果を判断できないことです。節約術を加えた回が軽く済んでも、設定が効いたのか、もともと消費の少ない応答に当たったのかを区別できません。品質を落として出力量だけ減らした場合も、トークン数だけを見れば成功に見えます。
同じ3課題を6通りの進め方で各8回、合計48回測り、生成物は隠しテストで採点しました。ところが、記事に載せる再現コードでは推定コストの揺れが小さく、最初の実験と一致しません。条件を追うと、再現コードではClaude Codeが自分で書いたスクリプトをBashで実行でき、最初の48回では実行を禁止していたことが分かりました。
そこでBash実行の許可だけを変えた20回の比較を、3週間空けてもう一度実施しました。2度目は推定コストだけでなく生成物も保存し、同じ品質へ到達しているかまで確かめています。
要点
- Bash実行を許可しない条件では、推定コストの最大値と最小値が1度目に12.1倍、3週間後も10.3倍。 許可した条件はどちらも1.2倍
- 2度目の20回は両条件とも生成スクリプトが中央値14行で、期待値との厳密照合にも全件合格。高い回ほど良い成果物を作ったわけではない
- 中央値の比は2.45倍から1.49倍へ変化。「常に何倍安い」ではなく、極端に重い回が実行禁止側へ混ざるという対比の再現
/clear、出力形式の指定、読み取り範囲の限定、前置きの禁止は、Bash実行を禁止した条件で各8回では個別の削減効果を確認できず- Haiku 4.5に数十行のPythonスクリプトを書かせたヘッドレス実行での結果。推定コストはCLIの概算であり、請求額や利用枠の減少量ではない
Bash実行と推定コストの意味
この記事でいう「Bash実行の許可」は、Claude Codeが生成したスクリプトをコマンドで動かし、結果を自分で確認できる設定を指します。禁止した条件ではファイルの読み書きだけが可能で、生成物を実行して確かめられません。安全上の制約を緩める提案ではなく、許可の有無と消費のばらつきを比較した実験です。
呼び出しには、対話画面を開かず1回ずつ実行するclaude -pを使いました。この形式をヘッドレス実行と呼びます。モデルはHaiku 4.5、応答へ割り当てる思考量の設定(effort)はmediumで固定しています。
表の金額は、Claude Code CLIが応答に含めるtotal_cost_usdです。定価をもとにした概算なので、以下では「推定コスト」と表記します。88回はAPIキーを外したサブスクリプション環境で実行しており、請求額や利用枠の減少量との対応は測っていません。出力トークンはモデルが生成した量、ターン数は道具の利用を含めて応答が完了するまでの往復回数です。
88回をどのように比較したか
実験は、Bash実行の有無を比べる40回と、節約術を比べる48回に分かれます。
| 比較 | 課題 | 条件と反復 | 確認したこと |
|---|---|---|---|
| Bash実行の有無 | CSVを集計するスクリプトの作成 | 許可・禁止を各10回。3週間後に同じ20回を再測定 | 推定コスト、出力トークン、所要時間。2度目は成果物も保存して厳密採点 |
| 節約術 | 話題をまたぐ3課題 | 6条件を各8回、合計48回 | 推定コストと、3つの隠しテストの通過数 |
Bash比較では、タスク、モデル、思考量、入力ファイルを固定し、許可と禁止を1回ずつ交互に実行しました。1度目は推定コストしか保存していなかったため、2026-08-19の再測定では成果物も残し、region名と合計値の組が期待値に一致するか確認しています。
節約術の比較では、CSV集計、別のログからのエラー抽出、最初のCSV集計への引数追加という3課題を続けて依頼しました。基準となる1セッションに対し、/clearに相当する区切り、出力形式の指定、読み取り範囲の限定、前置きの禁止を1つずつ加え、全部を組み合わせた条件も用意しています。この48回はすべてBash実行を禁止した状態です。別途行ったBash比較では、この設定側だけに大きな揺れが生じました。
安い回が単に未完成だった可能性を除くため、3課題にはモデルから見えないテストを置きました。正しい実装では3問すべて、意図的に壊した実装では1問だけ通ることを事前に確認しています。
Bash実行を禁止した10回だけ、推定コストが最小と最大で12.1倍に開いた
1度目の比較では、Bash実行を許可した10回が$0.0301〜$0.0372に収まったのに対し、禁止した10回は$0.0274〜$0.3303まで広がりました。安い回だけなら両条件に差はありませんが、禁止側にはほかの回を大きく上回る応答が混ざっています。
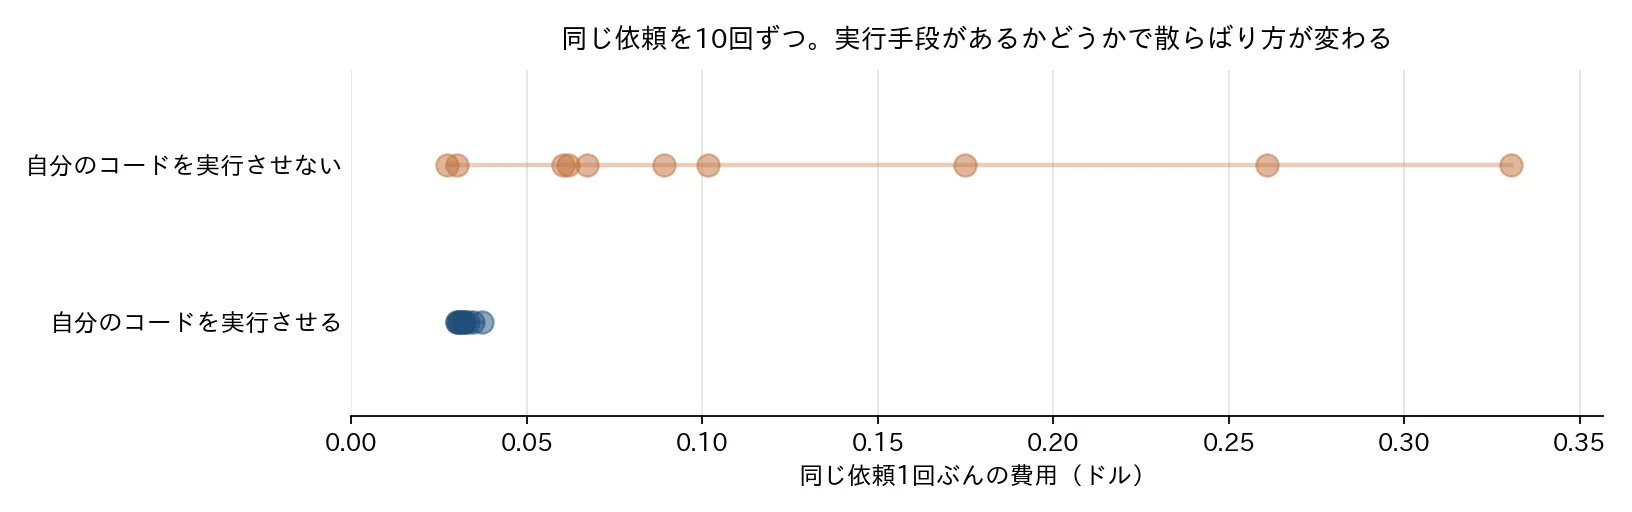
| 設定 | 中央値 | 最小〜最大 | 出力トークン |
|---|---|---|---|
| 自分のコードを実行させない | $0.0781 | $0.0274〜$0.3303(12.1倍) | 958〜14,275 |
| 自分のコードを実行させる | $0.0319 | $0.0301〜$0.0372(1.2倍) | 920〜1,193 |
当初は、生成物を実行できないため、モデルが内部で何度も書き直していると考えました。しかし、ターン数の中央値は両条件とも4です。最高額の$0.3303も4ターンで、$0.1748の回は1ターンのまま10,685トークンを生成していました。推定コストの増加に対応していたのは、ターン数より1回の応答に含まれる出力量です。 出力量が増えた原因までは、このログから分離できません。
所要時間にも同じ非対称がありました。実行禁止側は13.5〜190.5秒、許可側は14.3〜31.1秒です。少なくともこの課題では、Bashを禁止しても処理時間や推定コストの上限は下がっていません。
3週間後も再現したのは平均差ではなく、ばらつきの差
1度目は成果物を保存していなかったので、推定コストの比較しかできません。そこで2026-08-19にもう20回回しました。CLIへ渡した引数は1度目と1文字も違いません。ただし、同じだと確認できたのはその引数までです。3週間のあいだにCLIやモデル側の更新があった可能性は排除できません。
表の変動係数は、標準偏差を平均で割った値です。単位の異なる分布でも相対的な散らばりを比べられ、値が大きいほど回ごとの差が大きいと読みます。
| 測った値 | 1度目(2026-07-28) | 2度目(2026-08-19) |
|---|---|---|
| 実行させない: 中央値 | $0.0781 | $0.0473 |
| 実行させない: 最大÷最小 | 12.1倍 | 10.3倍 |
| 実行させない: 変動係数 | 0.85 | 1.06 |
| 実行させる: 中央値 | $0.0319 | $0.0317 |
| 実行させる: 最大÷最小 | 1.2倍 | 1.2倍 |
| 実行させる: 変動係数 | 0.07 | 0.07 |
| 中央値の比 | 2.45倍 | 1.49倍 |
中央値の比は2.45倍から1.49倍へ変わり、日をまたいで安定しませんでした。2度目の実行禁止側は$0.027〜$0.031が5回、$0.064〜$0.278が5回に分かれているため、中央値はどちらの集まりへ入るかで動きます。10回の半分は実行許可側の中央値より安く、Bash実行を許せば毎回安くなるとは判断できません。 それでも禁止側だけに$0.28〜$0.33へ達する回が現れ、許可側の変動係数は2度とも0.07でした。
2度目は成果物も残しました。できあがった total.py は20回とも13行から19行、中央値14行です。実質的なコードの形は9種類しかなく(コメントと空行だけを落として数えた値で、変数名の違いは別の形として数えています)、上位3つの形が両方の条件にまたがって20回中14回を占めます。最も高くついた回(出力18,146トークン・$0.2777)が書いたファイルは、最も安かった回(902トークン・$0.0271)のものと変数名しか違わない14行でした。20回とも標準ライブラリの csv で書かれ、pandas を使った回はゼロです。
隠しテストにはラベルと値の取り違えを見逃す余地があったため、region名と合計値の組を取り出して期待値と照合し直したところ、20回すべて一致しました。成果物の行数と正しさが同程度でも、生成されたトークン数は902〜18,146まで変化しています。
各8回では4つの節約術の個別効果を確認できなかった
48回の比較も、コマンドの実行を許さない設定で回しています。最初から揺れの大きい領域で測っていたことになります。
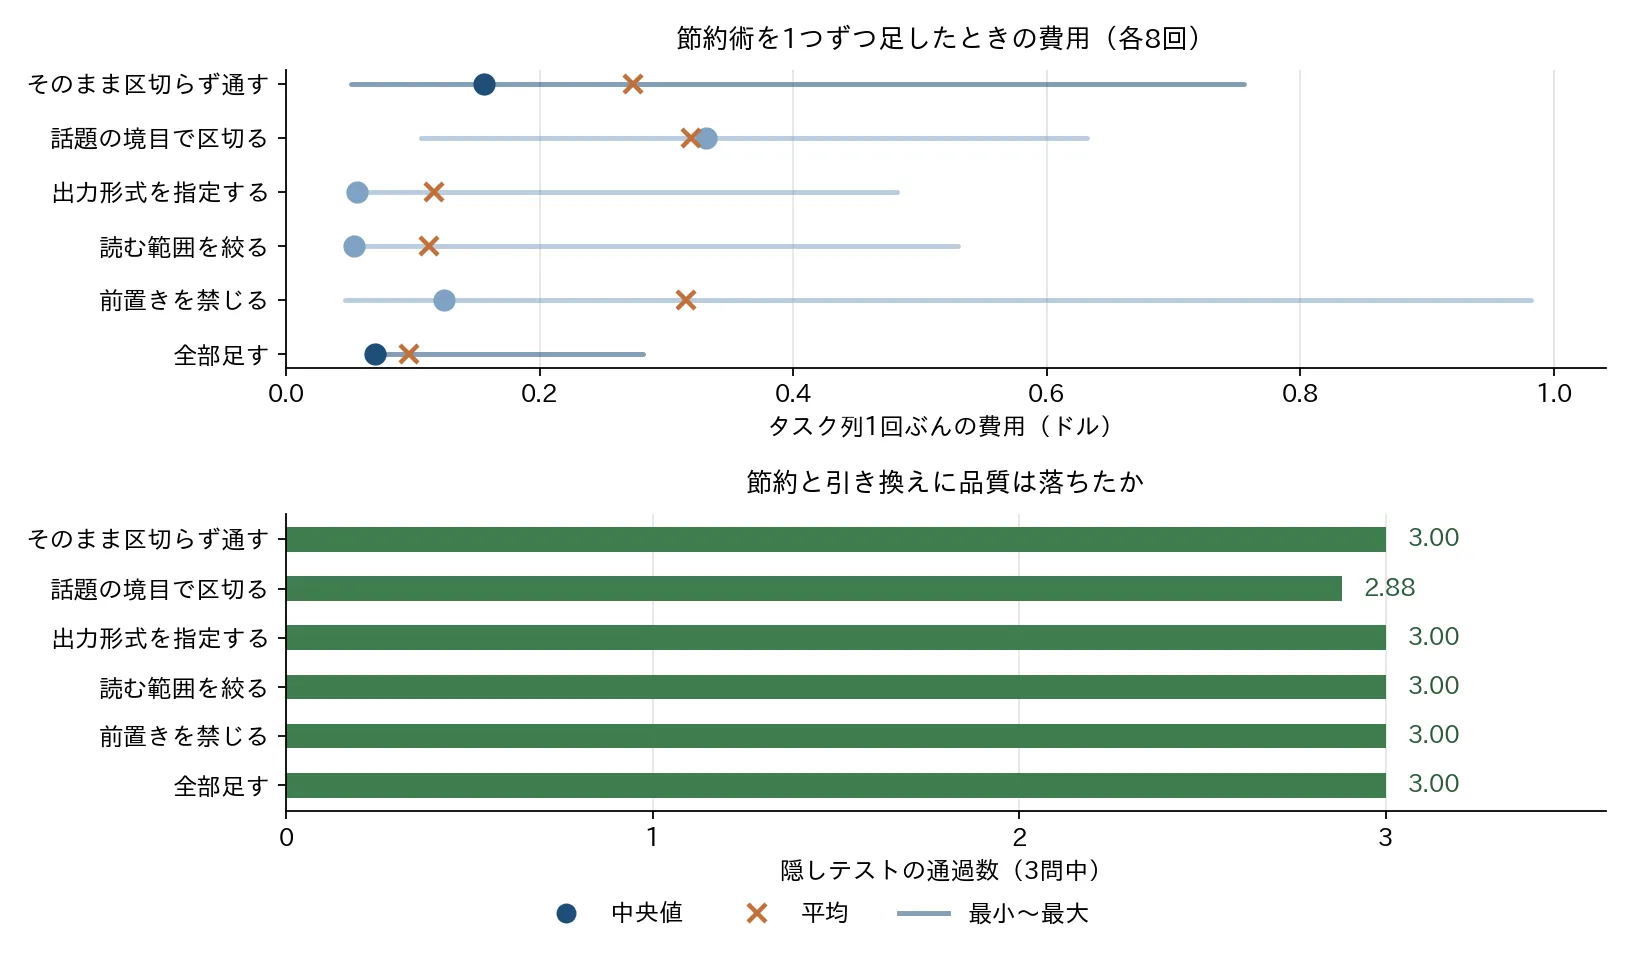
中央値には差があるものの、各条件の最小〜最大は広く重なっています。
| やり方 | 中央値 | 最小〜最大 | 隠しテスト |
|---|---|---|---|
| そのまま区切らず通す | $0.156 | $0.051〜$0.756 | 3.00/3 |
| 話題の境目で区切る | $0.331 | $0.107〜$0.632 | 2.88/3 |
| 出力形式を指定する | $0.056 | $0.051〜$0.482 | 3.00/3 |
| 読む範囲を絞る | $0.054 | $0.050〜$0.530 | 3.00/3 |
| 前置きを禁じる | $0.125 | $0.046〜$0.982 | 3.00/3 |
| 全部足す | $0.070 | $0.069〜$0.282 | 3.00/3 |
中央値だけを見ると差があるように見えますが、各8回では測定値の範囲が大きく重なりました。平均差の区間を見積もると、補正前に差が残ったのは4つの方法を全部加えた条件だけです。5条件を同時に比べた影響まで補正すると、その区間も0を含みました。個別の節約術について、各8回の結果から削減効果を確定できません。 計算方法と区間の値は「詳しい検証条件」にまとめています。
隠しテストは5条件で平均3.00/3、「話題の境目で区切る」条件だけ2.88/3でした。点数を落とした1回は内容の誤りではなく、2つ目のスクリプトが作られないまま終了しています。
較正で同じ依頼を8回投げたときの揺れ(変動係数0.92)から、差を見分けるのに何回必要かを見積もりました。
| 検出したい差 | 1条件あたりの必要回数 | 6条件の合計 |
|---|---|---|
| 50% | 約54回 | 324回 |
| 30% | 約150回 | 900回 |
| 20% | 約338回 | 2,028回 |
今回観測した揺れを前提にすると、50%の差でも1条件あたり約54回が必要という見積もりです。較正段階では1条件1回の結果から「最大94%削減」と読める差が出ましたが、反復を増やすと消えました。削減率を提示するには、効果の大きさに応じた反復が必要です。
3ターンでは/clearによる削減を確認できなかった
話題の境目で区切った条件の中央値は$0.331、区切らない基準は$0.156でした。平均差の95%区間は0をまたぐため、区切ると高くなるとも、安くなるとも断定できません。
内訳では、キャッシュへ新しく書き込んだ量が区切る条件で平均109,537トークン、継続する条件で84,943トークンでした。キャッシュを経由しない入力も2,169対990で、どちらも区切る条件のほうが多くなっています。短い履歴を消した効果より、新しいセッションで入力やキャッシュを作り直した量が上回った可能性がありますが、因果を分離する実験は行っていません。
今回のタスク列は3ターンと短く、履歴がまだ小さい段階でした。何十ターンも続けたあとなら、履歴の重さがキャッシュの利点を上回るかもしれません。今回の結果は「短いセッションでは区切っても安くならなかった」までです。
トークン消費のばらつきを確認する実務手順
-
実行許可の安全な範囲 まず、Claude Codeにどのコマンドまで任せられるかを決めます。今回直接比べたのはBash実行の許可だけであり、権限を広げるほどよいという結果ではありません。全面的に許可できない環境では、サンドボックスや許可コマンドの限定など、生成物を安全に検証できる範囲を検討します。
-
代表的な依頼の反復 普段よく使う依頼を同じ条件で、まず10回を目安に実行し、中央値だけでなく最小値、最大値、変動係数を並べます。これは極端に重い回が混ざるかを探す初期確認であり、削減率を確定する回数ではありません。後半のコードではBash実行の許可と禁止を交互に測れます。
-
生成物の品質確認 軽い回と重い回から成果物を保存し、テスト結果や出力内容も照合します。消費が少なくても未完成なら節約とはみなせず、反対に重い回の品質が変わらなければ、増えた出力量が成果へ結びついていないと判断できます。
-
節約術の比較 ばらつきと品質を把握してから、
/clearや出力形式の指定を1つずつ加えます。比較する条件は交互に実行し、最大値が偶然片方へ偏らないようにします。今回のように揺れが大きければ、数回の中央値だけで削減率を決めることはできません。 -
履歴に応じた
/clearの判断 3ターンの短いタスク列では、会話を区切る利点を確認できませんでした。固定ルールとして毎回消すのではなく、長い履歴を含む普段の作業でも測り、入力やキャッシュを作り直す量との釣り合いで判断するのが現実的です。
詳しい検証条件
1度目(2026-07-28)に回した68回については、CLIとPythonの版を記録していません。冒頭の検証環境に出ている版は、2度目の測定時に記録したものです。2度目の20回でCLIへ渡した引数が1度目と同じであることは、保存しておいた引数列を突き合わせて確認しました。
交互というのは1回ずつの入れ替えで、片方の条件をまとめて流した区間はありません。作業ディレクトリも1回ごとに作り直し、前の回の生成物を次の回へ持ち込まないようにしています。
隠しテストは region 名と合計値をそれぞれ別に照合するので、ラベルと値の対応が入れ替わっていても通ります。10種の不具合を仕込んで確かめたところ、見逃したのはこの1種だけでした。そこで2度目の20回については、出力から region と合計値の対を取り出し、期待値と完全に一致するかを判定し直しています。テストの判定との食い違いはありませんでした。
統計の扱いと、測定中に修正した4つの誤り
条件どうしの差は、得られた測定値から重複を許して標本を作り直す方法(ブートストラップ)で、基準との平均差に区間を付けました。再抽出は10,000回、乱数シードは固定しています。補正前の95%区間が0をまたがなかったのは、4つの方法を全部加えた条件だけで、平均差は-$0.176401、区間は-$0.362771〜-$0.013904でした。5条件を同時に比べる影響をBonferroni法で補正した99%区間は-$0.424839〜$0.023230となり、0を含みます。最終的な判断には補正後の区間を使い、削減効果は確認できなかったとしました。
測定と記事化の途中で、結果の読み方を変える誤りが4つ見つかりました。
- 消費量の集計元 応答の
usageは最終メッセージ分しか含まないのに、当初はこれを消費量として合計していました。手計算とtotal_cost_usdが大きくずれたため、モデル別の積み上げであるmodelUsageから取得するよう修正しています。 - 反復1回での区間推定 較正では同じ1点からしか再抽出できず、区間に幅がないまま5条件すべてで「差を確認できた」と出力されていました。反復が2回未満なら区間を出さない処理へ変えています。修正前の集計では、偶然の1回を削減効果として掲載するところでした。
- 採点環境にないライブラリ 生成されたスクリプトが使うライブラリを採点側へ入れておらず、正しい答えを実行エラーで不合格にしていました。環境を整えたあと、保存済みの成果物だけを再採点しており、モデルは再実行していません。
- 実行条件を伏せた一般化 当初は、観測したばらつきをClaude Code全般の特徴として書いていました。記事用コードの結果と一致しなかったため条件を調べ、Bash実行を禁止した設定で生じた差だと判明しています。
この結果を当てはめられる範囲
- モデルと使い方 対象はHaiku 4.5のヘッドレス実行です。対話画面や、より大きなモデルでは測っていません。最初の68回はCLIとPythonの版も記録していないため、冒頭の環境情報は2度目の20回に対応します。
- 反復回数 Bash比較は各10回、節約術は各8回です。最大÷最小は試行回数が増えるほど広がりやすく、変動係数も今回は極端に高い1回の影響を受けています。中央値の比も安定していないため、持ち帰れるのは散らばり方の対比までです。
- 成果物の検証 region名と合計値の組まで厳密に照合したのは、2度目の20回に限られます。最初の20回は成果物を保存しておらず、48回の節約術比較には別の隠しテストを使いました。
- 課題の規模 数十行のPythonスクリプトを作る小さな依頼であり、大きなコードベースの探索や、実行自体に時間がかかる作業では推定コストの内訳が変わる可能性があります。
- 金額と利用枠
total_cost_usdはCLIの概算です。請求額のほか、5時間ごと・週次の利用枠がどの程度減るかも、この実験では確認していません。 - 節約術を測った条件 48回はすべてBash実行を禁止した状態で回しています。この設定は変動係数が0.85〜1.06で、許可した場合の0.07より大きく揺れます。削減効果を確認できなかったのは、この揺れの大きい条件で各8回測った範囲までの話で、Bashを許可した環境で同じ結論になるかは測っていません。
- 安全性と未検証の方法 Bash実行の可否は、推定コストではなく安全要件を優先して決めます。会話を圧縮する
/compactも比較対象に含めていません。
自分の環境で推定コストのばらつきを測るコード
同じ依頼をBash実行の許可・禁止で交互に送り、推定コストの分布を並べるコードです。20回実行するため、ANTHROPIC_API_KEYが設定された環境ではAPIの従量課金が発生します。2度目の20回に対するCLI推定コストの合計は$1.05でしたが、この測定ではキーを外してサブスクリプションを利用しました。同じ条件にそろえるなら、envを作った直後にenv.pop("ANTHROPIC_API_KEY", None)を追加してください。
実行を許す側では、確認を挟まずにBashが動きます。作業場所は毎回作り直す一時ディレクトリですが、Bash自体をその中へ隔離するコードではありません。 入力ファイルと依頼内容を確認し、安全を判断できる環境だけが対象です。
"""同じ依頼を「実行させる/させない」で繰り返し、費用の分布を比べる。"""
import json
import os
import shutil
import statistics
import subprocess
import tempfile
from pathlib import Path

# 測りたい依頼。自分がよくやる作業に置き換える
PROMPT = "sales.csv を読み、region ごとに amount を合計して表示する total.py を作ってください。"

# 依頼に必要な入力ファイル。{ファイル名: 中身}
INPUT_FILES = {
    "sales.csv": "id,region,amount\n1,east,120\n2,west,80\n3,east,45\n4,north,200\n",
}

REPETITIONS = 10  # 増やすほど分布が安定するが、そのぶん利用枠を使う
MODEL = "claude-haiku-4-5-20251001"


def run_once(allow_bash: bool) -> float | None:
    """1回実行して費用を返す。失敗したら None(集計から外す)。"""
    # 前の回の生成物や、作業中プロジェクトの設定を持ち込まないよう毎回作り直す。
    # ただし ~/.claude/CLAUDE.md は作業ディレクトリによらず読まれる(両条件に等しく効く)
    workdir = Path(tempfile.mkdtemp(prefix="cost-spread-"))
    try:
        for name, content in INPUT_FILES.items():
            (workdir / name).write_text(content, encoding="utf-8")

        # CLAUDE 系の環境変数を落として実行条件をそろえる
        env = {k: v for k, v in os.environ.items() if not k.startswith("CLAUDE")}

        argv = [
            "claude", "-p", PROMPT,
            "--output-format", "json",
            "--model", MODEL,
            "--effort", "medium",
            "--max-turns", "20",
            "--permission-mode", "acceptEdits",
            "--strict-mcp-config",  # アカウント側の外部ツール接続を止める
        ]
        # 違いはコマンドの実行を許すかどうかだけ
        if allow_bash:
            argv += ["--allowedTools", "Read", "Write", "Edit", "Bash"]
        else:
            argv += ["--allowedTools", "Read", "Write", "Edit",
                     "--disallowedTools", "Bash"]

        proc = subprocess.run(
            argv, cwd=workdir, env=env, capture_output=True, text=True,
            timeout=900, stdin=subprocess.DEVNULL,
        )
        if proc.returncode != 0 or not proc.stdout.strip():
            return None
        return json.loads(proc.stdout).get("total_cost_usd")
    except (subprocess.TimeoutExpired, json.JSONDecodeError):
        # 時間切れと、JSON でない出力。ここで受け止めないと最後の1回の失敗で
        # それまでの結果ごと落ちる
        return None
    finally:
        shutil.rmtree(workdir, ignore_errors=True)


def report(label: str, costs: list[float], n_failed: int) -> None:
    if len(costs) < 2:
        print("\n[%s] 測定できた回が足りません(成功 %d / 失敗 %d)"
              % (label, len(costs), n_failed))
        return
    costs.sort()
    mean = statistics.fmean(costs)
    print("\n[%s] 成功 %d回 / 失敗 %d回" % (label, len(costs), n_failed))
    print("  中央値 $%.5f" % statistics.median(costs))
    print("  最小 $%.5f / 最大 $%.5f" % (costs[0], costs[-1]))
    if costs[0] > 0:
        print("  最大は最小の %.1f倍" % (costs[-1] / costs[0]))
    if mean <= 0:
        # Bedrock 経由などでは費用が 0.0 で返る。比が取れないのでここで止める
        print("  費用が 0 で返っています。トークン数で比べてください")
        return
    cv = statistics.stdev(costs) / mean
    print("  変動係数 %.2f" % cv)
    # 変動係数から、その差を検出するのに必要な回数の目安を出す。
    # 2回未満という結果は測定として成立しないので下限を置く
    for ratio in (0.5, 0.3):
        n = max(2, round(16 * (cv / ratio) ** 2))
        print("  %d%% の差を見るには1条件あたり約%d回" % (ratio * 100, n))


def main() -> None:
    results = {}
    failures = {}
    # 2つの設定を交互に回し、時間帯の影響が片方へ偏らないようにする
    for allow in (False, True):
        results[allow] = []
        failures[allow] = 0
    for i in range(REPETITIONS):
        for allow in (False, True):
            cost = run_once(allow)
            label = "実行させる" if allow else "実行させない"
            if cost is None:
                failures[allow] += 1
                print("%s %d/%d 失敗(時間切れ・異常終了など。この回は集計から外す)"
                      % (label, i + 1, REPETITIONS))
                continue
            results[allow].append(cost)
            print("%s %d/%d  $%.5f" % (label, i + 1, REPETITIONS, cost))

    report("実行させない", results[False], failures[False])
    report("実行させる", results[True], failures[True])

    if len(results[False]) >= 2 and len(results[True]) >= 2:
        base = statistics.median(results[True])
        if base > 0:
            ratio = statistics.median(results[False]) / base
            print("\n中央値の比: 実行させない側が %.1f倍" % ratio)

    if REPETITIONS < 10:
        print("\n注意: %d回では分布の裾を取りこぼします。" % REPETITIONS)
        print("実行させない側の費用は右に大きく裾を引くので、高くつく回に")
        print("当たらないまま終わると、揺れを実際よりずっと小さく見積もります。")


if __name__ == "__main__":
    main()
反復回数は10回を初期値にしています。実行禁止側の分布は高い方向へ長く伸びたため、少数回では極端に重い応答を取りこぼします。実際、最初にサンプルコードを4回だけ試したときは$0.031〜$0.035(1.1倍)に収まりましたが、これはBash実行を許可した設定でした。後に条件を分けて測ったことで、禁止側だけに大きな揺れがあると判明しています。
最後に表示する中央値の比も、10回では日を空けると動きました。節約率として扱わず、最小値と最大値の開き、変動係数、生成物の品質をセットで比較するための出力です。
まとめ: 節約術の前に、重い回が混ざる条件を探す
/clear、出力形式、読み取り範囲、前置きの指定を各8回で比べても、個別の削減効果は確認できませんでした。それより明瞭だったのが、Bash実行を禁止した条件だけに極端に重い応答が混ざった点です。3週間後の再測定でも散らばり方の差は残る一方、中央値の比は変化しています。
Claude Codeの消費を見直すなら、1回の結果から節約率を計算する前に、同じ依頼を繰り返して分布と成果物を比べることが判断の起点になります。Bashを許可できるかは安全要件次第ですが、禁止する場合も、その設定で消費が安定しているとは限りません。今回まだ分からないのは、同程度の成果物へ至るまでに出力トークンが大きく増える理由です。大規模な開発作業や別モデルへ一般化するには、課題の規模と実行時間を変えた追加検証が必要です。