
Claude Codeがセッションの最初に読むプロジェクト規約、CLAUDE.mdの話です。手元のこのファイルが、ルールを足すうちに長くなってきました。削ったほうがいいのか、それとも長い部分は最初から読まれていないのか、判断がつきません。
書き方の助言はよく見かけます。200行以下にする。MUSTやNEVERを使う。大事なルールは先頭に置く。禁止を並べず、使ってよいものだけを書く。どれも筋は通っています。ただ、長さの話と、書き方の話と、置き場所の話が、同じ「守らせるコツ」として並んでいます。
「遵守率が何割上がった」という数字だけでは、自分のファイルへ当てはめられません。どのモデルで、どんなルールを何回試し、何をもって「守った」と数えたのかで、数字の意味が変わります。そこで、同じ7つのルールを7通りのCLAUDE.mdに書き分け、長さ・置き場所・言い方・反復回数だけを1か所ずつ動かして解かせたところ、7通りの遵守率は77.4〜88.1%の幅に収まりました。書き方の違いより先に、もっと大きな差が別のところにありました。
先に結論: 効いたのは書き方より、書いてあるかどうか
- 7ルールをどこにも書かない条件の遵守率(生成されたコードが7ルールをいくつ満たしたかの割合)は7.1%。CLAUDE.mdに書いた7条件は77.4〜88.1%
- 書き方7条件どうしの差は最大でも約10ポイント
- 40行版が88.1%で最高。ただし196行から779行へ増やしても低下せず、最適な長さを決められる結果ではない
loggingを許可するだけではprintは止まらず。やめてほしい操作は名指しで書く必要がある結果- 測ったのは Haiku 4.5(
--effort medium。1回の応答にどれだけ考える量を割くかの設定)、単一ファイルのPython課題4種類、8条件×各12回の計96回
遵守率は「出てきたコードが規約を満たしたか」だけの数字
結果の中心に置く数字は1つで、ルール遵守率と呼びます。モデルが書いたPythonコードが7つのルールのうちいくつを満たしたかを、構文木(コードの構造をプログラムから辿れる形にしたもの)などで機械判定した割合です。7つとも満たせば100%になります。
判定しているのは、出てきたコードがルールを満たしたかどうかだけです。モデルが規約を読んだか、理解したか、意図して従ったかは測っていません。 結果を読むときにここが効いてくるので、先に断っておきます。
実行にはヘッドレス実行(claude -p)を使いました。Claude Codeを対話画面ではなくコマンドから1回ずつ動かし、結果をJSONで受け取る使い方です。あとで出てくる表の「キャッシュ書き込み」は、送った内容をモデル側のキャッシュへ書き込んだトークン数を指します。
同じ7ルールを8通りに書き分けて96回解かせた
守らせたのは、実在しそうな社内規約のつもりで用意した次の7つです。かっこ内が「何をもって満たしたと数えたか」です。
- 公開関数の名前は
snake_caseかつ接頭辞do_(補助関数はアンダースコア始まり、mainは対象外) requestsを使わず標準ライブラリのurllib.requestで通信する(import文の走査)- 生成物は
solution.pyの1ファイルだけ(作られたファイル一覧) - 文字列の組み立ては
%書式で、f文字列を使わない(構文木にf文字列が1つも無いこと) - すべての関数定義に戻り値の型注釈を付ける
printを使わずloggingを使う(printの呼び出しが0で、かつロガーで実際に出力していること)- どの関数も20行以内(
defの行から関数の末尾まで)
解かせたのは小さなPythonスクリプト4種類です。為替レートの取得と換算、RSSフィードからの見出し抽出、複数URLの死活確認、公開CSVの列の集計で、いずれも取得と加工を別の処理に分け、実行中の状況を表示する課題にしました。各条件につき4課題を3回ずつ、合わせて12回実行しています。
7つのルールは課題の指示文には一切書いていません。 CLAUDE.mdにだけ書いてあります。コードは実行させず、Bashを無効化し、ファイルの読み書きだけを自動承認しました。
比べた8条件はこの並びです。長さは40行・196行・779行の3段階で、残りの4条件は196行版を基準に1か所だけ変えています。
- CLAUDE.mdなし(0行): ファイルを置かない対照条件
- 短い版(40行): 規約と、短いプロジェクト説明だけ
- 中くらいの版(196行): 比較の基準
- 長い版(779行): 中くらいの版の後ろへ、同じ調子の節を53追加
- MUST/NEVERで書いた版(196行): 規約11行を、内容を変えずに命令形へ
- 許可リストで書いた版(196行): 禁止をやめ「使ってよいもの」だけを列挙
- 末尾に置いた版(196行): 規約を186行目へ移動
- 3か所に繰り返した版(193行): 同じ規約11行を冒頭・中間・末尾へ
長さを変えた3条件は入れ子になっています。短い版は中くらいの版の先頭40行と完全に同じで、中くらいの版も長い版の先頭196行と完全に同じです。 長くする条件では既存の部分を1文字も書き換えず、規約より後ろにプロジェクト説明だけを足しました。ファイルの全文と、混入を防ぐための確認は、後半の「詳しい検証条件」にまとめてあります。
CLAUDE.mdを書くと遵守率は7.1%から8割前後へ
書き方7条件の差は最大でも約10ポイントだった
いちばん大きかったのは、ファイルの書き方の違いではありませんでした。規約がどこにも書かれていない条件だけが極端に低く、書いてある7条件は横並びです。手元のCLAUDE.mdをどう書くか悩む前に、守らせたいルールがそこに載っているかどうかで、結果のほとんどが決まっていたことになります。
CLAUDE.mdに書いた7条件は77.4〜88.1%に収まりました。書き方による違いは、最大でも10ポイント程度です。規約を書かなかった対照条件との差は70ポイント以上あり、桁が違います。
| CLAUDE.md | 行数 | ルール遵守率 | 1回あたりの推定コスト | キャッシュ書き込み |
|---|---|---|---|---|
| CLAUDE.mdなし | 0 | 7.1% | $0.0415 | 9,641 |
| 短い版 | 40 | 88.1% | $0.0526 | 11,787 |
| 中くらいの版 | 196 | 81.0% | $0.0530 | 14,418 |
| 長い版 | 779 | 82.1% | $0.0813 | 24,735 |
| MUST/NEVERで書いた版 | 196 | 85.7% | $0.0539 | 14,562 |
| 末尾に置いた版 | 196 | 82.1% | $0.0512 | 13,514 |
| 3か所に繰り返した版 | 193 | 85.7% | $0.0548 | 14,963 |
| 許可リストで書いた版 | 196 | 77.4% | $0.0539 | 14,392 |
たとえば、標準ライブラリだけで書ける課題でも、CLAUDE.mdなしでは urllib.request が選ばれたのは42%だけでした。事前の較正でも、4回すべてで requests をimportしています。外部依存を足す理由がなくても、指定しなければ使い慣れたライブラリが選ばれるようです。CLAUDE.mdに規約を書いた7条件では、84回すべてが urllib.request を使いました。
ファイル名も揃いません。CLAUDE.mdなしの条件が作ったのは currency_converter.py、converter.py、fetch_rss.py、healthcheck.py、csvstats.py など毎回ばらばらで、頼んでいない requirements.txt やURL一覧まで作ることがありました。指定した solution.py に揃った実行は0件です。この手の毎回変わって扱いに困るばらつきは、規約を1度書いておくだけで消えました。
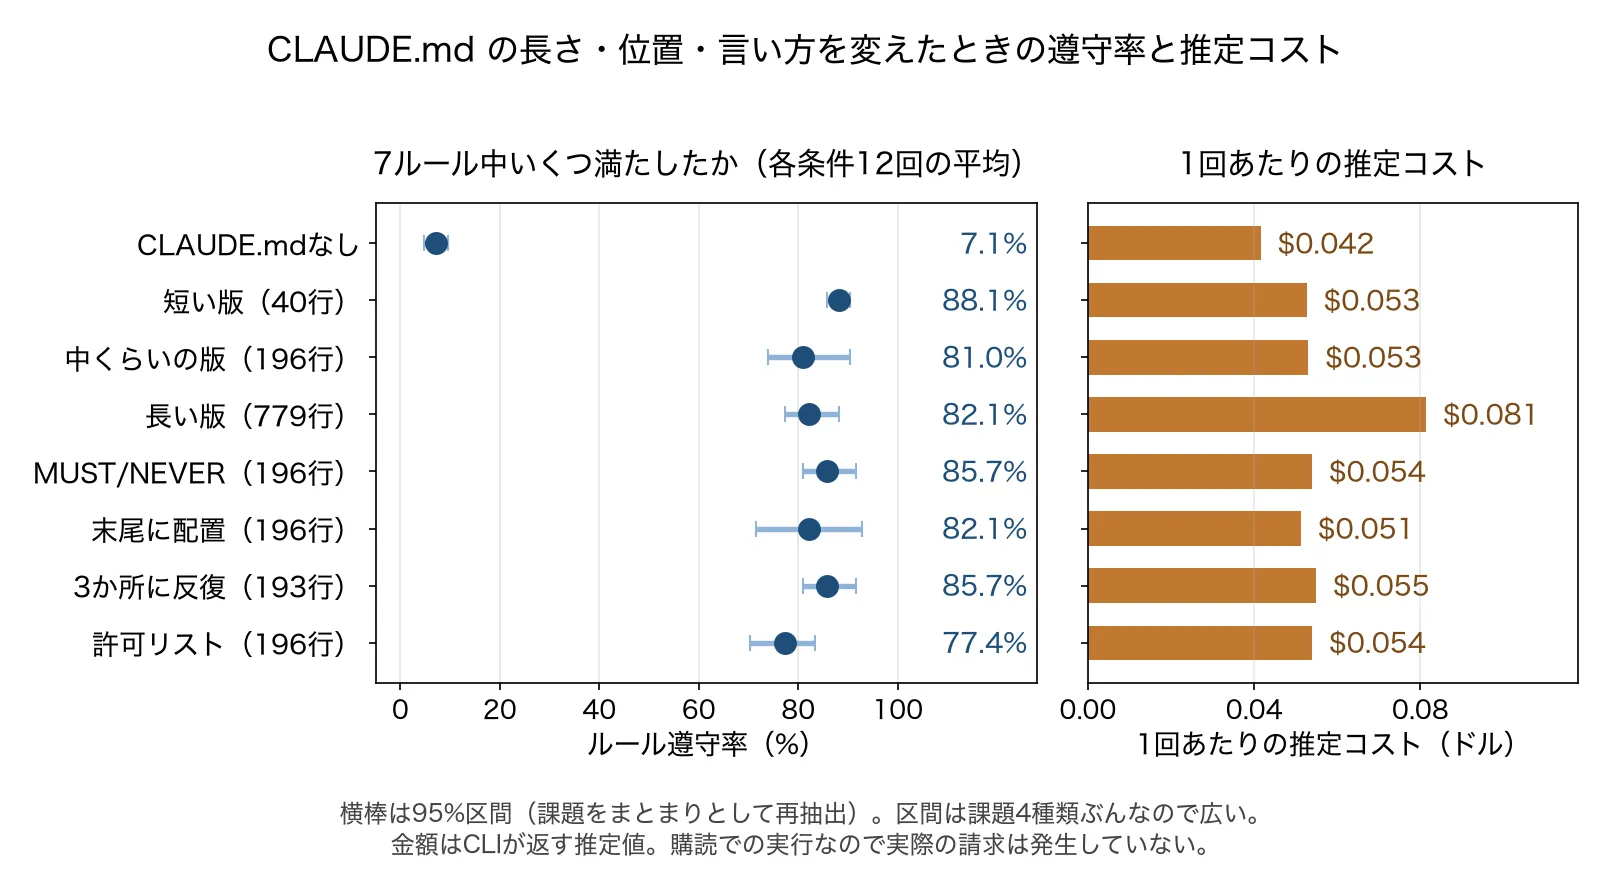
40行版が最高。ただし196行から779行に増やしても下がらなかった
測る前に見込んでいたのは、長くするほど守られなくなる形でした。よく見る助言もその向きです。実測はそうならず、779行にしても196行から落ちていません。
遵守率が最も高かったのは40行の短い版で、88.1%でした。196行の中くらいの版は81.0%、779行の長い版は82.1%です。短い版と長い版の差は+5.9ポイントで、4つの課題のうち3つで短い版が上、残る1つが同点でした。一方、196行から779行へ4倍に膨らませたときの差は+1.2ポイントにとどまり、どちらが上かは課題によって入れ替わります。
つまり、長さと遵守率は単調に落ちる関係ではありませんでした。40行から196行では7.1ポイント下がり、196行から779行ではほぼ動きません。しかも40行版と196行版の比較では、1つの課題だけ向きが逆でした。短い版が有利そうに見える、と言えるのはここまでで、どの長さでも同じ傾向になるとまでは言えません。
そこで、平均値をルール別に分けてみました。
差が出たのは、ほぼ2つのルール
平均の上下を作っていたのは、7ルールのうち2つでした。CLAUDE.mdありの7条件では、7ルールのうち4つが全84回で満たされています。戻り値の型注釈も、許可リスト版の1回を除いて満たされました。条件によって大きく上下したのは「print を使わない」と「関数20行以内」の2つです。
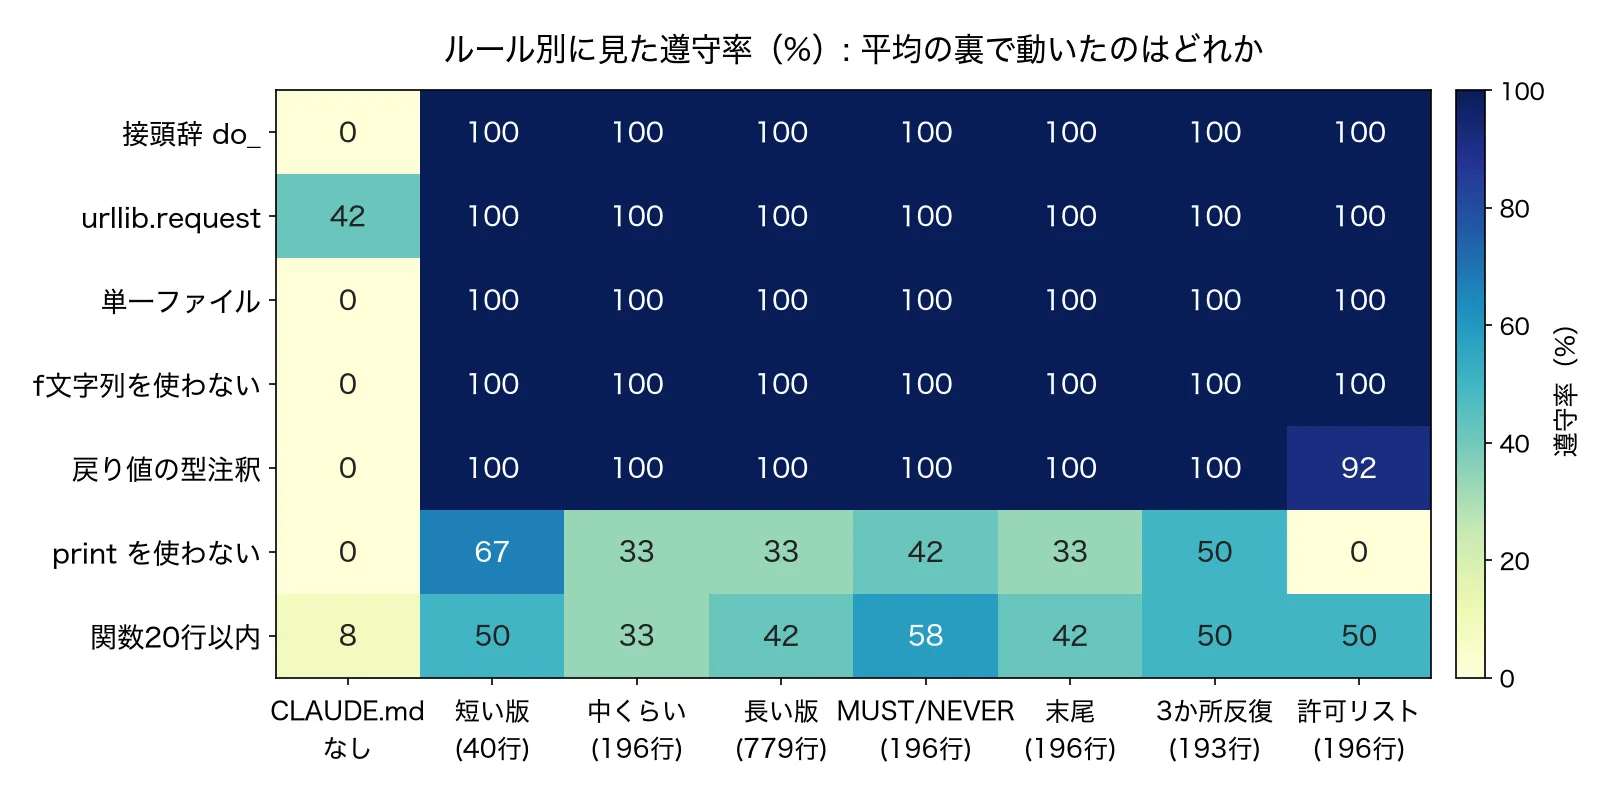
命名、通信ライブラリ、単一ファイル、f文字列の禁止は、CLAUDE.mdに1回書けば84回すべてで守られました。型注釈の取りこぼしも1回だけです。この型注釈は、規約がなくても付きやすいルールだろうと見込んでいたほうで、実際には対照条件の12回すべてで欠落しました。
残りの2つは、CLAUDE.mdがあっても安定しません。「print を使わない」は0〜67%、「関数20行以内」は33〜58%の幅で動きます。どちらもコードを書いている途中に違反する機会が何度も訪れるルールで、出力のどこか1か所に print が残る、関数が1つだけ21行になる、それで不合格になります。
条件間で平均が動いた原因も、「言い方が効いた」のではなく、この2つがどこまで持ちこたえたかの差だろうと見ています。平均遵守率という1つの数字だけを見て「短いCLAUDE.mdのほうが5.9ポイント優秀」と読むと、ほとんど動いていない5ルールまで含めて差がついたように見えてしまいます。
ルール別の数値を表で確認する
| ルール(単位: %) | CLAUDE.mdなし | 短い版 | 中くらい | 長い版 | MUST/NEVER | 末尾 | 3か所反復 | 許可リスト |
|---|---|---|---|---|---|---|---|---|
接頭辞 do_ | 0 | 100 | 100 | 100 | 100 | 100 | 100 | 100 |
urllib.request を使う | 42 | 100 | 100 | 100 | 100 | 100 | 100 | 100 |
| 単一ファイル | 0 | 100 | 100 | 100 | 100 | 100 | 100 | 100 |
| f文字列を使わない | 0 | 100 | 100 | 100 | 100 | 100 | 100 | 100 |
| 戻り値の型注釈 | 0 | 100 | 100 | 100 | 100 | 100 | 100 | 92 |
print を使わない | 0 | 67 | 33 | 33 | 42 | 33 | 50 | 0 |
| 関数20行以内 | 8 | 50 | 33 | 42 | 58 | 42 | 50 | 50 |
MUST/NEVER、置き場所、反復は決め手にならなかった
言い方・位置・反復の3つは、いずれも196行版を基準にして1か所だけ変えたものです。結果から言えば、どれも採否を決める材料にはなりませんでした。
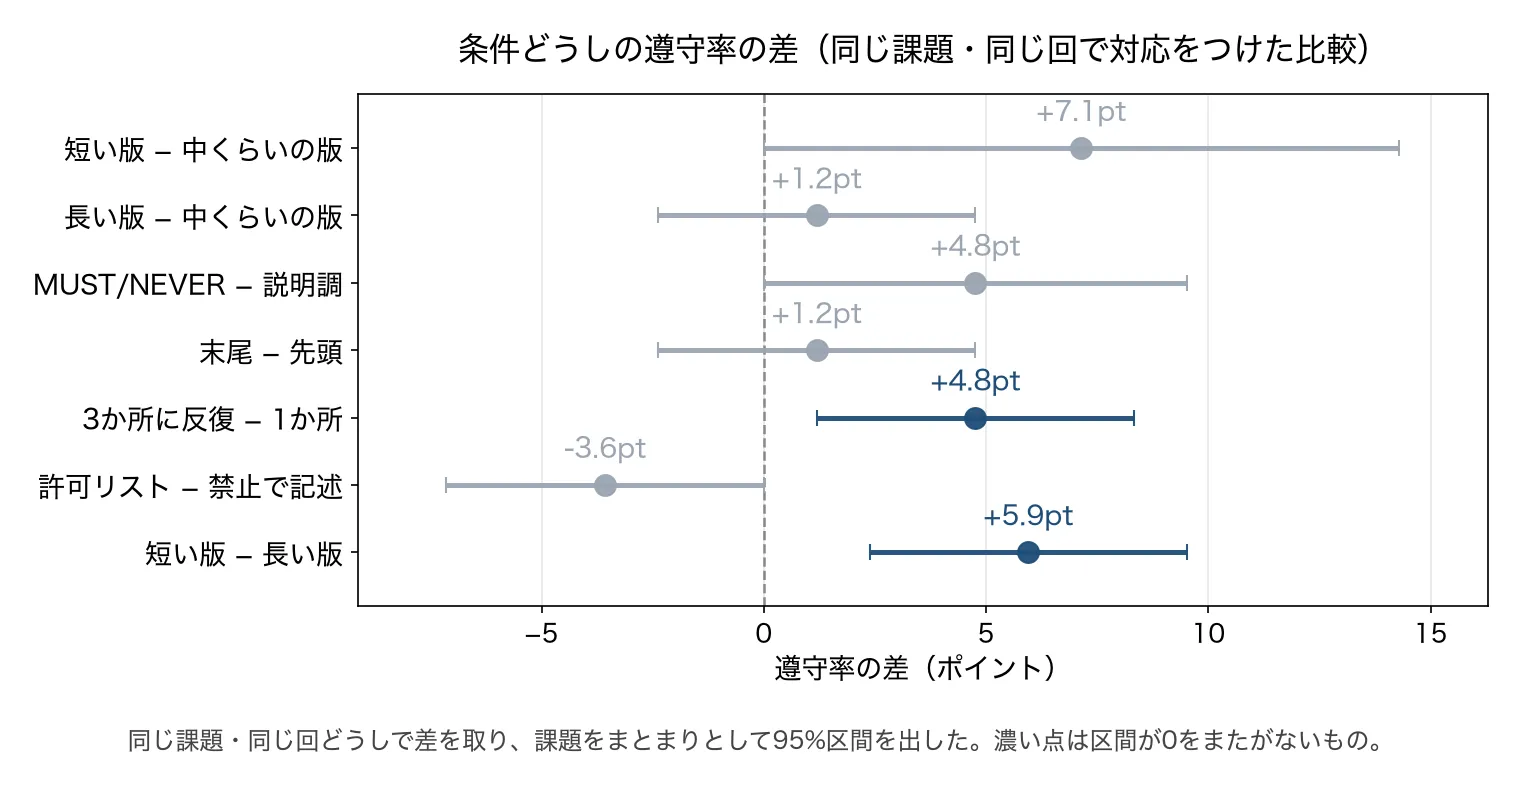
図の横棒は95%区間、つまり「同じ測り方をやり直したときに差が収まりそうな幅」です。この幅が0をまたがなければ、差の向きは一応そろっていることになります。ただし今回はまとまりの単位が課題4つしかなく、4つのうち3つで同じ向きに動けば区間は機械的に0をまたがなくなります。 3か所に反復した条件の点が0から離れて見えるのも、この事情の内側です。
MUST/NEVER版と、同じルールを3か所へ書いた版は、どちらも遵守率85.7%でした。196行の基準から+4.8ポイントです。1条件あたり12回×7ルール=84件の判定のうち、合格が増えたのも4件ずつでした。違ったのは課題ごとの散らばり方で、3か所反復版は3課題で上がり、命令形は2課題で上がりました。残りは同点で、下がった課題はありません。
課題が4種類しかない設計では、数ポイントの差を見分けられません。同じ条件を何度実行しても解決せず、増やすべきは課題の種類でした。命令形と反復のどちらが効いたのかも、この結果からは言えないままです。
3か所反復版そのものにも、注意点がひとつあります。この版は埋め草を削ってルールを2回足したもので、行数は196行から193行へ3行減っています。ただし文字の量まで揃ってはおらず、ルールを3回書いたぶん、ファイル全体の大きさは基準より約7%増えました。純粋に「繰り返しただけ」の比較にはなっていません。
ルールを末尾へ移した版も+1.2ポイントで、向きは課題によって入れ替わります。「大事なことは先頭に書け」という助言は、少なくとも196行程度のファイルでは、遵守率の面では裏づけを得られませんでした。
許可リストだけでは print を止められなかった
CLAUDE.mdに規約を書いた7条件のうち、ルールの文面そのものを書き換えたのは許可リスト版だけです。禁止を並べず「使ってよいもの」を挙げる書き方は、短く済む方法として紹介されることがあります。今回は、この版だけが目に見えて崩れました。
遵守率は7条件で最も低い77.4%です。「print を使わない」に相当するルールは12件中0件でした(禁止で書いた版は33%、短い版は67%)。短い版との差は10.7ポイントあり、4つの課題すべてで短い版が上です。
「使ってよい情報出力: logging」と書けば、モデルは logging を使います。ただ、それで print をやめる理由にはなりませんでした。少なくとも今回のモデルには、やめてほしい操作もそのまま書く必要がありました。この版が最下位になった主因はこの出力ルールで、7条件で唯一の型注釈の取りこぼしも、ここで起きています。
合否だけでは、print の減り方が見えない
ここまでの集計では、print が1回でも残れば違反です。ただし、呼び出し回数まで数えると見え方が変わります。
CLAUDE.mdなしの条件では、1回あたり平均9.50個の print が書かれていました(12回すべてで6〜14個)。ルールを書いた条件では大きく減り、短い版で0.92個、最も多く残った許可リスト版でも2.92個です。中くらいの版・長い版・MUST/NEVER版・末尾版・3か所反復版は、いずれも1.4〜1.9個でした。
print を禁止する指示自体は、どの条件でもある程度効いていました。平均9.5個が1〜3個まで減り、そのうえで最後の1個が残ったかどうかで合否が分かれています。遵守率だけを見ると、ルールの効果は小さく、条件間の差は大きく見えます。
残った print の用途も確認しました。許可リスト版のコードから出力部分だけを抜き出すと、進捗とエラーにはロガーを使い、利用者に返す最終結果だけを print していました。
# 許可リスト版が書いた solution.py からの抜粋(16・21・33・52行目)
logger.info("URL: %s" % BASE_URL)
logger.info("取得できた通貨: %d件" % currency_count)
logger.error("通貨 %s は含まれていません" % currency)
print("%.2f" % result)
ルールを無視したわけではなく、「ログ」と「利用者向けの表示」を分けて解釈したように見えます。関数の長さにも似たところがあり、20行を超えた関数はCLAUDE.mdありの7条件で延べ55件、その47%は21〜23行でした。一方で3分の1は27行以上、最大は41行です。上限のすぐ上で止まるものと、大きくはみ出すものが混ざっています。
長い版で増えたのは遵守率ではなく推定コストだった
1回あたりの推定コストは、CLAUDE.mdなしの$0.0415に対し、40行版で$0.0526でした。779行版は$0.0813で、ほかのCLAUDE.mdあり6条件($0.0512〜$0.0548)の約1.5倍です。対照条件と比べると約2倍でした。そのぶん遵守率が上がっているわけでもありません。96回の合計は$5.31でした。
この金額は、Claude Codeが返す推定値です。使ったトークン数を標準の従量単価で換算したもので、今回はサブスクリプションで実行したため請求は発生していません。従量課金で同じ量を使った場合の目安です。
内訳を見ると、CLAUDE.mdの長さを素直に反映しているのはキャッシュ書き込みで、1回あたり9,641トークンから24,735トークンまで増えました。キャッシュ読み出しは実行順に大きく左右されるため、条件間の比較には使えません。推定コストは両方の合算なので、「消費が減った」と言うときは、金額なのか、特定のトークン量なのかを分ける必要があります。
従量課金で1日に何十回もセッションを開くなら、779行版で増えた1回$0.03弱も積み上がります。たまに使うだけなら小さな差で、定額プランなら請求額は変わりません。遵守率が上がっていない以上、コストを払ってまでファイルを長くする理由は見つかりませんでした。
まずルールを書き、必要になってから短くする
CLAUDE.mdがまだ無いなら、書くこと自体が最大の一手。 守らせたいルールを並べたファイルを1つ置くだけで、最初の表の1行目と2行目ほどの距離が動きます。文面の工夫はそのあとで足ります。
短い版から始めて足りないぶんを足すのが、いまの結果に合う手順。 40行版が最も高く、推定コストも低い側でした。ただし最適な長さを決められる結果ではないので、40行に収めることを目標にはしなくて構いません。
すでに数百行あるファイルは、遵守率だけを理由に急いで削らない。 196行と779行の差は+1.2ポイントで、向きも課題によって入れ替わりました。人間が読みづらい、更新しづらい、推定コストを抑えたい。削るのはそういう問題が出たときのほうが筋が通ります。
許可リストの落とし穴は、禁止したい操作が文面から抜けること。 logging を許可するだけでは、print の禁止までは伝わりませんでした。MUST/NEVERへの変更やルールの反復は、今回の結果だけでは優先する理由が見つかりません。
最後に見るのは、生成されたコードそのもの。 命名やライブラリ指定は安定して守られた一方、出力方法と関数の長さには取りこぼしが残りました。どのルールが落ちるかは書き方から予測できないので、手元のファイルでも一度確かめるのが早いと思います。
詳しい検証条件: 8条件のCLAUDE.mdと、差の読み方
ここからは、比べたファイルの中身と測り方です。結果の順位を読み替えるほどの条件はここに集めてあります。
比べた8条件の中身
規約の文面は、説明調、MUST/NEVERの命令形、許可リストの3種類です。ほかの5条件では説明調の文面を変えず、置き場所、反復回数、周囲の説明量だけを変えました。舞台は架空の在庫管理ツール shelfkit のリポジトリです。
1. CLAUDE.mdなし(0行)
ファイルを置きません。7つのルールはどこにも書かれていない状態です。
2. 短い版(40行)
残り6条件は、この6〜16行目の規約を差し替えるか、17行目より後ろへ説明を足したものです。
# 在庫管理ツール shelfkit — プロジェクト方針

このリポジトリは、小規模な小売店向けの在庫管理コマンドラインツール `shelfkit` の実装です。
店舗スタッフが端末から在庫の照会・補充計画の作成を行えるようにすることを目的にしています。

## コーディング規約

この節は、このリポジトリのコードが従っている書き方をまとめたものです。

- 公開関数の名前は `snake_case` にしていて、接頭辞 `do_` から始めています。`do_fetch_rate` や `do_format_row` のような形になります。内部専用の補助関数はアンダースコアから始めるので、この接頭辞の対象外です。エントリポイントの `main` も対象外です。
- HTTP 通信には標準ライブラリの `urllib.request` を使っています。`requests` は依存関係を増やすため、このリポジトリでは導入していません。
- 実装は `solution.py` の1ファイルにまとめています。補助モジュールやテストファイルを別に作る運用はしていません。
- 文字列の組み立てには `%` 書式を使っています。f文字列は使っていません。
- すべての関数定義に戻り値の型注釈を付けています。引数の型注釈も原則として付けます。
- 実行時の情報出力には `logging` を使っています。`print` は使いません。
- 1つの関数は20行以内に収めています。長くなる場合は、アンダースコアで始まる補助関数へ切り出します。

## 想定している利用者

`shelfkit` を日常的に使うのは、店舗の在庫担当者と本部のバイヤーです。
在庫担当者は開店前と閉店後の1日2回、棚の実数と帳簿上の数量を突き合わせます。
バイヤーは週次で発注数を決めるため、直近の販売速度と在庫の残り日数を参照します。
どちらの利用者もコマンドラインに慣れているわけではないので、出力は日本語で、
1行あたりの情報量を抑えることを優先しています。

## 全体の構成

処理は大きく3層に分かれています。

第1層は入出力層です。コマンドライン引数の解釈、設定ファイルの読み込み、
外部サービスからのデータ取得、標準出力への表示をここで担当します。
外部との境界をこの層に閉じ込めることで、残りの層を単体で検証しやすくしています。

第2層は計算層です。在庫の残り日数、発注点、安全在庫といった数値をここで計算します。
この層は副作用を持たず、入力として渡された値だけから結果を組み立てます。
日付の扱いだけは例外で、基準日を引数として受け取る形にしています。

第3層は永続化層です。棚卸しの履歴と発注履歴をローカルの CSV に保存します。
データベースは使っていません。店舗ごとの規模が小さく、
ファイルをそのまま経理担当者へ渡せる利点のほうが大きいと判断したためです。
3. 中くらいの版(196行)
比較の基準です。冒頭の40行は上の短い版と完全に同じなので再掲せず、「全体の構成」の後ろへ足した11節だけを示します。規約以外は13節になります。
## 用語集

- **棚卸し**: 実際の棚にある数量を数えて記録する作業。`shelfkit count` で入力します。
- **帳簿在庫**: 入荷と販売の記録から計算される、理論上の在庫数量です。
- **差異**: 棚卸しの結果と帳簿在庫の差です。差異が続く商品は破損や紛失の候補になります。
- **販売速度**: 直近7日間の1日あたり平均販売数量です。季節商品では別の期間を指定できます。
- **残り日数**: 現在の在庫数量を販売速度で割った値です。発注の緊急度を判断する主指標です。
- **発注点**: 残り日数がこの値を下回ったら発注する、という閾値です。商品分類ごとに設定します。
- **安全在庫**: 需要の変動に備えて常に確保しておく数量です。過去の変動幅から算出します。
- **リードタイム**: 発注してから入荷するまでの日数です。仕入先ごとに登録します。
- **セット商品**: 複数の単品をまとめた商品です。在庫数量は構成単品の最小値で決まります。
- **廃番**: 仕入先が取り扱いを終了した商品です。在庫が尽きた時点で一覧から外れます。

## 設定ファイル

設定は `shelfkit.toml` に置いています。店舗コード、仕入先の一覧、
商品分類ごとの発注点、営業日カレンダーの4つが主な内容です。
設定ファイルが見つからない場合は、カレントディレクトリから上位へ順に探します。
見つからなければ既定値で動作しますが、店舗コードだけは必須なので、
未設定のときは処理を始めずに終了します。

営業日カレンダーは、販売速度の計算から休業日を除くために使います。
初期の実装では単純に7日間で割っていましたが、
週1日の定休日がある店舗で販売速度が15%ほど低く出る問題があり、
営業日だけを分母にする形へ変更しました。

## 外部サービスとの連携

仕入先の一部は、在庫と価格を返す HTTP の API を公開しています。
`shelfkit` はこれを取得して、発注可能かどうかの判断に使います。
API の応答は JSON で、商品コードをキーにした辞書の形です。
応答が遅い仕入先があるため、タイムアウトは既定で10秒にしています。

API が利用できない仕入先については、担当者が月次で更新する CSV を代わりに読み込みます。
CSV の列構成は仕入先ごとに異なるので、列名の対応表を設定ファイルに持たせています。

## 過去の意思決定メモ

**データベースを使わない判断について。** 検討の初期には SQLite を使う案がありました。
複数店舗のデータを1つのファイルにまとめられる点が魅力でしたが、
実際の運用では店舗ごとに担当者が異なり、データを混ぜないほうが事故が少ないと分かりました。
また経理へ渡すファイルが CSV である以上、どこかで変換が必要になります。
最初から CSV で持つほうが工程が減るため、この案は採用しませんでした。

**日付の扱いについて。** 当初は関数の内部で現在時刻を取得していましたが、
月末をまたぐ集計の検証が難しくなったため、基準日を引数で受け取る形に変更しました。
呼び出し側が1か所だけ現在時刻を取得し、以降はその値を引き回します。

**エラー処理の方針について。** 外部サービスの障害は日常的に起きるので、
1つの仕入先の失敗で全体を止めない構成にしています。
失敗した仕入先は結果に「取得できず」と記録し、他の仕入先の処理を続けます。
すべての仕入先が失敗した場合だけ、終了コードを非ゼロにします。

**出力の形式について。** 表形式の整形は文字幅の計算が必要で、
日本語と英数字が混ざると桁がずれます。全角文字を2桁として数える処理を入れましたが、
一部の記号で例外があり、完全な整列は諦めました。
現在は列の区切りをタブにして、表計算ソフトへ貼り付けられることを優先しています。

## 開発の進め方

変更は小さな単位で行い、1つの変更で1つの関心事だけを扱います。
新しい機能を足すときは、まず計算層に純粋な関数として書き、
入出力層からそれを呼ぶ形にします。この順序にすると、
外部サービスが利用できない環境でも計算部分の検証を進められます。

依存関係は最小限に保っています。現時点で追加している外部パッケージはありません。
標準ライブラリだけで書ける範囲に機能を収めることを設計の制約にしています。
将来的に表形式の出力が複雑になった場合は、整形ライブラリの導入を再検討します。

## 既知の制約

- 複数店舗の横断集計は未対応です。店舗ごとに実行して結果を手作業でまとめています。
- 商品コードの体系が仕入先ごとに異なり、同一商品の名寄せは手動の対応表に頼っています。
- セット商品の在庫計算は構成単品が3つまでを想定していて、それ以上は検証していません。
- 営業日カレンダーは1年分しか持たないため、年末に更新作業が必要です。
- 価格改定の履歴を保持していないので、過去時点の在庫金額を再計算できません。

## コマンドの一覧

`shelfkit` が受け付けるサブコマンドは現在7つです。

`count` は棚卸しの入力です。商品コードと実数を対話的に受け取り、履歴に追記します。
入力の途中で中断された場合、それまでの入力は破棄されます。
部分的な棚卸しを保存すると、差異の解釈が難しくなるためです。

`diff` は棚卸しと帳簿在庫の差異を一覧にします。差異の絶対値が大きい順に並びます。
差異がゼロの商品は既定では表示されません。

`plan` は発注計画を作ります。残り日数が発注点を下回った商品について、
リードタイムと安全在庫から必要数量を計算します。

`fetch` は仕入先の API から在庫と価格を取得します。取得結果はキャッシュに保存され、
同じ日のうちは再取得しません。

`export` は集計結果を CSV に書き出します。経理へ渡すファイルはこの形式です。

`history` は過去の棚卸し履歴を表示します。期間の指定がない場合は直近30日分です。

`doctor` は設定ファイルとデータファイルの整合性を確認します。
列の欠落、商品コードの重複、日付の不正な並びを検出します。

## 導入までの経緯

最初の版は、店舗の担当者が使っていた表計算ソフトのマクロを置き換える目的で作られました。
マクロは1店舗の運用に合わせて長年つぎはぎされており、他店舗へ持ち出せない状態でした。
共通化できる部分と店舗ごとに違う部分を切り分けるところから作業が始まっています。

切り分けの結果、共通化できたのは残り日数と発注点の計算、差異の一覧、履歴の保存の3つでした。
店舗ごとに違ったのは、商品分類の粒度と、催事期間の扱いです。
前者は設定ファイルで吸収し、後者は当面は対象外としました。

置き換えは3店舗で先行して行い、2か月ほど並行運用しました。
並行運用の期間に見つかった食い違いの多くは、休業日の扱いと、
入荷日の記録が実際より1日早い店舗があったことが原因でした。

## CSV の形式

棚卸し履歴の CSV は5列です。日付、店舗コード、商品コード、実数、担当者コードの順に並びます。
日付は `YYYY-MM-DD` の形式で、時刻は保持していません。
1日に複数回の棚卸しを行う店舗があるため、同じ日付の行が複数存在します。
その場合は後の行を有効として扱います。

発注履歴の CSV は7列です。日付、店舗コード、仕入先コード、商品コード、
発注数量、単価、入荷予定日の順です。入荷予定日は発注時点のリードタイムから計算した値で、
実際の入荷日とは別に記録しています。

文字コードは UTF-8 です。表計算ソフトで開いたときに文字化けする環境があるため、
`export` では BOM を付ける選択肢を用意しています。

## 季節要因の扱い

年間を通じて需要が一定でない商品があります。
飲料は夏に、暖房関連の小物は冬に販売数量が伸びます。
直近7日間の平均だけを使うと、需要が立ち上がる時期に発注が遅れます。

前年同期の実績を係数として使う案を検討しましたが、
商品の入れ替わりが速く、前年に存在しない商品が多いことが分かりました。
現在は商品分類の単位で係数を持ち、単品ではなく分類の傾向を使っています。

催事期間は例外が多く、係数では扱えません。
催事の前後は担当者が手作業で数量を調整しており、この部分は自動化していません。

## 運用上のよくある確認

在庫の残り日数が極端に大きく出る場合、販売速度がゼロに近い可能性があります。
新商品や季節外の商品では販売実績が少なく、残り日数が意味を持ちません。
このため販売実績が3日分に満たない商品は、残り日数を計算せず対象外として扱います。

差異が毎回同じ方向に出る商品は、入荷の記録漏れか、
セット商品の構成数量の登録誤りが原因のことが多くあります。
`doctor` で構成数量の整合性を確認できます。

仕入先の API から取得した価格が前回と大きく異なる場合、
単位の違いが原因のことがあります。ケース単位と単品単位が混在する仕入先があり、
対応表で単位を吸収しています。
4. 長い版(779行)
1〜196行目は中くらいの版と完全に同じです。そのあとに、同じ性格の節が53続きます。
## 店舗ごとの運用の違い

導入している店舗は現在12店です。売場面積は最小の店で40坪、最大の店で210坪あり、
扱う商品数も3千点から1万2千点まで開きがあります。
小さい店では担当者が1人で全分類を見ますが、大きい店では分類ごとに担当が分かれます。

担当が分かれている店では、棚卸しの入力も分類ごとに別々の時間帯に行われます。
1日分の入力が揃うのが翌朝になることがあり、差異の確認が1日ずれます。
この遅れを前提に、差異の一覧は入力日ではなく対象日で並べています。

売場面積の小さい店では、バックヤードの在庫と売場の在庫を分けて数えていません。
分けて数える店と混在するため、集計では店舗ごとの区分方法を設定から読んで切り替えます。

## 仕入先との取り決め

仕入先は現在38社です。うち9社が在庫と価格のAPIを公開しています。
残りの29社は月次のCSVか、担当者へのメールでのやり取りになります。

発注の締め時刻は仕入先ごとに異なり、最も早い社で午前10時、最も遅い社で午後6時です。
締めを過ぎた発注は翌営業日扱いになるため、入荷予定日の計算では締め時刻を考慮します。

最低発注金額を設けている社が14社あります。金額に満たない場合は送料が別途かかるため、
発注計画では複数商品をまとめて金額の下限を超えるように提案します。

返品を受け付けない社が6社あります。この6社の商品は、発注数量の提案を控えめにしています。

## 商品分類の設計

分類は3階層です。大分類が12、中分類が68、小分類が412あります。
発注点と安全在庫は中分類の単位で設定しています。
小分類まで細かくすると設定の維持が難しく、大分類だと粗すぎるためです。

分類の変更は年に1回、期首に行っています。期中の変更を認めると、
過去の実績との比較ができなくなるためです。
新商品が既存の分類に収まらない場合は、暫定的に「その他」の小分類へ入れ、期首に整理します。

分類ごとの商品数には偏りがあり、最も多い小分類には180点、最も少ない小分類には2点が属します。
点数の少ない分類では、分類単位の統計が安定しません。

(中略。同じ調子の節が49続く)

## 参考にした資料

在庫管理の基本的な考え方は、一般的な流通業向けの解説書を参考にしています。
安全在庫の計算式は需要の標準偏差とリードタイムから求める形が広く使われており、
このツールでも同じ考え方を採っています。

ただし需要の分布が正規分布から外れる商品が多く、
計算式どおりの値をそのまま使うと過大になる傾向があります。
現在は計算値に分類ごとの係数を掛けて調整しています。

係数の決め方に理論的な裏づけはなく、運用の実績から決めています。
中略した49節の見出しは次のとおりです。
## 価格改定の運用
## 返品と交換の扱い
## 棚割りとの関係
## 発注のタイミング
## 物流と入荷の記録
## 端末と実行環境
## 権限とアカウント
## バックアップ
## 障害時の運用
## 移行の記録
## 教育と引き継ぎ
## 監査対応
## 指標の定義
## 週次のレビュー
## 月次の締め
## 年次の棚卸し
## 廃番商品の扱い
## セット商品の設計
## 単位の換算
## 商品コードの体系
## 名寄せの運用
## 文字コードの経緯
## 日付と時刻の扱い
## 数量の丸め
## 金額の丸め
## 税の扱い
## 割引の扱い
## キャンペーンの期間
## 予約商品の扱い
## 取り寄せの運用
## 在庫の引当
## ロケーション管理
## 賞味期限の管理
## 温度帯の区分
## 什器と陳列
## 発注書の様式
## 検品の手順
## 誤差の許容範囲
## 棚卸しの頻度
## 応援スタッフの受け入れ
## 繁忙期の運用
## 閉店後の作業
## 開店前の作業
## レジとの連携
## ポイント制度と会員価格
## 帳票の保管期間
## 用語の揺れ
## 数字の見方についての注意
## 今後検討している内容
意味のない文字列で嵩を稼いだのではなく、上と同じ調子の文章が53節ぶん続きます。長い版の見た目は「読む価値のない水増し」というより「よくある、書きすぎたCLAUDE.md」に近いものです。ここに命令形や指示語がないこと、7ルールに関係する語が規約の節以外に出てこないことは機械的に確認しました。「ログは慎重に」のような文が1つ紛れるだけでも、長い版の条件が変わってしまうためです。
5. MUST/NEVERで書いた版(196行)
中くらいの版の規約11行を、内容を変えずに命令形へ置き換えたものです。ほかの節はすべて同じです。
## コーディング規約

以下は例外を認めない必須の規約です。

- 公開関数の名前は MUST で `snake_case` とし、接頭辞 `do_` から始めること。`do_fetch_rate` や `do_format_row` の形にすること。内部専用の補助関数はアンダースコアから始めること。エントリポイントの `main` は対象外とする。
- HTTP 通信には MUST で標準ライブラリの `urllib.request` を使うこと。`requests` は NEVER 使用しないこと。
- 実装は MUST で `solution.py` の1ファイルにまとめること。補助モジュールやテストファイルを NEVER 作らないこと。
- 文字列の組み立てには MUST で `%` 書式を使うこと。f文字列は NEVER 使用しないこと。
- すべての関数定義に MUST で戻り値の型注釈を付けること。引数の型注釈も付けること。
- 実行時の情報出力には MUST で `logging` を使うこと。`print` は NEVER 使用しないこと。
- 1つの関数は MUST で20行以内に収めること。長くなる場合はアンダースコアで始まる補助関数へ切り出すこと。
6. 許可リストで書いた版(196行)
同じく規約11行だけを差し替えました。禁止をやめて「使ってよいもの」だけを並べています。この版には「print を使わない」に当たる文がありません。logging だけを許可すれば同じ意味になるのかを比べたい条件です。
## コーディング規約

このリポジトリで使ってよいものだけを挙げます。ここに挙がっていない書き方は採用していません。

- 使ってよい公開関数名: `do_` で始まる `snake_case`(`do_fetch_rate` など)。補助関数はアンダースコア始まり。エントリポイントは `main`。
- 使ってよい HTTP 通信: 標準ライブラリの `urllib.request`。
- 使ってよい成果物: `solution.py` の1ファイル。
- 使ってよい文字列の組み立て: `%` 書式。
- 使ってよい関数定義: 戻り値の型注釈が付いたもの。引数の型注釈も付ける。
- 使ってよい情報出力: `logging`。
- 使ってよい関数の長さ: 20行以内。超える場合はアンダースコアで始まる補助関数へ切り出す。
7. 末尾に置いた版(196行)
中くらいの版と同じ13節を使い、規約だけをファイルの最後(186行目)へ移しました。規約の文面は説明調のまま変えていません。
  1  # 在庫管理ツール shelfkit — プロジェクト方針
  6  ## 想定している利用者      規約を抜いたぶん前へ詰まる
 14  ## 全体の構成
 30  ## 用語集
 43  ## 設定ファイル
 56  ## 外部サービスとの連携
 66  ## 過去の意思決定メモ
 88  ## 開発の進め方
 99  ## 既知の制約
107  ## コマンドの一覧
131  ## 導入までの経緯
145  ## CSV の形式
159  ## 季節要因の扱い
172  ## 運用上のよくある確認
186  ## コーディング規約        説明調の11行
8. 3か所に繰り返した版(193行)
同じ規約11行を、冒頭・中間・末尾の3か所へ置きました。行数を揃えるため説明を2節ぶん削ってあります。
  6  ## コーディング規約        説明調の11行
 18  ## 想定している利用者
 26  ## 全体の構成
 42  ## 用語集
 55  ## 設定ファイル
 68  ## 外部サービスとの連携
 78  ## 過去の意思決定メモ
100  ## 開発の進め方
102  ## コーディング規約        まったく同じ11行
123  ## 既知の制約
131  ## コマンドの一覧
155  ## 導入までの経緯
169  ## CSV の形式
183  ## コーディング規約        まったく同じ11行
4種類の課題を単位に差を読んだ
本文の数値は、96回ぶんの実行結果をログとして保存し、そこから集計したものです。条件どうしの比較は、同じ課題・同じ回どうしで差を取りました。ただし課題は4種類しかないので、条件間の数ポイントを「差があった/なかった」の二値で読める設計ではありません。そこで本文では、差の大きさ(ポイント)と、4つの課題のうちいくつで同じ向きだったかを併せて示しています。「明確な差を確認できなかった」と書いた箇所は、「差がない」と証明したという意味ではありません。
モデルとeffortはフラグで明示指定し、モデルIDが毎回 Haiku 4.5 であることは応答とセッション開始イベントの両方で確認しています。effortはCLIの出力にもデバッグログにも現れないため、「全条件で同じ値を指定した」としか言えません。 結論が当てはまる範囲はこの結果が当てはまる範囲にまとめます。
読み飛ばし可: 対応をつけた差の一覧・区間推定の手順・実行順・除外した実行
- 条件どうしの差は、同じ課題・同じ回のペア(各12組)で取りました。区間は課題をまとまりとした復元抽出(クラスタ数4、10,000回、シード 20260727)による95%区間です。クラスタ数が4しかないので、区間はあくまで目安であり、「0をまたがない」ことを強い証明として読まないでください。
| 比較 | 差(ポイント) | 95%区間 | 区間が0をまたぐか |
|---|---|---|---|
| 短い版 − 長い版 | +5.9 | [+2.4, +9.5] | またがない |
| 短い版 − 中くらいの版 | +7.1 | [−0.0, +14.3] | またぐ |
| 長い版 − 中くらいの版 | +1.2 | [−2.4, +4.8] | またぐ |
| MUST/NEVER − 説明調 | +4.8 | [+0.0, +9.5] | またぐ |
| 末尾 − 先頭 | +1.2 | [−2.4, +4.8] | またぐ |
| 3か所に反復 − 1か所 | +4.8 | [+1.2, +8.3] | またがない |
| 許可リスト − 禁止で記述 | −3.6 | [−7.1, +0.0] | またぐ |
| 短い版 − 許可リスト | +10.7 | [+4.8, +16.7] | またがない |
- 実行順は1回目・2回目・3回目それぞれで全条件を一巡する形にし、その中の順序はシード 20260727 でシャッフルしました。途中で止まっても条件ごとの実行回数が揃ったまま減るようにするためです。実際、96回のうち91件目でハーネスのプロセスが外部から停止されましたが、中断された1回を除外して同じ条件を実行し直し、比較は壊れずに済みました。
- 判定コードには合格例と違反例の両方を含むユニットテスト(19ケース・31判定)を付けています。ただし本文に書いたとおり、テストが確かめるのは「判定コードが仕様どおり動くか」であって「その仕様が測りたいものと一致しているか」ではありません。
- 副次的な観測値: 通常の入力トークンは全条件で26〜34と小さく、内訳の主役はキャッシュでした。出力トークンは2,650〜3,698、ターン数は3.08〜4.17、1回の所要時間は30.7〜42.1秒です。96回でエラーは0件、利用上限への到達も0件でした。
読み飛ばし可: 測定前に見つけた2つの落とし穴と、採点コードの修正
ルールは本番前の較正で決めています。最初に用意した「コメントとdocstringを日本語で書く」は、課題の指示文が日本語だったため、CLAUDE.mdがなくても4回中3回は満たされました。これでは条件差を見分けられません。「f文字列を使わない」へ差し替え、さらに「関数は20行以内」を加えています。20行という上限も、本番の結果を見る前に決めています。
採否の判断に使ったのは、CLAUDE.mdなしの条件と196行版だけです。残る6条件はまだ実行していませんでした。ただし、この2条件の結果を見て選んだ以上、ルール選定が結果と完全に独立だったとは言えません。較正で実行した分は本番の集計から除外しています。
もう1つ気をつけたのが、他の設定を読ませないことです。Claude Codeは実行したディレクトリから親をたどって設定ファイルを探します。手元のリポジトリ内で測ると、そこに置いてある別のCLAUDE.mdや .claude の定義まで読み込まれかねません。そこで実行のたびにリポジトリの外へ作業ディレクトリを作り、測りたいCLAUDE.mdと課題の仕様だけを置きました。実行前には、上位ディレクトリに別の CLAUDE.md や .claude がないことも確認しています。
ハーネスを書いている途中までは、成果物と同じリポジトリ内に作業ディレクトリを作る実装でした。実行前に直しましたが、そのままなら別の設定が混ざった状態で96回測っていたはずです。
較正の最初の1回では、採点コードの間違いも見つかりました。出てきたコードを人間の目で読むと、モデルは規約どおりに do_fetch_feed と命名し、補助関数を _parse_pubdate にしています。それなのに判定は「違反」でした。原因はこちら側で、エントリポイントの main まで公開関数として数えていたためです。
同じ実行では、モデルが説明を日本語のdocstringで書いていたのに、判定コードは # コメントしか数えず、#!/usr/bin/env python3 を英語コメント1件として数えていました。ユニットテストは19ケースすべて通り、例外も出さず、もっともらしい数字を返していました。成果物を1つ開いて判定結果と突き合わせるまで、誤りに気づけませんでした。 ルール文と判定コードを直し、その実行結果は破棄しました。
この結果が当てはまる範囲
今回確かめたのは、Haiku 4.5に、単一ファイルの小さなPython課題を1回ずつ解かせた場合です。結果を広げて読むときは、次の制約があります。
- 使ったモデルはHaiku 4.5、effortは
mediumの1水準だけです。effortが利用者側の設定を上書きしたかは確認できていません。 - 課題は4種類で、いずれも単一ファイルを作る1回きりの実行です。複数ファイルの開発や長い対話は測っていません。
- 7ルールは、構文木などで合否を判定できるものに限っています。「読みやすく書く」のような抽象的な方針には、この結果をそのまま当てはめられません。
- 平均遵守率の違いは、主に
printの禁止と関数20行以内の2ルールから生じています。別のルールを選べば、条件の順位も変わる可能性があります。 - 試した長さの上限は779行です。それを超える長さでも遵守率が変わらないとは言えません。追加した文章も架空プロジェクトの説明で、実際のCLAUDE.mdとは内容が異なります。
- 各条件12回ですが、課題は4種類だけです。数ポイントの差を、語調や配置の効果として確定できる設計ではありません。
- CLAUDE.md以外の経路(skills、サブエージェント、システムプロンプトへの直接指定)は測っていません。
CLAUDE.mdなしの7.1%は、Haiku 4.5のコーディング能力が低いことを示す数字ではありません。今回の7ルールはこの実験だけの取り決めで、対照条件には書かれていなかったためです。一方、許可リスト・長さ・語調の相対的な結果は、モデルによって指示の解釈が変われば入れ替わる可能性があります。
手元のCLAUDE.mdで同じ比較をするコード
比べたい2つの版、課題、判定したいルールを差し替えれば、版ごとの遵守率と1回あたりの金額が出ます。ここで判定しているのは3つのルール(print を使わない、f文字列を使わない、戻り値の型注釈がある)だけなので、check_rules は自分の規約に合わせて書き換えてください。
"""CLAUDE.md の2つの版で同じ課題を解かせ、ルール遵守率と金額を比べる。"""
import ast
import json
import os
import shutil
import subprocess
import tempfile
from pathlib import Path

# ここを自分の環境に合わせて差し替える
CLAUDE_MD_VERSIONS = {
    "現行版": Path("CLAUDE.md"),
    "削った版": Path("CLAUDE_short.md"),
}
REPETITIONS = 3  # 版ごとの反復回数。増やすほど利用枠を消費する
MODEL = "claude-haiku-4-5-20251001"
EFFORT = "medium"

TASK_PROMPT = (
    "spec.md を読み、その仕様を満たす Python スクリプトを書いてください。"
    "コードを実行する必要はありません。"
)
SPEC = """# 課題
公開CSVのURLと列名を受け取り、その列の件数・最小・最大・平均を求めて表示する。
- 取得する処理と集計する処理は別の関数に分ける
- 標準ライブラリだけを使う
- 実行中の状況が分かるようにする
"""

# 判定するルール。ここを自分の CLAUDE.md に書いてあるルールへ差し替える
RULE_NAMES = ("printを使わない", "f文字列を使わない", "戻り値の型注釈がある")


def check_rules(source: str) -> dict:
    """成果物のコードを構文木で走査し、ルールを満たしたかを判定する。"""
    try:
        tree = ast.parse(source)
    except SyntaxError:
        return dict.fromkeys(RULE_NAMES, False)
    nodes = list(ast.walk(tree))
    n_print = sum(
        1 for n in nodes
        if isinstance(n, ast.Call) and isinstance(n.func, ast.Name) and n.func.id == "print"
    )
    functions = [n for n in nodes if isinstance(n, (ast.FunctionDef, ast.AsyncFunctionDef))]
    return {
        "printを使わない": n_print == 0,
        "f文字列を使わない": not any(isinstance(n, ast.JoinedStr) for n in nodes),
        "戻り値の型注釈がある": bool(functions) and all(f.returns is not None for f in functions),
    }


def assert_isolated(workdir: Path) -> None:
    """上位ディレクトリに別の CLAUDE.md / .claude が無いことを確かめる。"""
    start = workdir.resolve()
    d = start
    while True:
        if d != start and ((d / "CLAUDE.md").exists() or (d / ".claude").exists()):
            raise SystemExit("上位に別の設定ファイルがあります: %s" % d)
        if d.parent == d:
            return
        d = d.parent


def run_once(md_path: Path) -> dict:
    """隔離ディレクトリを作り、CLAUDE.md と課題を置いて1回だけ実行する。"""
    workdir = Path(tempfile.mkdtemp(prefix="claude_md_bench_"))
    assert_isolated(workdir)
    shutil.copy(md_path, workdir / "CLAUDE.md")
    (workdir / "spec.md").write_text(SPEC, encoding="utf-8")
    before = {p.name for p in workdir.iterdir()}

    # 利用者側の設定を引き継がないよう、CLAUDE 系の環境変数を外す
    env = {k: v for k, v in os.environ.items()
           if not k.startswith("CLAUDE") and k != "ANTHROPIC_API_KEY"}
    cmd = ["claude", "-p", TASK_PROMPT, "--output-format", "json",
           "--model", MODEL, "--effort", EFFORT, "--max-turns", "30",
           "--permission-mode", "acceptEdits",
           "--allowedTools", "Read", "Write", "Edit",
           "--disallowedTools", "Bash", "--strict-mcp-config"]
    proc = subprocess.run(cmd, cwd=workdir, env=env, capture_output=True,
                          text=True, timeout=900)
    try:
        result = json.loads(proc.stdout)
    except json.JSONDecodeError:
        raise SystemExit("claude の出力を解釈できません: %s" % proc.stderr[:400])

    rules = dict.fromkeys(RULE_NAMES, False)
    for p in sorted(workdir.rglob("*")):
        if p.is_file() and p.suffix == ".py" and p.name not in before:
            rules = check_rules(p.read_text(encoding="utf-8", errors="replace"))
            break
    return {"workdir": str(workdir),
            "cost_usd": result.get("total_cost_usd", 0.0),
            "n_satisfied": sum(1 for v in rules.values() if v)}


def main() -> int:
    for path in CLAUDE_MD_VERSIONS.values():
        if not path.exists():
            raise SystemExit("ファイルが見つかりません: %s" % path)
    for label, path in CLAUDE_MD_VERSIONS.items():
        runs = [run_once(path) for _ in range(REPETITIONS)]
        rate = sum(r["n_satisfied"] for r in runs) / (len(runs) * len(RULE_NAMES))
        cost = sum(r["cost_usd"] for r in runs) / len(runs)
        print("%s: 遵守率 %.1f%%  1回あたり $%.4f" % (label, rate * 100, cost))
        for r in runs:
            print("    %d/%d  %s" % (r["n_satisfied"], len(RULE_NAMES), r["workdir"]))
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
REPETITIONS は既定が3なので、2つの版で計6回モデルを呼びます。このコードを REPETITIONS = 1 にして本文の196行版と40行版で動かしたときは、196行版が$0.0760、40行版が$0.0370でした。2回で合わせて$0.1130です。反復を増やせば、そのぶん金額と利用枠を消費します。
このときの結果は、どちらの版も3ルール中2つで、崩れたのは print を使わないルールだけでした。1回ずつなので条件の比較にはなりませんが、このコードが判定している3ルールに限れば、本編の同じ2条件(196行版と40行版)でも崩れたのは print を使わないルールだけです。本編でもう1つ上下した「関数20行以内」は、このコードでは判定していません。
assert_isolated は、作業ディレクトリより上に別の CLAUDE.md や .claude があれば実行を止める関数です。リポジトリの中で測ると、そこに置いてある設定まで一緒に読まれてしまうので、比べたい版だけが効いている状態を先に確かめています。
短いほど守られる、とまでは言えなかった
短いほど守られるのか。向きとしては40行版がいちばん高く、そこだけ見れば短い側に分があります。ただ、779行まで増やしても196行から落ちなかった以上、長さと遵守率が単調に対応する形にはなっていませんでした。
96回を通していちばん大きかったのは、長さでも言い方でもなく、守らせたい規約を明示したかどうかです。どう書くかを工夫しても、書いていないルールは守られません。書き方の助言に手を付けるのは、規約を1度書き切ったあとで足ります。
次に測るなら、増やすのは実行回数ではなく課題の種類です。4種類では、語調や配置の数ポイントを見分けられませんでした。複数ファイルを扱う作業や長い対話でも同じ形になるのかは、この96回の外にあります。
設定ファイルではなく実行時のeffortを動かした場合は、5段階のeffortを120回のコードレビューで比べた検証で測っています。lowからmaxへ上げると出力トークンは16.6倍・所要時間は6.9倍になった一方、検出率の差は確定できませんでした。実タスクでの精度を見た例は、データリーク入りのコードを読ませた検証にあります。