
Claude Codeには、モデルにどれだけ考えさせるかを決める effort という設定があります。同じファイルを同じ指示でレビューさせても、いちばん低いlowなら10秒足らずで返ってきた応答が、いちばん高いmaxでは1分を超えました。作業の途中でレビューを挟むとき、この差は小さくありません。
この設定を低くすれば速く返り、高くすれば長く考えます。では、増えた待ち時間に見合うものが返ってきているのでしょうか。
素直に測ろうとして、一度行き詰まりました。以前、似たことを実装タスクで測ろうとしたときは、どの条件でも成功率が満点に張り付き、段階の差を測れなかったのです。そこで今回は、バグを仕込んだコードをレビューさせ、バグのある行番号を当てさせる形に変えました。
本番前に8本すべてで較正を回し、仕込んだバグの当たり方が0%にも100%にも張り付かないことを確かめました。そのうえで、5段階×8タスク×3反復の120回を実行しています。
先に結論: 段階を上げても、仕込んだ30個のうち17個以上は判定が動かなかった
- 今回の8タスクでは、effort(考える量の設定)はlowから始め、指摘が物足りないときだけ上げるのが妥当。mediumはlowより遅いうえ、検出率の測定値も下回った(この段階どうしの比較は探索的な扱い)
- lowからmaxで出力トークン(モデルが生成した量)は16.6倍、所要時間は6.9倍。検出率(仕込んだバグをどれだけ指摘できたかの割合)の測定値は上向いたが、この規模では差を確定できず
- 仕込んだ30個のうち7個は全段階で一度も指摘されず。設計上の問題に偏る結果
- 適用条件: claude-sonnet-5の1モデル、Pythonファイル8本に仕込んだバグ30個、1段階あたり24回。正解かどうかは行番号の一致だけで判定
段階の名前と、この記事で数えるもの
今回の環境で指定できた effort は、low / medium / high / xhigh / max の5段階でした。既定に依存しないよう、120回すべてで --effort を明示指定しています。そのため既定値がどれかは測っておらず、この記事からは言えません。段階の名前も既定値もモデルによって変わるので、自分がいまどの段階を使っているかは公式の説明で確認してください。
検出率は、仕込んだバグのうち何個を指摘できたかの割合です。段階ごとの値は、8タスクそれぞれの検出率を平均したものになります。正解でない行をいくつ挙げたかが誤検出です。分量の単位には出力トークンを使います。モデルが生成した量ですが、今回の値は思考と可視出力の合算で、思考だけを取り出すことはできません。
「CLIが返す推定コスト」は請求額ではありません。 この値はCLIが定価をもとに手元で計算した概算で、実際の請求とは一致しないことがあると公式ドキュメントが明記しています。定額プランで使っている場合は、請求の観点では意味を持ちません。段階どうしの相対的な重さを示す値です。従量課金でなければ、実質的に増えるのは待ち時間になります。
5段階だけを変えて、同じ8本のコードを120回レビューさせた
比較したのは effort の5段階だけです。モデル(claude-sonnet-5)、プロンプト、許可したツール(ファイルの読み取りのみ)、出力形式(JSONのみ)は全条件で固定しました。プロンプトは「対象ファイルを読み、バグのある行番号をJSONで答えてください」の1種類で、観点の指定はしていません。
1段階あたり24回、合計120回を実行し、実行の失敗は0件でした。JSONの取り出しも120回すべて成功しています(うち10回は、JSONをコードフェンスで囲んだ形で返ってきました)。
実行には対話画面ではなく ヘッドレス実行(claude -p)を使っています。コマンドから1回だけ走らせて結果をJSONで受け取る使い方で、同じ条件を何十回も同じ形で繰り返せます。同じ呼び出しを小さくしたものはサンプル実装に置きました。
8本のPythonファイルに30個の欠陥を仕込んだ
使ったのは、実務で書き捨てられがちな小さなユーティリティに寄せたPythonファイル8本です。
- 統計計算(29行・欠陥4個)
- 在庫管理(30行・欠陥5個)
- 二分探索(28行・欠陥3個)
- テキスト整形(24行・欠陥3個)
- 日付処理(26行・欠陥4個)
- 買い物かご(20行・欠陥3個)
- APIクライアント(24行・欠陥4個)
- 金額計算(22行・欠陥4個)
欠陥は合計30個です。ミュータブルな既定引数やオフバイワンのような典型的なものから、金額にfloatを使う、例外を握り潰すといった「動きはするが設計として問題がある」ものまで散らしました。なお当初は29項目として登録しており、1項目に2つの欠陥を束ねていたことが後で分かって2つに割っています。
1本目の統計計算の課題は、こういうファイルです。# ← の印はこの記事のために付けたもので、モデルに渡したのはコメントの無い状態のファイルです。
import csv


def parse_scores(path, default_tags=[]):  # ← 4行目 バグ1: ミュータブルな既定引数
    rows = []
    with open(path) as f:
        reader = csv.reader(f)
        header = next(reader)
        for row in reader:
            rows.append(row)
    return rows, header, default_tags


def top_n(scores, n):
    ordered = sorted(scores, reverse=True)
    return ordered[0:n - 1]  # ← 16行目 バグ2: スライスのオフバイワン(末尾が1件足りない)


def average(scores):
    total = 0
    for s in scores:
        total += s
    return total / len(scores)  # ← 23行目 バグ3: 空リストならゼロ除算


def percentile(scores, p):
    ordered = sorted(scores)
    idx = int(len(ordered) * p / 100)  # ← 28行目 バグ4の実際の原因: p=100 のとき idx が len と等しくなる
return ordered[idx] # ← 29行目 バグ4として登録した行: 範囲外で IndexError仕込んだのは4個です。最後の1個、p=100 で添字が範囲外になる欠陥が、あとで採点の歪みとして表に出てきます。
同じ120回の回答を、二通りの規則で採点した
集計を終えてから、採点そのものに問題が見つかりました。当初は、モデルが答えた行番号が、あらかじめ登録した正解行と完全に一致した場合だけ検出と数えていました。この方法では、原因を正しく指していても、行番号が違うだけで不正解になります。上の統計計算の課題がまさにそれで、原因の行を答えたmaxの3回が、まとめて「検出0件、誤検出3件」になっていました。この減点は、深く考えさせた段階に偏っていました(登録した行と原因の行のずれは詳しい検証条件に書きました)。
結果を見てから正解データを書き換えると、都合のよい方へ寄せられます。そこで同じ120回の回答を二通りで採点し、両方を等しく載せることにしました。
| 採点軸 | 検出とみなす回答 | 原因側の行だけを答えた回答の扱い |
|---|---|---|
| 採点A | 修正後の正解行と完全に一致したものだけ | 不正解 |
| 採点B | 採点Aに加えて、同じ不具合を構成する関連行も | 正解 |
関連行というのは、たとえば辞書を反復しながら要素を削除する欠陥なら、for 文と del 文の両方です。この欠陥は片方だけでは成立しないので、採点Bではどちらを答えても検出として数えます。あわせて、1項目に束ねていた欠陥を割り直して正解の総数を29個から30個に直しており、この訂正は採点A・採点Bの両方に反映しています(割り直した中身は後半に回します)。訂正より前の数え方は「当初の採点」と呼び、誤検出の話にだけ出てきます。
採点Bで関連行として認めた5つの行は、実験前に決めたものではありません。120回の回答を見たあとで追加しています。恣意的に広げないよう、観測されていない行は足していませんが、採点Bに判断の余地が残ることは変わりません。だからこそ、完全一致だけを見る採点Aを常に併記します。行を追加した経緯は詳しい検証条件にまとめました。
待ち時間は増えたが、検出率の差は確定できなかった
待ち時間と出力量は5段階で一貫して増えた
| effort | 出力トークン中央値 | 所要秒中央値 | CLIが返す推定コスト(24回合計) |
|---|---|---|---|
| low | 362 | 9.6 | $2.85 |
| medium | 486 | 11.7 | $2.91 |
| high | 1,001 | 16.8 | $3.17 |
| xhigh | 1,633 | 21.1 | $3.52 |
| max | 5,994 | 66.6 | $6.61 |
出力トークンも所要時間も、段階に沿って単調に増えました。lowの362トークン・9.6秒を基準にすると、maxの中央値はそれぞれ16.6倍と6.9倍です。この2つは、8タスクという規模でも差を確認できました。 トークンも時間もコストも採点の定義とは無関係なので、この3列は採点Aでも採点Bでも同じ値です。
時間の差が効いてくるのは、作業を止めてレビューの結果を待つときです。10秒なら待てても、1分を超えると手が離れます。しかも中央値は穏やかなほうでした。maxでは1回あたりの所要時間が19.5秒から406.5秒まで開いており、どれくらい待つかも読めません。
一方、CLIが返す推定コストの増え方はもっと穏やかでした。24回ぶんの合計はlowの$2.85に対してmaxが$6.61、およそ2.3倍です(表の5段階を足すと、120回で$19.06です)。出力トークンの伸び方とは別物として読んでください。なお所要時間はこの実行環境で測った値なので、比較は同じ環境の中に限られます。
検出率は上向いたが、差は確定できない
検出率の測定値は、どちらの採点でも上がりました。行の完全一致で採点すると58.8%から67.5%へ、同一不具合の関連行も正解に含めると61.0%から72.5%へ動きました。向きは採点で変わりませんが、伸び幅は8.75ポイントと11.53ポイントで、3割ほど違います。
| effort | 検出率(採点A: 行の完全一致) | 検出率(採点B: 関連行も正解) |
|---|---|---|
| low | 58.8% | 61.0% |
| medium | 55.1% | 58.8% |
| high | 58.3% | 61.5% |
| xhigh | 66.2% | 69.4% |
| max | 67.5% | 72.5% |
ただし、差が出たのは8タスクのうち4つだけで、残る4つはmaxとlowで差がちょうど0でした。同じタスクの反復を増やしても、根拠の種類は増えません。別の性格のコードでも同じ傾向になるかは、この実験だけでは判断できませんでした。
段階の並びは単調ではありません。どちらの採点でもmediumがlowを下回り、いったん沈んでから上がります。谷はmediumです。
測定値だけなら、maxは1タスクあたり平均0.4個多く検出しました(採点Bの11.53ポイントは、1タスクあたり平均3.75個のバグに対して0.4個ぶんにあたります)。ただし、その0.4個と引き換えの出力量は前節のとおり16倍以上です。今回の結果だけでは、maxへ上げる価値があるとは判断できませんでした。
誤検出が増えたように見えたが、無関係な指摘は1件も無かった
当初の採点では、1回あたりの誤検出はlowの0.21からmaxの0.42へ倍増しているように見えました。深く考えるほど「ここも怪しい」と言い出しているのだろう、と解釈しかけたところです。
effortを上げたことで無関係な指摘が増えた、とは言えませんでした。当初「誤検出」として数えた回答は、すべて実在するバグの近くを指していたからです。120回で正解以外に挙がった行は延べ31件。その全部が、実在するバグの2行以内にありました(1行違いが21件、2行違いが10件、3行以上離れたものは0件)。無関係な行を挙げた回は1件もありません。延べ31件といっても、行としては6行に集中しています。症状行に対する根本原因の行、辞書を反復しながら消す欠陥の先頭行と中間行、リストを反復しながら消す欠陥の先頭行、日付の判定行に対する加算行、そして1つの項目に束ねていた2つ目の欠陥の行です。
正解の項目を分割したうえで数え直すと、行の完全一致での誤検出はlowが0.21、maxが0.29です。当初0.42だったmaxは0.29まで下がり、途中のhighが最も低い(0.12)という形になります。同一不具合の関連行も正解に含めると、全120回で0件です。
| effort | 誤検出/回(採点A) | 誤検出/回(採点B) |
|---|---|---|
| low | 0.21 | 0.00 |
| medium | 0.17 | 0.00 |
| high | 0.12 | 0.00 |
| xhigh | 0.17 | 0.00 |
| max | 0.29 | 0.00 |
採点Bで0になるのは、観測された行をそのまま同一とみなす規則にしたためで、定義上そうなります。読み取れるのは「実在バグと無関係な行を挙げた回が1件も無かった」という事実のほうです。
いちばん分かりやすいのが、束ねていた項目を分割したあとの挙動です。在庫管理の「戻り値の型が揃っていない」欠陥を指摘した回数は、low 0回・medium 0回・high 2回・xhigh 3回・max 3回でした。この8回は、当初の採点では全部「誤検出」に数えられていました。 段階を上げるほど誤検出が増えるように見えていたものの正体は、段階を上げるほど正しく指摘されるようになった欠陥だったわけです。
7個のバグは、maxでも一度も見つからなかった
仕込んだ30個のうち7個は、lowからmaxまでの15回(5段階×3反復)すべてで一度も指摘されませんでした。逆に、採点方法によって10〜13個は15回すべてで指摘されています。平均の検出率を眺めていると段階を上げるほど拾えるように読めますが、バグ1個ずつに割ると、effortを変えても判定が動かないものが30個の過半を占めます。
一度も見つからなかったのが7個、毎回見つかったのが採点Aで10個・採点Bで13個。この不変の群は採点Aで17個、採点Bで20個にのぼります。16倍を超えるトークンと7倍近い時間を払っても、この17個から20個の判定は1回も動いていません。
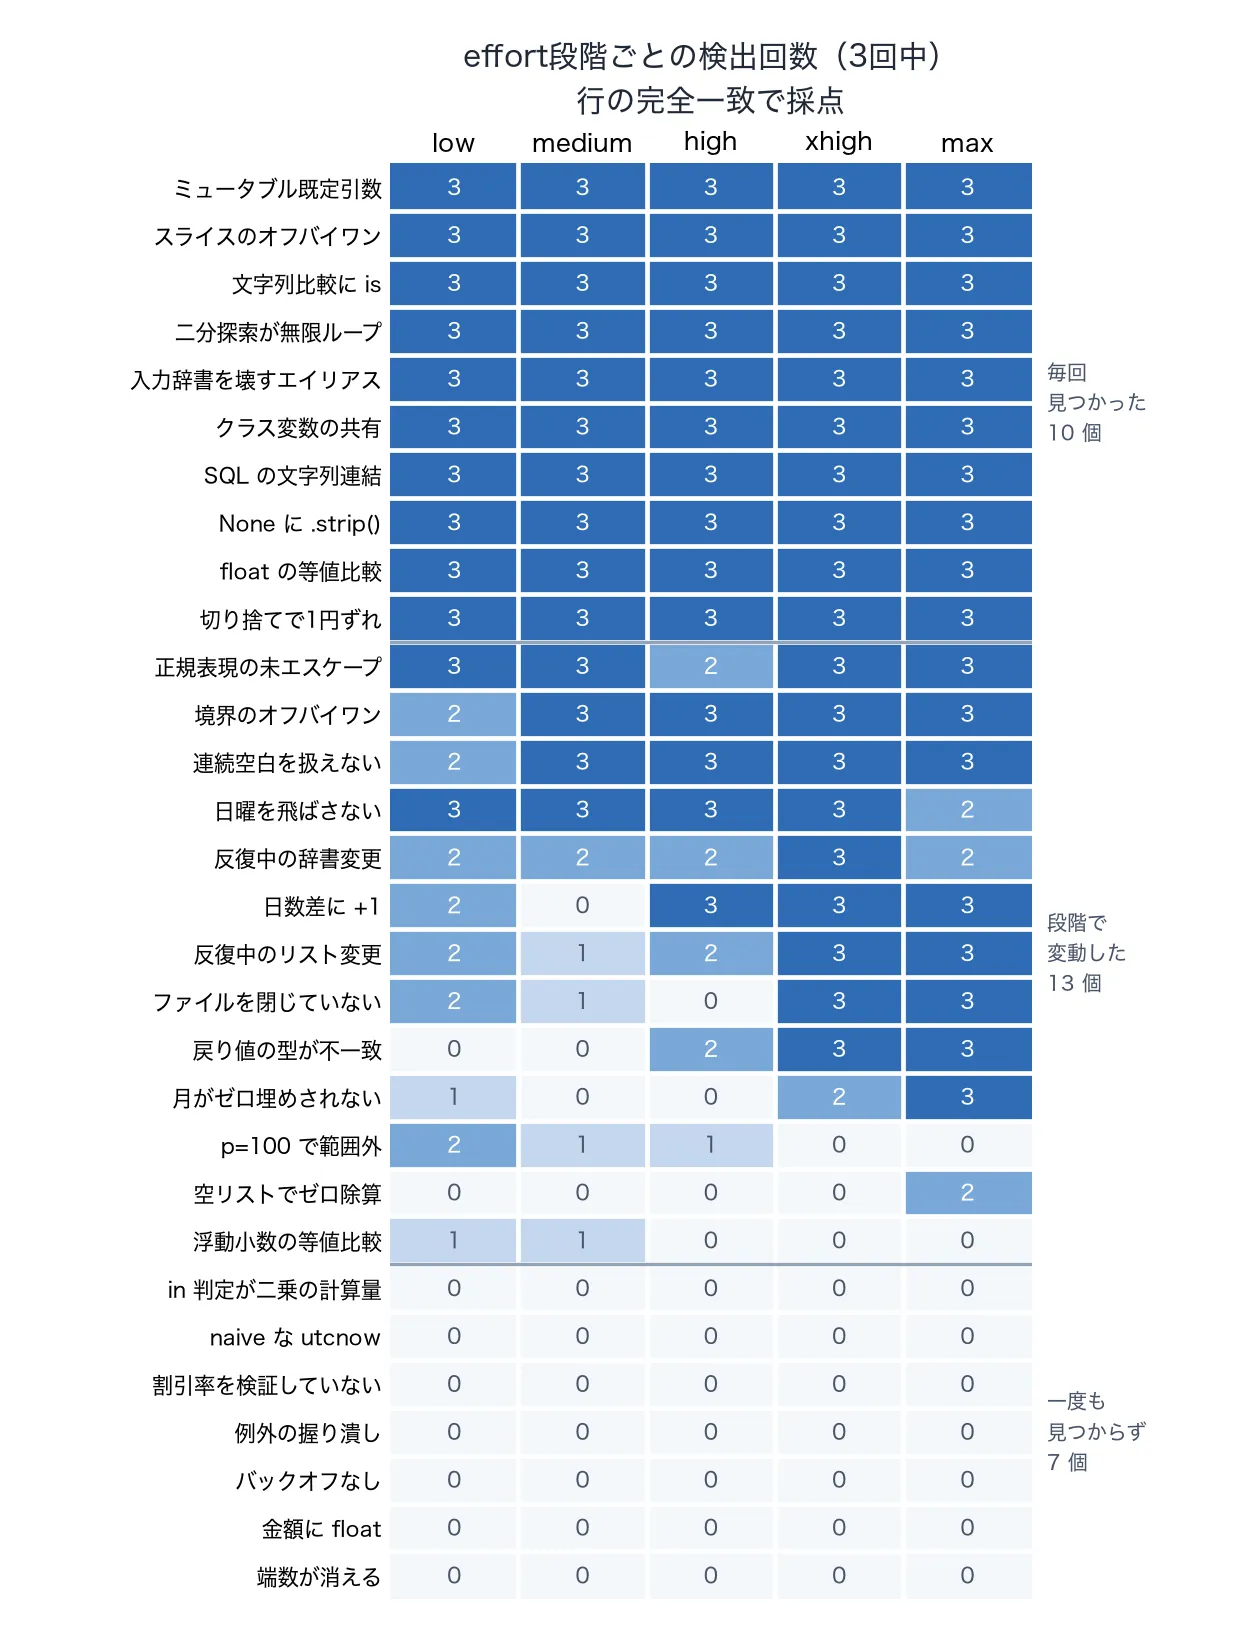
そして一度も見つからなかった7個は、両方の採点で完全に同じでした。まず5個を実物で並べます。どれも構文としては正しく、動きはします。
# 二分探索の課題(14-21行目): リストの in 判定なので、要素が増えると計算量が二乗になる
def dedupe(items):
    seen = []
    out = []
    for it in items:
        if it not in seen:
            seen.append(it)
            out.append(it)
    return out


# 日付処理の課題(14-15行目): naive な utcnow() では、タイムゾーン付きの日時と比較できない
def is_expired(expires_at):
    return expires_at < datetime.utcnow()


# 買い物かごの課題(18-20行目、Cart クラスのメソッド): rate に 200 や -50 が来ても素通りする
    def apply_coupon(self, rate):
        total = self.subtotal()
        return total - total * rate / 100


# 金額計算の課題(1-5行目): 金額を float で積むので誤差が残る
def running_total(values):
    total = 0.0
    for v in values:
        total += v
    return round(total, 2)


# 金額計算の課題(8-10行目): 割り切れないと合計が元の金額に戻らない
def split_bill(amount, people):
    share = amount / people
return [share] * people同一不具合の関連行まで正解に含めても1件も動きませんでした。近い行を答えて惜しく外したのではなく、話題にすら上がっていないのです。
行の完全一致で毎回見つかった10個は対照的でした。ミュータブルな既定引数、スライスのオフバイワン、文字列比較に is を使う、二分探索の更新漏れによる無限ループ、SQLの文字列連結、None に .strip()。入門書や静的解析ツールの解説でおなじみの型が並びます。
一度も見つからなかった残る2個は、APIクライアントの課題にあります。同じ対比が、1つのファイルの中でも起きていました。この # ← も記事のために付けたもので、モデルに渡したのはコメントの無いファイルです。
import time


def fetch(url, session, retries=3):
    for i in range(retries):
        try:
            r = session.get(url)
            if r.status_code == 200:
                return r.json()
        except Exception:  # ← 10行目 1度も見つからなかった: 例外を握り潰して原因が消える
            pass
        time.sleep(1)  # ← 12行目 1度も見つからなかった: 固定待ちでバックオフなし。最後の試行のあとにも待つ
    return None


def save_all(records, conn):
    cur = conn.cursor()
    for r in records:
        cur.execute("INSERT INTO t (name) VALUES ('" + r["name"] + "')")  # ← 19行目 毎回見つかった: SQLの文字列連結
    conn.commit()


def get_config(cfg, key):
    return cfg.get(key, None).strip()  # ← 24行目 毎回見つかった: キーが無いと None に .strip()
19行目のSQL文字列連結と24行目の None への .strip() は、5段階すべてで15回中15回見つかりました。一方、10行目で例外を握り潰していることと、12行目の再試行が固定待ちでバックオフを持たないこと(しかも最後の試行のあとにも待つ)は、15回中0回です。同じ24行を読ませて、片方は全段階で拾われ、もう片方は max でも話題に上がりませんでした。
見落とされたのは、設計上の問題のほうでした。性能、タイムゾーン、入力検証、エラー処理、金額の型。いずれも「動きはするが設計として問題がある」性質で、毎回見つかった側は典型的なパターンに寄っています。段階を上げても、拾われない側は拾われないままでした。
もっとも、これは30個という限られた標本での観察であって、因果の説明でも一般法則でもありません。正確に言えば、今回のプロンプトと設定では5段階のどれでも一度も挙がらなかった、というだけです。観点を指定して指示を書き直せば挙がる可能性は残っていますが、それは今回検証していません。
タスク単位で見た検出率(採点A・採点B)
タスク単位でも同じことが起きます。行の完全一致で採点したタスク別の検出率が下の表です。見るべきは列の高低ではなく、それぞれの行が段階をまたいで動いているかどうかです。
| タスク | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| 統計計算 | 66.7% | 58.3% | 58.3% | 50.0% | 66.7% |
| 在庫管理 | 53.3% | 46.7% | 46.7% | 80.0% | 73.3% |
| 二分探索 | 66.7% | 66.7% | 66.7% | 66.7% | 66.7% |
| テキスト整形 | 77.8% | 100.0% | 88.9% | 100.0% | 100.0% |
| 日付処理 | 50.0% | 25.0% | 50.0% | 66.7% | 66.7% |
| 買い物かご | 55.6% | 44.4% | 55.6% | 66.7% | 66.7% |
| APIクライアント | 50.0% | 50.0% | 50.0% | 50.0% | 50.0% |
| 金額計算 | 50.0% | 50.0% | 50.0% | 50.0% | 50.0% |
同一不具合の関連行も正解に含めると、動く行もあります。統計計算はmaxで91.7%まで上がり、日付処理はmaxで75.0%、買い物かごは5段階すべてが66.7%で揃います。それでも二分探索・APIクライアント・金額計算の3本は、どちらの採点でも5段階すべてで完全に同じ値でした。見つかったバグの顔ぶれも1つも入れ替わっていません。反対に日付処理は25.0%から66.7%まで動いており、段階を上げた効果はタスクによって別物です。自分のコードで段階を変える価値があるかどうかは、平均ではなくこの粒度で見ないと判断できません。ただし1タスクあたり3反復なので、まれにしか起きない変動は捉えられていません。
私ならlowで始め、段階を上げる前にプロンプトを見直す
今回の範囲なら、私が選ぶのはlowです。lowとmaxで検出率の明確な差を確認できませんでした。ただし、これは両者の精度が同じという意味ではありません。測定値のうえではmaxが1タスクあたり平均0.4個多く拾っており、その代わりに出力量は16倍以上、待ち時間は7倍近くになります。差が確定できない0.4個へ、その支払いをするかどうかという選択です。私はlowを選び、high以上へ上げるのは、lowの指摘が物足りないと感じたときにしています。
なお、mediumはlowより遅いうえに検出率の測定値も下回りました。段階どうしの比較のうち、事前に主役と決めていたのはmaxとlowの1組だけなので、この谷は探索的な観察として読んでください。
上げるかどうかを決めるときは、平均の検出率より「どの種類のバグが拾われていないか」を見るほうが手がかりになります。作業の途中でレビューを挟むなら、判断はさらにlow寄りになります。1分を超える待ちが、ときに数分になりました。
ただし、金額計算やエラー処理の見落としは段階を上げても残りました。一度も見つからなかった7個は、金額にfloatを使う、例外を握り潰す、入力を検証しない、といった性格のものです。私なら、effortを上げるより先に、確認したい観点をプロンプトへ書くほうを試します。その比較は今回の実験に入っていません。
指示をどこへ書くかという点では、CLAUDE.mdへ規約を書いた場合の遵守率も測っています。同じ7ルールを8条件のCLAUDE.mdで比べた検証では、ファイルなしの7.1%に対し、書いた条件は8割前後でした。実タスクでの検出精度を見た例としては、データリーク入りのコードを読ませた検証があり、Sonnet 5は70回中69回で機序まで言い当てています。
詳しい検証条件
結論の読み方に関わる細部は、ここにまとめます。本文の数値は、120回ぶんの実行ログを集計したものです。判定を伴わずに数値そのものへ触れるときは「測定値は」と断り、ばらつきを見込むと消える差や、この規模では決められない差は「明確な差を確認できなかった」と書いています。
採点の歪みが見えたのは、統計計算の課題でした。p=100 のときにエラーが起きる29行目を正解として登録していたのですが、実際の原因はその1行上にある idx = int(len(ordered) * p / 100) です。maxは3回とも原因側の28行目を答えており、当初の採点ではその3回が「検出0件、誤検出3件」になっていました。
正解データにも問題がありました。在庫管理の課題で、浮動小数の等値比較と戻り値の型の不一致という二つの欠陥を、一つの項目にまとめていたのです。これを二つに分け、正解の総数を29個から30個に直しました。
正解以外に挙がった行番号は、重複を除くと6種類でした。このうち1種類は、いま書いた二つの欠陥を分割したことでそのまま正解になっています。残る5種類はいずれも同じ不具合の一部と判断できたので、採点Bの正解に加えました。これが前半で触れた5行です。
読み飛ばし可: 段階の指定が本当に効いていたかの確認と、公平さのために固定したこと
段階の指定は本当に効いていたのか。
実行を終えてから、CLAUDE_EFFORT=high という環境変数が実行時の環境に残っていたことに気づきました。これがコマンドラインの --effort を上書きしていたなら、全条件が実質highで回っていたことになり、実験そのものが無効になります。推測で片付けず、同じタスクで3条件を1回ずつ走らせて確かめました。環境変数を残したまま --effort low を付けたときの出力トークンは285、環境変数はそのままでフラグだけ外したときは1,048で、後者は本実験のhighの中央値(1,001)とほぼ一致します。フラグの有無だけで結果が分かれているので、--effort は環境変数より優先されていました。各条件1回ずつの確認なので、読み取れるのはどちらの水準に収まったかまでです。
公平さのために固定したこと。
タスクの採否は単一条件(effort=high)での検出率だけで決めており、段階の間の差では選んでいません(効果そのものでタスクを選ぶと、その効果が上振れして見えるためです)。較正で回した分は本集計に含めていません。実行の順番はシャッフルして記録し、条件の並びと時間帯の変動が重ならないようにしました。そして全120回で、上位のディレクトリにある設定ファイルが1件も読み込まれていないことを確認しています。Claude Codeは実行したディレクトリから親をたどって設定ファイルを探し、見つけた内容をセッションに含めるので、それが紛れ込むと同じ指示でも挙動が変わります。
採用の目安は検出率30〜70%に置きましたが、テキスト整形の課題だけは較正で77.8%とこの範囲を超えていました。除外せずそのまま使っており、本実験では5段階のうち3段階で100%に達しています。この1本は上限に近いところで測っているので、段階の間の差が出にくくなっています。
モデルがなぜその行を挙げたかは見ていません。採点は行番号の一致だけで決まります。結論が当てはまる範囲は適用範囲と限界にまとめます。
統計の細部: 差の見積もり方と、この規模で確定できない理由(読まなくても結論は追えます)
- 条件どうしの差は、8つのタスクを単位にした対応ありのクラスタブートストラップ(2,000反復、seed=42)で推定しました。同じタスクの3反復を独立した3件として数えていません。同じコードを3回見せているだけなので、独立した3件ぶんの証拠にはならないためです。以下の角括弧は、この8タスクを選び直したら差がどのあたりまで動きうるかの幅で、実行時間のばらつきではありません。幅が0をまたがないことは向きの手がかりになりますが、それだけでは断定しません(理由は次の項)。
- 主役の比較は検出率の max − low の1つに絞り、それ以外の組み合わせは探索的として扱います。探索的なほうは比較数の多さに応じた補正をしていないので、単独では読まないでください。
- 主役の比較の結果は、採点Aで +8.75%pt [+2.50, +15.14]、採点Bで +11.53%pt [+2.78, +19.65]。区間はどちらも0を含みません。一方、8タスクの差の符号を全256通り反転させた並べ替え検定では、どちらも p=0.125 でした。
- この2つが食い違うのは、設計上の天井があるためです。検出率の max − low は8タスク中4タスクで差がちょうど0(両採点で二分探索・APIクライアント・金額計算、加えて採点Aでは統計計算、採点Bでは買い物かご)。符号を反転しても平均が動かないので、差がどれだけ大きくても p は 0.125 より小さくなりえません。区間だけを引いて断定せず、確定できない側に寄せて書いています。差を確定したいなら、段階で動くタスクの本数を増やすしかなく、反復を増やしても効きません。
- 出力トークンと所要秒の max − low は8タスク全部が同符号で、この設計で到達しうる最小の p=0.0078 でした。差は1回あたりの平均で、出力トークン +8,619 [+4,437, +13,034]、所要秒 +88.4秒 [+44.1, +135.5] です(本文の表に載せた中央値の差とは別の量です)。
- 誤検出の max − low は、1回あたり採点Aで +0.08件 [−0.25, +0.42]、採点Bで 0.00件 [0.00, 0.00] です。
- 最も議論の余地がある同一視(在庫管理の欠陥ブロックの中間行)を外して採点し直すと、検出率の max − low は +12.36%pt [+3.12, +21.25] でした。この行の同一視が効果量を押し上げているわけではありません。
- 正解の行番号は、各バグにしか現れない特徴的な文字列から機械的に位置を特定し、一致が1箇所であることを確かめて生成しました。実行順のシャッフルも seed=42 です。
- 使用量の記録には補助的なモデル呼び出し(入力1,580・出力13〜25、中央21)が混じるため、表の出力トークンはclaude-sonnet-5に帰属した分だけを集計しています。CLIが返す推定コストのほうは補助呼び出しを含む1回全体の値なので、両者を割り算して単価を出さないでください。
- 実行はClaude Code CLI 2.1.212で、2026-07-26のUTC 06:29から07:41までの約71分間に120回を連続実行しました。
適用範囲と限界
- モデル1種(claude-sonnet-5)、タスク8本、バグ30個、1段階あたり24回の範囲での結果です。他のモデルや他の性格のコードへ一般化できるものではありません。
- 本文で「明確な差を確認できなかった」と書いたのは、ばらつきを見込むと消えるか、この規模では決められない差のことです。差がないと証明したわけではありません。
- 採点規則で結論の強さが動きます。 今回は行の完全一致と隣接許容の二通りを並べましたが、正解の置き方や同一視の範囲を変えれば、伸び幅も誤検出の見え方も変わります。他の記事の数値と突き合わせるなら、採点規則が揃っているかで結論が変わります。
- 同じ不具合とみなす行は事前に登録したものではなく、データを見てから決めています。 恣意的に広げないよう観測された行だけに限りましたが、確証バイアスの余地は残ります。だからこそ厳密な採点Aも並記しています。
- 較正は検出率が0%や100%に張り付くタスクを避けるためのもので、段階を上げたときに動くタスクかどうかまでは保証しません。差が確定できないのはタスク数の少なさだけが理由ではなく、そもそも段階で動かないタスクが混じっているためです。
- 測っていないもの: 実装・リファクタ・設計判断などバグ検出以外のタスク、claude-sonnet-5 以外のモデル、観点を指定するなどプロンプトを変えた場合、思考の量そのもの(出力トークンは思考と可視出力の合算で分離できません)。
- バグは人工的に仕込んだもので、実務のコードに現れるバグの分布とは異なりえます。
サンプル実装
同じ比較を自分のコードで回すための最小のハーネスです。TARGET_CODE と GOLD_LINES を差し替えれば、段階ごとの検出数・誤検出・出力トークン・所要秒・推定コストがそのまま並びます。プロンプト、モデル、許可したツール(読み取りのみ)、出力形式は本実験と同じで、変えるのは --effort だけです。上位のディレクトリにある設定ファイルを拾わせないよう、一時ディレクトリを作ってそこで実行しています。
"""effortの段階ごとに、バグ検出の当たり方を比べる最小ハーネス。"""
import json
import re
import shutil
import statistics
import subprocess
import tempfile
from pathlib import Path

MODEL = "claude-sonnet-5"
EFFORTS = ["low", "medium", "high", "xhigh", "max"]
REPS = 1  # 1段階あたりの実行回数。増やすと利用量も比例して増える
PROMPT = (
    "review_target.py を読み、バグのある行番号を答えてください。"
    "出力は JSON のみとし、説明文は書かないでください。"
    '形式: {"buggy_lines": [4, 16]}'
)

# レビューさせる対象。自分のコードに差し替えるときは GOLD_LINES も一緒に直す
TARGET_CODE = '''def binary_search(arr, target):
    lo, hi = 0, len(arr)
    while lo < hi:
        mid = (lo + hi) // 2
        if arr[mid] == target:
            return mid
        elif arr[mid] < target:
            lo = mid
        else:
            hi = mid
    return -1


def dedupe(items):
    seen = []
    out = []
    for it in items:
        if it not in seen:
            seen.append(it)
            out.append(it)
    return out


def merge_config(base, override):
    result = base
    for k, v in override.items():
        result[k] = v
    return result
'''
# 8行目: 更新がmid+1でなく無限ループ
# 15行目: seenをリストで持つため、18行目のin判定で計算量が二乗になる
# 25行目: 入力の辞書を書き換えるエイリアス
GOLD_LINES = {8, 15, 25}


def run_once(workdir, effort):
    """headlessで1回実行し、答えた行番号と使用量を取り出す。"""
    proc = subprocess.run(
        [
            "claude", "-p", PROMPT,
            "--model", MODEL,
            "--output-format", "json",
            "--max-turns", "15",
            "--permission-mode", "acceptEdits",
            "--allowedTools", "Read",
            "--setting-sources", "project",
            "--effort", effort,
        ],
        cwd=workdir, capture_output=True, text=True,
    )
    data = json.loads(proc.stdout)
    matched = re.search(r"\{.*?\}", data.get("result", ""), re.S)
    answer = set(json.loads(matched.group(0))["buggy_lines"]) if matched else set()
    usage = data.get("modelUsage", {}).get(MODEL, {})
    return {
        "hit": len(answer & GOLD_LINES),
        "fp": len(answer - GOLD_LINES),
        "out_tok": usage.get("outputTokens", 0),
        "sec": data.get("duration_ms", 0) / 1000,
        "cost": data.get("total_cost_usd", 0.0),
    }


def main():
    # 一時ディレクトリで実行する(上位ディレクトリの設定ファイルを読ませないため)
    workdir = Path(tempfile.mkdtemp(prefix="effort-bench-"))
    (workdir / "review_target.py").write_text(TARGET_CODE, encoding="utf-8")
    print("effort    検出   誤検出   出力tok      秒   推定コスト")
    try:
        for effort in EFFORTS:
            runs = [run_once(workdir, effort) for _ in range(REPS)]
            hit = statistics.mean(r["hit"] for r in runs)
            fp = statistics.mean(r["fp"] for r in runs)
            tok = statistics.median(r["out_tok"] for r in runs)
            sec = statistics.median(r["sec"] for r in runs)
            cost = sum(r["cost"] for r in runs)
            print(f"{effort:8s} {hit:.1f}/{len(GOLD_LINES)}   {fp:5.1f} "
                  f"{tok:8.0f} {sec:7.1f}  ${cost:.3f}")
    finally:
        shutil.rmtree(workdir)


if __name__ == "__main__":
main()埋め込んであるのは、本文で二分探索と呼んでいる課題そのものです。REPS = 1 なので5段階で5回の呼び出しが走ります。2026-07-26に手元で回したときの出力がこれです。
effort    検出   誤検出   出力tok      秒   推定コスト
low      2.0/3     0.0      135     5.4  $0.238
medium   2.0/3     0.0      517    11.6  $0.271
high     2.0/3     0.0      564    12.2  $0.274
xhigh    2.0/3     0.0      600    12.0  $0.259
max 2.0/3 0.0 3242 33.7 $0.286この5回では、検出が5段階とも3行のうち2行、誤検出が0件で動かず、動いたのは出力トークン(135から3,242)・所要秒(5.4から33.7)・推定コスト($0.238から$0.286)のほうでした。本実験でも二分探索は5段階すべて66.7%(3行のうち2行)で、dedupe の1行は5段階×3反復の15回すべてで指摘されていません。
ただし各段階1回ずつなので、この出力の個々の数値は結論として扱わないでください(本実験は1段階あたり24回です)。同じ日にもう一度走らせたときは、lowが132・maxが1,972でした。段階ごとの値は実行のたびに動きます。検出のほうは2回とも全段階で3行のうち2行のままでした。1回通すとCLIが返す推定コストは合計で約$1.33です。実行には claude -p を使えるClaude Code CLIの環境が要ります。
まとめ
結論をいちばん動かしたのは、effortの段階ではなく採点の置き方でした。当初はeffortを上げるほど誤検出が増えるように見えましたが、実際には原因の行を指した回答を誤りとして数えていたのです。行番号で評価するなら、原因行と症状行のどちらを正解に置くかを先に決める必要があります。
一方、段階を上げても拾えなかった7個は、二通りの採点規則でまったく同じ顔ぶれでした。平均の検出率より、採点方法の影響を受けにくい結果です。
実装やリファクタで段階が効くかは測っていないので、そこは別の話になります。モデルやCLIのメジャー更新があった際は、同じ8タスク・同じプロンプト・同じ採点規則で測り直します。同じ枠組みでAIコーディングの挙動を検証した記事はClaude Code活用術の実測検証にまとめています。