
「来月の需要はおよそ120です」と伝えるより、「9割がたは90から150の間に収まります」と幅を添えたほうが、受け取る側は動きやすくなります。在庫をどこまで積むか、人員を何人まで見込むか、判断の材料が増えるからです。
ただ、その「9割がた」は誰が保証しているのでしょうか。9割ぶんの幅を出すようモデルへ指定はできますが、指定どおりに当たっているかどうかは、実際のデータで数えるまで分かりません。
真の分布が分かっている合成データで数えてみたところ、90%と名乗って作った区間が真値を含んだ割合は、8割強にとどまりました。
先に結論: 当たらない分は、幅を広げて買い戻す
- 下側5%と上側95%のモデルを2本引いて作った90%予測区間は、真値を含んだ割合が0.8240〜0.8256。名乗りより約7.5ポイント不足
- CQR(学習に使っていない較正データで区間を広げ直す補正)を入れると0.8987〜0.9030まで回復。ただし平均幅は約18〜20%増加
- 当たるようになったのは区間を広げたためで、予測そのものが良くなったわけではない
- 全体が約90%へ戻っても、ばらつきが場所によって変わる条件では領域ごとの割合が0.877〜0.945に散る
- 測ったのは、合成データ12,000件・シード5本・LightGBM・名目90%区間という1構成
この記事の前提知識
比べるのは、区間の作り方2通りです。下側5%と上側95%を狙う分位点モデルを2本学習し、その予測をそのまま下限と上限にするのが素朴なやり方。もう一つは、そこへCQRの補正を足したものです。下側5%と上側95%を指定した時点で、モデルが狙う割合は90%になります。これが名乗りの側で、記事では名目90%と書きます。
採点の側には、分位点回帰の経験だけでは埋まらない言葉が3つあります。
- 実カバレッジ: 未知の検証データで、真値が下限と上限の間に入った割合。この記事の主役
- 較正データ: 学習にも最終評価にも使わない取り分。CQRの補正量はここだけで決める
- 領域別カバレッジ: 1列目の特徴量で検証データを5分割し、領域ごとに数えた実カバレッジ
区間を広げるだけでも実カバレッジは上がるので、上限と下限の差の平均、つまり平均幅も同時に記録します。
CQR(コンフォーマル化分位点回帰)では、較正データを分位点モデルへ通し、真値が区間からどれだけはみ出したかを測ります。そのはみ出し量の分位点を補正量として、下限から引き、上限へ加えます。モデルを学習し直すのではなく、出力済みの区間を必要な分だけ広げる仕組みです。
Conformalized Quantile Regressionで示された保証は、較正データと検証データが同じ分布から得られることを前提としています。保証の対象は全体としてのカバレッジで、入力領域ごとに同じ割合になるとは限りません。分布が変わる運用や領域別の精度は、この保証とは分けて確かめる必要があります。
なお、同じ分位点回帰を区間ではなく高い水準を狙う点予測として使ったときの改善と悪化は、稀な高値の回帰を8条件で比べた検証で測っています。
ばらつきの異なる2条件を、12,000件×5シードで数えた
真の分布が分かる合成データを2種類用意しました。どの入力領域でもノイズの大きさが一定の条件と、1列目の特徴量が大きくなるほどノイズが増える条件です。後者では、必要な区間幅が場所によって変わります。
条件ごとに12,000件を生成し、学習50%・較正25%・検証25%に分けて、5シードの平均を集計しています。素朴な2本引きとCQRについて測ったのは、実カバレッジ、平均幅、上下限の交差率、領域別カバレッジの4つです。データの生成式とLightGBMの設定は記事の後半にあります。
実測前の見立ては2つありました。素朴な2本引きは名目90%に届かないだろうということ、そして上限の予測が下限を下回る「交差」も起きるだろうということです。前者は当たり、後者は1件も観測されませんでした。
2本引いただけの区間は、名目90%に届かなかった
下側5%と上側95%のモデルを別々に学習し、その予測をそのまま区間にすると、名乗った割合には届きませんでした。区間の外に出る件数が、想定より多く出ます。
そのため、90%区間として報告する前に、独立した検証データで実カバレッジを数える工程が要ります。
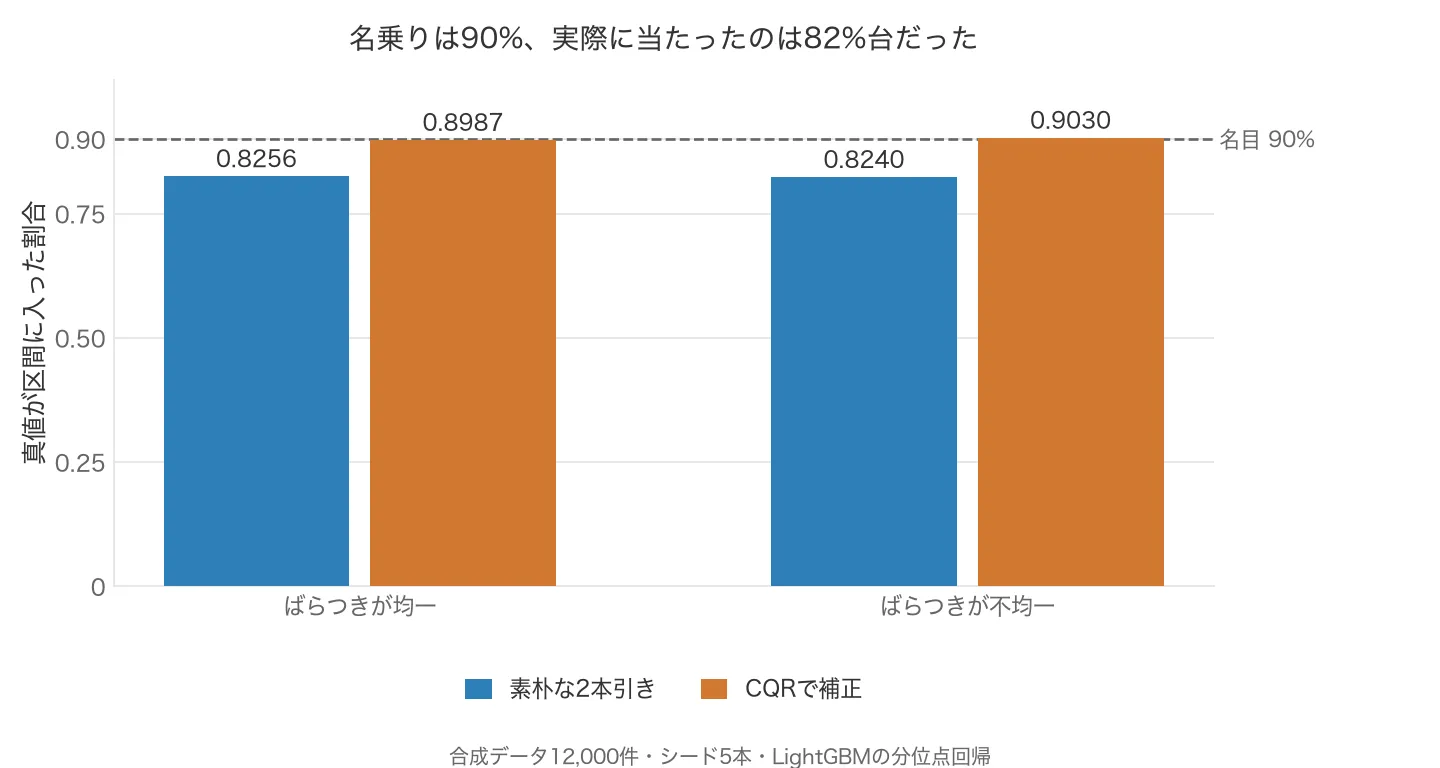
右2列の「領域最小」「領域最大」は、5分割した領域ごとの実カバレッジのうち、シードごとに最も低い値と最も高い値を取り、5シードで平均したものです。
| ばらつき | 方法 | 実カバレッジ | 平均幅 | 交差率 | 領域最小 | 領域最大 |
|---|---|---|---|---|---|---|
| 均一 | 素朴な2本引き | 0.8256 | 2.8496 | 0.0 | 0.8043 | 0.8540 |
| 均一 | CQR | 0.8987 | 3.4242 | 0.0 | 0.8793 | 0.9184 |
| 不均一 | 素朴な2本引き | 0.8240 | 3.4116 | 0.0 | 0.7893 | 0.8543 |
| 不均一 | CQR | 0.9030 | 4.0208 | 0.0 | 0.8733 | 0.9453 |
補正前の実カバレッジは、均一な条件で0.8256、不均一な条件で0.8240でした。どちらも名目0.90を約7.5ポイント下回っています。区間外に出た割合へ直すと約17.5%で、10件に1件が外れるつもりで運用していると、実際にはその1.75倍が外れている計算になります。
ばらつきの条件を変えても補正前の値はほぼ同じでした。ただしこの一致から、カバレッジ不足の原因を分位点回帰そのものに求めることはできません。学習データ上でのカバレッジや、木の本数・学習率を変えたときの挙動は測っておらず、ここで確認できたのは未知データ上の不足までです。
CQRは名目へ戻したが、代わりに区間が広がった
CQR後の実カバレッジは0.8987と0.9030で、名目0.90の近くまで戻りました。ばらつきが一定かどうかにかかわらず、補正は効いています。
ただ、名目に近づいたことだけでは補正の良し悪しを決められません。CQRは予測モデルを学習し直すのではなく、較正データで測った不足分を区間へ足す手法です。改善は幅を差し出して買っています。
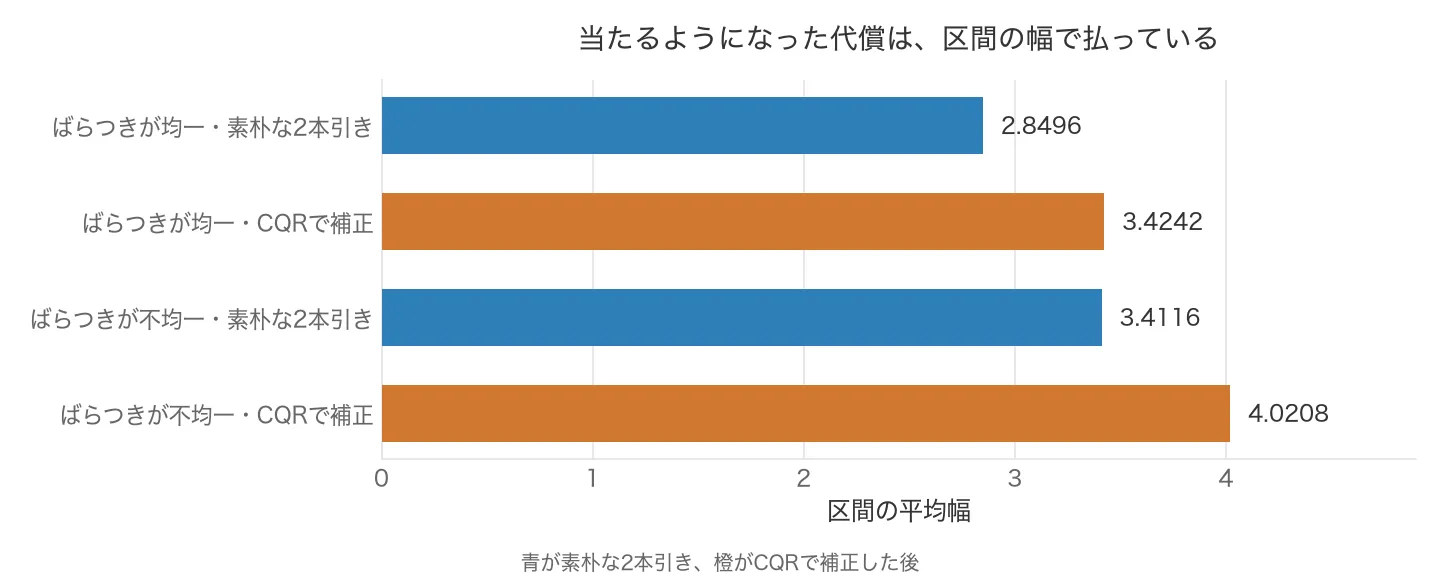
平均幅は、均一な条件で2.8496から3.4242へ20.2%、不均一な条件で3.4116から4.0208へ17.9%広がりました。区間が広いほど使いにくい用途では、この増分が採否を決めます。補正前後を比べるときは実カバレッジだけを取り出さず、平均幅の変化まで並べて評価します。
全体で当たっていても、場所によっては外れていた
全体の実カバレッジが名目へ戻っても、入力領域ごとに同じ割合で当たっているとは限りません。ノイズの大きさが場所によって変わる条件では、実際に偏りが残りました。領域別の精度が要る用途では、全体の1つの数字だけを採用の根拠にできません。
読み方に注意が要るのは、5つの領域から最小値を選ぶという操作そのものです。各領域が本当に90%当たっていても、5個のうち最も低い値は0.90を下回ります。最小値が0.90を割ったという事実だけでは、領域差の証拠になりません。
そこで、同じ件数構成で各領域が独立に0.90となる場合をシミュレーションし、比較のための基準線を用意しました。最小値は0.8790〜0.8917、最大値は0.9083〜0.9200が中央90%の範囲です。作り方は「詳しい検証条件」に書きました。
| ばらつき | 方法 | 領域最小 | 領域最大 | 基準線から外れているか |
|---|---|---|---|---|
| 均一 | 素朴な2本引き | 0.8043 | 0.8540 | 両方とも大きく下(全体が不足) |
| 均一 | CQR | 0.8793 | 0.9184 | どちらも範囲内(最小は下端 0.8790 のすぐ上) |
| 不均一 | 素朴な2本引き | 0.7893 | 0.8543 | 両方とも大きく下(全体が不足) |
| 不均一 | CQR | 0.8733 | 0.9453 | 最小は下端を下回り、最大は上端を大きく超える |
最小値と最大値だけでは形が見えないので、CQR後の領域ごとの平均カバレッジも並べます。1列目の特徴量が小さい順で、いずれも5シードの平均です。
| ばらつき | 領域1 | 領域2 | 領域3 | 領域4 | 領域5 |
|---|---|---|---|---|---|
| 均一 × CQR | 0.8950 | 0.8927 | 0.9007 | 0.9080 | 0.8973 |
| 不均一 × CQR | 0.9453 | 0.9020 | 0.8973 | 0.8933 | 0.8770 |
均一な条件はほぼ平らで、傾きも読み取れません。なお、上の判定表の領域最小0.8793は、シードごとに最小値を取ってから平均した値です。この表の最小である0.8927とは取り方が違うため、両者を直接は突き合わせられません。0.8793は基準線の下端0.8790のすぐ上にあり、読み取れるのは、この設計で領域差を検出できなかったところまでです。差がないことの証明ではありません。
不均一な条件は様子が違いました。ノイズが大きくなる方向へ、領域ごとの値が単調に下がっています。判定表の領域最大0.9453は基準線の上端0.9200を超え、領域最小0.8733は下端0.8790を下回りました。加えて5シードすべてで、ノイズが最も小さい領域が5領域中の最大値でした。
CQRで上下へ同じ量を加える方式では、もともとのばらつきが小さい領域で区間が広めになり、大きい領域では不足します。今回も、全体の実カバレッジは0.9030まで戻った一方、領域別の内訳は0.877〜0.945に散りました。
起きると見ていた分位点の交差は、1件も出なかった
分位点モデルを2本別々に学習すると、上限の予測が下限を下回る交差が起こる場合があります。見立てのうちこちらは外れ、実測では4条件すべてが交差率0.0でした。
とはいえ、1条件12,000件で真の関数も滑らかな設定です。どの要因が交差を抑えたかまでは切り分けていないので、言えるのは今回の設計で交差が観測されなかったというところまでになります。
手元の区間を採点する順番
- 学習・較正・検証の3つにデータを分ける
- 補正前の区間について、実カバレッジと平均幅を測る
- 較正データでCQRの補正量を決め、検証データで再評価する
- 全体だけでなく、重要な特徴量や領域ごとのカバレッジも確認する
- 領域別の最小値・最大値は、サンプル数だけで生じるばらつきの基準線と比較する
CQRには、学習にも最終評価にも使わない較正データが必要です。学習データを較正へ流用する構成は今回の比較に含めていません。3分割が難しくCQRを適用できない場合でも、手元の検証データで補正前の実カバレッジを数えておけば、少なくとも名目値との差は把握できます。
名目の水準と実際の当たり方がずれるのは、回帰の区間に限りません。モデル採点の平均へ信頼区間を付けた検証では、2万件から作った95%信頼区間の幅が±0.013まで狭まる一方、4,000回とも真値を外しました。また、較正データを学習や最終評価へ流用すると評価自体が甘くなります。評価側の情報が学習側の処理から見えているときの動き方は、データリーク5パターンを測った検証にまとめています。
詳しい検証条件
データ・分割・学習設定
合成データは、平均に1列目の特徴量を非線形、2列目を線形に効かせて作りました。残る3列目は結果と無関係に設定し、正規分布のノイズを加えています。ノイズは、どの入力領域でも大きさが一定の条件に加え、1列目の特徴量が大きくなるほど増える条件を用意しました。
データは学習50%、較正25%、検証25%に分け、CQRの補正量には較正データだけを使いました。較正と検証が同じデータでは、自分で合わせた区間を同じデータで採点することになるため、実カバレッジは独立した検証データから求めています。
LightGBMの分位点回帰は木300本・学習率0.05とし、早期打ち切りや正則化は調整していません。比較する2手法の学習条件をそろえるため、どちらも同じ6,000件から下側5%と上側95%のモデルを作りました。記事中の数値は、ばらつき2種、5シード、2手法の計20回を実行したログから集計しています。
基準線の作り方
判定の基準は、1領域600件、5領域、5シードという同じ件数構成で、各領域のカバレッジが独立に0.90となる場合を20万回シミュレーションして作りました。最小値は平均0.8856で中央90%が0.8790〜0.8917に入り、最大値は平均0.9140で中央90%が0.9083〜0.9200に収まっています。
この基準線が表しているのは検証件数から生じる数え上げのばらつきだけです。モデルの学習や較正に伴う変動は含まれておらず、本来のばらつきより狭い範囲になります。
適用範囲と限界
- 実測したのは合成データとLightGBMの分位点回帰で、木300本・学習率0.05、名目90%という1設定に限られます。実データやほかの学習器、99%など別の水準へ移れば、7.5ポイントという不足量は変わり得ます
- カバレッジ不足の原因は切り分けていません。学習データ上でのカバレッジや、木の本数・学習率を変えたときの挙動は未測定です
- 交差率0.0は、今回の条件で起きなかったという観測値にとどまります。交差が起きないことを示した結果ではありません
- CQRの保証には、較正データと検証データが同じ分布から得られるという前提があります。時間とともに入力や目的変数の分布が変わる状況は今回の対象外です
- 補正方法は、上下へ同じ量を加える単純なCQRだけを試しました。分位ごとに非対称へ広げる変種は比較していません
- 領域別の確認は1列目の特徴量による5分割に限られ、ほかの特徴量や分割方法は未測定です
- 判定に使った基準線は、各領域が独立に0.90で当たると仮定した数え上げのシミュレーションであって、領域間の差を検定したものではありません。モデルの学習や較正による変動を含まないぶん実際より狭く、基準線から外れやすい側に出ます
手元のデータで同じ表を出すコード
次のコードでは、LightGBMの分位点モデル2本で作る区間とCQRで補正した区間を同じデータで比較し、実カバレッジ、平均幅、領域別の最小値と最大値を出力します(出力の列名はビン最小・ビン最大です)。補正量を決めたデータで同じ区間を評価しないよう、学習・較正・検証の3分割は崩さないでください。
"""分位点回帰で引いた「90%区間」は、本当に90%当たるのか。

素朴なやり方(下側5%と上側95%の分位点モデルを2本引く)と、
CQR(較正データで区間を過不足なく広げ直す)を比べる。
真の分布が分かっている合成データなので、実際に当たった割合を直接数えられる。
実行: python sample_cqr.py (所要 1 分程度)
"""

import numpy as np
import pandas as pd
from lightgbm import LGBMRegressor
from sklearn.model_selection import train_test_split

N, ALPHA, N_BINS = 12_000, 0.10, 5  # ALPHA=0.10 → 名目 90% 区間
SEEDS = [0, 1, 2, 3, 4]


def make_data(kind, seed):
    rng = np.random.default_rng(seed)
    x = rng.uniform(-3, 3, size=(N, 3))
    mean = 2.0 * np.sin(x[:, 0]) + 0.8 * x[:, 1]
    # heteroscedastic は x0 が大きいほどばらつきが増える
    sd = np.full(N, 1.0) if kind == "均一" else 0.3 + 0.9 * (x[:, 0] + 3) / 6 * 2.0
    return pd.DataFrame(x, columns=["x0", "x1", "x2"]), mean + sd * rng.normal(size=N)


def score(y, lo, hi, x0):
    inside = (y >= lo) & (y <= hi)
    # x0 のビンごとのカバレッジ(全体で当たっていても場所で外れることがある)
    bins = pd.qcut(x0, N_BINS, labels=False, duplicates="drop")
    per_bin = [inside[bins == b].mean() for b in range(N_BINS)]
    return {
        "カバレッジ": inside.mean(),
        "平均幅": np.mean(hi - lo),
        "ビン最小": np.min(per_bin),
        "ビン最大": np.max(per_bin),
    }


rows = []
for kind in ["均一", "不均一"]:
    for seed in SEEDS:
        X, y = make_data(kind, seed)
        # 学習 / 較正 / 検証 に3分割する(較正データで測って同じデータで採点しない)
        Xtr, Xr, ytr, yr = train_test_split(X, y, test_size=0.5, random_state=seed)
        Xcal, Xte, ycal, yte = train_test_split(Xr, yr, test_size=0.5, random_state=seed)

        def q_model(a):
            return LGBMRegressor(
                objective="quantile", alpha=a, n_estimators=300, learning_rate=0.05,
                verbose=-1, random_state=seed, n_jobs=1,
            ).fit(Xtr, ytr)

        lo_m, hi_m = q_model(ALPHA / 2), q_model(1 - ALPHA / 2)
        lo_te, hi_te = lo_m.predict(Xte), hi_m.predict(Xte)
        rows.append({"ばらつき": kind, "方法": "素朴な2本引き",
                     **score(yte, lo_te, hi_te, Xte["x0"].to_numpy())})

        # CQR: 較正データでの「はみ出し量」の分位点だけ、上下に広げる
        s = np.maximum(lo_m.predict(Xcal) - ycal, ycal - hi_m.predict(Xcal))
        q_level = min(1.0, np.ceil((len(s) + 1) * (1 - ALPHA)) / len(s))
        q = float(np.quantile(s, q_level, method="higher"))
        rows.append({"ばらつき": kind, "方法": "CQR",
                     **score(yte, lo_te - q, hi_te + q, Xte["x0"].to_numpy())})

out = pd.DataFrame(rows).groupby(["ばらつき", "方法"], sort=False).mean().round(4)
print(f"名目カバレッジ {1 - ALPHA} / シード{len(SEEDS)}本の平均")
print(out.to_string())はみ出し量の分位点には、単純な90パーセンタイルよりわずかに高い、np.ceil((n + 1) * (1 - ALPHA)) / nで求めた水準を使っています。これは有限標本で名目カバレッジを保証するための補正で、根拠は前掲のCQRの論文にあります。ただし今回試したのは較正データ3,000件の1条件だけで、補正を外した場合との比較は行っていません。
予測区間は、カバレッジと幅をセットで確認する
LightGBMへ5%と95%を指定しただけでは、その区間が未知データで90%を捉えるかどうかは決まりません。報告に幅を添えるなら、独立した検証データで実カバレッジを数えるところから始めます。名目値を下回った場合はCQRが補正候補になりますが、その採否は、補正後の平均幅が用途に対して広すぎないかまで見て決めます。
全体の値が名目に合っていても、入力領域ごとの不足は残ります。今回も基準線を置いたことで、均一な条件では差を検出できず、不均一な条件では基準線を外れたという区別ができました。手元のモデルで同じ確認を始めるなら、補正前後のカバレッジ、平均幅、領域ごとの最小と最大を1つの表へ並べるところからです。