
問い合わせ対応の品質を、毎月の平均スコアで追っているとします。1件ずつ担当者が読み、「回答は正確だったか」「問題を解決できたか」を採点するのが理想です。しかし、問い合わせが2万件を超えると、全件を人が読むのは現実的ではありません。
そこで、一部だけを人が採点し、残りをモデルに任せます。件数は20倍。それを平均すれば、集計はより精密になりそうに見えます。実際、モデル採点2万件から作った95%信頼区間は、人手評価1,000件から作った区間よりはっきり狭くなります。
狭い区間は、しっかり測れたしるしのように見えます。ところが今回の実測では、いちばん狭い区間を出したやり方が、4,000回の試行すべてで真の平均を外しました。
先に結論: 危ないのは予測の粗さではなく、平均の偏り
- モデル採点をそのまま平均すると、予測の平均が 0.10 偏っただけで、2万件から作った95%信頼区間は4,000回とも真値の外側
- 崩したのは1件ごとの予測誤差ではなく、平均の偏り。1件ごとの誤差を大きくした予測器のほうは、区間が壊れなかった
- 人手評価を増やしても「そのまま平均」は直らない。人手評価は、偏りを測る側へ回して初めて効く
- PPI(少数の人手評価で予測の偏りを補正する手続き)なら、人手評価だけを使う場合より区間が狭い。狭くなる幅は傾き0.95の予測器で約28%、粗い傾き0.50では約21%
- 名目95%を保てたのは人手評価200件以上。50件では名目をやや下回る条件があり、この規模で保てるとは言い切れない
- 適用条件: 真の平均が0と分かる合成データ、モデル役は一次式、人手評価50件・200件・1,000件、モデル採点20,000件、各条件4,000回の反復。推定対象は母平均のみ
この記事の前提と、手元にある3つの集計方法
前提にするのは、平均に95%信頼区間を付けて報告した経験があることだけです。区間の作り方そのものは説明せず、作った区間が当たったか外れたかを数えた結果で話を進めます。
想定する状況は次のとおりです。
- 人が採点した1,000件: 信頼できる正解スコアがある
- モデルだけが採点した20,000件: 件数は多いが、人の採点とはずれる可能性がある
- 知りたい値: この業務から発生する問い合わせ全体の平均品質スコア
統計の言葉では、最後の値を「母平均」と呼びます。この記事で主に採点するのは、各やり方が母平均を区間の中に捉えられたかどうかです。捉えたうえで、区間がどれだけ狭いかも併せて見ます。
件数の差を考えれば、20,000件のモデル採点を平均に使いたくなります。データが増えるほど偶然のばらつきは小さくなるので、区間も狭まります。
ただし、そこで残るのがモデルの採点の「甘い・辛い」という癖です。個々の問い合わせで起きるバラバラな採点ミスは、平均を取ると打ち消し合うことがあります。一方、モデルが全体を一貫して0.10点高く採点するなら、2万件を平均しても0.10のずれは残ったままです。
件数を増やして小さくなるのは、偶然のばらつきだけ。すると、間違った値を中心に、非常に狭い信頼区間ができることがあります。
手元のデータからは、3つの集計方法が考えられます。
| 集計方法 | 考え方 | 弱点 |
|---|---|---|
| 人手評価1,000件だけを使う | 信頼できるスコアだけで平均を推定する | モデル採点2万件の情報を捨てるため、区間が広い |
| モデル採点2万件だけを使う | 大量の採点から平均と区間を計算する | モデルの平均的なずれまで、そのまま残る |
| 両方を組み合わせる | モデル採点を土台にし、人手評価でずれを補正する | 人手評価の集め方など、前提を確認する必要がある |
3つめの方法を統計的な手続きにしたものが、PPI(Prediction-Powered Inference)です。まず20,000件のモデル採点から平均を出し、次に人手評価のある1,000件で「モデルが平均としてどれだけずれたか」を測ります。そのずれを、最初の平均に足し戻す仕組みです。
母平均を求める場合の計算は、次の形になります。
PPIの推定値 = モデル予測の平均 + 人手評価で測った「正解スコア − 予測」の平均
たとえばモデルが平均で0.10高く採点していれば、「正解スコア − 予測」の平均は約 -0.10 になります。モデル予測の平均に -0.10 を足すことで、採点の甘さを打ち消すわけです。
何を確かめたか
名前と式を眺めただけでは、そのまま集計するとどれだけ壊れ、補正するとどこまで戻るのかは分かりません。そこで真の平均が分かる合成データを使い、次の3点を測りました。
- モデル採点をそのまま平均すると、95%信頼区間はどれだけ真値を外すのか
- 原因は1件ごとの予測誤差なのか、モデル採点全体の平均的なずれなのか
- PPIは妥当性を保ちながら、人手評価だけの場合より区間を狭くできるのか
モデル役には実際のLLMではなく、性質を制御できる一次式を使いました。実験前に疑っていたのは、予測が粗いこと自体です。予測誤差が大きければ、そのぶん推定も不安定になるのではないか、と考えたためです。データの作り方と予測器の調整は「詳しい検証条件」にまとめました。
扱うのは母平均だけです。割合や回帰係数、人手評価の付き方が偏る場合までは検証していません。
2万件のモデル採点だけで作った区間は、4,000回とも外れた
真の平均が 0 と分かっているデータで、モデル採点だけの2万件から平均と95%信頼区間を作り、4,000回くり返しました。使ったのは、予測値の平均が正解値の平均より 0.10 高く出るモデルです。この「全体として甘い」偏りを、以下では平均バイアスと呼びます。
| 人手評価 | やり方 | 区間が真値を含んだ割合 | 区間の幅 | 推定値の偏り |
|---|---|---|---|---|
| 50 | 予測をそのまま集計 | 0.0000 | 0.0263 | 0.1003 |
| 1,000 | 予測をそのまま集計 | 0.0000 | 0.0263 | 0.1002 |
4,000回のうち、区間が真値を含んだ回数はゼロでした。 「有意差が出やすくなる」という程度の話ではなく、名目95%の区間として機能していません。
人手評価を50件から1,000件へ増やしても、値は 0.0000 のまま。そもそも人手評価を使わない集計なので、当然の結果です。裏を返すと、「サンプルが足りないなら増やす」という対処は、増やす対象を間違えると空振りします。後述する PPI では、人手評価の件数が結果に効いてきます。
狭い区間は、間違った値の周りにできていた
表の右2列に理由が出ています。
推定値は真値から平均 0.1002 ずれていました。モデルに入れた平均バイアス 0.10 とほぼ同じ値です。予測の平均が 0.10 高ければ、そこから作る推定値も同じ方向へずれます。
区間の幅は 0.0263、つまり中心から ±0.013 です。0.10 ずれているものを ±0.013 の幅で主張しているので、当たりようがありません。
区間の幅を決めるのは件数です。2万件もあれば標準誤差は小さくなります。一方、推定値のずれを決める平均バイアスは、件数と関係なく残ります。正解スコアではないモデル予測をいくら増やしても、系統的な偏りは消えません。
なお今回はモデル採点を2万件に固定しており、件数を変えた実測はしていません。理屈のうえでは、偏りが一定なら標準誤差だけが件数とともに縮むので、モデル採点を増やすほど真値を含みにくくなるはずです。
外から見て分かりにくいのは、3つのやり方を並べたとき、そのまま集計した区間が最も狭く出る点です。
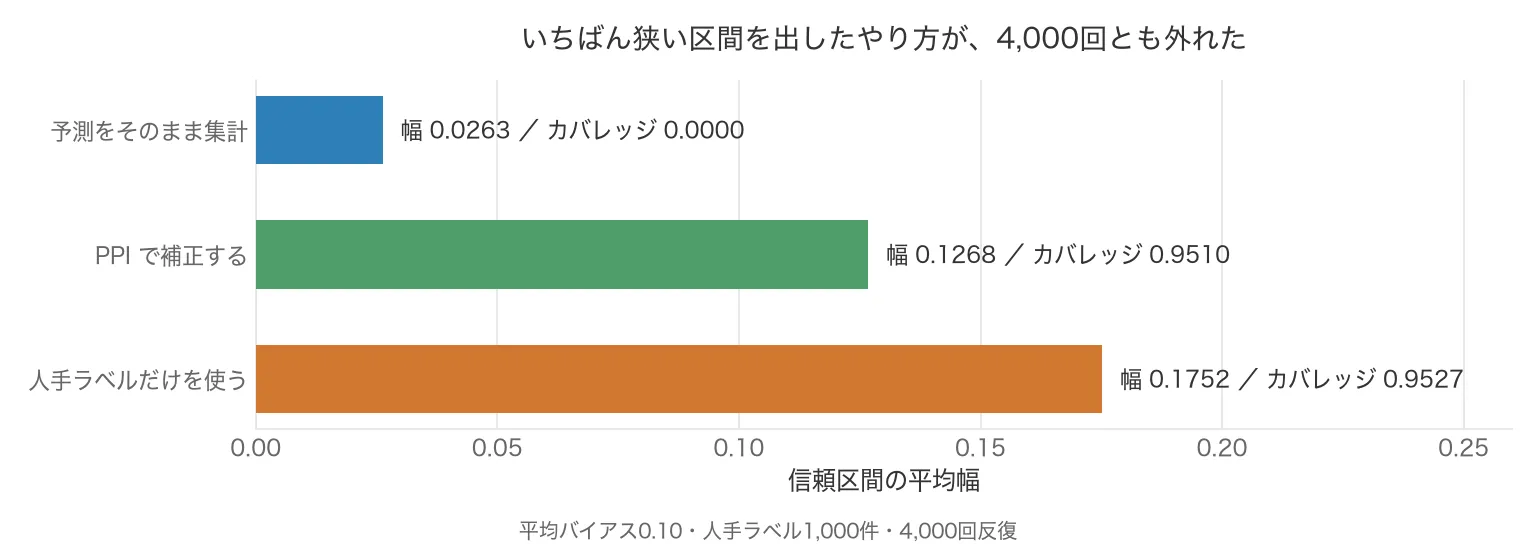
何も知らずに並べれば、いちばん精度が高そうに見えるのは最も狭い区間でしょう。見た目がいちばん自信ありげなものが、いちばん外れていました。
傾きを0.50へ縮めても区間は保たれ、偏りを入れたときだけ壊れた
平均バイアスを 0 にして、予測の縮み方を表す傾きだけを動かすと、様子が変わります。人手評価1,000件での成績です。
| 予測器 | やり方 | 区間が真値を含んだ割合 | 区間の幅 |
|---|---|---|---|
| 傾き0.95・バイアスなし | 予測をそのまま集計 | 0.9470 | 0.0263 |
| 傾き0.50・バイアスなし | 予測をそのまま集計 | 0.9495 | 0.0139 |
| 傾き0.95・バイアス0.10 | 予測をそのまま集計 | 0.0000 | 0.0263 |
バイアスがなければ 0.9470 と 0.9495 で、名目の 0.95 に近い値でした。傾きを 0.50 に縮め、1件ごとの予測誤差を大きくしても崩れません。実験前の予想とは逆に、この設計では予測の粗さより平均の偏りが効いていました。
実務へ持ち帰るなら、粗いモデルを警戒するより先に、予測の平均が一方向へずれていないかを見る、という順番になります。
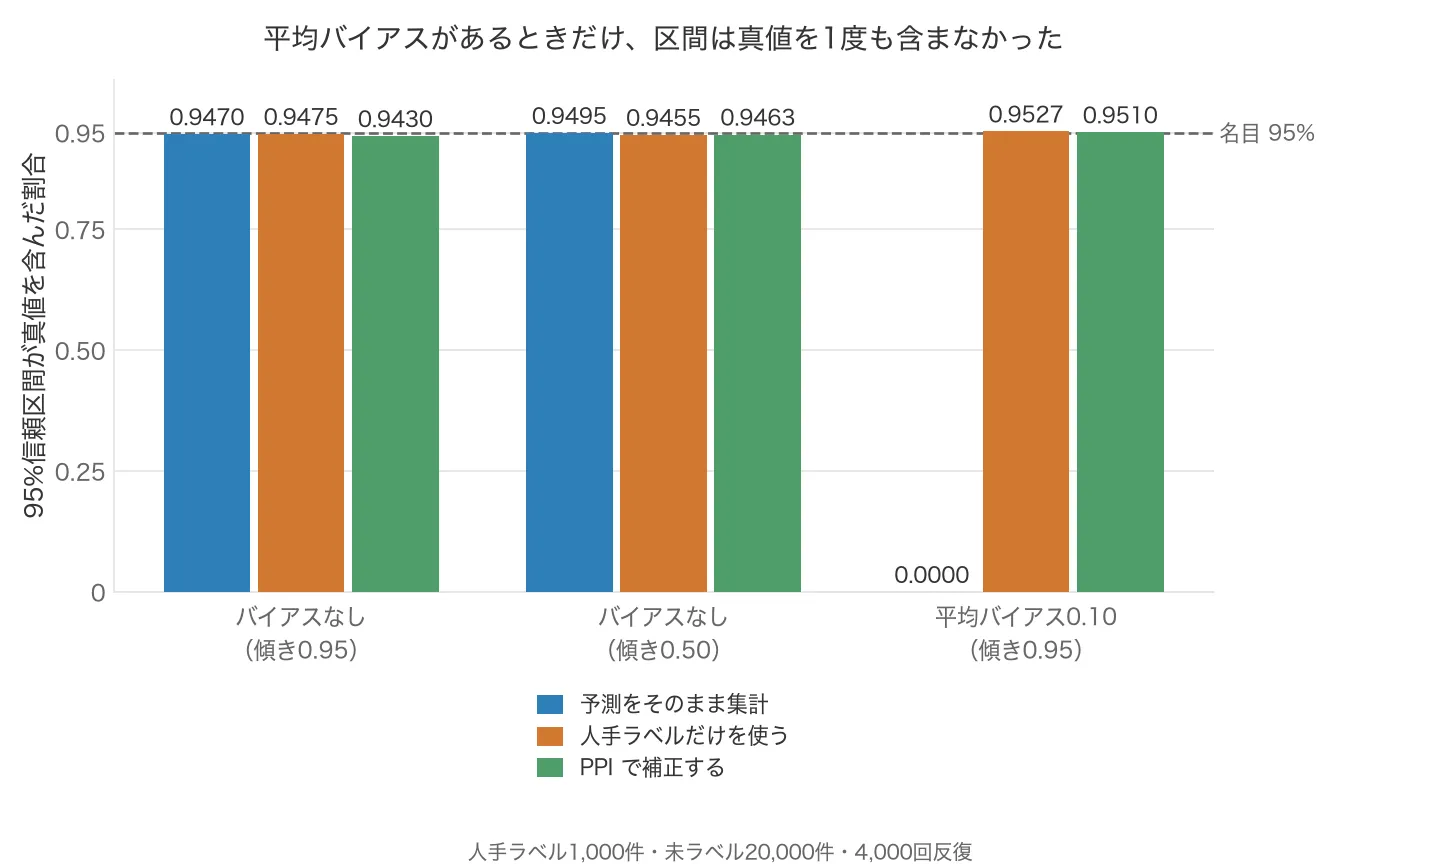
この結果は設計に依存します。f = a*X + b の平均は a*E[X] + b なので、X の平均を 0 にした今回は、傾き a を変えても予測の平均が動きません。母平均が 0 でない対象では傾きの縮みそれ自体が平均のずれを生みますが、その条件は測っていません。「精度の低いモデルでもそのまま集計してよい」とは読まないでください。 今回の設定で、壊れた原因を個々の予測誤差ではなく平均の偏り側へ切り分けられた、というところまでです。
PPIで補正すると、区間は名目どおりに戻った
偏りが原因なら、その大きさを測って差し引けばよいはずです。前提の節で式にした補正が、まさにこれに当たります。人手評価側の「正解スコア − 予測」の平均は、予測が平均で 0.10 高ければ約 -0.10 になり、モデル採点2万件の予測平均へ足すと相殺されます。
これが母平均を推定する場合の PPI で、Angelopoulos ら(Science 382巻, 2023年)が提案した枠組みにあたります。人手評価を捨てず、偏りを測るために使うのがポイントです。
同じ平均バイアス 0.10 の条件で比べます。
| 人手評価 | やり方 | 区間が真値を含んだ割合 | 区間の幅 | 推定値の偏り |
|---|---|---|---|---|
| 1,000 | 予測をそのまま集計 | 0.0000 | 0.0263 | 0.1002 |
| 1,000 | 人手評価だけを使う | 0.9527 | 0.1752 | -0.0003 |
| 1,000 | PPI で補正する | 0.9510 | 0.1268 | -0.0002 |
そのまま集計すると 0.10 ほどずれていた同じデータで、PPI の推定値の偏りは -0.0002。区間が真値を含んだ割合も 0.9510 で、名目どおりに戻りました。補正に使う人手評価は1,000件のままで、追加の採点は要りません。
人手評価だけを使うより、区間は約28%狭い
偏りを消すだけなら、人手評価だけを使う方法(上の表の2行目)でも足ります。PPI の利点が表れるのは、区間の幅です。
同じ人手評価1,000件で、人手評価だけなら区間幅は 0.1752、PPI では 0.1268。約28%狭い区間を、名目95%を保ったまま得ています。 傾き0.50 の粗い予測器でも 0.1752 から 0.1392 へ、約21%狭くなりました。予測が粗いほど、狭くできる幅は小さくなるという関係です。
同じ人手評価の件数で区間を狭くできるので、人手評価を「補正へ回す」判断は、採点コストを増やさずに効きます。
気になったのは、人手評価50件での挙動です。バイアスなし・傾き0.95の条件では、区間が真値を含んだ割合は 0.9365。名目の 0.95 をやや下回りました。他の3予測器は 0.9435〜0.9460 で、人手評価だけを使う場合の 0.9427〜0.9493 と同程度です。人手評価を200件または1,000件に増やすと、0.9430〜0.9510 に収まりました。
下振れが出たのは4条件のうち1つだけです。人手評価50件で一般に起きるのか、正規近似や有限標本による揺れなのかは、この実験では切り分けていません。この規模で名目95%を満たすとは言い切れない、というところで止めておきます。
実務では、モデルの平均的なずれを先に測る
モデルの採点をそのまま集計しているなら、まず人手評価のある一部で「正解スコア − 予測」の平均、つまり平均残差を見ます。標本の平均残差は、偶然でも 0 からずれます。大きさと一緒に不確実性も確認したうえで、実務上無視できない偏りが疑われるなら、モデル予測だけの平均をそのまま母平均として報告しない、という判断になります。
無視できるかどうかの目安は、報告しようとしている区間の幅との並べ比べです。今回の条件なら、幅は中心から ±0.013、平均残差は 0.10。桁がひとつ違いました。この関係になっているなら、区間の狭さは判断材料になりません。
今回、実務上もっとも重要だったのは、精度指標だけでは判断できない点です。RMSEや決定係数が良くても、平均の偏りが小さい保証はありません。実際、1件ごとの誤差を大きくした予測器(傾き0.50)は崩れず、平均が偏った予測器だけが崩れました。
人手評価があるなら、捨てずに補正へ回す方法を検討する価値はあります。今回の条件では PPI がその候補になり、人手評価200件と1,000件で、区間が真値を含んだ割合は 0.9430〜0.9510 でした。
名目の水準と実際に真値を含む割合がずれる現象は、回帰の予測区間でも起きます。LightGBMの分位点回帰で90%予測区間を作った検証では、90%と名乗った区間が実際に真値を含んだ割合が、補正前は82%台にとどまりました。
名目が崩れる経路はもう一つあります。A/Bテストを途中で覗く運用を測った検証では、有意になったら止める運用で50回覗くと、真の差がゼロでも31.7%が「差がある」側に落ちました。こちらを崩すのは予測の偏りではなく、見る回数です。
当てはまるのは今回測った範囲までです。人手評価50件については上に書いたとおりで、付き方が偏っている場合・母平均以外の推定量・実際のLLMや学習済みモデルは測っていません。
詳しい検証条件
粗さと偏りは、実際の学習済みモデルでは絡み合っています。精度を落とせば両方が同時に動くので、どちらが効いたのか特定できません。そこで予測器を f(X) = a*X + b という一次式にして、2つを独立に動かせるようにしました。
a(傾き): 予測平均は変えずに、個々の予測の縮み方と誤差の大きさを変えるための係数。0.95 から 0.50 へ下げると予測が 0 付近へ縮み、1件単位の誤差が増えますb(平均バイアス): 予測値の平均を丸ごと押し上げます。今回は 0 と 0.10
データは Y = X + eps(X と eps はいずれも標準正規分布)で作ったので、真の母平均は 0 です。人手評価つきのデータを 50件・200件・1,000件、モデル採点だけのデータを 20,000件とし、この2つは同じ分布から独立に生成しています(2万件の中の一部を人が採点した、という設定ではありません)。それぞれの組み合わせを4,000回ずつ回しました。
採点は、区間が真値を含んだ割合(統計の用語ではカバレッジ。名目は 0.95)で行います。真値が分かっているので、外れたかどうかを直接数えられます。
記事中の数値は、乱数の種を 20260807 に固定して回した1回の実行結果です。予測器4種 × 人手評価3水準 × 手法5種の60通りを記録し、そこから抜き出しています。
指標の定義と、偽の有意率との関係
本文の「区間が真値を含んだ割合」は、統計の用語ではカバレッジです。名目は 0.95 で、これを大きく下回れば区間が嘘をついていることになります。
真値を帰無仮説にした検定の棄却率(偽の有意率、名目 0.05)も記録していますが、本文では追いません。棄却の判定は区間と同じ幅から出しているので、偽の有意率は定義上つねに 1 − カバレッジになるためです。別々の証拠ではなく、同じ事実を有意判定の言葉で言い直したものです。予測をそのまま集計した条件では、カバレッジ 0.0000 の裏返しとして偽の有意率が 1.0000 になっています。
区間はすべて正規分布の分位点 1.96 で作っており、t 分位点は使っていません。
PPI++ の lambda を丸める流儀の影響
PPI には補正の強さを lambda という係数で調整する拡張(PPI++)があります。分散が最小になる lambda は理論上 1 を超えることがあるので、超えた値をそのまま使う版と、[0,1] に丸める版の両方を実装して比べました。
この設定では、分散最小の lambda の推定値(4,000回の平均)は傾き 0.95 の予測器で 1.0022〜1.0517、傾き 0.50 では 1.9035〜1.9965 でした。丸めの有無によるカバレッジの差は前者で 0.0026 以内でしたが、後者・ラベル1,000件では 0.0072(0.9535 対 0.9463)、区間幅は 0.1268 対 0.1392 まで開きました。lambda が 1 の近くにある設定なら丸めはほぼ効きませんが、1 から離れる設定では丸めたほうが区間が広くなります。
適用範囲と限界
- 推定対象は母平均だけです。割合・回帰係数・分位点など他の推定量では検証していません(分位点や回帰係数は原論文が扱っているので、母平均から先へ進むならそこが出発点になります)
- 母平均が 0 の設計です。予測の平均は
a*E[X] + bで、Xの平均を 0 にした今回は傾きaを変えても動きません。平均が 0 でない対象では傾きの縮みそれ自体が平均のずれになりますが、その条件は測っていません - 予測と正解の相関は4種類とも同じです。動かしたのは予測の縮み方(傾き 0.95 と 0.50)と平均バイアスだけで、相関の弱い予測器で PPI の区間が狭くなるかは確かめていません
- 予測器は解析的な一次式で、実際の学習済みモデルではありません。 予測誤差が入力によって変わる場合や、人手評価つきのデータとモデル採点だけのデータで分布がずれる場合は測っていません。実際の言語モデルによる採点は、この設定より複雑な壊れ方をしうると考えられます
- 人手評価つきの標本は無作為抽出です。「評価しやすいデータにだけ人手評価が付いている」という実務でよくある偏りは未検証で、この偏りがあると PPI の前提も崩れます
- 正規分布に基づく信頼区間のみです。ブートストラップなどは比較していません
- 区間が真値を含んだ割合 0.0000 は、平均バイアス 0.10・モデル採点20,000件という組み合わせでの値です。振ったのはバイアス 0 と 0.10 の2水準、モデル採点数は 20,000件の1水準だけなので、偏りがもっと小さい場合や件数が少ない場合にどこまで壊れるかは測っていません
- ここでの 0.10 は単位のない合成スコア上の値です。 実務上どの程度の偏りに相当するかは、スコアの尺度によって変わります
サンプル実装
このコードは本文の表と同じ値を出します。 予測器4種と人手評価3水準を、本実験と同じ順序・同じ乱数列で回しているためです。numpy と pandas だけで動き、所要は約1分。
"""予測でラベルを埋めて母平均を推定すると、信頼区間はどこで壊れるか。

正解ラベルが n 件しか無く、残り N 件にはモデルの予測しか無い状況を作る。
真の母平均は 0 と分かっているので、区間が真値を含む割合を直接採点できる。
実行: python sample_ppi.py (numpy と pandas だけ。所要 約1分)
"""

import numpy as np
import pandas as pd

TRUE_MEAN = 0.0
N_UNLABELED = 20_000
N_LABELED = [50, 200, 1000]
N_REP = 4_000
Z = 1.959963985
SEED = 20260807

# 予測器 f(X) = a*X + b の性質
#   a: 個々の予測の縮み方(小さいほど予測は粗い)
#   b: 予測平均の系統的なずれ(平均バイアス)
PREDICTORS = {
    "傾き0.95・バイアスなし": (0.95, 0.0),
    "傾き0.95・バイアス0.10": (0.95, 0.10),
    "傾き0.50・バイアスなし": (0.50, 0.0),
    "傾き0.50・バイアス0.10": (0.50, 0.10),
}


def one_rep(rng, n_lab, a, b):
    """1回の試行。3つのやり方それぞれの (推定値, 標準誤差) を返す。"""
    # 真の生成過程: Y = X + eps → 母平均は 0
    x_lab = rng.normal(size=n_lab)
    y_lab = x_lab + rng.normal(size=n_lab)
    f_lab = a * x_lab + b                    # ラベルのある側の予測
    f_unl = a * rng.normal(size=N_UNLABELED) + b  # 予測しか無い側

    # 予測をそのまま集計: 区間も N 件から作る
    naive = (f_unl.mean(), f_unl.std(ddof=1) / np.sqrt(N_UNLABELED))
    # 人手ラベルだけを使う: 予測は捨てる
    classical = (y_lab.mean(), y_lab.std(ddof=1) / np.sqrt(n_lab))
    # PPI: 予測平均を、ラベル側で測った「正解 − 予測」の平均で補正する
    resid = y_lab - f_lab
    ppi = (f_unl.mean() + resid.mean(),
           np.sqrt(f_unl.var(ddof=1) / N_UNLABELED + resid.var(ddof=1) / n_lab))
    return {"naive": naive, "classical": classical, "ppi": ppi}


rng = np.random.default_rng(SEED)
rows = []
for pname, (a, b) in PREDICTORS.items():
    for n_lab in N_LABELED:
        acc = {k: {"cover": 0, "width": 0.0, "bias": 0.0}
               for k in ("naive", "classical", "ppi")}
        for _ in range(N_REP):
            for k, (m, se) in one_rep(rng, n_lab, a, b).items():
                lo, hi = m - Z * se, m + Z * se
                acc[k]["cover"] += int(lo <= TRUE_MEAN <= hi)
                acc[k]["width"] += hi - lo
                acc[k]["bias"] += m - TRUE_MEAN
        for k, v in acc.items():
            rows.append({"予測器": pname, "ラベル数": n_lab, "手法": k,
                         "カバレッジ": round(v["cover"] / N_REP, 4),
                         "区間幅": round(v["width"] / N_REP, 4),
                         "偏り": round(v["bias"] / N_REP, 4)})

print(f"未ラベル{N_UNLABELED:,}件 / {N_REP}回反復 / 名目カバレッジ 0.95")
print(pd.DataFrame(rows).to_string(index=False))
実行結果(36行すべて)
未ラベル20,000件 / 4000回反復 / 名目カバレッジ 0.95
            予測器  ラベル数        手法  カバレッジ    区間幅      偏り
  傾き0.95・バイアスなし    50     naive 0.9545 0.0263  0.0000
  傾き0.95・バイアスなし    50 classical 0.9493 0.7809 -0.0012
  傾き0.95・バイアスなし    50       ppi 0.9365 0.5533  0.0005
  傾き0.95・バイアスなし   200     naive 0.9510 0.0263 -0.0001
  傾き0.95・バイアスなし   200 classical 0.9470 0.3916  0.0000
  傾き0.95・バイアスなし   200       ppi 0.9437 0.2785  0.0004
  傾き0.95・バイアスなし  1000     naive 0.9470 0.0263 -0.0000
  傾き0.95・バイアスなし  1000 classical 0.9475 0.1753  0.0010
  傾き0.95・バイアスなし  1000       ppi 0.9430 0.1269  0.0007
傾き0.95・バイアス0.10    50     naive 0.0000 0.0263  0.1003
傾き0.95・バイアス0.10    50 classical 0.9480 0.7776 -0.0008
傾き0.95・バイアス0.10    50       ppi 0.9450 0.5529 -0.0029
傾き0.95・バイアス0.10   200     naive 0.0000 0.0263  0.1001
傾き0.95・バイアス0.10   200 classical 0.9477 0.3914 -0.0018
傾き0.95・バイアス0.10   200       ppi 0.9475 0.2781 -0.0012
傾き0.95・バイアス0.10  1000     naive 0.0000 0.0263  0.1002
傾き0.95・バイアス0.10  1000 classical 0.9527 0.1752 -0.0003
傾き0.95・バイアス0.10  1000       ppi 0.9510 0.1268 -0.0002
  傾き0.50・バイアスなし    50     naive 0.9493 0.0139  0.0000
  傾き0.50・バイアスなし    50 classical 0.9427 0.7798 -0.0010
  傾き0.50・バイアスなし    50       ppi 0.9435 0.6172 -0.0027
  傾き0.50・バイアスなし   200     naive 0.9495 0.0139 -0.0001
  傾き0.50・バイアスなし   200 classical 0.9430 0.3916  0.0006
  傾き0.50・バイアスなし   200       ppi 0.9443 0.3098  0.0011
  傾き0.50・バイアスなし  1000     naive 0.9495 0.0139 -0.0001
  傾き0.50・バイアスなし  1000 classical 0.9455 0.1752 -0.0002
  傾き0.50・バイアスなし  1000       ppi 0.9463 0.1392  0.0001
傾き0.50・バイアス0.10    50     naive 0.0000 0.0139  0.1000
傾き0.50・バイアス0.10    50 classical 0.9453 0.7776 -0.0053
傾き0.50・バイアス0.10    50       ppi 0.9460 0.6144 -0.0046
傾き0.50・バイアス0.10   200     naive 0.0000 0.0139  0.0999
傾き0.50・バイアス0.10   200 classical 0.9505 0.3918  0.0000
傾き0.50・バイアス0.10   200       ppi 0.9470 0.3099 -0.0000
傾き0.50・バイアス0.10  1000     naive 0.0000 0.0139  0.1000
傾き0.50・バイアス0.10  1000 classical 0.9455 0.1753 -0.0004
傾き0.50・バイアス0.10  1000       ppi 0.9493 0.1393 -0.0005
classical と ppi の行が、バイアスの有無で同じ値になっている点に注目してください。 classical は予測を使わないので当然ですが、ppi が一致するのは偶然ではありません。前提の節で示した式のとおり、予測に b を足すと未ラベル側の予測平均が b だけ増え、ラベル側で測る「正解 − 予測」が b だけ減ります。式の中で打ち消し合うので、平均バイアスは結果に影響しません。 PPI の推定値の偏りが -0.0002 だったことの裏側がこれです。
まとめ
今回の合成データと一次式の予測器では、モデル採点をそのまま平均してよいかどうかを分けたのは、精度指標ではなく予測の平均の偏りでした。ただしこれは母平均を 0 にした設計での切り分けで、平均が 0 でない対象では予測の縮みそれ自体が偏りになりますし、実際の言語モデルによる採点は測っていません。人手評価が一部でもあるなら、その偏りを測る材料として使うことで、区間の狭さと妥当性を両立できる見込みがあります。
手元で試すときに先に確認したいのは、人手評価の集め方です。今回は人手評価つきの標本を無作為抽出しており、評価しやすいデータにだけ人手評価が付いている状況では、補正の前提そのものが崩れます。母平均から先、割合や回帰係数へ進む場合も、出発点は原論文になります。