
学習済みの分類モデルを本番で動かし始めると、次に気になるのが予測を返すまでの時間です。画面やAPIから1件ずつ予測する処理では応答の待ち時間が問題になり、定期的に大量のデータをまとめて処理する場合は、決められた時間内に何件終えられるかが課題になります。どちらも推論(学習済みモデルで予測を出す処理)の速度ですが、測る値も効く手当ても同じとは限りません。
速くしようとして、すぐに変換ツールを探す必要はありません。ループの中でLightGBM(表形式のデータでよく使われる勾配ブースティングのライブラリ)のpredictを1行ずつ呼んでいるなら、モデルが計算する時間だけでなく、呼び出しのたびに準備の時間がかかります。複数行を一度に渡せる処理なら、まず呼び出し回数を減らすだけで改善する余地があります。
その先の選択肢が、ONNX(学習済みモデルを共通形式へ変換し、onnxruntimeで実行する仕組み)とtreelite(木構造のモデルを予測向けに実行するライブラリ)です。どちらも再学習は要りませんが、変換処理と依存ライブラリが増え、元のLightGBMと予測値が一致するかも確認しなければなりません。しかも、1件の速さで有利な方法が大量処理でも有利とは限りません。
同じ学習済みモデルを、1行ずつ渡す方法、複数行をまとめる方法、ONNX、treeliteの4経路で動かしてみると、変換に手をつける前にできることが残っていました。途中でtreeliteのスレッド指定が1か所抜けているのに気づき、順位の解釈を一度撤回しています。
先に結論
- モデルを変換しなくても、numpy配列を1行ずつ渡す処理から一括処理へ変えるだけで13.7倍。LightGBMでは100件の時点で、18,000件一括の約9割の速さ
- treelite(木モデルをPythonから実行するGTIL経路)は、LightGBMとの順位が使い方で逆転。1件ずつなら4.7倍速く、18,000件の一括では0.45倍
- ONNXは1件ずつも一括も最速。LightGBM比でそれぞれ16.3倍と2.44倍。ただし変換後の確率には最大3.19e-07の差
- 8コアで一括処理を測り直しても、ONNX、LightGBM、treeliteの順序は不変。単発処理の並列条件は未検証
- 検証範囲は、Apple M1上の合成データ1件、20特徴・木300本のLightGBMモデル1つ。treeliteはGTIL経路のみで、Cへコンパイルする経路は未検証。主要な比較は全経路のスレッド数を1に固定
速度の数字は、1件の待ち時間と1秒あたりの件数に分かれる
この記事の表には、ミリ秒と「1秒あたりの行数」という2種類の数字が並びます。どちらを見るかで結論が変わるので、先に区別しておきます。
- 単発レイテンシは、1件を渡してから結果が返るまでの時間です。ミリ秒で測り、小さいほど待ち時間が短いと判断します。
- 一括スループットは、複数件をまとめて渡したとき、1秒間に処理できる行数です。値が大きいほど大量処理に向きます。
バッチ化(複数行を一度に渡す渡し方)はスループットを上げられます。ただし入力が1件ずつ届く処理では、指定した件数がたまるまで待つ時間も生じます。その待ち時間は今回測っていないため、リアルタイム処理では単発レイテンシ、すでに複数行がそろっている処理ではスループットを中心に読んでください。
もう1つ、入力の渡し方も結果に効きます。pandasのDataFrame(列名つきの表)のまま渡すか、numpy配列(数値だけを並べた配列)へ変換して渡すかで、速度が変わる可能性があるためです。バッチ化の効果と混ざらないよう、この違いも別々の条件として測りました。
同じ学習済みモデルを、4つの経路で動かした
特徴量20本・6万件の合成データを作り、7割を使って木300本のLightGBM二値分類モデルを学習しました。ここで比べるのは、同じ学習済みモデルから予測を返すまでの時間です。分類精度の優劣は検証対象に含めません。
| 経路 | 入力と実行方法 | 確認すること |
|---|---|---|
| LightGBM単発 | DataFrameまたはnumpy配列を1行ずつpredictへ渡す | 入力形式だけで速くなるか |
| LightGBM一括 | numpy配列を100・1,000・10,000・18,000件ずつ渡す | バッチ化の効果がどこで頭打ちになるか |
| treelite GTIL | 変換した木モデルをPythonから単発/一括で実行する | LightGBMとの順位が使い方で変わるか |
| ONNX Runtime | ONNXへ変換したモデルを単発/一括で実行する | 速度と予測確率の差 |
以降の表では、経路をlgb_numpy_rowのような名前で書きます。lgbがLightGBM、rowが1行ずつ渡す条件、batchが一括の条件です。
代表値の取り方は単発と一括で分けました。単発は300回測って中央値と95パーセンタイル(300回のうち95%がその時間以内に終わった値)を使い、一括は3回のうちの最小値を採ります。回数とウォームアップの取り方は記事末にあります。
主要な表では、全経路のスレッド数を1に固定しています。 同時に使うCPUの数がそろっていないと、ライブラリそのものの比較になりません。8コアを使う条件は、一括処理だけを別に測りました。
速度とあわせて、変換後も同じ予測を返すかを確認しました。基準はLightGBMへfloat64のnumpy配列を一括で渡したときの予測確率で、各経路との最大差を記録しています。
変換なしのバッチ化だけで、1秒あたりの処理件数の桁がひとつ動いた
ループの中で1行ずつpredictを呼ぶ形から、複数行をまとめて渡す形へ書き換えると、1秒あたりに処理できる行数が大きく増えました。追加のライブラリも変換作業も要りません。まとめて渡せる行があるなら、変換を検討する前にここを直すのが先です。
数値を見ていきます。まずは単発処理の、1行を渡してから結果が返るまでの時間です。
| 経路 | 中央値 (ms) | 95パーセンタイル (ms) |
|---|---|---|
lgb_df_row | 0.2408 | 0.2702 |
lgb_numpy_row | 0.2256 | 0.2363 |
treelite_gtil_row | 0.0508 | 0.0909 |
onnx_row | 0.0148 | 0.0161 |
続いて、一括処理で1秒あたりに処理できた行数です。
| 経路 | 行数 | 秒 | 行/秒 |
|---|---|---|---|
lgb_batch_100 | 100 | 0.0018 | 55,565.8 |
lgb_batch_1000 | 1,000 | 0.0162 | 61,560.7 |
lgb_batch_10000 | 10,000 | 0.1644 | 60,844.6 |
lgb_batch_18000 | 18,000 | 0.2965 | 60,710.4 |
lgb_batch_float32 | 18,000 | 0.2949 | 61,046.4 |
treelite_gtil_batch | 18,000 | 0.6643 | 27,095.1 |
onnx_batch | 18,000 | 0.1217 | 147,962.3 |
lgb_batch_float32は、ONNXやtreeliteへ渡したのと同じfloat32(32ビットの浮動小数点数)の配列を、LightGBMへ一括で渡した条件です。ほかのLightGBMの行はfloat64を渡しています。
DataFrameを1行ずつ渡した場合は0.2408 ms/件で、1秒あたりに換算すると約4,153件です。同じLightGBMへ18,000行のnumpy配列をまとめて渡すと60,710.4行/秒となり、変換や追加ライブラリなしで14.6倍に増えました。
ただし、この14.6倍にはDataFrameとnumpyという入力形式の違いも混ざっています。両方をnumpyへそろえると、1行ずつの4,432行/秒から一括の約6万行/秒へ変わりました。バッチ化そのものの差は13.7倍です。
入力形式だけの差は1.07倍にとどまりました。つまり今回の条件では、numpyへ変えることよりもpredictの呼び出し回数を減らすほうがはるかに効いています。
LightGBMなら、100件まとめた時点で18,000件一括の9割の速さが出た
まとめる件数を増やしても、速度の伸びは早い段階で止まりました。LightGBMでは100件の一括処理で55,565.8行/秒に達し、1,000件では61,560.7行/秒です。18,000件の約6万行/秒と比べても差は小さく、速度だけを理由に大きなバッチを待つ必要はなさそうです。
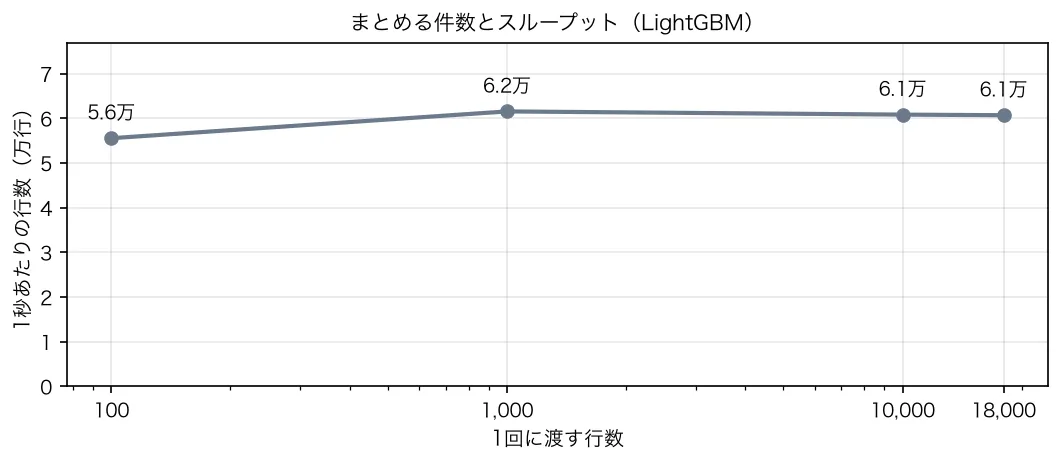
こうなると、件数を決める基準は速度側ではなく、入力がたまるまでの待ち時間の側に移ります。その待ち時間は今回測っていないので、実際の件数は手元の到着間隔と合わせて決めてください。なお、件数を振って測ったのはLightGBMだけで、treeliteとONNXの頭打ち位置は分かりません。
1件ずつなら速いtreelite(GTIL)が、一括ではLightGBMに負けた
測定前には、バッチ化だけで変換に近い速度が得られる一方、単発では変換後の経路が遅くなる条件もあると予想していました。バッチ化の効果は予想どおりでしたが、treeliteで起きた順位の反転は想定と逆向きです。
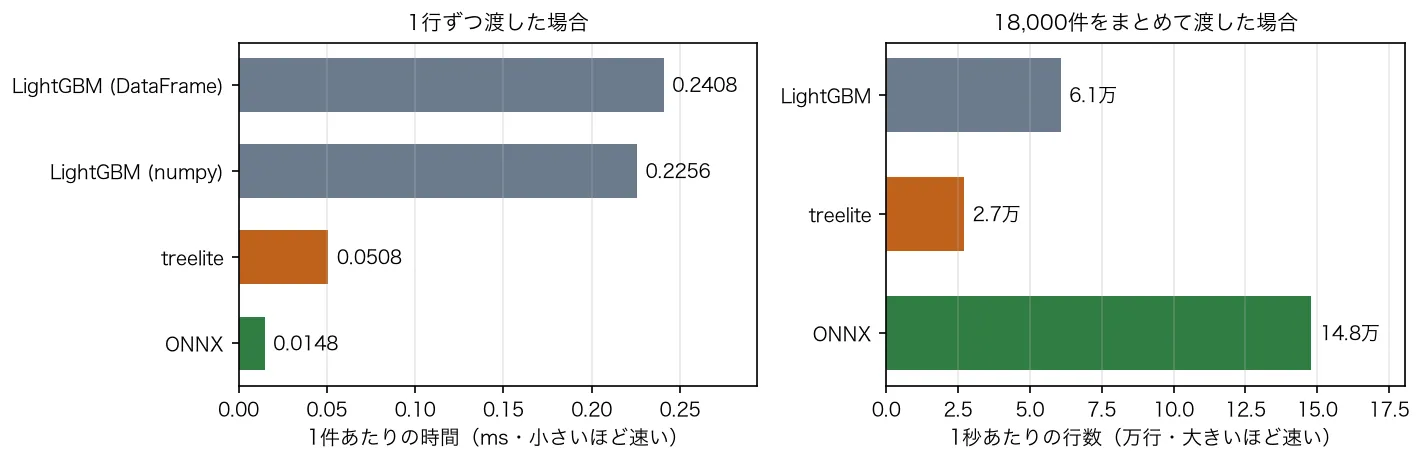
- 単発: 0.0508 ms で、LightGBM の 0.2408 ms の4.7倍速い
- 一括: 2.7万行/秒で、6万行/秒台のLightGBMの0.45倍
同じライブラリ・同じモデル・同じ条件で、使い方だけで順位が反転します。 図1では左が1件あたりの時間、右が1秒あたりの行数なので、棒の長さの意味も逆です。左でLightGBMより短かったtreeliteの棒は、右でもLightGBMより短く、一括では遅い側へ回っています。単発のレイテンシだけを見てtreeliteを選ぶと、バッチ処理ではLightGBMのまま使うより遅くなります。
一つの解釈は、予測処理を呼び出すたびにかかる準備時間と、モデル本体の計算時間の比が変わることです。1件だけなら準備時間の影響が相対的に大きく、18,000件を一度に渡すと1行あたりでは小さくなります。ただし、それぞれの処理時間を分解して測ったわけではないため、順位が反転した仕組みまでは特定していません。
推論速度の比較では、単発か一括かをそろえないと、手法の選択が逆になる可能性があります。「treeliteは速い」という結果だけでは、自分の処理に適用できるか判断できません。
8コアで測り直しても、treeliteはLightGBMを下回った
treeliteのGTILは既定で全コアを使う設計です。そこで、並列化すれば順位が変わるのかを追加で確かめました。同じマシンで、一括スループットだけを全経路8コアで測り直しています。
| 経路 | スレッド1 | 8コア | 伸び |
|---|---|---|---|
onnx_batch | 147,962.3 | 238,392.8 | 1.61倍 |
lgb_batch | 60,710.4 | 207,806.7 | 3.42倍 |
treelite_gtil_batch | 27,095.1 | 67,921.7 | 2.51倍 |
8コアでも順位は変わりませんでした。 treeliteは2.51倍に伸びましたが、LightGBMは3.42倍で、treeliteのスループットはLightGBMの0.33倍です。スレッド1での0.45倍より、差はむしろ広がりました。
伸び率が最も大きかったのはLightGBMです。ONNXは1.61倍にとどまりましたが、この値だけでは伸びが小さい原因まで特定できません。スレッド1での処理効率、並列化の負担、モデル構造などを分けて測っていないためです。
なお、8コアで測ったのは一括スループットだけです。単発レイテンシは並列条件で測っていないため、「単発ではtreeliteが速い」という前節の結果が並列でも保たれるかは分かりません。
ONNXは単発も一括も最速だった
ONNXは両方の使い方で最も速い経路でした。単発0.0148 msはLightGBMの16.3倍、一括147,962.3行/秒は2.44倍に相当します。
遅い側でも差は残りました。単発の95パーセンタイルも0.0161 msで、LightGBMの0.2702 msを下回っています。中央値だけでなく、今回測った遅い側の実行時間でも開きがあるということです。
速度だけを基準にすればONNXが第一候補になります。ただし採用の判断材料はほかにもあります。変換にかかる作業、対応していないモデル構成、それに次の節で見る出力差です。変換時間や対応範囲は今回比較していません。
速くなっても、予測確率が完全に一致するとは限らない
速度だけを見て導入を決めると、出力が変わっていることに気づけません。基準(LightGBM の float64 一括)との最大の確率差を確認しました。
treeliteと、入力をfloat32にしたLightGBMは基準と完全に一致しました(差0.0)。ONNXの最大差は3.19e-07です。多くの行では判定に影響しにくい大きさですが、予測確率が判定境界のごく近くにある場合や、元モデルとの完全一致が要件なら無視できません。
導入時には、実際の入力データを両方へ渡し、確率差の最大値と判定結果の不一致件数を確認します。この記事の値は1モデルに対する結果であり、別のモデルでも同じ差に収まる保証はありません。実際、scikit-learnモデルの保存形式を比べた検証では、ONNXの最大差6.56e-07のランダムフォレストで、1,000件中2件のクラス判定が反転しました。
自分の推論処理では、どこから手をつけるか
まとめて渡せる行があるなら、最初に触るのは変換ではなく呼び出し方です。順番に見ていきます。
-
処理単位の確認 1件ずつ応答する処理なのか、複数行をまとめられる処理なのかを分けます。前者はレイテンシ、後者はスループットを基準にします。
-
現在の呼び出し方の計測 ループ内で
predictを呼んでいる場合は、同じ入力形式のまま複数行を渡した条件と比較します。変換後のライブラリを試す前に、呼び出し回数を減らした効果を切り分けます。 -
LightGBMでは100件で効果の大半が出ましたが、入力が届くまでの待ちは測っていません。実際に待てる範囲で速度と遅延を並べて決めます。
-
変換経路との比較 単発処理ならONNXとtreelite、一括処理ならLightGBMを含む各経路を、同じ入力件数とスレッド数で測ります。単発の結果から一括の順位を推測しません。
-
変換前後の確率差と判定不一致を調べたうえで、変換時間、ファイルサイズ、メモリ、起動時間も採用条件に入れます。次に載せる4経路のコードを土台にできます。
詳しい検証条件
ここからは測り方の細部です。掲載した数字を自分の環境と突き合わせるときに読んでください。
単発は、初回実行に伴う準備時間を除くため30回動かしてから300回測りました。代表値は中央値で、遅い側の確認に95パーセンタイルを使っています。一括は3回実行し、ほかの処理による一時的な遅延を受けにくい最小値を採用しました。
主要な表のスレッド指定は、LightGBMがn_jobs=1、onnxruntimeがintra_op_num_threads=1、treeliteがnthread=1です。8コアの条件では、それぞれn_jobs=-1、nthread=-1、intra_op_num_threads=0(実行時に任せる)へ変えました。treeliteだけスレッドを解いて他を1のままにしたら、この記事が正そうとしている不公平な比較そのものになります。
掲載した数値はすべて、実際に実行して保存したログの集計値です。
読み飛ばし可: 集計とスレッド指定を直して測り直した経緯
最初の実装では、最後の一括条件で実際は 18,000 行しか渡していないのに 20,000 行として割っており、スループットを約11%過大に出していました。検証データの件数が上限だったためです。
実際に渡した行数で割るよう修正して測り直しています。掲載しているのは修正後の値です。
その後、サンプル実装でLightGBMとONNXだけスレッド数を1にし、treeliteのnthreadを指定していないことが分かりました。treeliteだけが全コアを使った結果を環境差と解釈していたため、3経路のスレッド条件をそろえて再測定しています。掲載値はこの再測定後の結果です。
適用範囲と限界
- 合成データ・20特徴・木300本の1モデルだけを使った比較です。 木の本数や特徴量数、カテゴリ変数の有無が変われば、経路の順位も変わる可能性があります。
- 主要な表は全経路をスレッド1に固定した結果です。8コアでは一括スループットだけを測っており、単発レイテンシの順位が並列条件でも保たれるかは分かりません。
- treeliteはPythonから呼び出すGTILだけを対象にしました。Cへコンパイルする経路は未検証なので、この記事の値をtreelite全体の速度上限とはみなせません。
- 変換時間、モデルファイルのサイズ、常駐メモリ、コールドスタートは測っていません。 単発の値はウォームアップ後の定常状態です。
- 絶対値は実行環境に依存します。同じ条件で測り直した際、一括スループットは3経路とも1〜6%動きましたが、順位と倍率の桁は変わりませんでした。
- バッチサイズを変えたのはLightGBMだけです。treeliteとONNXは18,000件の1条件しかなく、100件や1,000件で同じ速度関係になるかは判断できません。
- DataFrame単発からnumpy一括への差は14.6倍ですが、入力形式の影響が含まれます。バッチ化だけを評価する場合は、numpy同士で比べた13.7倍を使います。
単発と一括を同じ条件で測るコード
次のコードは、LightGBM、treelite、ONNXの単発と一括を同じデータで測り、変換前後の予測確率も比較します。実際のモデルへ移す場合は、合成データの生成と学習部分を置き換え、測定部分とスレッド指定を残します。
"""学習済み GBDT の推論を、同一ハーネスで比べる。

問い: 変換(treelite / ONNX)に工数をかける前に、「1件ずつ predict をやめて
まとめて渡す」だけでどこまで取れるのか。単発と一括で順位は変わるのか。
数値の一致も確認する(速くなっても答えが変われば意味がない)。

**スレッドは全経路で1に固定する。** treelite の GTIL は既定が nthread=-1(全コア)で、
指定しないと treelite だけ複数コアを使い、比較が成立しない。
実行: python sample_speedup.py (所要 5 分程度)
"""

import time

import numpy as np
import onnxruntime as ort
import pandas as pd
import treelite
from lightgbm import LGBMClassifier
from onnxmltools.convert import convert_lightgbm
from onnxmltools.convert.common.data_types import FloatTensorType
from sklearn.model_selection import train_test_split

N, N_FEATURES, N_TREES = 60000, 20, 300
N_SINGLE, N_BATCH_ROWS, WARMUP, SEED = 300, 20000, 30, 0


def timed_single(fn, rows, n):
    """ウォームアップ後に n 回測り、中央値と95パーセンタイルを返す。"""
    for i in range(WARMUP):
        fn(rows[i % len(rows)])
    lat = []
    for i in range(n):
        t = time.perf_counter()
        fn(rows[i % len(rows)])
        lat.append(time.perf_counter() - t)
    a = np.array(lat)
    return float(np.median(a) * 1000), float(np.percentile(a, 95) * 1000)


def timed_batch(fn, data, reps=3):
    fn(data[:100])                      # ウォームアップ
    return min(_time_once(fn, data) for _ in range(reps))


def _time_once(fn, data):
    t = time.perf_counter()
    fn(data)
    return time.perf_counter() - t


rng = np.random.default_rng(SEED)
X = rng.normal(size=(N, N_FEATURES))
logit = X[:, :5] @ np.array([1.5, -1.2, 0.9, 0.7, -0.5]) + 0.6 * X[:, 0] * X[:, 1]
y = rng.binomial(1, 1 / (1 + np.exp(-logit)))
X = pd.DataFrame(X, columns=[f"f{i}" for i in range(N_FEATURES)])
Xtr, Xte, ytr, _ = train_test_split(X, y, test_size=0.3, random_state=SEED)
model = LGBMClassifier(n_estimators=N_TREES, learning_rate=0.05, verbose=-1,
                       random_state=SEED, n_jobs=1).fit(Xtr, ytr)

Xb = Xte.iloc[:N_BATCH_ROWS]
Xb64 = np.ascontiguousarray(Xb.to_numpy(dtype=np.float64))
Xb32 = np.ascontiguousarray(Xb.to_numpy(dtype=np.float32))
df_rows = [Xte.iloc[[i]] for i in range(N_SINGLE)]
np_rows = [np.ascontiguousarray(Xte.iloc[[i]].to_numpy(dtype=np.float64))
           for i in range(N_SINGLE)]
rows32 = [np.ascontiguousarray(r.astype(np.float32)) for r in np_rows]

baseline = model.predict_proba(Xb64)[:, 1]     # 基準は LightGBM の float64 一括
out = []

# --- 単発 ---
for name, rs in (("lgb_df_row", df_rows), ("lgb_numpy_row", np_rows)):
    m, p = timed_single(lambda r: model.predict_proba(r), rs, N_SINGLE)
    out.append({"経路": name, "種類": "単発", "中央値ms": m, "p95ms": p})

# --- 一括(LightGBM)---
for bs in (100, 1000, 10000, N_BATCH_ROWS):
    sub = Xb64[:bs]
    sec = timed_batch(lambda d: model.predict_proba(d), sub)
    # 実際に渡した行数で割る(検証データの件数が上限)
    out.append({"経路": f"lgb_batch_{len(sub)}", "種類": "一括", "秒": sec,
                "行数": len(sub), "行/秒": len(sub) / sec, "最大確率差": 0.0})

sec = timed_batch(lambda d: model.predict_proba(d), Xb32)
out.append({"経路": "lgb_batch_float32", "種類": "一括", "秒": sec, "行数": len(Xb32),
            "行/秒": len(Xb32) / sec,
            "最大確率差": float(np.max(np.abs(model.predict_proba(Xb32)[:, 1] - baseline)))})

# --- treelite (GTIL) ---
tl = treelite.frontend.from_lightgbm(model.booster_)
pr = np.asarray(treelite.gtil.predict(tl, Xb32, nthread=1)).reshape(len(Xb32), -1)
diff_tl = float(np.max(np.abs((pr[:, -1] if pr.shape[1] > 1 else pr[:, 0]) - baseline)))
sec = timed_batch(lambda d: treelite.gtil.predict(tl, d, nthread=1), Xb32)
out.append({"経路": "treelite_gtil_batch", "種類": "一括", "秒": sec, "行数": len(Xb32),
            "行/秒": len(Xb32) / sec, "最大確率差": diff_tl})
m, p = timed_single(lambda r: treelite.gtil.predict(tl, r, nthread=1), rows32, N_SINGLE)
out.append({"経路": "treelite_gtil_row", "種類": "単発", "中央値ms": m, "p95ms": p,
            "最大確率差": diff_tl})

# --- ONNX ---
onx = convert_lightgbm(model.booster_, initial_types=[
    ("input", FloatTensorType([None, N_FEATURES]))], zipmap=False)
with open("model.onnx", "wb") as f:
    f.write(onx.SerializeToString())
so = ort.SessionOptions()
so.intra_op_num_threads = 1
sess = ort.InferenceSession("model.onnx", so, providers=["CPUExecutionProvider"])
iname, oname = sess.get_inputs()[0].name, sess.get_outputs()[-1].name

o = np.asarray(sess.run([oname], {iname: Xb32})[0])
diff_onnx = float(np.max(np.abs((o[:, -1] if o.ndim > 1 and o.shape[1] > 1
                                 else o.ravel()) - baseline)))
sec = timed_batch(lambda d: sess.run([oname], {iname: d}), Xb32)
out.append({"経路": "onnx_batch", "種類": "一括", "秒": sec, "行数": len(Xb32),
            "行/秒": len(Xb32) / sec, "最大確率差": diff_onnx})
m, p = timed_single(lambda r: sess.run([oname], {iname: r}), rows32, N_SINGLE)
out.append({"経路": "onnx_row", "種類": "単発", "中央値ms": m, "p95ms": p,
            "最大確率差": diff_onnx})

d = pd.DataFrame(out)
print("\n--- 単発(1行)レイテンシ ---")
print(d[d.種類 == "単発"][["経路", "中央値ms", "p95ms", "最大確率差"]].round(4).to_string(index=False))
print("\n--- 一括スループット ---")
print(d[d.種類 == "一括"][["経路", "行数", "秒", "行/秒", "最大確率差"]].round(4).to_string(index=False))比較時は、intra_op_num_threads=1、n_jobs=1、nthread=1をセットで指定します。 どれかを省くと経路ごとに使うCPUコア数が変わり、ライブラリ以外の差が混ざります。
とくに、treeliteのnthread=1は省きやすい指定です。GTILの既定値はnthread=-1(全コア)なので、書かなければtreeliteだけが複数コアを使います。実際にこの指定漏れによって順位が変わり、当初は環境差だと誤って解釈していました。
macOS で treelite を使う場合、OpenMP のライブラリが見つからずに読み込みが失敗することがあります。その場合は scikit-learn が同梱しているものを参照させると動きます(DYLD_LIBRARY_PATH に site-packages/sklearn/.dylibs を追加)。
下に載せたのは、このコードを本文の表と同じマシン(Apple M1 / Python 3.11.15)で回した結果です。
実行結果
--- 単発(1行)レイテンシ ---
               経路  中央値ms  p95ms  最大確率差
       lgb_df_row 0.2410 0.2671    NaN
    lgb_numpy_row 0.2297 0.2654    NaN
treelite_gtil_row 0.0506 0.0545    0.0
         onnx_row 0.0145 0.0161    0.0

--- 一括スループット ---
                 経路      行数      秒         行/秒  最大確率差
      lgb_batch_100   100.0 0.0018  55342.8850    0.0
     lgb_batch_1000  1000.0 0.0164  61107.8860    0.0
    lgb_batch_10000 10000.0 0.1590  62888.3849    0.0
    lgb_batch_18000 18000.0 0.2854  63076.6973    0.0
  lgb_batch_float32 18000.0 0.2875  62598.9337    0.0
treelite_gtil_batch 18000.0 0.6695  26883.9722    0.0
         onnx_batch 18000.0 0.1145 157148.3401    0.0
本文と同じスレッド設定で測っており、経路の順序と倍率は一致しました。実行セッションが異なるため、LightGBMの一括は60,710.4対63,076.7行/秒、ONNXの単発は0.0148対0.0145 msと、絶対値にはばらつきがあります。
最大確率差の列は小数第4位で丸めているため、ONNXも0.0と表示されます。前述のとおり完全一致ではないため、丸める前の値も確認が必要です。
高速化の手を選ぶ前に、処理の単位をそろえる
大量の行をまとめられるなら、最初に試すのはモデル変換ではなくLightGBMのバッチ化です。今回のモデルでは、100件の時点で一括処理の効果の大半が得られました。1件ずつ応答する処理ではONNXとtreeliteが候補になりますが、その結果をそのまま一括処理へ持ち込めません。
ベンチマークを再現するときは、入力件数、入力形式、スレッド数をそろえます。treeliteのスレッド指定が1か所抜けただけで順位が変わり、当初の環境差という解釈を撤回することになりました。
次の一手は、手元のコードでループ内のpredictを探し、単発と一括を分けて測るところです。そのうえで変換を検討するなら、速度だけでなく、予測確率と判定結果の一致も採用条件に入れてください。