
機械学習モデルを本番環境に出した後も、入力データを作る処理には改修が入ります。列名が変わったならエラーで気づけますが、金額の単位やカテゴリの対応だけが変わった場合は、そのまま最後まで処理が進みます。予測値は返ってくるのに、モデルが学習時とは違う意味のデータを受け取っている状態です。
数値への強制変換、欠損の補完、知らないカテゴリの無視を実装に組み込んでおけば、入力に問題があっても処理は続きます。止まらない仕組みとしては有効です。ただし例外が記録されないまま予測値だけが変わるので、気づくのが遅れます。ジョブの成功記録が示すのは処理が最後まで動いた事実であって、入力の中身が正しいことではありません。
そこで登場するのがpanderaです。データが満たすべき条件をコードで書いておき、モデルへ渡す前に違反を止めます。ただし止められるのは、書いた条件までです。この記事では学習済みモデルを固定したまま、推論(学習済みモデルで予測を出す処理)に渡す入力だけを8種類変え、どこまで止まってどこからすり抜けるのかを測りました。
先に結論
- panderaで止めやすいのは、型、欠損、値域など、スキーマ(データが満たすべき条件の定義)に宣言した条件への違反。今回の検証では、異常が1%混じった時点で警告が出た
- 宣言した範囲内で値の意味だけが変わると、検査を通過する。金額を1/1000にする単位のずれは4つの検査すべてが見逃し、正解率は最大4.96ポイント低下
- 学習データの最小値と最大値をそのまま境界にすると、正常な入力にも10シード(乱数の種を変えた10回の繰り返し)中6シードで警告。上下に1割広げた場合は3シードに減り、検出できる異常は変わらなかった
- 検証条件は、
adult(48,842件)の2値分類をLightGBMで解く1構成。学習済みモデルと評価行を固定し、推論時の入力だけを変化させて10シードで比較
panderaとは?DataFrameをスキーマで検証するライブラリ
読み進めるのに必要なのは、pandasのDataFrame(表形式のデータ)を組み立てた経験だけです。panderaを使ったことがなくても困らないよう、スキーマの書き方から順に見ていきます。
panderaは、DataFrameに期待する構造と値の条件をPythonコードで表し、届いたデータが条件を満たすか検証するライブラリです。pandas向けに始まり、現在はPolars、PySpark SQL、Ibisにも対応しています。今回の検証にはpandas向けAPIを使いました。ほかのライブラリへの対応状況は、pandera公式ドキュメントで確認できます。
スキーマに記述する主な条件は、次のとおりです。
- 必要な列とデータ型
- 欠損を許可するか
- 数値の最小値・最大値
- カテゴリ列で許可する値
- 余分な列や列順を許可するか
- 複数列を使った独自のチェック
たとえば、ageは0〜120の数値で欠損不可、occupationは定義済みのカテゴリだけを許可するなら、次のように定義します。
import pandera.pandas as pa

allowed_occupations = sorted(training_df["occupation"].unique())

schema = pa.DataFrameSchema(
    {
        "age": pa.Column(
            int,
            pa.Check.in_range(0, 120),
            nullable=False,
        ),
        "occupation": pa.Column(
            str,
            pa.Check.isin(allowed_occupations),
            nullable=False,
        ),
    },
    strict=True,
)

validated_df = schema.validate(input_df, lazy=True)推論前に呼び出すのはschema.validate()です。条件に合わないデータはここで止まり、モデルには渡りません。training_dfとinput_dfは、お手元の学習データと届いたデータに読み替えてください。strict=Trueは定義にない余分な列を拒否する指定、lazy=Trueは見つかった違反をまとめて報告する指定です。
推論処理に組み込む位置は、次の順序で考えると分かりやすくなります。
- ファイルやAPIからDataFrameを受け取る
- panderaで列構造と値を検証する
- 検証を通ったデータだけを前処理へ渡す
- 学習時と同じ変換を適用してモデルで推論する
panderaが判断するのは、スキーマに書かれた条件への適合です。予測精度の低下や、値の意味の変化までは対象になりません。学習データとの分布差を監視する方法にも、区切り方や閾値による見逃しが残ります。導入時に決めるのは組み込む場所だけではなく、何をスキーマに書き、どこから先を別の監視へ任せるかという境界までです。その境界がどこにあるのかを、実際の入力を変えて測りました。
学習済みモデルを固定し、入力だけを変えて4つの検査に通した
学習済みモデルと評価に使う行は固定したまま、推論へ渡す入力にだけ変化を加えました。条件間で動くのは入力の壊し方だけなので、精度の差を入力の変化と結びつけて読めます。
使ったのは、米国の人口調査をもとにした二値分類データadult(48,842件、説明変数14列)です。モデルにはLightGBMを使い、入力異常による変化を正解率とROC-AUCで測りました。ROC-AUCは、正例を負例より上位に並べられる度合いを表します。0.5付近がランダム、1に近いほど良い値です。
加えた異常は、数値の文字列化、欠損の急増、欠損を表す特殊値、未知カテゴリ、単位のずれ、2列の取り違え、カテゴリコードの変更、符号の反転の8種類です。それぞれ、異常を混ぜる行の割合(混入率)を1%から100%まで6段階に振り、乱数の種を変えて10回ずつ繰り返しました。
入力を受け止める側には、4種類の検査を並べました。最初の3つはpanderaで書いたスキーマで、許容範囲だけを変えています。
- 学習範囲そのまま:数値列は学習データの最小値から最大値まで、カテゴリ列は学習時に現れた水準(カテゴリが取り得る値)の集合。列の集合と順序も固定
- 学習範囲+1割:数値範囲を学習時の幅の1割ずつ上下に広げ、ほかの条件は変えない
- ドメイン知識のみ:定義書から決められる範囲を使用。カテゴリの水準集合は学習データから取り、列順は問わない
- 分布監視(PSI):値の範囲をいくつかの区間に分け、区間ごとの行の割合が学習時からどれだけ動いたかを1つの数値にする指標。学習データとのずれが0.2以上の列に警告
見たいのは、どの異常を検出できるか、検出できない異常で精度がどこまで下がるか、正常な入力を誤って止めていないかの3点です。同じスキーマでも、異常を止める力と正常な入力を通す力は別物です。検出の可否と誤検出は別々に数えます。この分け方が結論を決めました。
防御的に書いた実装では8種類とも例外が出ず、精度だけが落ちた
8種類のどれを混ぜても、推論処理は一度も止まりませんでした。ジョブが最後まで動いたことは、入力が正しい根拠にならないわけです。推論の呼び出しをtry/exceptで囲んで例外の有無を記録したところ、防御的に書いたパイプラインでは480通りすべてが通過し、例外は0件でした。おかげで、どの入力変化についても正常時との精度差を比較できました。
同じ入力をscikit-learn既定の検査に通すと、8種類中3種類が例外になりました。数値の文字列化、欠損の急増、未知カテゴリは混入率1%でも停止しますが、特殊値による欠損表現、単位のずれ、2列の取り違え、カテゴリコードの変更、符号の反転は通過します。後者はいずれも、型として受け取れる値のまま意味だけが変わっているためです。
この判定に使ったのは、正常な入力がそのまま通った8本の種だけです。残る2本では、学習側にないnative-countryの希少な水準が検証側だけに現れ、異常を加える前から例外になりました。
すべての検査が捉えた4種が、被害は最も小さかった
4つの検査すべてが捉えた4種類では、正解率の低下が0.61〜0.73ポイントに収まりました。一方、どの検査も捉えなかった単位のずれは4.96ポイント低下し、今回の8種類で最大です。混入率100%の結果を、低下幅の大きい順に並べます。
| 入力異常 | 正解率の変化(pt) | AUCの変化 | 学習範囲そのまま | 学習範囲+1割 | ドメイン知識のみ | 分布監視(PSI) |
|---|---|---|---|---|---|---|
| 単位のずれ(金額が1/1000) | -4.96 ± 0.21 | -0.0704 | 見逃し | 見逃し | 見逃し | 見逃し |
| 似た2列の取り違え | -4.19 ± 0.38 | -0.0545 | 検出 | 検出 | 見逃し | 検出 |
| 符号の反転 | -2.47 ± 0.15 | -0.0260 | 検出 | 検出 | 検出 | 見逃し |
| カテゴリコードの振り直し | -2.18 ± 0.25 | -0.0178 | 見逃し | 見逃し | 見逃し | 検出 |
| 未知のカテゴリ水準 | -0.73 ± 0.21 | -0.0044 | 検出 | 検出 | 検出 | 検出 |
| 欠損を999で表現 | -0.65 ± 0.32 | -0.0106 | 検出 | 検出 | 検出 | 検出 |
| 数値が文字列で到着 | -0.61 ± 0.19 | -0.0080 | 検出 | 検出 | 検出 | 検出 |
| 欠損の急増 | -0.61 ± 0.19 | -0.0080 | 検出 | 検出 | 検出 | 検出 |
正解率の変化は、10本の平均と標準偏差です。検出の可否は10本とも一致しました。混入率100%で「数値が文字列で到着」と「欠損の急増」が同じ数値になるのは、どちらも強制変換によって全行が欠損になり、中央値で埋まるためです。混入率50%以下では、両者の結果が分かれます。
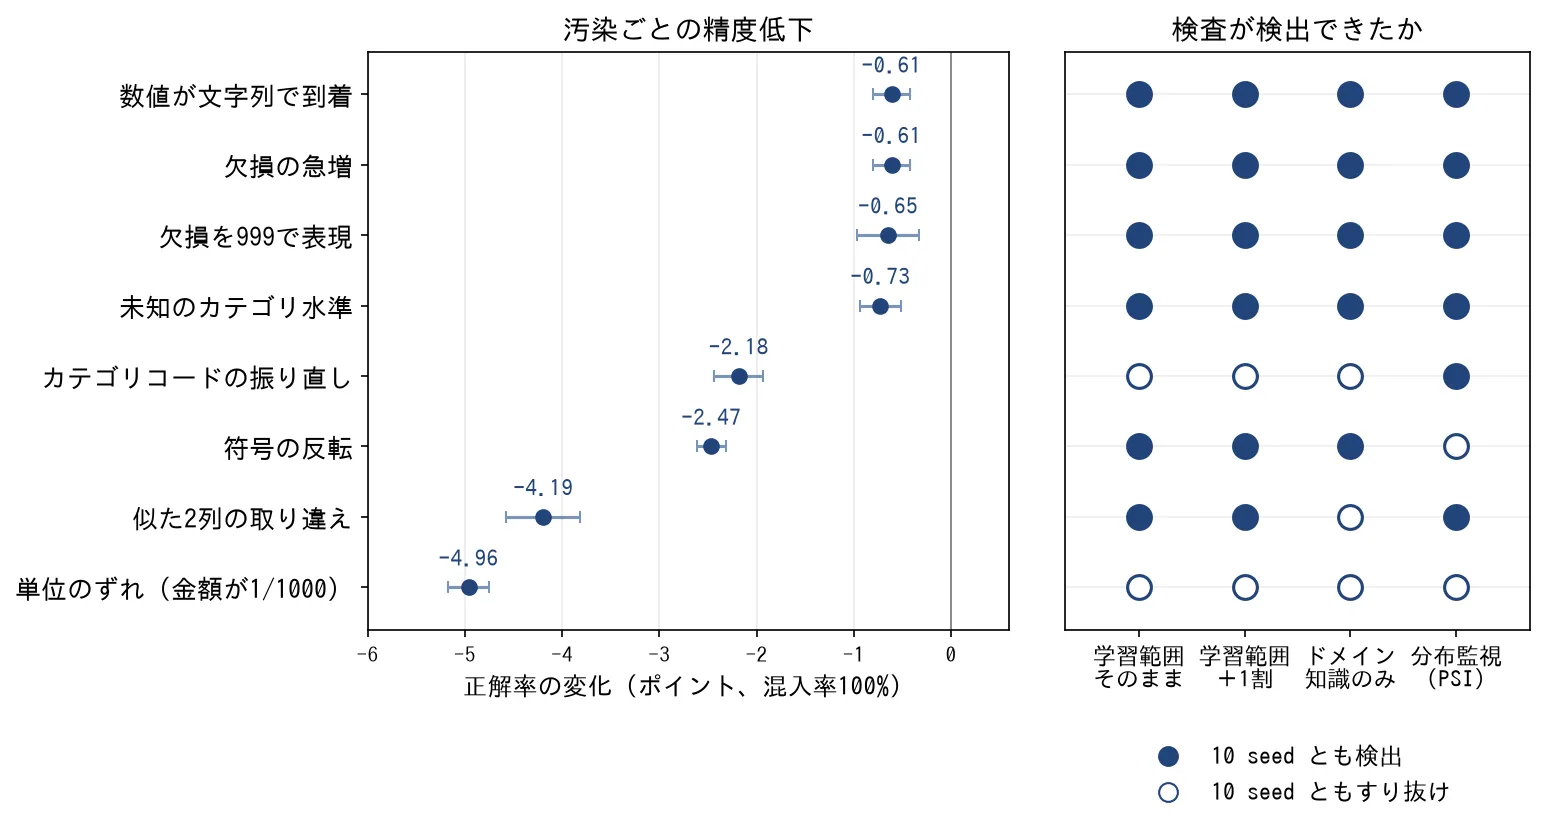
値の範囲やカテゴリ集合を宣言する検査は、条件内に収まる値を原理的に検出できません。単位を1/1000にしても、値が0以上かつ学習時の最大値以下なら範囲内ですし、変更後の値がすべて既知ならカテゴリコードの変更もすり抜けます。文字列、欠損、未知カテゴリを検出できるのは、宣言した型や候補に反するからです。
もっとも、検出可否と精度低下が常に逆相関するわけではありません。符号の反転は3種類のスキーマが検出したものの、正解率は2.47ポイント下がりました。列単位では例外が残るため、「検出できる異常は影響が小さい」とは一般化できません。
列単位の検査の検出可否は混入率で動かず、被害だけが大きくなる
列単位の検査は、今回の6水準のあいだで検出可否が1件も変わりませんでした。混入率1%(9,769行のうち98行)でも、宣言に反する値があれば検出します。反対に、範囲内の異常は100%まで増やしても見逃したままでした。
それに対して、精度の低下は混入率にほぼ比例しました。単位のずれでは1%で-0.06ポイント、10%で-0.54ポイント、50%で-2.54ポイント、100%で-4.96ポイントまで広がっています。混入が小さいうちは列単位の検査だけが反応し、範囲内の異常では精度だけが静かに下がるということです。
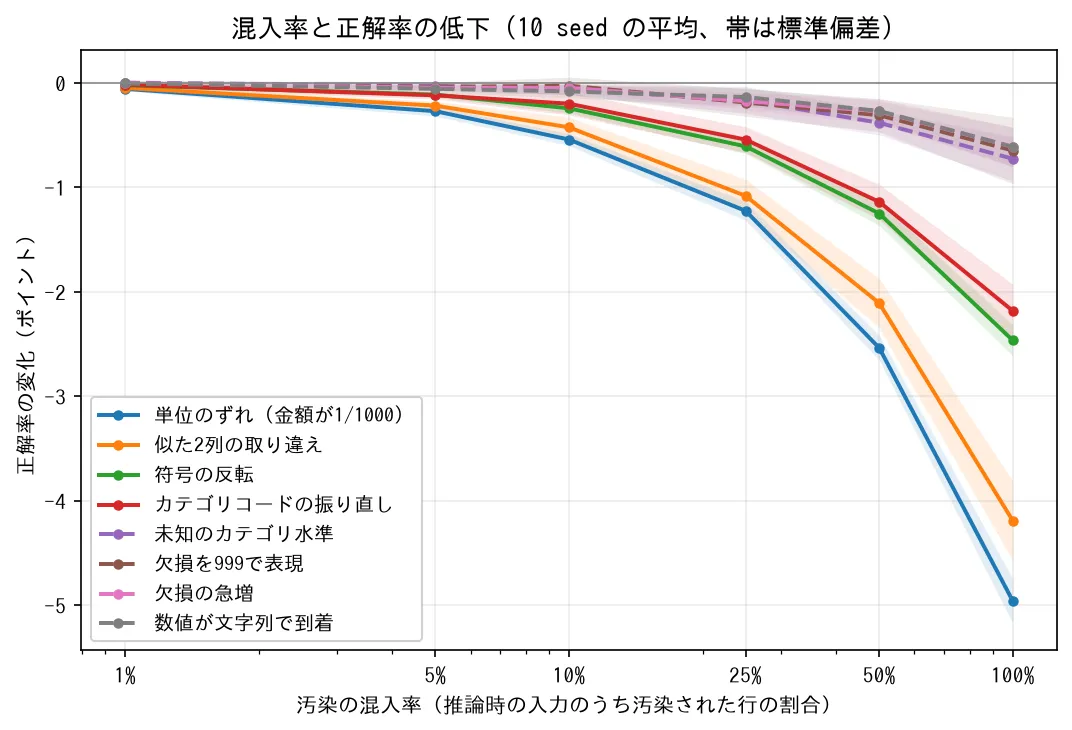
つまりここには2種類の死角があり、列単位の検査と精度監視は互いの死角を補う関係でした。片方だけを運用に置くと、どちらかの死角がそのまま残ります。ただし今回の精度は正解ラベルのある評価データ上で測っており、本番で精度監視を回せるのは、遅れてでも正解が手に入る業務に限られます。
分布監視(PSI)だけは、混入率によって検出結果が変わりました。カテゴリコードの振り直しは50%以上で検出され、100%でのPSIは2.10です。999による欠損表現は25%以上、2列の取り違えは100%で検出されましたが、取り違えの混入率が50%の場合は10本中5本にとどまりました。
単位のずれと符号の反転は、混入率100%でもPSIが0.105どまりで、閾値0.2に届きませんでした。金額の2列は9割以上の行が0なので、値の大きさ順に10等分しようとすると区間が潰れ、等幅の区切りへ切り替わります。その結果、値の大半が最初の区間に集中し、1/1000への変換や符号の反転があっても区間ごとの割合はほとんど動きません。
この説明にたどり着くまでに、集計を一度やり直しています。最初の実装では、金額列に変化を加えたどの条件でも、2列のPSIが0.000000でした。原因は、区間が1本しか作られていなかったこと。入力がどう変わっても、指標は動きません。等幅の区切りへ切り替える規則を加え、再計測したものが掲載値です。
厳しいスキーマは、汚れていない入力も止めた
誤検出の数値も、集計をやり直した結果です。最初は「何らかの警告が出たか」を、そのまま検出率として数えていました。すると、学習データの最小値〜最大値を境界にしたスキーマが、10シード中6シードで8種類すべてを検出した計算になります。範囲内に収まる単位のずれやカテゴリコードの振り直しまで検出率0.6。不自然な集計でした。
原因は、正常な検証データにも10シード中6シードで違反が出たことです。検証側に学習時の最大値を超えるfnlwgtが現れたケースと、学習側にないnative-countryの希少な水準が検証側だけに現れたケースがありました。入力異常とは無関係な警告です。「報告された列に、入力異常を加えた列が含まれるか」で数え直すと、単位のずれとカテゴリコードの振り直しは3種類のスキーマすべてで検出率0.0となり、結論が反転しました。
数値範囲を上下1割ずつ広げても、今回の8種類で検出できた入力異常は変わりませんでした。減ったのは誤検出の頻度だけです。「ドメイン知識のみ」まで緩めると2列の取り違えを見逃し、ここで初めて検出対象に差が出ました。
誤検出は、範囲を緩めるほど減少しました。内訳は、学習範囲そのままが10シード中6シード、学習範囲+1割が3シード、ドメイン知識のみが2シードです。分布監視では発生せず、正常時のPSIも最大0.0066と閾値0.2を大きく下回りました。
列の並び替えは、列名で受ければAUCが動かず、位置で渡すと平均0.218落ちた
列の並び替えは、ほかの8種類と分けて測定しました。想定したのは、上流で列の順序だけが変わるケースです。
列名で選ぶ実装では、AUCの差が10本の種すべてで0.0000となり、列順が変わっても影響はありませんでした。ところが、同じ入力を位置で渡すと、AUCは平均0.218低下し(標準偏差0.118、最小0.102、最大0.487)、正解率も平均9.3ポイント下がっています。入力側で起きた変化は同じでも、被害を決めたのは受け取る側の実装でした。
位置渡しの検証には、数値6列だけで学習した別のモデルを使いました。このAUCをほかの節の値と直接比較することはできず、比べられるのは同じ実験内における正常時との差だけです。
列の集合と順序を固定した「学習範囲そのまま」は、10本すべてで順序違反を報告しました。列順を問わない「ドメイン知識のみ」で警告が出たのは2本だけで、いずれも列順とは無関係なnative-countryの誤検出でした。
導入時にまず流すのは、異常データではなく正常な入力
ここまでの結果から、導入前の確認は次の順序で進めます。
- 上流の仕様をもとに、列の集合、型、欠損の可否、値域、カテゴリ水準を宣言する
- 異常を加える前の検証データを流し、正常な入力への警告を記録する。学習データの最小値と最大値は、境界の候補であって正解ではない
- 単位の変更やカテゴリ対応の変更など、起こり得る入力変化を再現し、違反が出た列まで確認する
- 範囲内の変化には分布監視や列間の整合性検査を検討し、列は位置ではなく名前でモデルへ渡す
最初の境界としては、学習範囲をそのまま使うより上下1割広げたほうが扱いやすい結果でした。今回の条件では検出できる異常が変わらないまま、誤検出の出たシードだけが半分に減っています。上流との仕様合意や列間の整合性検査は、範囲内で起きる変化への候補として残りますが、その効果は今回の実験では測っていません。
詳しい検証条件
ここから先は、結果を点検したい読者向けの条件です。読み飛ばしても本線の結論は変わりません。
データはPMLB収録版のadultで、カテゴリ列が整数コードになっているため、情報量を変えずに文字列カテゴリへ置き換えました。乱数の種ごとに目的変数の比率を保ったまま8割と2割に分割し、正常な8割だけで学習、評価用の2割にだけ異常を加えています。
- 混入率: 1%・5%・10%・25%・50%・100%の6水準
- 乱数の種: 0から9の10本(8種類 × 6水準 × 10本で480通り)
- 指標: ROC-AUCと正解率(同じ種の正常時との差を求めてから平均)
金額の2列(capital-gainとcapital-loss)は、9割以上の行が0です。単位のずれ、符号の反転、2列の取り違えを全行へ加えても、実際に値が動く行は一部でした。それでも、精度への影響は大きく出ました。
精度計測には、数値への強制変換、中央値補完、未知カテゴリの無視を組み込み、例外で停止しにくくした実装を使いました。比較用として、scikit-learn既定の入力検査(check_arrayとhandle_unknown="error")を使う構成も用意しています。後者で調べるのは例外の有無だけで、精度比較には含めません。
4種類の検査はいずれも、乱数の種ごとに学習データから生成しました。スキーマの規則は、入力を変化させる前に固定しています。結果を見てから規則を書き足すと、都合よく「検出できた」ことにできてしまうためです。検出の条件は、違反として報告された列に、入力異常を加えた列が含まれていることとしました。
掲載する数値は、実行時に保存したログの集計値です。統計的な検定は行っていません。低下幅は前掲の表のとおりで、標準偏差はいずれも0.4ポイント以下でした。この開きなら、順位は僅差の区別に左右されないと判断できます。正常な入力での基準値は、10本の平均でROC-AUC 0.9291、正解率0.8734でした。
読み飛ばし可: 分布監視の作り方・取得元
- 数値列のPSIは、学習データの十分位からビンを作りました。十分位が重複して4本未満に潰れる列(値の大半が0の金額列など)では、等幅ビンへ切り替えています。カテゴリ列は水準の出現割合を基準とし、割合0のビンには1e-4の下限を設けました。閾値0.2とビンの規則は事前に固定しています。
- 変化を加える行は、乱数の種、入力異常の番号、混入率の番号から決まる乱数生成器で抽出しました。同じ条件なら同じ行が選ばれます。
- データはPMLBのリポジトリから取得し、取得日、SHA256、ファイルサイズを実行ログに記録しました。PMLBの収録情報では、出典はUCI Machine Learning RepositoryのAdult、原典の文献はKohavi(1996)とされています。収録データ本体の再配布条件は、この実行環境から一次情報に到達できず確認できませんでした。PMLBリポジトリのライセンス表記が収録データの上流条件を上書きするとは限らないため、ライセンスについては断定していません。
今回の検証結果を適用できる範囲
今回対象にしたのは、表形式データの2値分類をLightGBMで解く1構成です。入力異常による被害の順位は、データや列の重要度が変われば入れ替わる可能性があります。
被害の大きさは、入力を受け取る実装にも左右されます。数値への強制変換、中央値補完、未知カテゴリの無視を組み込んだパイプラインでの結果であり、すべての推論実装に共通する値ではありません。列の並び替えでは、名前で受けるか位置で受けるかによって影響が分かれました。
PSIの結果も実装依存です。値の大きさ順に10等分し、区切りが潰れた列では等幅へ切り替えました。閾値は0.2です。「PSIでは単位のずれを検出できない」という一般的な結論ではなく、区切り方や閾値が変われば検出可否も変わります。
精度低下の機序、DataFrame全体を対象とした列間の検査、上流との単位の取り決めは未検証です。検証による処理時間の増加も測りましたが、CPUをほかのジョブと共有する環境だったため、比較に使える数値は得られませんでした。
合成データでスキーマの死角を再現する
スキーマで止められる入力と、範囲内ですり抜ける入力を手元で確かめる最小実装です。外部データは使わず、合成データで学習してスキーマを作り、範囲外、未知カテゴリ、単位のずれという3種類の入力を流します。
pandera 0.24以降では、pandas向けAPIがpandera.pandasに置かれています。読み込みはimport pandera.pandas as paです。検索結果で見かけるimport pandera as paは古い書き方の場合があります。実行手順で0.32以降を指定したのは、計測環境に合わせるためです。
"""pandera で「弾ける事故」と「すり抜ける事故」を手元で再現する最小例。"""
import numpy as np
import pandas as pd
import pandera.pandas as pa
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import accuracy_score

rng = np.random.default_rng(0)
N = 6000

# 合成データ: 金額(重い裾)・時間・地域コードから二値ラベルを作る
amount = np.where(rng.random(N) < 0.8, 0.0, rng.gamma(2, 3000, N))
hours = rng.normal(40, 10, N).clip(1, 99)
region = rng.choice(["r0", "r1", "r2", "r3"], N)
score = 0.00035 * amount + 0.05 * hours + pd.Series(region).map(
    {"r0": 0, "r1": 1.5, "r2": -1.0, "r3": 0.5}
).to_numpy()
y = (score + rng.normal(0, 1.0, N) > np.median(score)).astype(int)
df = pd.DataFrame({"amount": amount, "hours": hours, "region": region, "y": y})

train, serve = df.iloc[:5000], df.iloc[5000:].reset_index(drop=True)


def to_matrix(d):
    """推論用の特徴量行列。カテゴリは学習時の水準でダミー化する。"""
    x = d[["amount", "hours"]].apply(pd.to_numeric, errors="coerce")
    x = x.fillna(train[["amount", "hours"]].median())
    for lv in sorted(train["region"].unique()):
        x[f"region_{lv}"] = (d["region"].astype(str) == lv).astype(int)
    return x


model = HistGradientBoostingClassifier(random_state=0).fit(
    to_matrix(train), train["y"]
)

# 学習データをプロファイルして作る、ごく普通のスキーマ
schema = pa.DataFrameSchema(
    {
        "amount": pa.Column(
            float,
            pa.Check.in_range(train["amount"].min(), train["amount"].max()),
            nullable=False,
        ),
        "hours": pa.Column(
            float,
            pa.Check.in_range(train["hours"].min(), train["hours"].max()),
            nullable=False,
        ),
        "region": pa.Column(
            str, pa.Check.isin(sorted(train["region"].unique())), nullable=False
        ),
    },
    strict="filter",
)

cases = {
    "クリーン": serve,
    "範囲外(hours=999)": serve.assign(hours=999.0),
    "未知のカテゴリ": serve.assign(region="r9"),
    "単位のずれ(金額が1/1000)": serve.assign(amount=serve["amount"] / 1000),
}

base = accuracy_score(serve["y"], model.predict(to_matrix(serve)))
print(f"クリーンな入力の正解率: {base:.4f}\n")
for name, d in cases.items():
    try:
        schema.validate(d, lazy=True)
        detected = "検出なし"
    except pa.errors.SchemaErrors as e:
        detected = f"検出 ({len(e.failure_cases)}件)"
    acc = accuracy_score(d["y"], model.predict(to_matrix(d)))
print(f"{name:26s} 検証={detected:14s} 正解率={acc:.4f} ({acc - base:+.4f})")上のコードをminimal_pandera_demo.pyとして保存し、次のコマンドを実行します。
pip install "pandera>=0.32" scikit-learn pandas numpy
python minimal_pandera_demo.py
この環境では、次の出力が得られました。
クリーンな入力の正解率: 0.7860

クリーン                       検証=検出なし           正解率=0.7860 (+0.0000)
範囲外(hours=999)             検証=検出 (1000件)     正解率=0.7120 (-0.0740)
未知のカテゴリ                    検証=検出 (1000件)     正解率=0.6420 (-0.1440)
単位のずれ(金額が1/1000) 検証=検出なし 正解率=0.7270 (-0.0590)金額を1/1000にした条件だけは、検証を通過したまま正解率が下がりました。範囲検査だけでは、許容範囲内の単位変換を捉えられません。この最小例には本文と異なる合成データを使っているため、低下幅や入力異常どうしの順位は比較の対象外です。schemaを実際のデータ定義に置き換え、casesへ想定する異常を加えると、自分の推論処理でも同じ確認を行えます。
スキーマ検証だけでは入力変化を網羅できない
panderaを推論の手前に置くと、宣言に反する入力は今回の最小の混入率でもモデルへ届きませんでした。運用で効きめを分けるのは、そこから先の記録の取り方です。警告が出たかどうかだけをログに残すと、鳴っている理由が入力の異常なのか、境界の置き方なのかを後から区別できません。違反した列名まで残しておけば、この取り違えを避けられます。
次の一手は、スキーマを書くことより、書いた境界を測ることです。正常な入力と想定する異常の両方を流し、誤検出と見逃しを別々に数えたうえで境界を決めてください。学習前のデータ処理が精度へ及ぼす影響は、データリークの実測記事で扱っています。