
3か月後までに解約しそうな人を先に知りたい。そう考えて契約データを開くと、最初に必要になるのが正解ラベルです。解約した人に 1、していない人に 0 を付けて、あとは分類モデルに学習させる。手順としては、ここまでで一度形になります。
ところが、0 が付いた人は同じ状態ではありません。契約開始日や最終確認日がそろっていないデータでは、期間内に解約しなかった対象と、結果が分かる前に追跡が終わった対象が同じ 0 に混ざります。後者まで未解約とみなせば、モデルを学習する前のラベル作成の時点で、すでに解約率がずれてしまいます。
解約したか分からないまま追跡が終わることを、生存分析では「打ち切り」と呼びます。結果は不明でも、最後に確認できた日までは解約していなかったことが分かるので、その期間まで捨てる必要はありません。生存分析は、特徴量に加えて「どこまで観測できたか」と「解約を確認できたか」を受け取り、将来の解約確率や解約リスクを計算します。
では、追跡が終わった対象を 0 に混ぜたまま学習すると、解約率の見積もりはどれだけ動くのでしょうか。本当はいつ解約する予定だったのかを保持した合成データを作り、答え合わせをしました。
先に結論
- 追跡が途中で終わった対象まで「未解約」の 0 にすると、学習データ上の解約率は低くなる。追跡切れが 68.5% の条件では、真の解約率 0.2480 に対して 0.2027 となり、相対で約18%低かった
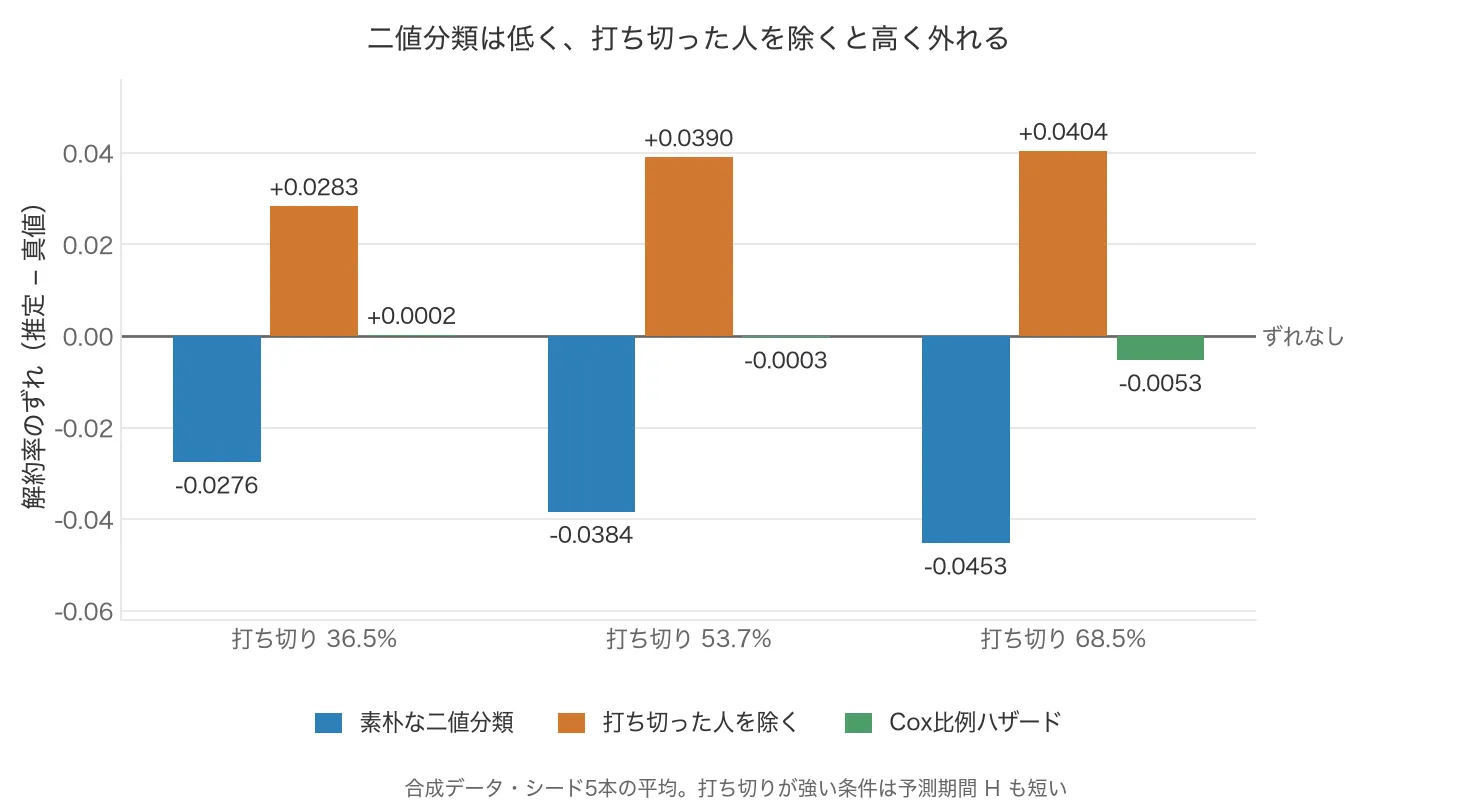
- 追跡切れが増えるにつれて、真の解約率との差は -0.0276、-0.0384、-0.0453 と広がった。ただし、条件ごとに予測期間の長さも異なる
- 追跡が切れた対象を学習データから除く方法では、差が +0.0283、+0.0390、+0.0404 となり、今度は解約率を高く見積もった
- 観測できた期間も学習に使う生存分析では、3条件とも真の解約率との差が平均 0.0053 以内。誰が先に解約するかという順位の精度も二値分類を上回った
- 検証範囲は、代表的な生存分析モデルである Cox 比例ハザードに合うよう作った合成データ 8,000 件と、追跡切れ3水準。乱数の初期値を変えた5回の平均で、Cox の差も1回ごとには -0.0182〜+0.0156 の幅がある
比べたのは3つの方法、採点は2種類の数字
どの方法にも共通の前提が、何日後・何か月後までの解約を当てるのかという予測期間です。以降はこれを H と書きます。今回は学習データの観測時間の中央値を当てました。
この H の内側で、追跡が切れた対象の扱いだけが違う3つのやり方を比べます。
- 素朴な二値分類: 特徴量と 0/1 のラベルを LightGBM へ渡し、期間 H までに解約する確率を予測する。H より前に追跡が終わった対象も 0 に含める
- complete case: H より前に追跡が終わり、正解ラベルを決められない対象を除いてから、同じ LightGBM を学習する
- Cox 比例ハザード: 特徴量、観測できた期間、解約を確認できたかという3種類の情報を使い、時点ごとの解約確率と対象間のリスク順位を求める
採点の1つ目は、解約する人数の見積もりが真値からどれだけ外れたかです。見積もった解約率から真の解約率を引いた値を「ずれ」と呼び、0に近いほど真値に近く、負なら過小、正なら過大な見積もりになります。
2つ目が C-index です。2つの対象を比べたとき、実際に早く解約した方へモデルが高いリスクを付けられた割合を表し、0.5 ならランダム、1.0 ならすべて正しい順序になります。今回は合成データに保存した真の解約時刻で順位を採点しました。
データは、追跡切れの割合が 36.5%・53.7%・68.5% になる3条件を用意しています。合成データを選んだのは、追跡が切れた対象についても本当はいつ解約する予定だったのかを保持でき、各方法の見積もりを真値と突き合わせられるからです。実測前に立てていた仮説は「素朴な二値分類は解約率を過小評価する」で、complete case については差が出る方向を決めていませんでした。
ひとつ断っておくと、この合成データは Cox に合う作りで、二値分類の側には追跡切れを補正する工夫を入れていません。手法全体の優劣を決める比較ではなく、追跡切れを考慮せずラベルを作ると何が起きるのかを見る比較です。
打ち切りを 0 に丸めると、解約率を系統的に低く見積もる
追跡が終わった対象を 0 に混ぜると、学習データの中で解約したことになっている人の割合が、本当の解約率より低くなります。3条件とも下振れし、追跡切れが多い条件ほど差が広がりました。
つまり、このラベルから解約する人数の規模を読むと、実際より小さい数字が出ます。モデル側の精度を上げる前に、ラベルの作り方を疑うほうが先です。
| 打ち切り率 | 方法 | C-index | 推定解約率 | 真の解約率 | ずれ | 学習件数 |
|---|---|---|---|---|---|---|
| 36.5% | cox | 0.7912 | 0.3960 | 0.3957 | +0.0002 | 5,600 |
| 36.5% | 素朴な二値分類 | 0.7649 | 0.3681 | 0.3957 | -0.0276 | 5,600 |
| 36.5% | complete case | 0.7643 | 0.4240 | 0.3957 | +0.0283 | 4,861 |
| 53.7% | cox | 0.7912 | 0.3265 | 0.3268 | -0.0003 | 5,600 |
| 53.7% | 素朴な二値分類 | 0.7610 | 0.2884 | 0.3268 | -0.0384 | 5,600 |
| 53.7% | complete case | 0.7618 | 0.3658 | 0.3268 | +0.0390 | 4,415 |
| 68.5% | cox | 0.7912 | 0.2427 | 0.2480 | -0.0053 | 5,600 |
| 68.5% | 素朴な二値分類 | 0.7546 | 0.2027 | 0.2480 | -0.0453 | 5,600 |
| 68.5% | complete case | 0.7531 | 0.2884 | 0.2480 | +0.0404 | 3,935 |
表の「推定解約率」の作り方は、3方法で完全にはそろっていません。二値分類の2行では学習データでラベルが 1 になった割合、Cox の行では検証データに対する予測確率の平均です。ここで見たいのはモデルが出す確率の正確さではなく、追跡切れを 0 に置き換えた時点で解約数の見積もりがどれだけ動くかなので、この3行を同じ種類のモデル出力としては比べないでください。
Cox の C-index が3条件とも同じ値で並ぶのは、3条件が同じ個体と同じ真の解約時刻を使い、変えたのが観測の終わる時刻だけだからです。順位の採点もその真の解約時刻に対して行っています。表の 0.7912 はシード5本の平均を小数第4位へ丸めた値で、試行ごとには 0.7815〜0.7952 の幅があります。
表のいちばん下にある3行が、追跡切れが最も多い条件です。素朴な二値分類の過小評価は、真の解約率のおよそ18%に当たります。予測期間 H より前に追跡が終わった対象は、その後 H までに解約していてもラベルが 0 になるため、学習データ上の解約率が真値を下回るわけです。検証前に置いた仮説と整合する結果でした。
一貫性も見ておくと、二値分類のラベル作成だけに注目した15試行(3水準×シード5本)のずれは、すべて負でした。同じシード間で水準を比べた15組のうち14組は、追跡切れが多い条件ほど真値との差が広がっています。
打ち切りを除く回避策は、逆向きにほぼ同じだけ外す
complete case については、差が出る方向を検証前に決めていませんでした。実測で起きたのは過小評価の解消ではなく、過大評価への反転です。ずれは3条件とも正へ転じ、外れる幅は素朴な二値分類とほぼ同じでした。
予測期間 H より前に追跡が終わった対象を除くと、手元に残るのは「H までに解約を確認できた対象」と「H を超えて追跡できた対象」です。早く解約した対象は前者へ入りますが、未解約として残るには H を超えるまで観測されていなければなりません。そのため、除外後のデータでは解約の割合が本来より高くなります。
減るのは精度だけではありません。68.5% 条件では学習件数が 5,600 件から 3,935 件へ、およそ30%失われました。
0 へ含める方法と除外する方法では、真値から外れる向きが反対です。しかし、どちらも「追跡が終わるまで解約していなかった」という期間の情報を使いません。この条件では、complete case は解約率のずれを直す回避策になりませんでした。
誰が先に解約するかの順位も、Cox が一貫して上だった
解約率の見積もりだけでなく、誰から先に手を打つべきかという並べ替えでも、Cox が3条件を通じて上回りました。施策の対象を上位から選ぶ使い方をするなら、順位が崩れないかどうかも見ておきたいところです。
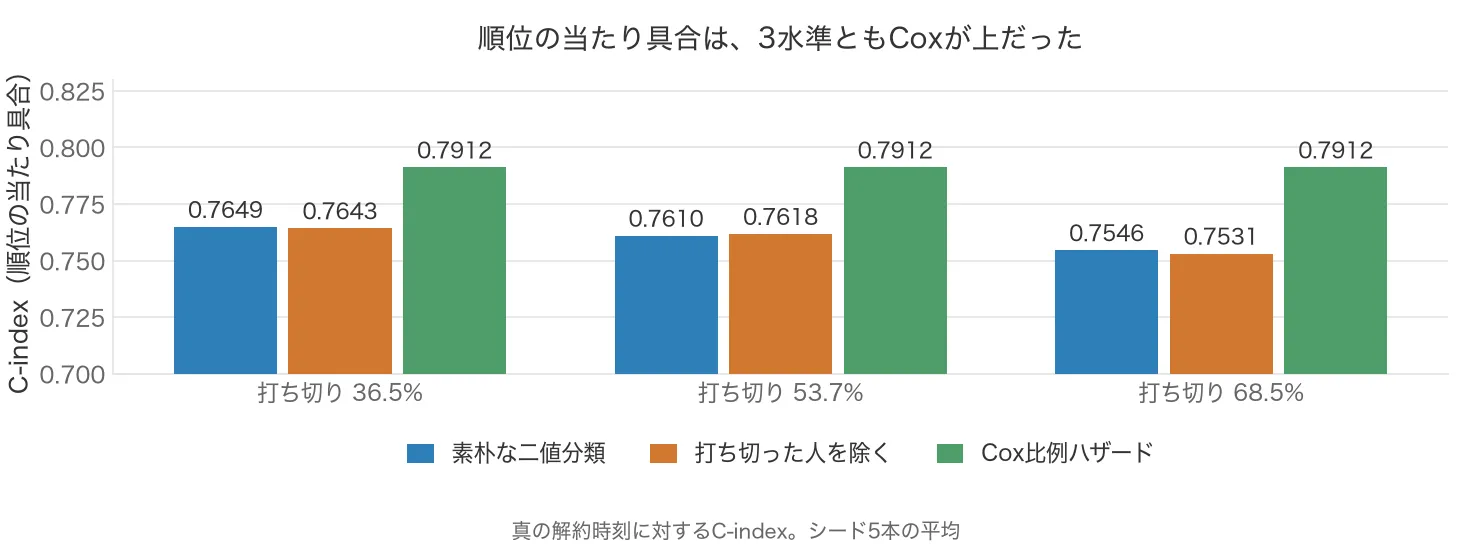
Cox の C-index は、表のとおり3条件で動きません。素朴な二値分類は追跡切れの増加に伴って 0.7649、0.7610、0.7546 と下がり、同じシード同士で比べても5本すべてで 68.5% 条件が 36.5% 条件を下回っています。complete case まで含めた最低値は 0.7531 で、Cox との差は 0.026〜0.038 でした。
差そのものは大きくありませんが、追跡切れが強くなっても Cox 側だけが劣化しなかったのは、追跡終了までの期間を学習に使えることが効いた可能性があります。ここは実測から直接は切り分けられていません。
実データでは、モデルより先に件数を数える
手元のデータでどちらを選ぶかは、次の順で確かめると判断できます。
- 何日後・何か月後までを予測するのか、期間 H を決める
- H より前に追跡が終わり、解約ラベルを確定できない対象を数える
- 求めたい答えが「H までに解約する確率」か「誰が先に解約するか」かを分ける
- ラベルを確定できない対象が含まれるなら、二値分類だけでなく生存分析も比較する
- Cox を候補にする場合は、特徴量の効果が時間とともに大きく変わらないという仮定を確認する
- complete case を試す場合も、除外後の件数と解約ラベルの割合がどう変わったかを確かめる
最初に見るべきなのは、モデルの種類ではなくラベルを確定できない対象の割合です。今回観測した約7%・12%・18%という相対差は、解約時刻と追跡終了時刻の作り方、予測期間 H の決め方に依存します。実データの解約率へ、そのまま足したり掛けたりできる補正値ではありません。
ラベルの作り方でこれだけ動くように、評価の数字は手続きしだいで変わります。学習と評価の分離が崩れたときにスコアがどう動くかは、データリーク5パターンを測った検証で測っています。
詳しい検証条件
特徴量4本から解約の起きやすさを決め、解約までの時間を表すためによく使われる Weibull 分布から真の解約時刻を作りました。これとは別に、追跡が終わる時刻をランダムに与えます。解約が先なら解約を確認でき、追跡終了が先なら打ち切りです。合成データなので、後者についても本当はいつ解約する予定だったのかを保持できます。
観測終了時刻の範囲を変えて用意したのが、打ち切り率 36.5%・53.7%・68.5% の3条件です。いずれも同じ個体と真の解約時刻を使い、観測終了時刻の分布だけを変えました。1条件 8,000 件のうち 5,600 件を学習、2,400 件を検証に割り当て、乱数の初期値を変えて5回実行しています。本文の打ち切り率と結果は、この5回の平均です。打ち切り3水準、シード5本、方法3種の計45回を実行し、保存したログから平均を求めました。
予測期間 H に学習データの観測時間の中央値を使ったため、打ち切りが強い条件ほど H も短くなります。真の解約時刻が同じでも、期間内の真の解約率は 0.3957 から 0.3268、0.2480 へ下がります。本文で示したずれの変化には、打ち切り率だけでなく予測期間の違いも含まれます。
ずれの計算は、試行ごとに推定解約率から真の解約率を引いてから平均する順序です。図1の棒はこの平均を表しています。
適用範囲と限界
今回の合成データでは、特徴量の影響が時間とともに大きく変わらないように解約時刻を作っています。これが Cox 比例ハザードモデルの名前にも含まれる「比例ハザード」の前提です。また、追跡が終わる時刻は、解約しやすさと無関係に決めました。どちらも Cox に都合のよい条件なので、実データで同じ差が出るとは限りません。たとえば解約しそうな対象ほど追跡も切れやすいデータでは、Cox の見積もりにもずれが生じます。
二値分類には、追跡が早く終わった対象の影響を調整する重み付けなどを加えていません。したがって、この結果だけで「二値分類より生存分析の方が優れている」とは判断できず、追跡切れを考慮せず 0 へ置き換えた実装との比較に限られます。二値分類2方法では学習ラベルの割合、Cox では検証データに対する予測確率の平均を使っており、学習後の分類モデルが出す確率の平均も未検証です。
数値は、乱数の初期値を変えた5回の平均です。個々の試行では Cox のずれが -0.0182〜+0.0156 の範囲にあり(C-index の試行別の幅は本文に示しました)、1回の学習結果が表の平均と一致するわけではありません。予測期間 H の決め方も学習データの観測時間の中央値という1通りだけで、条件ごとに H が異なります。追跡切れの割合だけを変えた比較ではない点は残ります。
比較対象は、素朴な二値分類、complete case、Cox 比例ハザードの3方法だけです。決定木を使うランダム生存フォレストや勾配ブースティング型の生存モデルは試していません。
サンプル実装
サンプル実装は、打ち切りが最も強い条件(約69%)について、3方法の解約率のずれと C-index を計算します。データの T_true は真の解約時刻、obs_time は実際に確認できた期間、event は解約を確認できたかを表します。通常の実データでは分からない T_true を合成データに残しているため、見積もりが真値からどれだけ外れたかまで採点できます。実行には lifelines と LightGBM が必要です(pip install lifelines==0.30.3 lightgbm==4.7.0)。
"""解約予測を二値分類で解くと、打ち切りのせいで何を間違えるのか。

合成データなので、観測が切れた人の「本当の解約時刻」も分かっている。
現場では見えない真値を使って、3つのやり方を採点する。
実行: python sample_churn.py
"""

import warnings

import numpy as np
import pandas as pd
from lifelines import CoxPHFitter
from lifelines.utils import concordance_index
from lightgbm import LGBMClassifier

warnings.filterwarnings("ignore")

N, SEEDS = 8000, [0, 1, 2, 3, 4]
FEATURES = ["x0", "x1", "x2", "x3"]
CENSOR_SCALE = 0.8  # 小さいほど早く観測が切れる(打ち切りが強い)


def make_data(seed):
    """Weibull 生存時間 + 一様打ち切り。真の解約時刻 T も保持する。"""
    rng = np.random.default_rng(seed)
    X = rng.normal(size=(N, 4))
    lin = 0.8 * X[:, 0] - 0.6 * X[:, 1] + 0.4 * X[:, 2]  # 大きいほど早く解約
    T = np.exp(-lin) * rng.weibull(1.4, N)               # 真の解約時刻
    C = rng.uniform(0, CENSOR_SCALE, N)                  # 観測が切れる時刻
    df = pd.DataFrame(X, columns=FEATURES)
    df["T_true"] = T
    df["obs_time"] = np.minimum(T, C)
    df["event"] = (T <= C).astype(int)                   # 1=解約を観測 0=打ち切り
    return df


def fit_clf(tr, y, seed):
    return LGBMClassifier(
        n_estimators=300, learning_rate=0.05, verbose=-1, random_state=seed, n_jobs=1
    ).fit(tr[FEATURES], y)


rows = []
for seed in SEEDS:
    df = make_data(seed)
    tr, te = df.iloc[: int(0.7 * N)], df.iloc[int(0.7 * N) :]
    H = float(np.median(tr["obs_time"]))          # 期間 H は実務で決められる値
    true_rate = float((te["T_true"] <= H).mean())  # 本来は見えない真の解約率

    # 1) 素朴な二値分類: 観測が切れた人も「解約せず」にしてしまう
    y_naive = ((tr["event"] == 1) & (tr["obs_time"] <= H)).astype(int)
    m = fit_clf(tr, y_naive, seed)
    rows.append(("naive_classification", concordance_index(
        te["T_true"], -m.predict_proba(te[FEATURES])[:, 1]),
        float(y_naive.mean()), true_rate, len(tr)))

    # 2) complete case: H より前に観測が切れた人を学習から落とす
    tr2 = tr[~((tr["event"] == 0) & (tr["obs_time"] < H))]
    y_cc = ((tr2["event"] == 1) & (tr2["obs_time"] <= H)).astype(int)
    m = fit_clf(tr2, y_cc, seed)
    rows.append(("complete_case", concordance_index(
        te["T_true"], -m.predict_proba(te[FEATURES])[:, 1]),
        float(y_cc.mean()), true_rate, len(tr2)))

    # 3) Cox: 打ち切りを打ち切りとして扱う
    cph = CoxPHFitter().fit(
        tr[FEATURES + ["obs_time", "event"]], duration_col="obs_time", event_col="event")
    risk = cph.predict_partial_hazard(te[FEATURES]).to_numpy()
    p_cox = 1.0 - cph.predict_survival_function(te[FEATURES], times=[H]).to_numpy().ravel()
    rows.append(("cox", concordance_index(te["T_true"], -risk),
                 float(np.mean(p_cox)), true_rate, len(tr)))

d = pd.DataFrame(rows, columns=["方法", "C-index", "推定解約率", "真の解約率", "学習件数"])
out = d.groupby("方法", sort=False).mean().round(4)
out["ずれ"] = (out["推定解約率"] - out["真の解約率"]).round(4)
print(f"打ち切り率 {1 - make_data(0)['event'].mean():.4f} / シード{len(SEEDS)}本の平均")
print(out.to_string())
concordance_index へ渡す時刻は、実際に確認できた期間を表す obs_time ではなく、真の解約時刻である T_true です。obs_time を使うと、追跡が切れた日を解約日として採点することになります。コードを実行すると次の結果になります。
実行結果
打ち切り率 0.6889 / シード5本の平均
                      C-index   推定解約率  真の解約率    学習件数      ずれ
方法
naive_classification   0.7546  0.2027  0.248  5600.0 -0.0453
complete_case          0.7531  0.2885  0.248  3935.2  0.0405
cox                    0.7912  0.2427  0.248  5600.0 -0.0053
出力された C-index、推定解約率、ずれは、本文表の打ち切り率 68.5% にある3行と一致します。complete case の末尾1桁だけが異なるのは、平均を求める前に丸めるか、求めた後に丸めるかによる差です。冒頭の 0.6889 はシード0の全 8,000 件、本文の 68.5% は学習データ 5,600 件についてシード5本を平均しており、集計対象が異なります。乱数の初期値とライブラリ版を検証環境にそろえれば、同じ出力を再現できます。
二値分類で解くなら、打ち切りの扱いを先に決める
モデルを選ぶ前に、予測期間 H より早く追跡が終わった対象を、ラベル上でどう扱っているか確認してください。未解約の 0 へ混ぜれば解約ラベルの割合が下がり、対象ごと除外すれば残るデータの構成が変わります。どちらを選んでも、追跡が終わるまでに観測できた時間は利用されません。
解約の有無を判定する期間を全対象で確保できるなら、二値分類はそのまま候補になります。期間内に追跡が切れる対象を含み、解約確率や解約までの時間を知りたい場合は、生存分析も同じデータで比較するのが出発点です。Cox を使うなら、特徴量の影響が時間とともに大きく変わらないかを確認し、この前提に合わなければ別の生存モデルへ広げます。
この検証から持ち出せるのは18%という補正値ではなく、追跡切れを無視したラベルの作り方が、解約率の見積もりを動かすという判断材料です。実データでは追跡切れの割合、予測したい期間、必要な出力、モデルが置く前提を並べて、二値分類と生存分析のどちらが目的に合うかを選びます。