
LightGBMを運用していると、モデルがどんな判断をしているのかを関係者へ説明したい場面が出てきます。ただ、数百本の木が組み合わさった本体をそのまま開いても、どの条件で予測が変わるのかを簡潔には示せません。
そこでよく使われるのが、本体の判断を1本の決定木で置き換えるやり方です。深さ3なら葉は最大8枚に収まるので、条件分岐を1枚の図として渡せます。このように複雑なモデルの振る舞いを単純なモデルで近似したものを、代理モデル(サロゲートモデル)と呼びます。決定木を使うときは、正解ラベルではなく、本体が出した予測を教師にして学習させます。
置き換えた木は、しかし本体とは別のモデルです。分岐がきれいに整理され、もっともらしい説明に見えても、本体が出していない判断をその木がしていることがあります。本体がクラス1と予測した行を、木のほうはクラス0と予測するかもしれません。その食い違いを確かめないまま「本体の判断ルール」として見せると、本体には存在しない判断を説明することになります。
実際に測ってみると、人が読める深さ3の木でさえ、条件によっては10件のうち約4件で本体と違う答えを返しました。合成データの二値分類で、本体と代理の木が同じ答えを返した割合を、木の深さとデータの複雑さを変えながら記録した結果です。
先に結論: 読める木の限界は、深さでは埋まらなかった
- 人が読める深さ3(葉8枚)の木が本体と同じ答えを返した割合は、条件が良くても0.84前後。2特徴の組み合わせだけで正解が決まり特徴量が20本ある条件では、平均0.6090
- この平均は安定しない。同じ設定の3回が0.48から0.81まで散る
- 同じ20特徴・交互作用1.0では、深さ12・葉415枚まで増やしても平均0.6692。深さ8の0.6729とどちらが上かは、今回のデータでは決められない
- この条件で深くして伸びたのは学習データ上の一致だけ(平均 0.7118 → 0.8420)。深さで進むのは過適合のほう
- 代理木の正解率が本体に近いことは、同じ判断をしている証拠にならない。正解率の差0.02の条件で、答えは約2割食い違う
- 射程は、合成データの二値分類・LightGBM本体の1設定・決定木の代理モデル・シード3本まで。深さ12より先は測っていない
深くしても頭打ちになるのは、あくまで交互作用が主役で特徴量が20本の条件です。主効果が中心のデータでは、表にある深さ6まで忠実度が上がっています。
代理木の点数は、正解率ではなく本体との一致率
忠実度は、本体と代理木が同じ行で同じ答えを返した割合です。0.84なら、残りの16%の行では2つのモデルの予測が食い違っています。この記事の主役の数字はこれひとつです。
まぎらわしいのが正解率との関係です。正解率は正解ラベルをどれだけ当てたかを見ますが、忠実度は本体と同じ予測を返したかを見ます。両方のモデルが同じくらいの頻度で正解していても、正解した行が互いに違えば、2つの判断は一致していません。代理木を本体の説明として使うなら、点数として要るのは忠実度のほうです。
もうひとつ、忠実度は代理木の学習に使っていない検証データで測ります。学習データだけで測ると、代理木が本体の予測を覚え込んだだけでも高い値が出るためです。
交互作用4水準・特徴量2水準・深さ8水準で測った
本体をLightGBM、代理モデルを決定木に固定し、次の3点を調べました。
- 人が読みやすい深さ3の代理木は、本体の判断をどこまで再現できるか
- 決定木を深くすると、検証データでの忠実度も上がるか
- 本体と代理木の正解率が近ければ、判断も一致していると言えるか
使ったのは合成データの二値分類です。正解を決める信号として、特徴量が単独で効く「主効果」と、2特徴の組み合わせで効く「交互作用」を用意しました。交互作用の割合は0・0.3・0.6・1.0の4水準で、割合が高いほど、単純な分岐だけでは表しにくい構造になります。
特徴量の本数も5本と20本に変えました。組み合わせの候補が増えたときに、浅い木が追随できるかを見るためです。代理木の深さは1・2・3・4・5・6・8・12の8水準、各条件を3つのシードで実行しました。
実験前に立てていた見込みは、「木の深さと交互作用の強さによって忠実度が急落し、読める説明が本体と別物になる領域がある」というものでした。どのあたりで別物になるのかを知りたくて、交互作用の割合を0から1.0まで動かしています。
結果を読む前にひとつだけ断っておくと、この実験は「忠実度がいくつなら説明に使ってよいか」という基準を決めていません。測ったのは一致の水準までです。実データや回帰、決定木以外の代理モデルを含む射程の話は、記事末の適用範囲と限界にまとめました。
読める深さでは、本体の判断の2割弱から4割が再現できない
深さ3の代理木は、条件が良ければ本体の8割強を再現しました。一方、複雑な条件では6割まで落ちます。同じ形式の図を見せていても、その1枚がどれだけ本体を写しているかは条件しだいで大きく変わる、ということです。
したがって、木の絵を作る前に、その条件での忠実度を実測しておくことになります。まずは特徴量5本の場合。
| 深さ | 葉の数 | 交互作用 0.0 | 0.3 | 0.6 | 1.0 |
|---|---|---|---|---|---|
| 1 | 2 | 0.7692 | 0.7531 | 0.6739 | 0.5156 |
| 2 | 4 | 0.7785 | 0.8185 | 0.7743 | 0.6682 |
| 3 | 8 | 0.8403 | 0.8408 | 0.7869 | 0.7740 |
| 4 | 16 | 0.8729 | 0.8735 | 0.8415 | 0.8039 |
| 6 | 約63 | 0.8939 | 0.8971 | 0.8583 | 0.8201 |
特徴量20本の場合はこうなります。
| 深さ | 葉の数 | 交互作用 0.0 | 0.3 | 0.6 | 1.0 |
|---|---|---|---|---|---|
| 1 | 2 | 0.7661 | 0.7351 | 0.6731 | 0.5321 |
| 2 | 4 | 0.7833 | 0.8150 | 0.7726 | 0.5628 |
| 3 | 8 | 0.8400 | 0.8244 | 0.7967 | 0.6090 |
| 4 | 16 | 0.8612 | 0.8615 | 0.8296 | 0.6118 |
| 6 | 約63 | 0.8696 | 0.8782 | 0.8190 | 0.6206 |
| 8 | 約184 | 0.8379 | 0.8357 | 0.7860 | 0.6729 |
| 12 | 約509 | 0.8010 | 0.7885 | 0.7399 | 0.6692 |
どちらの表も、葉の数の列は交互作用0.0 の条件の値です。葉の数は交互作用の水準によっても変わります。
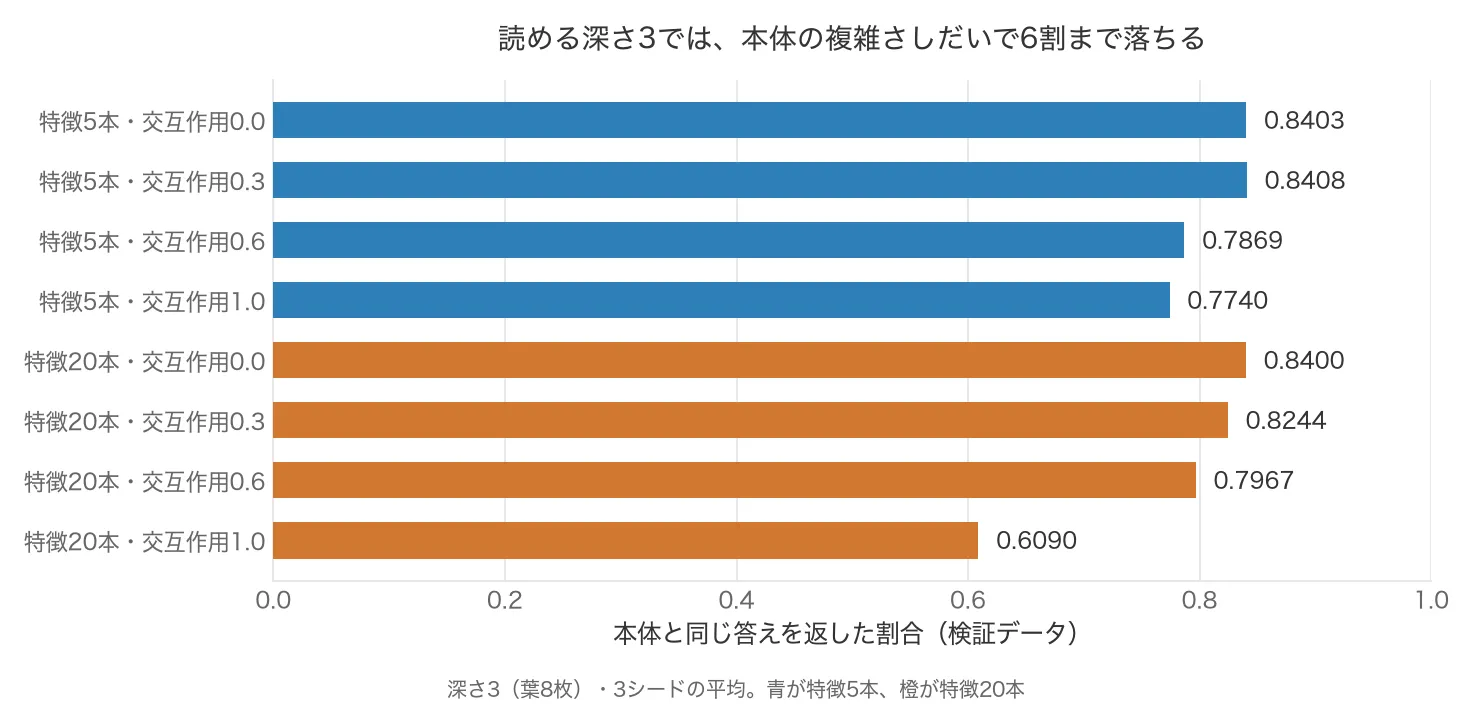
人に見せる代理木の目安は、ここでは深さ3(葉は最大8枚)としました。交互作用がない条件でも忠実度は0.84前後で、本体と異なる予測が約16%あります。交互作用だけで正解が決まる20特徴の条件では平均0.6090。言い換えると、10件のうち約4件で代理木と本体の答えが違います。
ただし、この平均値は安定していません。交互作用1.0・20特徴・深さ3の忠実度は、3回の実行で0.5350・0.4842・0.8079に分かれました。同じ設定でも、本体を約8割再現する回と、半分程度しか再現できない回があります。
対照的に、交互作用0.0では0.8417・0.8396・0.8388で、3回の幅は0.003でした。特徴量数と深さが同じでも、交互作用の有無で振れ方がここまで違います。つまり0.6090は、振れの大きい3回をならした値です。1回実行したときの見込み値としては読めません。
いちばん厳しいのは表の右上です。深さ1・交互作用1.0・20特徴の忠実度は0.5321で、二値予測の一致率としてはコイン投げとほとんど変わりません。この木を本体の判断ルールとして見せる根拠は、この数字からは出てきません。
深くして伸びたのは、学習データ側だけ
読みやすさをいったん脇へ置き、木を深くした場合を見ます。20特徴・交互作用1.0では、深さ6で0.6206、深さ8で0.6729、深さ12で0.6692でした。深さ8と12の平均はほぼ同じです。実行ごとの値もそれぞれ0.55〜0.79、0.58〜0.74に散らばっており、今回の3シードから優劣は決められません。深さ3から12まで増やしたときの平均差は約0.06です。
この条件では、葉の数が深さ8で約129枚、深さ12で約415枚になります。深さ3の約8枚から50倍以上です。1枚の図として人が読むという当初の目的からは、すでに外れています。
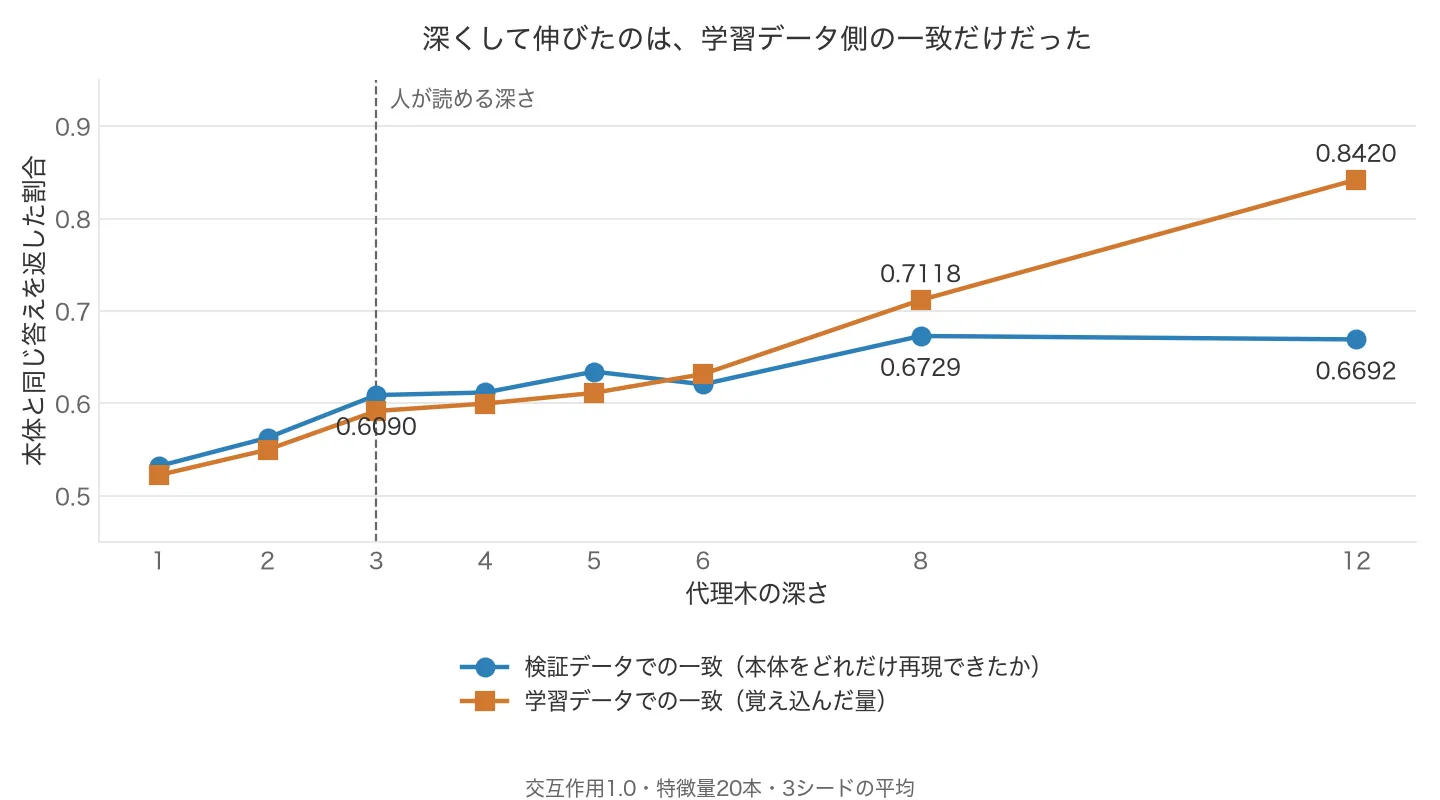
一方、学習データ上の忠実度は0.7118(深さ8)から0.8420(深さ12)へ伸びました。3シードとも同じ向きです(0.632→0.762、0.691→0.824、0.812→0.940)。代理木は学習データ上の本体予測を細かく覚えたものの、その改善が検証データへ移らなかった形になります。深くして進んだのは、本体の再現ではなく過適合のほうです。
少なくとも深さ8から12の範囲では、深くすることが検証データ上の忠実度向上にはつながりませんでした。ただし実行ごとの動きはそろっていません。前掲の深さ3の3本は、深さ12でそれぞれ0.5825・0.6842・0.7408になりました。伸びた回も下がった回もあります。深さ12より先は測っていないため、さらに深い木の挙動は不明です。
特徴量20本でも、主効果が中心なら深さ3の忠実度は変わらなかった
特徴量が多いほど代理木は苦しくなる、とひとくちには言えませんでした。効いたのは、多数の特徴から交互作用を表現しなければならない条件だけです。
交互作用1.0を特徴量数で比べると、深さ6の忠実度は5特徴で0.8201、20特徴で0.6206でした。平均では約0.2の差です。ただし3回のうち1回は0.8225対0.8008で、差は0.02にとどまりました。ここでも平均だけでは振れを捉えられません。
交互作用が弱い側では、差はほとんど出ていません。交互作用0.0・深さ3では、5特徴が0.8403、20特徴が0.8400。深さ6でも差は0.024です。交互作用0.6・深さ3では、20特徴のほうがわずかに高くなっています。人が読みやすい深さ3に限れば、特徴量数が増えただけで一貫して忠実度が下がったわけではありませんでした。
交互作用1.0で差が開いた理由としては、探索する組み合わせ数の増加が考えられます。2特徴の組み合わせは、5特徴なら10通り、20特徴なら190通りです。浅い木では必要な分岐を表しきれなかった可能性があります。ただし原因を切り分ける実験はしていないので、ここは結果からの推測です。
正解率が近くても、同じ判断とは限らない
正解率と忠実度の違いがいちばん見やすく出たのは、20特徴・交互作用0.6・深さ3(葉8枚)の条件です。
- 代理木の正解率: 0.6782
- 本体の正解率: 0.6996
- 忠実度: 0.7967
正解率の差は0.02しかありません。それでも忠実度は0.7967で、約2割の行では予測が食い違いました。3回の実行でも、正解率の差は0.01・0.03・0.02、忠実度は0.81・0.79・0.79と同じ傾向です。5特徴・交互作用1.0・深さ3でも、正解率の差は0.02、忠実度は0.7740でした。
これは矛盾ではありません。前に書いたとおり、正解した行がずれていれば、正解率は近いまま忠実度だけが下がります。0.02という差は、2つのモデルが同じ行で同じ判断をしている保証にはなりません。
平均値の組をそのまま関係として読めない条件もあります。20特徴・交互作用1.0・深さ6では、平均正解率が代理木0.5668、本体0.6801、忠実度0.6206でした。ただしこの条件はシード間の振れが大きく、正解率の差は0.16・0.18・-0.004、忠実度は0.52・0.54・0.80です。比較的安定して確認できたのは、先ほどの「正解率差0.02でも忠実度0.7967」という条件のほうになります。
正解率だけを見て代理木を採用すると、本体と異なる判断をしている行を見落とします。
代理木を渡すときに、一緒に出しておく数字
代理木を作ったら、最初の作業は検証データでの一致率の計算です。 正解率は本体の性能を見るときに並べておけば足ります。前節のとおり、正解率の差がごくわずかな条件でも、予測は約2割食い違っていました。
図を提示するときは、代理木の深さや葉の数とともに、検証データでの忠実度を示します。忠実度0.84の木に付ける説明は、「検証データで約84%一致した近似」です。「本体の判断ルール」と言い切ると、一致しなかった行の存在が消えます。今回の深さ3では、条件によって平均0.61から0.84、個別の実行では0.48まで下がりました。
忠実度が不足していても、木を深くすれば解決するとは限りません。 20特徴・交互作用1.0では、葉を約8枚から約415枚へ増やしても、平均の上昇は約0.06でした。検証データで必要な水準に届かないなら、さらに複雑な木を説明として採用するより、代理木を使わない判断や別の説明方法を検討する余地があります。行ごとの寄与を出すSHAPやLIMEはその候補ですが、どちらを使うかで「いちばん効いた特徴」は変わります。SHAPとLIMEを同じ1,080行で比べた検証では、第1位が一致したのは33.3〜46.1%でした。
特徴量数だけを基準にするのも不十分です。交互作用1.0・深さ6では5特徴と20特徴で平均約0.2の差が出た一方、交互作用0.0から0.6の深さ3では差が0.02以内でした。本体の判断が特徴の組み合わせにどれだけ依存しているかも、代理木の再現しやすさに関係します。
そもそも代理モデルを介さず、最初から説明しやすい形で学習するモデルを選ぶ道もあります。EBMとLightGBMを比べた検証では、実データ3件のROC-AUCの差はいずれも0.012以下でしたが、1回の学習にかかる平均時間はEBMが73.00秒、LightGBMが0.116秒でした。
詳しい検証条件
データは1条件あたり8,000件です。特徴量は標準正規分布から作り、主効果は先頭3特徴の線形結合、交互作用は2特徴の積を2組使っています。両方をそれぞれ標準化してから交互作用の割合で混ぜているので、割合を変えても信号全体の強さは揃います。生成規則の全体は、後掲のコードがそのまま実験の縮小版になっています。
本体のLightGBMは木300本・学習率0.05で、特別な調整はしていません。データの3割を検証用に取り分け、代理木は残りの学習データ上で本体の予測を教師にして学習させています。忠実度は学習データと検証データの両方で記録し、本文の表に載せたのは検証データ側です。
葉の数は、深さだけでなく交互作用の水準によっても変わります。本文の表に載せた葉の数は交互作用0.0 の条件の値で、深さ8で約184枚、深さ12で約509枚です。記事の後半で追いかけた交互作用1.0・特徴量20本の条件は、同じ深さでも葉が少なく、それぞれ約129枚と約415枚でした。
載せた値の来歴も書いておきます。特徴量2水準 × 交互作用4水準 × 深さ8水準 × シード3本の192回を1回の実行で回し、そのログを集計しました。表の各セルはシード3本の平均で、本文中に「3回の実行で」と書いた並びは、その3本の個別値です。
合成二値分類と決定木の代理モデルに限られる
- 対象は合成データ・二値分類・LightGBM本体の1設定です。実データ、回帰問題、他の本体モデルでは検証していません
- 代理モデルは決定木だけです。線形モデルやルールリストなど、別の代理モデルは比較していません
- 忠実度は予測ラベルの一致率です。予測確率の近さは測っていないため、ラベルは同じでも確信度が異なるケースを区別できません
- どの忠実度なら説明に使えるかは決めていません。必要な水準は用途や誤説明の影響によって変わります
- 深さ12では葉が約415〜509枚になりました。実務で見せる木というより、測定範囲の上限として置いた条件です
- 交互作用1.0・20特徴ではシード間の振れが大きく、深さ3の忠実度は0.48から0.81まで開きました。平均値を1回の実行結果の目安にはできません
- 測ったのは深さ12までです。それより深い木の忠実度は分かりません
本体の予測を教師にして忠実度を測る
以下のコードでは、本体の複雑さと代理木の深さを変えながら、忠実度と正解率を記録します。代理木の教師には本体の予測を使い、忠実度は学習データと検証データの両方で測ります。
"""「複雑なモデルを浅い決定木で説明する」代理モデルは、どこまで本体に忠実か。

代理モデルは本体の**予測**を教師にして学習させる。したがって採点すべきは
「正解 y をどれだけ当てるか」ではなく「本体と同じ答えを返すか(忠実度)」。
忠実度は学習に使っていない検証データで測る。
実行: python sample_surrogate.py (192 回の学習。検証環境のマシンで同じ計算に約2分)
"""

import numpy as np
import pandas as pd
from lightgbm import LGBMClassifier
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

N, SEEDS = 8000, [0, 1, 2]
DEPTHS = [1, 2, 3, 4, 5, 6, 8, 12]
INTERACTION_SHARES = [0.0, 0.3, 0.6, 1.0]
N_FEATURES = [5, 20]


def make_data(n_feat, inter_share, seed):
    """主効果と2次交互作用の混合比を変えて二値ラベルを作る。"""
    rng = np.random.default_rng(seed)
    X = rng.normal(size=(N, n_feat))
    main = X[:, :3] @ np.array([1.5, -1.0, 0.8])
    inter = 2.0 * (X[:, 0] * X[:, 1]) + 1.5 * (X[:, 1] * X[:, 2])
    # 主効果側と交互作用側をそれぞれ標準化してから混ぜる(強さの比を制御するため)
    main = (main - main.mean()) / main.std()
    inter = (inter - inter.mean()) / inter.std()
    logit = (1 - inter_share) * main + inter_share * inter
    logit = 2.0 * (logit - logit.mean()) / logit.std()
    return (pd.DataFrame(X, columns=[f"x{i}" for i in range(n_feat)]),
            rng.binomial(1, 1 / (1 + np.exp(-logit))))


rows = []
for n_feat in N_FEATURES:
    for s in INTERACTION_SHARES:
        for seed in SEEDS:
            X, y = make_data(n_feat, s, seed)
            Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=seed)
            black = LGBMClassifier(n_estimators=300, learning_rate=0.05, verbose=-1,
                                   random_state=seed, n_jobs=1).fit(Xtr, ytr)
            bb_tr, bb_te = black.predict(Xtr), black.predict(Xte)

            for d in DEPTHS:
                # 代理木は本体の予測を教師に学習する(正解 y ではない)
                surr = DecisionTreeClassifier(max_depth=d, random_state=seed).fit(Xtr, bb_tr)
                rows.append({
                    "特徴量": n_feat, "交互作用": s, "深さ": d,
                    "忠実度(検証)": (surr.predict(Xte) == bb_te).mean(),
                    "忠実度(学習)": (surr.predict(Xtr) == bb_tr).mean(),
                    "代理木の正解率": (surr.predict(Xte) == yte).mean(),
                    "本体の正解率": (bb_te == yte).mean(),
                    "葉の数": surr.get_n_leaves(),
                })
        print(f"特徴量={n_feat} 交互作用={s} 完了", flush=True)

d = pd.DataFrame(rows).groupby(["特徴量", "交互作用", "深さ"]).mean().round(4)
print("\n--- 忠実度(検証) ---")
print(d["忠実度(検証)"].unstack("交互作用").to_string())
print("\n--- 葉の数 ---")
print(d["葉の数"].unstack("交互作用")[0.0].round(1).to_string())
print("\n--- 特徴量20本・交互作用1.0 の詳細 ---")
print(d.loc[(20, 1.0)].to_string())
fit(Xtr, bb_tr) の第2引数は、本体の予測 bb_tr です。ここを正解ラベル ytr に変えると、本体を近似する代理モデルではなく、正解を学習する別の決定木になります。
実行結果のうち、特徴量20本・交互作用1.0 の詳細だけを抜粋します。
実行結果(抜粋)
--- 特徴量20本・交互作用1.0 の詳細 ---
    忠実度(検証)  忠実度(学習)  代理木の正解率  本体の正解率       葉の数
深さ
1    0.5321   0.5224   0.4975  0.6801    2.0000
2    0.5628   0.5499   0.5210  0.6801    4.0000
3    0.6090   0.5918   0.5608  0.6801    7.6667
4    0.6118   0.5998   0.5628  0.6801   15.0000
5    0.6344   0.6114   0.5674  0.6801   28.0000
6    0.6206   0.6317   0.5668  0.6801   49.0000
8    0.6729   0.7118   0.5967  0.6801  129.3333
12   0.6692   0.8420   0.5876  0.6801  415.3333
抜粋した20特徴・交互作用1.0の忠実度は、本文の表と同じ値です。乱数シードを固定しています。ただし、深さ12のように葉が数百枚になる条件では、環境によって小数第3位付近や葉の数がわずかに変わる場合があります。
代理木を説明に使う前に確認すること
「決定木の代理モデルはどこまで信頼できるか」への答えは、条件しだい、というものでした。主効果が中心のデータなら深さ3の木で本体の8割強を再現できます。組み合わせだけで正解が決まる20特徴の条件では6割前後まで落ち、深さを4倍にしても検証データ側はほとんど動きませんでした。伸びたのは学習データ上の一致のほうです。
自分が代理木を外へ出す立場なら、深さと葉の数の隣に検証データでの忠実度を置き、シードを変えた再実行の幅も添えます。今回の難しい条件では、同じ設定の3回が半分程度から8割まで散りました。1回の値だけを渡すと、受け取った側はその木がどれだけ当てになるかを読み違えます。学習データ側の忠実度だけが上がっていないかも、同時に見る場所です。
決めていないのは基準のほうです。忠実度がいくつなら説明として通るかは、用途や誤説明の影響によって変わります。深さ12より先も測っていないため、さらに深い木で検証側の一致が動き出すのかは分かりません。