
売上が落ち始めた日はいつか。センサーの挙動が変わったのはどこか。時系列のデータを眺めて「ここから様子が変わった」と言い当てる作業は、監視やアラートの土台になります。この作業を自動でやるのが変化点検知で、Python なら ruptures というライブラリを入れれば数行で動きます。
ライブラリを開くと、手法がいくつも並んでいます。Pelt、Binseg、Window、Dynp。解説記事を読むと計算量や理論的な性質の違いが説明されていて、決めるべきなのは手法だ、という話に見えます。
ところが実際に動かすと、変化点の本数を指定しない3つ(Pelt・Binseg・Window)には pen という引数が要ります。変化点を1本増やすことに対する罰の重さで、これが小さければ検出は増え、大きければ減ります。しかもこの引数に既定値はなく、値を渡さなければ predict は動きません。手法をどう選ぶかは議論されているのに、この引数をいくつにすればよいかは、動かしてみるまで判断材料がありませんでした。
先に結論: 効いていたのは手法名ではなくペナルティ
- 結果を左右するのは手法よりペナルティ。同じ Pelt でも、ノイズ1.0 のときペナルティ1で F1(見逃しと誤検出をまとめた0から1の採点)0.275、ペナルティ20で 0.931。5シードすべてで2.8倍以上の開き
- ただしペナルティを外した側では手法差も大きい。ノイズ2.0・ペナルティ1 の F1 は 0.196〜0.758 に散る
- 小さすぎるペナルティの失敗は過剰検出として出る。真の変化点が平均4.4本のところ、平均 37.0 本(シード別は35〜39本)を検出した条件があった
- Window はペナルティに鈍感で、1から50まで平均 F1 は 0.758〜0.921。ただしこれはシード5本の平均で、個別の走行では取りこぼし側に 0.333 まで落ちた例がある
- ノイズが増えると最良のペナルティも上がる。Pelt の最良はノイズ0.5でペナルティ20と50が同値、ノイズ1.0で20、ノイズ2.0で50
- ペナルティの数値は信号のスケールに依存し、この記事の 5・20・50 を他のデータへ持ち出せない。自分のデータでは、標準化したうえでペナルティを振り、検出本数が想定のオーダーに入る値を選ぶ
- 適用条件: 平均が階段状に変わる1次元の合成信号1,500点、ノイズ3水準×5シード、
ruptures1.1.10。採点は真の位置との許容ずれ15点。分散・トレンドの変化と実データは対象外
表に出てくる言葉
この先の表は、行が手法とペナルティの組み合わせ、列がノイズの強さで並びます。中身は F1 か検出本数です。手法の内部で何が起きているかまでは踏み込まないので、Python で時系列の配列を扱えれば読み進められます。
- ペナルティ:
predict(pen=...)に渡す値です。表では 1・5・20・50 の4水準が並びます - F1: 取りこぼしと誤検出の両方を1つの数値にまとめた採点です。0から1で、1が満点になります
- 検出本数: その設定が返してきた変化点の数です。今回の信号では真の変化点が平均4.4本なので、そこが物差しになります
- ノイズ: 各点に独立に加えた正規分布の乱数(いわゆるホワイトノイズ)の標準偏差です。0.5・1.0・2.0 の3水準で、大きいほど段差が埋もれて見つけにくくなります。各区間の平均は標準偏差3.0の分布から引いているので、ノイズ1.0 は区間どうしの高さの散らばりより一回り小さい揺れが全点に乗った状態です
手法は4つ出てきます。前の3つがペナルティを渡す仲間で、最後の Dynp だけは変化点の本数を渡して使います。
- Pelt: 全体を厳密に最適化する
- Binseg: 二分探索で順に切っていく
- Window: 窓を滑らせて前後の差を見る
- Dynp: 本数を先に決めて、その数に分割する
位置が分かっている信号を作って、手法とペナルティを総当たりした
使ったのは合成信号です。1,500点の時系列を作り、途中の数箇所で平均値がジャンプする階段状の構造にしました。ジャンプの位置は乱数で決めますが、その位置をこちらは知っているので、検出結果を正解と突き合わせて採点できます。真の変化点は平均で 4.4 本になりました。
この階段にノイズを重ね、標準偏差を3水準に振っています。各条件でシードを5本回し、平均を取りました。
比べたのは本数を知らない3手法(Pelt・Binseg・Window)と、ペナルティ4水準(1・5・20・50)の総当たりです。手法とペナルティのどちらが効くかを見るのが目的なので、片方を固定せずに全部の組み合わせを回しました。あわせて、変化点の本数を最初から教えてある手法も別枠で測り、上限の目安にしています。
採点は F1 と検出本数の2つです。検出した位置が真の位置から15点までのずれなら当たり、と数えて F1 を出します。本数も一緒に出したのは、F1 だけを見ていると、失敗が「見つけられない」なのか「見つけすぎ」なのかが分からないためです。
なお、この作り方では段差がノイズに埋もれた変化点が正解に混ざるので、どの手法でも F1 は満点に届きません。理由は後半の「詳しい検証条件」で説明します。
ペナルティを外すと、成績も失敗の形も変わった
同じ Pelt で、ペナルティによって F1 が3倍以上動く
ペナルティを変えるだけで、同じ手法・同じデータの成績が別物になりました。手法名を比べる前に、この引数を決めるほうが先です。
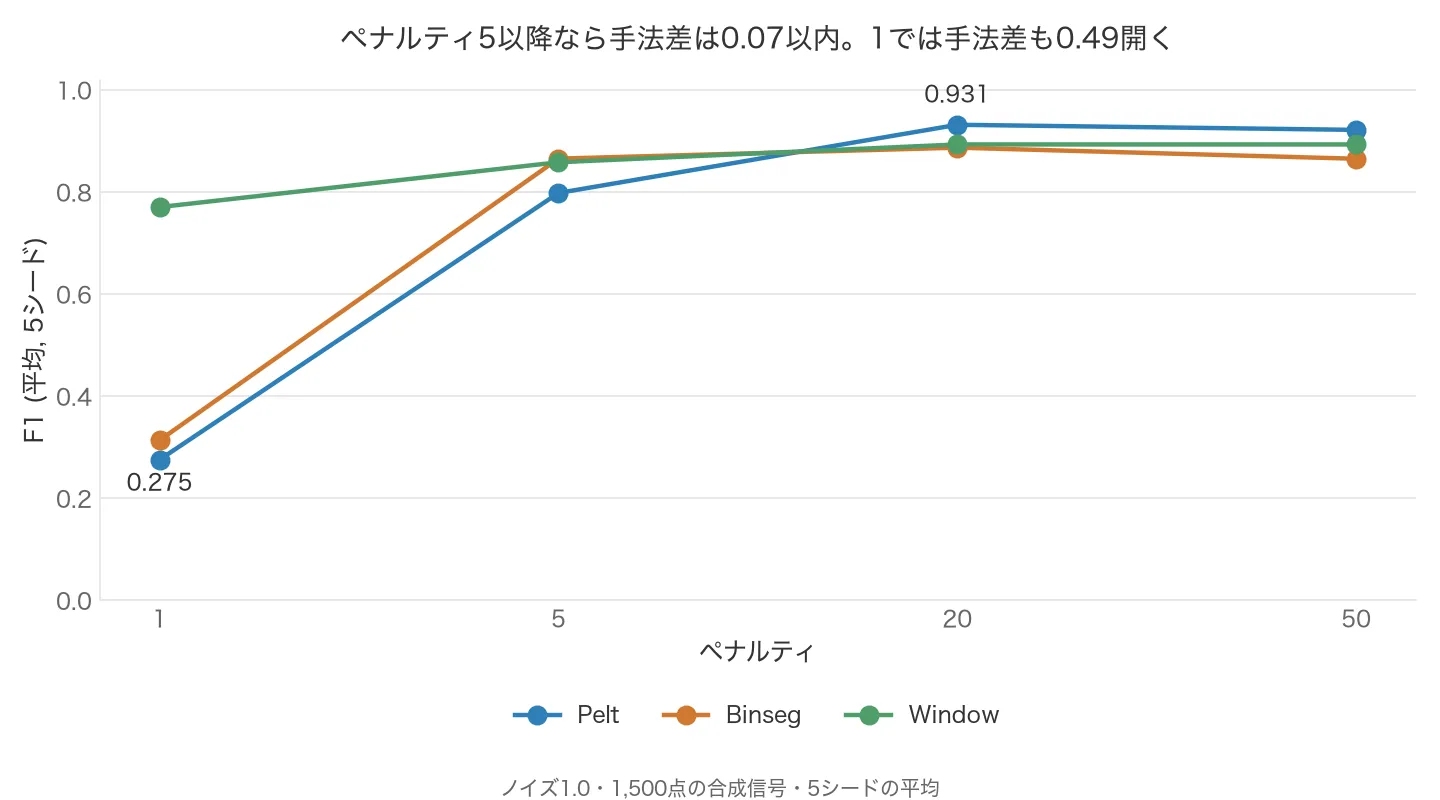
本数を知らない3手法の F1 です。太字は各列の最良値を示します。
| 手法 | ペナルティ | ノイズ0.5 | ノイズ1.0 | ノイズ2.0 |
|---|---|---|---|---|
| Pelt | 1 | 0.698 | 0.275 | 0.203 |
| Pelt | 5 | 0.910 | 0.798 | 0.290 |
| Pelt | 20 | 0.949 | 0.931 | 0.735 |
| Pelt | 50 | 0.949 | 0.921 | 0.821 |
| Binseg | 1 | 0.782 | 0.313 | 0.196 |
| Binseg | 5 | 0.910 | 0.865 | 0.346 |
| Binseg | 20 | 0.931 | 0.887 | 0.750 |
| Binseg | 50 | 0.905 | 0.865 | 0.781 |
| Window | 1 | 0.878 | 0.770 | 0.758 |
| Window | 5 | 0.921 | 0.858 | 0.790 |
| Window | 20 | 0.921 | 0.893 | 0.814 |
| Window | 50 | 0.921 | 0.893 | 0.788 |
同じ Pelt の同じデータで、ノイズ1.0 のとき F1 は 0.275 から 0.931 まで動きます。ペナルティを 1 から 20 に変えただけで3倍以上です。一方、ペナルティを 20 に揃えて手法だけを比べると、0.931・0.887・0.893 で、差はずっと小さくなります。
つまり、手法名の比較記事を読んで一方に決めても、最初に決めたペナルティを固定したままなら、その決定はほとんど意味を持ちません。
小さすぎるペナルティの失敗は「見つけすぎ」として出る
F1 が低いとき、そこで何が起きているのかを検出本数で見ます。
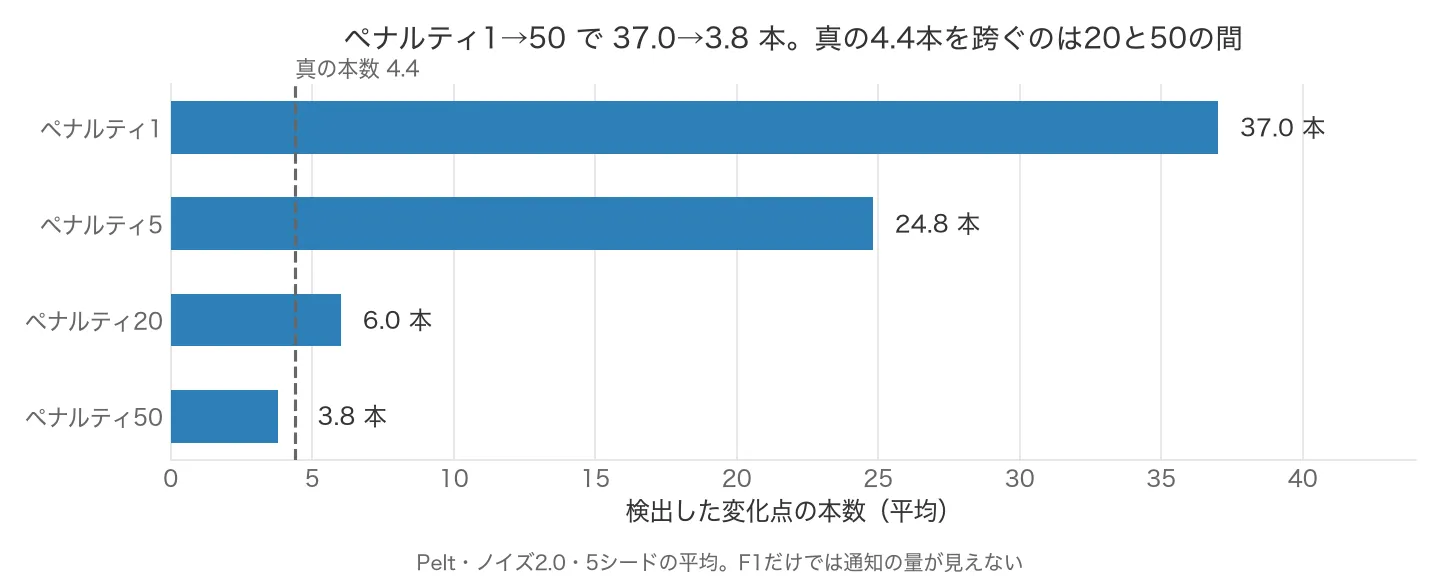
真の変化点は平均 4.4 本です。太字は Pelt がペナルティ1 で最も過剰に検出した2条件で、前の表とは太字の意味が逆になります。
| 手法 | ペナルティ | ノイズ0.5 | ノイズ1.0 | ノイズ2.0 |
|---|---|---|---|---|
| Pelt | 1 | 8.8 | 27.6 | 37.0 |
| Pelt | 20 | 4.0 | 4.2 | 6.0 |
| Binseg | 1 | 6.6 | 24.4 | 34.4 |
| Window | 1 | 4.8 | 6.0 | 5.2 |
| Window | 20 | 3.8 | 3.6 | 4.4 |
ペナルティ1 の Pelt は、ノイズ2.0 の条件で平均 37.0 本を検出していました。シード別では 38・35・39・36・37 本で、真の 4.4 本に対して8倍以上です。ノイズ1.0 でも平均 27.6 本。この条件で F1 が低い正体は、変化点を見逃していることではなく、ノイズの揺れを片端から変化点と呼んでいることでした。
実運用では、この違いが決定的です。1,500点をまとめて分割するたびに、35本から39本の変化点が返ってきます。この量の通知を運用が捌けるかどうかまでは測っていませんが、私はこの設定を本番の閾値に置く気になりませんでした。F1 が 0.203 という数字より、「37本鳴る」という形の方が、その判断には効いています。
だから F1 だけを見て設定を選ぶのは危険です。検出本数を一緒に出しておけば、真の本数のオーダーから外れた設定はその場で除外できます。
なお、ペナルティ1 では手法の差も開きます。ノイズ1.0 での F1 は Pelt の 0.275 に対し Window が 0.770 で、罰を軽くしすぎた領域に限れば手法の選択も効いています。「設定が先」と言えるのは、ペナルティが妥当な範囲に入ってからの話です。
Window はペナルティに鈍感だった
Window の4行を縦に見ると、ペナルティ1から50まで F1 は 0.758 から 0.921 の範囲に収まっています。検出本数も 3.4 から 6.0 で安定していました。Pelt は 0.203、Binseg は 0.196 まで落ちる条件があるのと対照的です。ノイズを固定して見ても、ペナルティによる振れ幅は最大で 0.770 から 0.893(ノイズ1.0)にとどまります。
窓を滑らせて前後の差を見るという仕組み上、窓の幅そのものが検出の細かさを決めているためだと考えられます。ペナルティは候補を絞る役割にとどまり、支配的な要因になりにくい。ここは今回の実測から機序まで確かめたわけではないので、可能性としての説明です。
ただしこの範囲は、シード5本の平均どうしの幅です。1回ごとの走行を保証する値ではありません。シード単位まで下りると、ノイズ2.0・ペナルティ50 で真の5本に対し1本しか検出せず、F1 が 0.333 まで落ちた走行があります。
この走行の誤検出は0本で、失敗の出方は見つけすぎではなく取りこぼしでした。前の節で見た過剰検出とは逆向きの壊れ方で、しかも通知が飛ばないぶん気づきにくい形です。
実務的には、設定を詰める余裕がないなら Window、という読み方ができます。ただしこれは値を外したときの落ち込みが浅いという話で、窓幅という別の設定は残ります。また、条件ごとの平均では、最良の値を選んだ Pelt に3水準とも届いていません。差はノイズが小さい側ほど開くので、手間をかけられるなら、ノイズが小さい側ほど Pelt でペナルティを探す価値があります。どちらを既定にするかは、走行単位まで下りたうえで後半にまとめます。
ノイズが増えると、最良のペナルティも上がる
Pelt の最良値がどこにあるかを追うと、ノイズ0.5 ではペナルティ20と50が同値(ともに 0.949)、ノイズ1.0 ではペナルティ20(0.931)、ノイズ2.0 ではペナルティ50(0.821)です。ノイズ2.0 でペナルティ20 のままだと 0.735 で、同じノイズでの最良より 0.086 低くなります。
ノイズが大きいほど偶然の揺れが変化に見える機会が増え、それを抑えるには、変化点を1本追加する罰を重くするしかありません。
もっとも、同じ表はもう一つの読み方も許します。ペナルティ50 に固定した場合の F1 は 0.949・0.921・0.821 で、3水準とも最良から 0.010 以内です。水準ごとに選び直すのが最良であるのは確かですが、選び直せないなら大きめに寄せて固定するという手も、この表の範囲では成り立ちます。
監視の対象が季節や施策で変わる場合、この点は運用の設計に関わります。設定を見直す仕組みを作るより先に、固定する値を大きめに寄せるほうが安く済みます。
本数を知っていても完全にはならない
変化点の本数を教えてある手法は、届く上限の目安になるはずだと考えて別枠で測りました。その期待は、この信号では裏切られています。
| 手法 | F1 ノイズ0.5 | F1 ノイズ1.0 | F1 ノイズ2.0 |
|---|---|---|---|
| Dynp(本数既知) | 0.91 | 0.91 | 0.84 |
| Binseg(本数既知) | 0.91 | 0.87 | 0.75 |
本数という強い情報を与えても、F1 は 0.75 から 0.91 でした。ノイズ水準ごとに最良のペナルティを選んだ Pelt は 0.949・0.931・0.821 なので、ノイズ0.5 と 1.0 では Pelt が上、ノイズ2.0 では Dynp の 0.84 が Pelt の最良をわずかに上回ります。ただしこの Pelt の値は、正解と突き合わせてノイズごとに一番良かったペナルティを後から採ったものです。本数を渡しただけの Dynp と同じ土俵ではありません。
失点の出方は手法をまたいで似ていました。ノイズ0.5 で Dynp が満点を落としたのはシード1とシード4で、誤検出ゼロだった同じ条件の Pelt(ペナルティ20)が取りこぼしたのも、同じ2本のシードです。どちらの手法も1本ずつ取りこぼす形でした。
共通して当てにくい変化点があった可能性が高いものの、ログに残しているのは本数と precision・recall だけで検出位置は記録していないので、同じ変化点を落としたかどうかは確かめていません。段差がノイズに埋もれた変化点が正解に混ざっているためと考えられますが、機序を切り分けて測ったわけではありません。
現場では、ペナルティを振ってから検出本数で外す
まず振るのはペナルティ: 信号を標準化したうえで、Pelt でペナルティを 5・20・50 と振り、検出本数が想定のオーダーに収まるものを選んでください。物差しになるのは「変化点は何本くらいあるはずか」の見積もりなので、自分のデータについてはそこから決めることになります。
時間がないときの既定は、この5シードでは決着しませんでした: Pelt をペナルティ50 に寄せて固定するか、同じペナルティ50 で Window を使うか。条件ごとの平均では Pelt@50 が 0.949・0.921・0.821 で Window@50 の 0.921・0.893・0.788 を上回ります。走行ごとに突き合わせてもノイズ2.0 の平均差は +0.033 と小さく、5走行のうち1走行では 0.250 対 0.333 と逆転します。言えるのは、ノイズ0.5 と 1.0 では5走行とも Pelt@50 が Window@50 を下回らなかったこと、ノイズ2.0 では標本5本では順位が決まらないこと、の2点です。なお Window の窓幅は100に固定してあり、幅の決め方は測っていないので、Window を選んでも詰めなくてよい設定が1つ増えるわけではありません。
検出をそのままアラートにするなら、見るのは F1 より検出本数: 通知の量は、運用が回るかどうかを直接決めます。真の本数のオーダーから外れた設定は、F1 を読む前に外せます。
ノイズの水準が変わりうる運用では、大きめ側に固定: 小さめに固定したままノイズが増えると劣化が大きく、大きめの50に寄せておけば、今回の3水準では見直さなくても最良からわずかな差に収まりました。水準ごとに選び直せるならそれが最良です。振れ幅が今回の3水準を超える現場では、この保証は確かめ直す必要があります。
詳しい検証条件
信号は1,500点の区分定数です。変化点の候補を6本引いたうえで、近すぎるものを落としました。最小の区間長30点の2倍より近い候補は捨てるという規則で、間隔が短すぎて分離できない問題にしないためです。この処理を通した結果、真の変化点はシード平均で 4.4 本になっています。
区間ごとの平均は、標準偏差3.0の正規分布から独立に引いています。隣り合う区間の値が偶然近いと、段差がノイズより小さい「真の変化点」が正解ラベルに残ります。そこはどの手法でも原理的に当てられません。この記事の F1 が満点に届かないのは、一部はこれが理由です。
ノイズは各点に独立な正規乱数を加える形で、標準偏差を 0.5・1.0・2.0 の3水準に振りました。ジャンプの大きさに対してノイズが大きくなるほど、変化点は見つけにくくなります。シードは0から4までの5本を回し、表の値はその平均です。
手法は3つとも l2 モデル(平均の変化を想定するコスト関数)で、最小の区間長は30点に固定しました。Window の窓幅は100です。ここへペナルティ4水準(1・5・20・50)を掛けて総当たりにしています。
本数を教えてある側は、Dynp と Binseg に真の本数を渡した場合です。ペナルティを渡す手法と同じ条件ではないので、表も分けました。上限の目安として読むためのものです。
採点では、検出した位置と真の位置を、15点までのずれなら正解として1対1に対応づけ、取りこぼしと誤検出の両方を反映した F1 を出します。あわせて検出した本数そのものも記録しました。数値はすべて、実際に実行して保存したログを集計したものです。
適用範囲と限界
- 平均が階段状に変わる構造だけです。 分散の変化やトレンドの変化は今回のモデルでは想定しておらず、別の設定が要ります
- 1次元の信号のみです。 多変量の変化点検知は測っていません
- 合成データのみです。 正解ラベルを持つ実データが必要なため実データでの検証は行っていません。実際の時系列は区分定数からもっと離れているはずです
- 採点は許容ずれ15点という基準に依存します。 基準を緩めれば数値は上がり、厳しくすれば下がります
- ペナルティの数値はこの信号のスケールでの値です。
rupturesの l2 コストは残差の二乗和なので、ペナルティの意味は信号の分散と系列長に依存します。今回はノイズsd 0.5〜2.0・段差sd 3.0・1,500点の設定で、この上での 5・20・50 です。スケールの違うデータ(未標準化の売上やセンサー値)に同じ数値をそのまま持ち込んでも意味を持ちません。自分のデータで使うなら、まず標準化したうえで、検出本数が想定のオーダーに入る値を探してください - ペナルティは4水準の飛び飛びの探索です。 最適値を詰めたわけではないので、表の最良値が到達可能な上限ではありません
- Window の窓幅は100固定です。 ペナルティに鈍感だという結論は、窓幅が適切だったことに依存している可能性があります
- 正解ラベルに、段差がノイズより小さい変化点が混ざっています。 区間の平均を独立に引いているためで、どの手法の F1 も、この分だけ天井が下がっています
同じ採点をコピーして回すコード
3手法 × ペナルティ4水準を、正解つきの合成信号で採点します。F1 と検出本数の両方を出しているところが要点です。
"""変化点検知は、手法とペナルティでどれだけ結果が変わるか。

区分定数の信号を合成して変化点の位置を既知にし、ruptures を正解つきで採点する。
F1 だけでなく「何本検出したか」も出す(失敗は過剰検出として現れるため)。
実行: python sample_cpd.py (手元では数秒で終わる)
"""

import numpy as np
import pandas as pd
import ruptures as rpt

N_POINTS, N_BKPS, MIN_SIZE, TOLERANCE = 1500, 6, 30, 15
NOISE_SDS = [0.5, 1.0, 2.0]
PENALTIES = [1.0, 5.0, 20.0, 50.0]
SEEDS = [0, 1, 2, 3, 4]


def make_signal(noise_sd, seed):
    """区分定数の信号。真の変化点の位置を一緒に返す。"""
    rng = np.random.default_rng(seed)
    bkps = np.sort(rng.choice(
        np.arange(MIN_SIZE * 2, N_POINTS - MIN_SIZE * 2), size=N_BKPS, replace=False))
    # 近すぎる変化点は落とす(検出不能な問題にしないため)
    keep = [bkps[0]]
    for b in bkps[1:]:
        if b - keep[-1] >= MIN_SIZE * 2:
            keep.append(b)
    bkps = np.array(keep)

    means = rng.normal(0, 3.0, len(bkps) + 1)
    sig = np.empty(N_POINTS)
    edges = np.r_[0, bkps, N_POINTS]
    for i in range(len(edges) - 1):
        sig[edges[i] : edges[i + 1]] = means[i]
    return sig + rng.normal(0, noise_sd, N_POINTS), list(bkps)


def f1_score(true_bkps, pred_bkps):
    """許容ずれ TOLERANCE 以内で1対1に対応づけて F1 を出す。"""
    pred = [p for p in pred_bkps if p < N_POINTS]
    unmatched, tp = list(true_bkps), 0
    for p in sorted(pred):
        hit = [t for t in unmatched if abs(t - p) <= TOLERANCE]
        if hit:
            unmatched.remove(min(hit, key=lambda t: abs(t - p)))
            tp += 1
    prec = tp / len(pred) if pred else 0.0
    rec = tp / (tp + len(unmatched)) if (tp + len(unmatched)) else 0.0
    return (2 * prec * rec / (prec + rec) if (prec + rec) else 0.0), len(pred)


rows = []
for noise in NOISE_SDS:
    for seed in SEEDS:
        sig, true_bkps = make_signal(noise, seed)
        algos = {
            "Pelt": rpt.Pelt(model="l2", min_size=MIN_SIZE).fit(sig),
            "Binseg_pen": rpt.Binseg(model="l2", min_size=MIN_SIZE).fit(sig),
            "Window": rpt.Window(width=100, model="l2", min_size=MIN_SIZE).fit(sig),
        }
        for pen in PENALTIES:
            for name, algo in algos.items():
                f1, n_pred = f1_score(true_bkps, algo.predict(pen=pen))
                rows.append({"手法": name, "ペナルティ": pen, "ノイズ": noise,
                             "F1": f1, "検出本数": n_pred})
    print(f"ノイズ {noise} 完了", flush=True)

d = pd.DataFrame(rows)
print(f"\n真の変化点は平均 {np.mean([len(make_signal(1.0, s)[1]) for s in SEEDS]):.1f} 本")
for col in ["F1", "検出本数"]:
    print(f"\n--- {col} ---")
    print(d.pivot_table(index=["手法", "ペナルティ"], columns="ノイズ", values=col)
           .round(3).to_string())
1対1の対応づけは、同じ真の変化点に重ねて検出した分を二重に得点しないためのものです。ただし今回は最小区間長を30点に固定しているので、検出どうしは必ず30点以上離れます。許容ずれ15点と組み合わせると、1つの真の変化点に2本以上が同時に当たる状況はほぼ起きません。この対応づけが効いてくるのは、真の変化点がもっと密に並ぶ問題の方です。
実行するとこの出力が出ます。
実行結果
真の変化点は平均 4.4 本

--- F1 ---
ノイズ                 0.5    1.0    2.0
手法         ペナルティ
Binseg_pen 1.0    0.782  0.313  0.196
           5.0    0.910  0.865  0.346
           20.0   0.931  0.887  0.749
           50.0   0.905  0.865  0.781
Pelt       1.0    0.698  0.275  0.203
           5.0    0.910  0.798  0.290
           20.0   0.949  0.931  0.735
           50.0   0.949  0.921  0.821
Window     1.0    0.879  0.770  0.758
           5.0    0.921  0.858  0.790
           20.0   0.921  0.893  0.814
           50.0   0.921  0.893  0.788

--- 検出本数 ---
ノイズ               0.5   1.0   2.0
手法         ペナルティ
Binseg_pen 1.0    6.6  24.4  34.4
           5.0    4.4   5.4  18.2
           20.0   4.2   4.2   5.2
           50.0   4.0   4.0   3.8
Pelt       1.0    8.8  27.6  37.0
           5.0    4.4   5.8  24.8
           20.0   4.0   4.2   6.0
           50.0   4.0   3.8   3.8
Window     1.0    4.8   6.0   5.2
           5.0    3.8   4.0   4.8
           20.0   3.8   3.6   4.4
           50.0   3.8   3.6   3.4
本文の F1 の表とは36セル中34セル、検出本数の表とは15セルすべてが一致します。残る2つ(Binseg・ペナルティ20・ノイズ2.0 の 0.749、Window・ペナルティ1・ノイズ0.5 の 0.879)は末尾1桁だけ違います。本文の表は集計を小数4桁に丸めた値をさらに3桁で書いていて(0.7495 が 0.750 になる)、このサンプルは平均を直接3桁に丸めています(0.749)。二重に丸めるかどうかの差です。乱数の種を固定しているので、手元でも同じ値が出ます。
まとめ
変化点検知で結果を決めていたのはペナルティでした。同じ Pelt の同じデータで、F1 は3倍以上動きます。比較の順序としては、手法名より設定が先です。手法名の前に確かめることがある、という構図は時系列予測でも同じでした。ARIMA・指数平滑をナイーブ予測と比べた検証では、平均誤差で勝つ手法が、週次では4割の系列で素朴なコピーに勝てていません。
F1 の値だけでは、それが「見逃している」のか「鳴りすぎている」のかは分かりません。真の本数の8倍を超える検出という形で見て初めて、その設定が実運用で採用できないことがはっきりします。指標の値を現場での見え方に翻訳できたのは、本数を一緒に出したからでした。
確信をもって言えるのは、平均が階段状に変わる1次元の合成信号について、許容ずれ15点という採点基準のもとまで。実データはこれよりずっと汚く、分散やトレンドも動きます。次に測るなら、分散の変化を含む信号で同じ設定がどこまで通用するかです。監視の現場で「変わった」と言われるのは、平均だけとは限りません。