
社内の規程やマニュアルをAIに検索させると、関係のありそうな資料は並ぶのに、肝心の1件が上位に出てこないことがあります。次の一手として選ばれやすいのは道具の入れ替えです。検索に使うモデルを新しいものへ替える、後段の並べ替えを足す、質問文を言い換えて何度も検索する。
ただ、同じ「精度が低い」に見える症状の中には、別々の失敗が混ざっています。答えの根拠がそもそも候補に入っていない取りこぼしと、候補には入っているのに下へ沈んでいる順位のずれです。前者は並べ替えでは直りません。渡されていない文書は、後ろの工程で拾い直せないためです。
このシリーズでは、チャンク分割、埋め込みモデル、ハイブリッド検索、リランカー、クエリ拡張を1工程ずつ測ってきました。並べてみると、手を足したのに狙った側が動かない例が出ています。複数の検索結果を混ぜるRRFは順位の指標を押し上げましたが、上位5件へ正解が入る割合の差は確認できませんでした。語彙のずれを埋めるつもりで足したクエリ拡張にいたっては、順位の指標が単体検索を下回り、1問あたりの時間だけが秒単位へ伸びています。
どこが壊れているのかを先に数えれば、この空振りは減らせます。この記事では、評価用の質問ごとに3つの数字を取り、チャンク分割、一次検索(埋め込みモデルや検索方式の選定がここに当たります)、RRFやリランカーによる並べ替えのどこから見直すかを決める手順をまとめます。数え方のコードも載せるので、手元の検索基盤へつなげば同じ診断ができます。
先に結論
- 手法を足す前に、答えの根拠を丸ごと含むチャンクが検索対象にあるかを数える。無ければモデルを替えても取り返せない(分割の設定だけで、検索前に消える質問は0問にも20問にもなった。JSQuAD由来500問)
- 根拠はあるのに上位20件へ入らないなら候補を集める一次検索、候補には入るのに順位が低いなら並べ替え(RRFやリランカー)が見直し先
- 質問ごとに残すのは、根拠チャンクの有無、Recall@5・@20(上位5件・20件に正解が入った質問の割合)、最初の正解が1位・2〜5位・6〜20位・圏外のどこにあるか
- 土台は5本ともJSQuAD由来で、同一条件の通し実験ではない。試す順序は仕組みと運用コストから決め、効果は自分の評価質問で測り直す
この記事の前提知識と、診断で使う言葉
必要なのは、RAGを一度動かした経験と、評価に使える質問が手元にあることです。検索の評価指標や統計に詳しくなくても最後まで進めます。RAGの各工程と、そこで起きる失敗の種類そのものはRAGとは?検索・生成の仕組みと精度が落ちる4つの場所で説明しています。
検索側で失敗し得る場所は3つに分かれます。根拠を含むチャンクを作る段階、そのチャンクを候補へ入れる段階、候補の中で上位へ並べる段階です。平均の「精度」をひとつ眺めているだけでは、このどこで落ちたのかは分かりません。
診断で何度も出てくる言葉には、記事の中での役割だけ添えておきます。
- 取りこぼしと順位: 正解を候補へ入れられたかと、候補の中で正解を上へ置けたか。同じ「精度が低い」を分ける2つの見方です。
- 一次検索: 質問を受け取って最初の候補を集める処理です。埋め込みによる意味検索(dense検索)や、語の一致で順位を付けるBM25がここに入ります。
- Recall@5・Recall@20: 評価質問のうち、上位5件(20件)の中に正解チャンクが現れた質問の割合です。取りこぼしの側を測ります。
- nDCG@10とMRR@10: 正解が何位に出たかを点数にした指標です。上位へ来るほど大きくなり、順位の側を測ります。
- 根拠スパン: 回答の根拠が原文のどこにあるかを、文書IDと開始・終了位置で表したものです。この記事の正解判定はこの範囲を単位にします。
改善箇所は、質問ごとの3つの数字で絞り込む
Recall@5が低いという事実だけでは、次に触る場所は決まりません。検索前に根拠が欠けているのか、20位以内にも取得できていないのか、6〜20位にはあるのに上位5件へ届かないのかで、見直す箇所は同じではないからです。そこで、評価用の質問ごとに次の3点を記録します。
- 回答の根拠を丸ごと含むチャンクが存在する質問数
- 正解チャンクが上位5件と上位20件に入る割合
- 最初の正解が1位、2〜5位、6〜20位、圏外のどこにあるか
Recall@5だけでなく@20まで併記するのは、「20位以内にも取得できない質問」と「6〜20位にはある質問」を分けるためです。前者は候補を作る側、後者は並べ替える側の問題になります。nDCG@10とMRR@10の平均値も同じで、それだけでは個々の失敗を追えません。最初の正解順位を4区分で残しておけば、どの質問が取りこぼされ、どの質問が並べ替えだけで改善し得るかを後から確認できます。
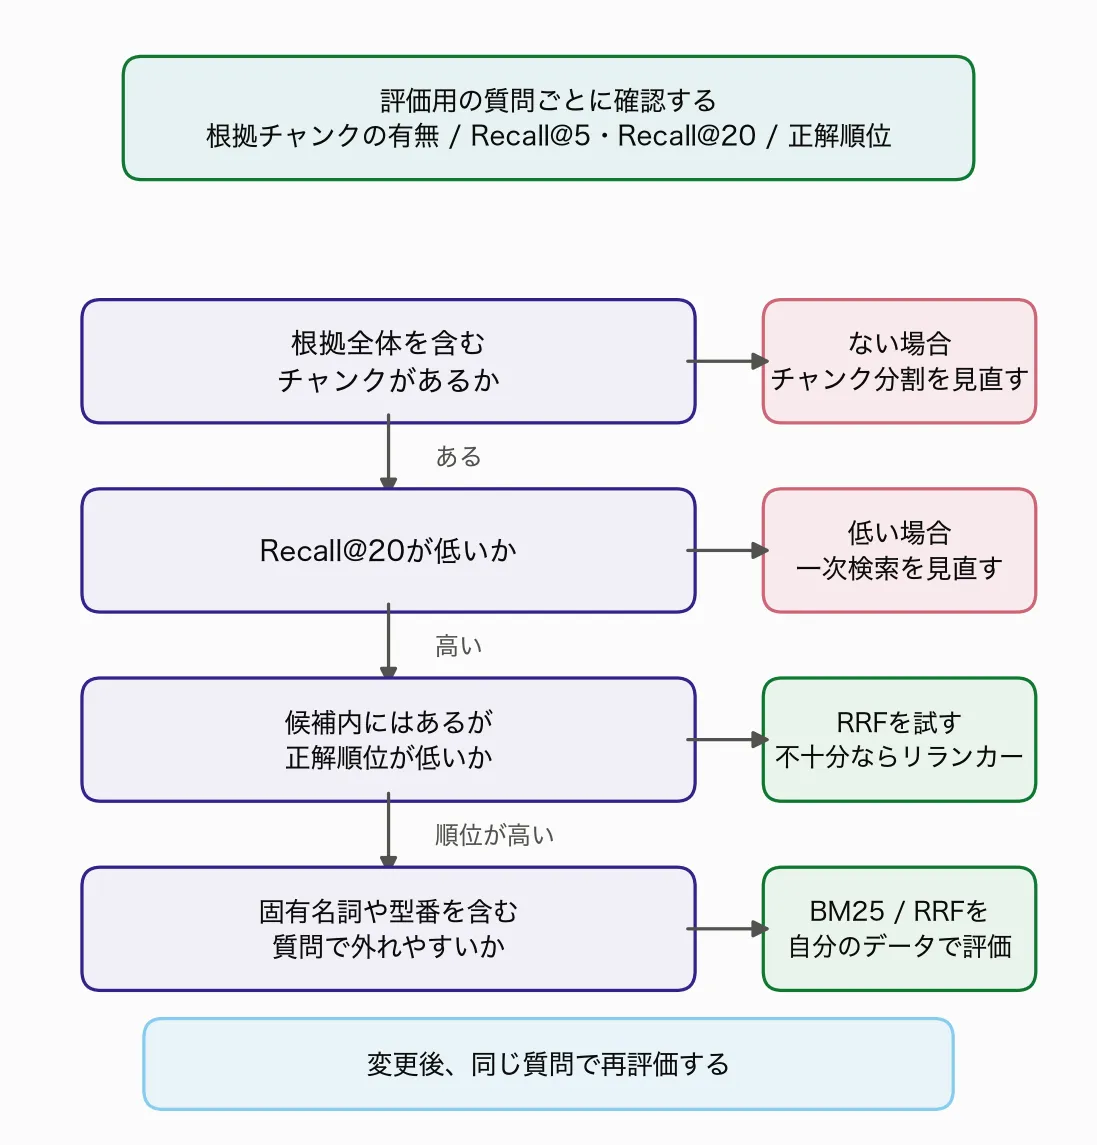
数えるのに必要な材料は3つです。評価用の質問、回答根拠と検索対象チャンクの原文位置、そして検索結果のチャンクIDです。
ここで正解と数える単位には注意が要ります。「1972年」「東京」のような短い回答文字列ではなく、回答の根拠となる原文範囲を単位にします。評価データに文書IDと原文中の開始・終了位置を持たせ、同じ文書のチャンクがその範囲全体を含む場合だけ正解とします。回答文字列だけを照合すると、別の文脈に現れた同じ語まで正解として数えてしまい、1つ目の数字がいつも「問題なし」を返すようになるためです。
診断の中核は、根拠の包含判定と最初の正解順位
入力は、質問と根拠範囲を持つEvaluationCase、チャンクIDと原文位置を持つChunk、質問に対して順位付きチャンクIDを返すretrieve関数の3種類です。上の3点は、この入力から機械的に数え上げます。返り値には集計値だけでなく質問別の判定も含まれるため、圏外になった質問を後から読み返せます。
1つ目の数字「根拠チャンクの有無」を決めるのは、次の包含判定だけです。同じ文書のチャンクが根拠範囲を丸ごと含むときに正解とみなします。
def contains_span(chunk: Chunk, span: EvidenceSpan) -> bool:
    """同じ文書で、チャンクが根拠範囲を丸ごと含むかを返す。"""

    return (
        chunk.document_id == span.document_id
        and chunk.start <= span.start
        and span.end <= chunk.end
)この判定は検索を実行しなくても計算できるため、モデルを動かす前に1つ目の数字を得られます。残り2つは、検索結果の上から順に同じ包含判定を当て、最初に正解した順位から導きます。その数え上げのコードは、記事末の全文と一緒に置きました。特定の検索基盤には依存させていないので、retrieveにあたる部分を手元の実装へ差し替えれば動きます。
原文の文字位置を用意できない場合は、根拠となる文や段落の全文と文書IDで代用できます。ただし、根拠として登録する範囲が長いほど、1つのチャンクに全体が収まる条件は厳しくなります。その結果、「根拠チャンクなし」が実態より増え、診断が大きなチャンクを選ぶ方向へ偏る点には注意が必要です。
ここから先の数値は、公開済み5記事の個別実験で得たものです。工程をまたいでRecall値を横並びには比較しません。5本がどんな土台で測ったものかは、後半の「5本の実測が立っている土台」にまとめました。
検索前に根拠が消えているなら、モデルではなく分割を直す
検索対象の中に正解チャンクがなければ、埋め込みモデルやリランカーを変更しても根拠は取得できません。ここでの失敗は検索の性能ではなく、検索に渡す材料の側で起きています。
最初に試す変更は分割方法です。根拠範囲とチャンクの原文位置だけで判定できるので、モデルを動かす前に確認できます。
チャンク分割の8構成を比べた検証では、根拠全体を含むチャンクがなかった質問は、100文字・重なりなしで20問、200文字で5問、400文字で3問でした。重なり20%の4構成と段落分割では0問です。つまり分割の設定だけで、検索が始まる前に消える質問が0問にも20問にもなります。
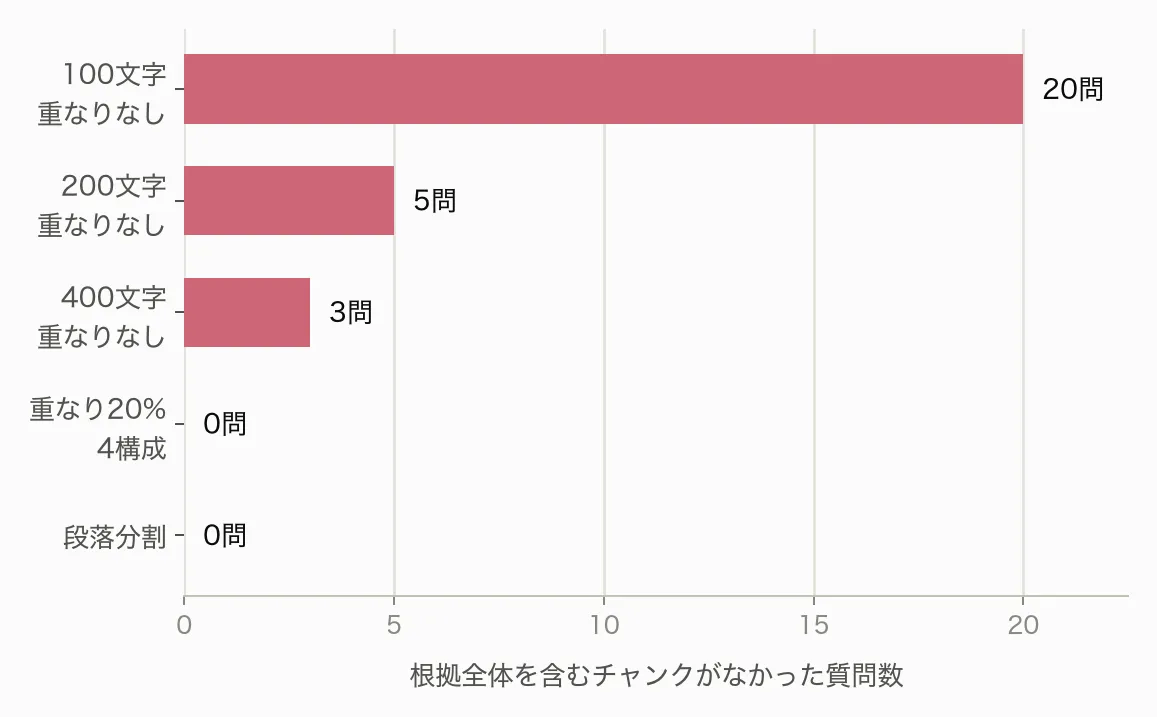
この頻度は、短い根拠が多いJSQuAD(日本語の抽出型質問応答データ)由来500問での結果です。重なりより長い根拠は、20%を入れても分断されます。
順位の側では、段落境界を残した構成のnDCG@10が0.8947、固定長で最も高かった400文字・重なり20%が0.8515でした。ただしRecall@5で差が残った5ペア、つまり複数の組を同時に比べる影響を割り引いた後まで残った比較は、すべて100文字・重なりなしが関係するものです。100文字の重なりを0%から20%へ変えた比較には差が残らなかったため、この実験だけから「段落分割なら取りこぼしも減る」とは判断できません。
分割を疑ったときの最初の作業は、指標を比べることではありません。根拠チャンクが存在しない質問を実際に読み、分断されている位置に合う分割方法を試すことです。
20位以内にも入らないなら、候補を作る側を調べる
根拠チャンクが存在しても20位以内に取得できない質問が多い場合は、候補を作る段階、つまり埋め込みモデルや検索設定を調べます。リランカーでは救えません。一次検索が渡していないチャンクは、後段で並べ直せないためです。
ただしこの段階は、モデルを新しくすれば取りこぼしが減る、という手当てではありません。日本語埋め込み9モデルの比較では、Recall@5の36ペア中、同じ割り引きの後も差が残ったのは6ペアだけでした。6ペアはすべて、静的埋め込みモデル(static-embedding-japanese。速度は桁違いに速いかわりに、検索3指標が9モデル中で最下位だったモデル)が関係する比較です。
残る6モデル、つまりruri-v3-130m・310m・30m、GLuCoSE、e5-large、bge-m3の間には、Recall@5の差が残っていません。この中でどれを選んでも、取りこぼしの側の違いは区別できなかったことになります。
この実測から選べるのは、Recall@5が低かった静的埋め込みのような外れの構成を掴んでいないかの確認と、精度を区別できないモデルを次元数や速度で絞ることです。取りこぼしを減らす手当てとしては、この節に材料がありません。
候補数を増やす方法もありますが、その効果も、複数の工程を続けて変更したときの改善幅も測っていません(記事末の未検証事項参照)。上流を直した後は、同じ質問でRecall@20を取り直します。
候補には入るのに上位へ来ないなら、RRFとリランカーを比べる
20位以内には正解が入るのに、1位や上位5件へ届かない質問が多ければ、次の確認対象は候補内の順位です。候補プールとは一次検索が後段へ渡す文書の集合で、リランカーはその中だけを並べ替えます。
この段階で測るのは順位の改善であって、取りこぼしの改善ではありません。Recall@20の上積みを期待せず、正解順位とnDCG・MRRの変化を見ます。
dense検索を使っているならRRFから試す
BM25・dense・RRFを比べた検証では、dense単体にRRF融合を足すとnDCG@10が+0.013、MRR@10が+0.017上がりました。RRFは、複数の検索結果を元のスコア尺度に依存せず、順位から1つのリストへ統合する方法です。ここでもRecall@5の差は確認できず、BM25単体を基準にした順位改善も確認できていません。動いたのは順位の側だけ、と読むのが実測に近い姿です。
BM25の検索は1問あたり1.5ms、索引構築は0.22秒でした。対象は1,145段落の全数検索で、索引構築時間は1回だけの計測です。リランカーが候補20件だけを処理したのに対し、BM25の検索量は文書件数とともに増えます。大規模コーパスではコスト関係が逆転する可能性があり、BM25用の索引を別に管理する負担も残ります。
RRFで足りなければリランカーを測る
日本語リランカー5種の検証では、5種中4種でnDCG@10が+0.023〜+0.031、MRR@10が+0.030〜+0.041上がりました。候補20件の並べ替えに加わった時間は406〜2704msです。最も軽いruri-smallは406msでしたが、順位改善を確認できなかった唯一のモデルでもあり、処理が軽い順に効果が高いわけではありませんでした。
RRFよりリランカーの点推定が大きく見えても、両者を同じ比較の中で検定した結果ではありません。RRFを先に試す順序は、今回の小規模コーパスで追加検索が軽かったことに基づきます。方式の採否には、平均指標だけでなく、変更後に正解順位が下がった質問の件数と内容も必要です。
固有名詞や言い換えで外れる質問は、方式別に分けて測る
固有名詞や型番の完全一致が必要な質問と、文書側の言い換えを拾う質問では、同じ検索方式が逆方向に働くことがあります。今回の5実験は語彙が重なりやすいJSQuADを土台としており、この症状全体への推奨は出せません。
実際、2つの質問は逆方向に動きました。「定数1とは何か?」は、正解段落にも「定数1」がそのまま現れ、denseの57位からBM25の10位、RRFの9位へ上がっています。反対に「燃料を入れるところは」では、正解段落が「ガソリンスタンド」と言い換えており、denseの10位に対してBM25は917位、RRFは39位です。いずれもdenseからの順位変化が最大という規則で機械的に抽出した極値であり、語彙一致・不一致の質問全体を代表する例ではありません。
言い換えを埋める手法として、検索する前に質問文のほうを作り替えるクエリ拡張もあります。仮の回答文を生成させてその文で検索するHyDEと、質問を複数の言い方へ言い換えて結果を束ねるマルチクエリが代表格です。両者を測った検証では、nDCG@10がdense単体の0.9419に対してHyDEは0.9047、マルチクエリは0.9285でした。1問あたりの時間も約23msから6.1〜39.7秒へ増えています。この条件では、順位の指標を下げたうえで時間だけが伸びた形です。
語彙のずれを疑う場合は、評価質問を「完全一致が効く」「言い換えが必要」に分け、dense、BM25、RRF、必要ならクエリ拡張の順位変化を区分ごとに集計します。クエリ拡張を後ろへ回すのは、効果がないと一般化できたからではなく、今回の条件で精度悪化と約250〜1700倍のコスト増が同時に出たためです。
今回の条件では、モデル大型化とクエリ拡張を先に試さない
ruri-v3-130mから310mへ替えると、パラメータは約2.4倍になり、重みは528.6MBから1,258.5MBへ増えます。段落を処理する速度は46.9件/秒から15.8件/秒へ下がりました。それでいて、検索3指標の改善は確認できていません。増えたのは重みの大きさと処理時間だけ、という測定結果です。なお速度はセッション間で最大±20%動いたため、絶対値より桁と大小関係を見ます。
HyDEとマルチクエリも3指標でdense単体の測定値を下回り、質問ごとの順位変化はHyDEが改善20件・悪化69件、マルチクエリが改善14件・悪化34件でした。いずれも一次検索がRecall@5で0.976に達していた条件であり、一次検索が弱いデータや語彙ギャップが大きいデータでは結論が変わり得ます。
精度差を区別できない候補は、運用コストで選ぶ
点推定だけでは選びません。GLuCoSE-base-ja-v2とruri-v3-130mは検索3指標で差を区別できず、選択を分ける材料は次元数とベクトル保存量でした。チャンク分割でも、400文字から800文字へ変えるとベクトル数は632から326へ減りましたが、精度差は検出されていません。精度の優劣を確認できない候補は、運用条件へ比較軸を移します。
運用条件には、常駐メモリ、ベクトル件数、索引管理、1問の待ち時間を含めます。今回の測定では、リランカーが候補20件へ406〜2704msを追加し、クエリ拡張は1問ごとに秒単位の生成を挟みました。ハイブリッド検索は検索時間が軽くても索引を2系統持つため、レイテンシだけでは費用を比較できません。
5本の実測が立っている土台
この記事の判断順序は、チャンク分割、埋め込みモデル、ハイブリッド検索、リランカー、クエリ拡張を個別に測った5本の検証から組み立てています。5本はいずれもJSQuAD由来の文書と質問を土台にしていますが、同一条件の通し実験ではありません。
ハイブリッド検索、リランカー、クエリ拡張の3本は、1,145段落を対象にした500問で、一次検索をcl-nagoya/ruri-v3-130mに固定しています。埋め込みモデルの比較は同じ段落と質問を使うものの、比べる対象がモデル本体なので一次検索は固定されていません。チャンク分割だけは土俵が違い、段落をつないで作った擬似的な長文書をチャンクへ切り直したうえ、質問標本と正解判定の基準も他の4本と異なります。
そのため各工程の実測は「次に何を試すか」を選ぶ材料であって、工程どうしの優劣を並べたものではありません。採用判断は、同じ評価質問で変更前後を測ってから行います。
ページ上部の検証環境は、記事末の診断コードを動かした環境です。本文の測定値は5本それぞれの実験環境で得たもので、データ条件と実行環境はリンク先の各記事に記載があります。
診断順序の適用範囲と未検証事項
- 5本はいずれもJSQuAD由来の一般知識QAが土台で、型番・製品コードの完全一致や社内固有語の大きな語彙ギャップを代表していません
- チャンク分割は他4本と質問標本・正解判定が異なるため、工程をまたいだRecall値は比較できません
- ハイブリッド検索とリランカー、チャンク分割とリランカーなど、複数工程を組み合わせた効果は未検証です
- リランカーへ渡す候補数は20件に固定しており、増減したときの取りこぼしと順位変化は測っていません。ハイブリッド検索とマルチクエリのRRFは、1,145段落の全順位を融合した別条件です
- 記事中のRecall値は読者のRAGに対する合格ラインではなく、診断コードの区間包含とも正解判定が異なります
- 下流のLLMが最終的に正しく回答したかは測っていません
- JSQuADと使用モデルの公開学習データの重なりは未検査で、一次検索の高さへの影響を切り分けられていません
- 「差を区別できなかった」は同じ性能を確認したという意味ではありません
手元の検索基盤へつなぐ診断コードの全文
本文で触れた2つの関数はここに含まれます。順位の側を数えるfirst_correct_rankだけ、先に抜き出しておきます。
def first_correct_rank(
    ranked_chunk_ids: list[str],
    chunk_by_id: dict[str, Chunk],
    spans: tuple[EvidenceSpan, ...],
) -> int | None:
    """根拠を丸ごと含む最初のチャンクの1始まり順位を返す。"""

    for rank, chunk_id in enumerate(ranked_chunk_ids, start=1):
        chunk = chunk_by_id[chunk_id]
        if any(contains_span(chunk, span) for span in spans):
            return rank
    return None
Recall@5・@20と4区分の順位分布は、この順位を質問ごとに数え上げるだけで得られます。
rank = first_correct_rank(ranked, chunk_by_id, case.evidence_spans)
recall_at_5 += int(rank is not None and rank <= 5)
recall_at_20 += int(rank is not None and rank <= 20)

if rank == 1:
    bucket = "1位"
elif rank is not None and rank <= 5:
    bucket = "2〜5位"
elif rank is not None and rank <= 20:
    bucket = "6〜20位"
else:
bucket = "圏外"診断の中核はこの2つの関数と順位の区分けで、残りは入力検証と集計です。次が、contains_spanとfirst_correct_rankに、データクラスの定義、入力検証、集計、動作確認用の合成データとコマンドライン入出力を加えた全文です。外部パッケージを使いません。demo_retrieveを手元のベクトルDBや検索APIへ置き換えれば診断できます。付属の合成データは4つの順位区分を通す動作確認用であり、RAG手法の効果を示す実測値ではありません。
特定の埋め込みモデルやベクトルDBを組み込む案は採りませんでした。診断に必要なのは検索基盤が返す順位付きチャンクIDだけで、外部依存を足すと読者側の環境差が診断ロジックの確認を妨げるためです。
"""RAGの取りこぼしと順位を、根拠スパンで分けて数える最小例。

検索結果は ``retrieve`` 関数から受け取るため、特定のベクトルDBや
埋め込みモデルには依存しない。実運用では ``demo_retrieve`` を、
自分の検索基盤が返すチャンクIDのリストへ置き換える。
"""

from __future__ import annotations

import argparse
import json
from collections import Counter
from dataclasses import dataclass
from pathlib import Path
from typing import Callable


@dataclass(frozen=True)
class EvidenceSpan:
    """回答根拠の原文範囲。endは終端を含まない文字オフセット。"""

    document_id: str
    start: int
    end: int


@dataclass(frozen=True)
class Chunk:
    """検索対象チャンクと、元文書上の位置。"""

    chunk_id: str
    document_id: str
    start: int
    end: int
    text: str


@dataclass(frozen=True)
class EvaluationCase:
    """1件の質問。複数の根拠候補のどれか1つを取得できれば正解。"""

    case_id: str
    question: str
    evidence_spans: tuple[EvidenceSpan, ...]


Retrieve = Callable[[EvaluationCase, int], list[str]]


def contains_span(chunk: Chunk, span: EvidenceSpan) -> bool:
    """同じ文書で、チャンクが根拠範囲を丸ごと含むかを返す。"""

    return (
        chunk.document_id == span.document_id
        and chunk.start <= span.start
        and span.end <= chunk.end
    )


def validate_inputs(cases: list[EvaluationCase], chunks: list[Chunk]) -> None:
    """診断前に、ID重複と不正な区間を検出する。"""

    if not cases:
        raise ValueError("質問集合が空です")

    chunk_ids = [chunk.chunk_id for chunk in chunks]
    if len(chunk_ids) != len(set(chunk_ids)):
        raise ValueError("chunk_id が重複しています")

    case_ids = [case.case_id for case in cases]
    if len(case_ids) != len(set(case_ids)):
        raise ValueError("case_id が重複しています")

    for chunk in chunks:
        if chunk.start < 0 or chunk.end <= chunk.start:
            raise ValueError(f"不正なチャンク区間: {chunk.chunk_id}")
        if len(chunk.text) != chunk.end - chunk.start:
            raise ValueError(
                f"チャンク本文の長さとオフセットが一致しません: {chunk.chunk_id}"
            )

    for case in cases:
        if not case.evidence_spans:
            raise ValueError(f"根拠スパンがありません: {case.case_id}")
        for span in case.evidence_spans:
            if span.start < 0 or span.end <= span.start:
                raise ValueError(f"不正な根拠区間: {case.case_id}")


def first_correct_rank(
    ranked_chunk_ids: list[str],
    chunk_by_id: dict[str, Chunk],
    spans: tuple[EvidenceSpan, ...],
) -> int | None:
    """根拠を丸ごと含む最初のチャンクの1始まり順位を返す。"""

    for rank, chunk_id in enumerate(ranked_chunk_ids, start=1):
        chunk = chunk_by_id[chunk_id]
        if any(contains_span(chunk, span) for span in spans):
            return rank
    return None


def diagnose(
    cases: list[EvaluationCase],
    chunks: list[Chunk],
    retrieve: Retrieve,
    max_k: int = 20,
) -> dict:
    """根拠の存在数、Recall@5/@20、正解順位の分布を返す。"""

    if max_k < 20:
        raise ValueError("Recall@20を計算するため max_k は20以上にしてください")
    validate_inputs(cases, chunks)
    chunk_by_id = {chunk.chunk_id: chunk for chunk in chunks}

    evidence_available = 0
    recall_at_5 = 0
    recall_at_20 = 0
    rank_counts: Counter[str] = Counter()
    per_case = []

    for case in cases:
        available = any(
            contains_span(chunk, span)
            for chunk in chunks
            for span in case.evidence_spans
        )
        evidence_available += int(available)

        # 同じIDが複数返っても順位を水増ししない。
        ranked = list(dict.fromkeys(retrieve(case, max_k)))[:max_k]
        unknown = [chunk_id for chunk_id in ranked if chunk_id not in chunk_by_id]
        if unknown:
            raise ValueError(f"未知のchunk_idが検索結果にあります: {unknown}")

        rank = first_correct_rank(ranked, chunk_by_id, case.evidence_spans)
        recall_at_5 += int(rank is not None and rank <= 5)
        recall_at_20 += int(rank is not None and rank <= 20)

        if rank == 1:
            bucket = "1位"
        elif rank is not None and rank <= 5:
            bucket = "2〜5位"
        elif rank is not None and rank <= 20:
            bucket = "6〜20位"
        else:
            bucket = "圏外"
        rank_counts[bucket] += 1
        per_case.append(
            {
                "case_id": case.case_id,
                "evidence_chunk_exists": available,
                "first_correct_rank": rank,
                "rank_bucket": bucket,
            }
        )

    total = len(cases)
    return {
        "n_questions": total,
        "evidence_chunk_exists": {
            "count": evidence_available,
            "rate": evidence_available / total,
        },
        "recall_at_5": {"count": recall_at_5, "rate": recall_at_5 / total},
        "recall_at_20": {"count": recall_at_20, "rate": recall_at_20 / total},
        "rank_distribution": {
            bucket: rank_counts[bucket]
            for bucket in ("1位", "2〜5位", "6〜20位", "圏外")
        },
        "per_case": per_case,
    }


def format_report(result: dict) -> str:
    """診断結果を記事へ載せやすい日本語のテキストにする。"""

    total = result["n_questions"]
    exists = result["evidence_chunk_exists"]
    r5 = result["recall_at_5"]
    r20 = result["recall_at_20"]
    dist = result["rank_distribution"]
    return "\n".join(
        [
            f"質問数: {total}",
            "1. 根拠を丸ごと含むチャンクが存在する質問: "
            f"{exists['count']}/{total} ({exists['rate']:.3f})",
            f"2. Recall@5: {r5['count']}/{total} ({r5['rate']:.3f})",
            f"   Recall@20: {r20['count']}/{total} ({r20['rate']:.3f})",
            "3. 正解順位の分布: "
            + " / ".join(f"{bucket}={dist[bucket]}" for bucket in dist),
            "注意: 正確な文字オフセットの代わりに文・段落全体を根拠として使うと、",
            "      『根拠を含むチャンクがない』件数が系統的に増え、",
            "      診断は大きいチャンクを選ぶ側へ寄ります。",
        ]
    )


def demo_data() -> tuple[list[EvaluationCase], list[Chunk], Retrieve]:
    """4つの順位区分を1件ずつ通る、実行確認用の小さな合成例。"""

    docs = {
        "doc-a": "有給休暇は入社6か月後から10日付与されます。",
        "doc-b": "社内VPNは多要素認証を終えてから接続します。",
        "doc-c": "本番デプロイには2名のレビュー承認が必要です。",
        "doc-d": "セキュリティ申請は部門長の承認後に実施します。",
        "doc-e": "経費精算は翌月5日までに申請します。",
        "doc-f": "問い合わせ窓口は平日9時から18時までです。",
        "doc-g": "在宅勤務の予定はカレンダーへ登録します。",
        "doc-h": "障害連絡は当番チャンネルへ投稿します。",
        "doc-i": "備品購入には事前申請が必要です。",
    }

    chunks = [
        Chunk("c1", "doc-a", 0, len(docs["doc-a"]), docs["doc-a"]),
        Chunk("c2", "doc-b", 0, len(docs["doc-b"]), docs["doc-b"]),
        Chunk("c3", "doc-c", 0, len(docs["doc-c"]), docs["doc-c"]),
    ]
    for index, doc_id in enumerate(("doc-e", "doc-f", "doc-g", "doc-h", "doc-i"), 4):
        chunks.append(Chunk(f"c{index}", doc_id, 0, len(docs[doc_id]), docs[doc_id]))

    # doc-dだけは根拠の途中で切り、検索前に正解チャンクが存在しない例にする。
    evidence_d = "部門長の承認後"
    d_start = docs["doc-d"].index(evidence_d)
    split = d_start + 3
    chunks.extend(
        [
            Chunk("c9", "doc-d", 0, split, docs["doc-d"][:split]),
            Chunk("c10", "doc-d", split, len(docs["doc-d"]), docs["doc-d"][split:]),
        ]
    )

    def span(doc_id: str, phrase: str) -> EvidenceSpan:
        start = docs[doc_id].index(phrase)
        return EvidenceSpan(doc_id, start, start + len(phrase))

    cases = [
        EvaluationCase("q1", "有給はいつ付与されますか", (span("doc-a", "入社6か月後"),)),
        EvaluationCase("q2", "VPN接続に必要なものは何ですか", (span("doc-b", "多要素認証"),)),
        EvaluationCase("q3", "本番デプロイの条件は何ですか", (span("doc-c", "2名のレビュー承認"),)),
        EvaluationCase("q4", "セキュリティ申請はいつ実施しますか", (span("doc-d", evidence_d),)),
    ]
    rankings = {
        "q1": ["c1", "c4", "c5", "c6", "c7", "c8", "c2", "c3", "c9", "c10"],
        "q2": ["c4", "c5", "c2", "c6", "c7", "c8", "c1", "c3", "c9", "c10"],
        "q3": ["c4", "c5", "c6", "c7", "c8", "c1", "c3", "c2", "c9", "c10"],
        "q4": ["c4", "c5", "c6", "c7", "c8", "c9", "c10", "c1", "c2", "c3"],
    }

    def demo_retrieve(case: EvaluationCase, k: int) -> list[str]:
        # 実運用では、ベクトルDB等が返したチャンクIDをここで返す。
        return rankings[case.case_id][:k]

    return cases, chunks, demo_retrieve


def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--text-output", type=Path)
    parser.add_argument("--json-output", type=Path)
    args = parser.parse_args()

    cases, chunks, retrieve = demo_data()
    result = diagnose(cases, chunks, retrieve)
    report = format_report(result)
    print(report)

    if args.text_output:
        args.text_output.parent.mkdir(parents=True, exist_ok=True)
        args.text_output.write_text(report + "\n", encoding="utf-8")
    if args.json_output:
        args.json_output.parent.mkdir(parents=True, exist_ok=True)
        args.json_output.write_text(
            json.dumps(result, ensure_ascii=False, indent=2) + "\n", encoding="utf-8"
        )


if __name__ == "__main__":
main()合成した4問で実行すると、根拠チャンクが存在するのは3問、Recall@5は2問、Recall@20は3問です。最初の正解順位は、1位、2〜5位、6〜20位、圏外へ1問ずつ分かれます。手元で使うときはdemo_retrieveを検索基盤の呼び出しに置き換え、評価用の質問とチャンクを実データから作成してください。
書く前に取り違えが起きそうだと踏んでいたのは、区間の境界、複数の根拠を持つ質問、5位と20位の境目でした。7つの境界テストを通しても、そこでは問題が出ていません。代わりに見つかったのは、質問集合が空のまま渡されたときのゼロ除算です。入力の時点で理由を示すエラーへ直し、再実行して出力が一致することを確認しました。何を正解として数えるか、空の入力をどう扱うかが決まらないままでは、後段の指標も改善幅も比較できません。
まとめ: 数えてから、一工程ずつ動かす
次の一手を決めるのは手法の一覧ではなく、手元の集計結果です。診断を回したら、件数がいちばん多かった区分を、そのまま最初の見直し先にします。固有名詞や言い換えの影響を疑うときは、全体平均で判断せず、質問を区分してから方式ごとの順位を比べます。
変更は一度にひとつです。同じ評価質問で3つの数字を取り直せば、チャンク分割、一次検索、RRF、リランカーのどこを次に試すかを、平均精度だけに頼らず判断できます。
まだ答えを出せていないのは、文字位置の代わりに文や段落を根拠として使ったときに、「根拠チャンクなし」がどれだけ増えるかです。偏る向きは区間の包含判定から予測できますが、量は付属の合成例からは測れませんでした。実データで代用したときの差は、次に確かめたいところです。