
「有給はいつから取れますか」と質問したのに、社内文書の側には「年次有給休暇の付与」と書いてある。質問に使う言葉と文書に書かれた言葉がずれていると、探している1件はなかなか上位に出てきません。
このずれを埋める定番の工夫が、検索する前に質問文の方を作り替える手法です。生成AIに仮の回答文を書かせてその文で検索するHyDEと、質問を複数の言い方へ言い換えて検索結果を束ねるマルチクエリが代表格で、まとめてクエリ拡張と呼ばれます。検索へ渡す手がかりが増えるのだから、当たりやすくなりそうに見えます。
ところが「定数1とは何か?」という質問では、それが裏目に出ました。言い換えなしの検索で1,145段落中57位だった正解が、HyDEでは154位、マルチクエリでは119位まで沈みます。正解は数学の話ではなく、選挙制度の「定数1」を説明する段落です。生成された仮の回答文の方が、「定数1」を数学や物理の定数として語っていました。
もちろん、この1問で手法の善し悪しは決まりません。相性の悪い質問をたまたま引いただけかもしれず、逆に語彙のずれが大きい質問では効いている可能性もあります。そこで、シリーズで基準にしてきた通常の意味検索へHyDEとマルチクエリをそれぞれ足し、同じ500問で測りました。
先に結論
- HyDEもマルチクエリも、言い換えなしの意味検索(dense単体)を上回れなかった。日本語の質問応答データJSQuAD由来の500問では、正解を上位へ並べる力(nDCG@10・MRR@10)がどちらの拡張でも低下
- 上位5件に正解が入る割合(Recall@5)は、どのペアでも差を確認できず。はっきり動いたのは順位の側
- 1問あたりの検索時間は約23ミリ秒から数秒〜数十秒へ。しかも機体の発熱状態で大きく動き、単一の代表値にはまとめられない
- 既定はdense単体のまま。クエリ拡張を足すのは、自分の質問集合で改善を確かめてから
この記事の前提と、点数の読み方
RAG(質問に関係する文書を探してLLMへ渡し、答えさせる仕組み)という言葉を聞いたことがあれば、この先は読めます。扱うのは検索の部分だけで、回答を書かせる工程は出てきません。指標や手法の名前は、出てくる場所で意味を添えます。
土台にするdense(埋め込み)検索は、質問と文書をそれぞれベクトルへ変換し、意味の近さで順位づけする方式です。この記事ではこれを「dense単体」と呼び、比較の基準にします。HyDEとマルチクエリは検索の仕組み自体を差し替えるのではなく、そこへ渡す質問を作り替える前段の工程です。
点数は2つの見方で読みます。Recall@5は上位5件の中に正解があった質問の割合で、拾えたかどうかだけを見ます。nDCG@10とMRR@10は、正解を何位に置けたかを点数にしたもので、上位へ来るほど1に近づきます。この2つは以降まとめて順位品質と呼びます。見つかったかどうかと、どれだけ上に並べられたかは別の話なので、分けて確認します。
マルチクエリで使うRRFは、複数の検索結果を順位の情報だけで束ねる定番の融合法です。言い換え3件がそれぞれ返した順位を、1つの並びへまとめる役に立ちます。
RAG全体のどこで精度が落ちるかを工程ごとに分けて調べる枠組みは、RAGとは?検索・生成の仕組みと精度が落ちる4つの場所にまとめています。
dense単体を固定し、拡張を足した差だけを見た
問いは「日本語の検索で、クエリ拡張は本当に効くのか」です。埋め込みモデルもコーパスも指標も固定し、質問の作り替えだけを差し替えました。
比べたのは3方式です。dense単体は質問をそのまま埋め込んで全段落と照合します。+HyDEは質問から仮想文書を1本だけ生成し、その文で検索します。+マルチクエリは言い換えを3件作り、それぞれの検索結果をRRFで統合します。生成にはローカルで動かしたQwen2.5-7B-Instructの量子化版を使いました。
評価データは、日本語の短答QAデータセットJSQuAD由来の1,145段落と500問です。埋め込みモデル比較・リランカー・ハイブリッド検索の各回と同じコーパス、同じクエリ、同じ正解ラベルを使い回しています。JSQuADはWikipedia由来で、質問と正解段落の語がもともと重なりやすい性格があります。この点は結果の解釈に効いてきます。
測っていないもの(別の生成器、言い換えの本数を変えた場合、ハイブリッド検索との併用、回答生成まで通した品質)は、記事末の「適用範囲と限界」にまとめました。プロンプトや統計の手続きは「詳しい検証条件」にあります。
順位は下がり、拾えたかどうかは差を確認できなかった
500問の平均でも、冒頭の1問と同じ向きの結果になりました。3指標ともdense単体が最も高く、HyDEが最も低くなっています。
| 方式 | Recall@5 | nDCG@10 | MRR@10 |
|---|---|---|---|
| dense単体(ruri-v3-130m) | 0.976 | 0.9419 | 0.9268 |
| +HyDE | 0.960 | 0.9047 | 0.8802 |
| +マルチクエリ(N=3、RRF融合) | 0.970 | 0.9285 | 0.9103 |
太字は各指標の最良値です。数値は丸めて表記しています。
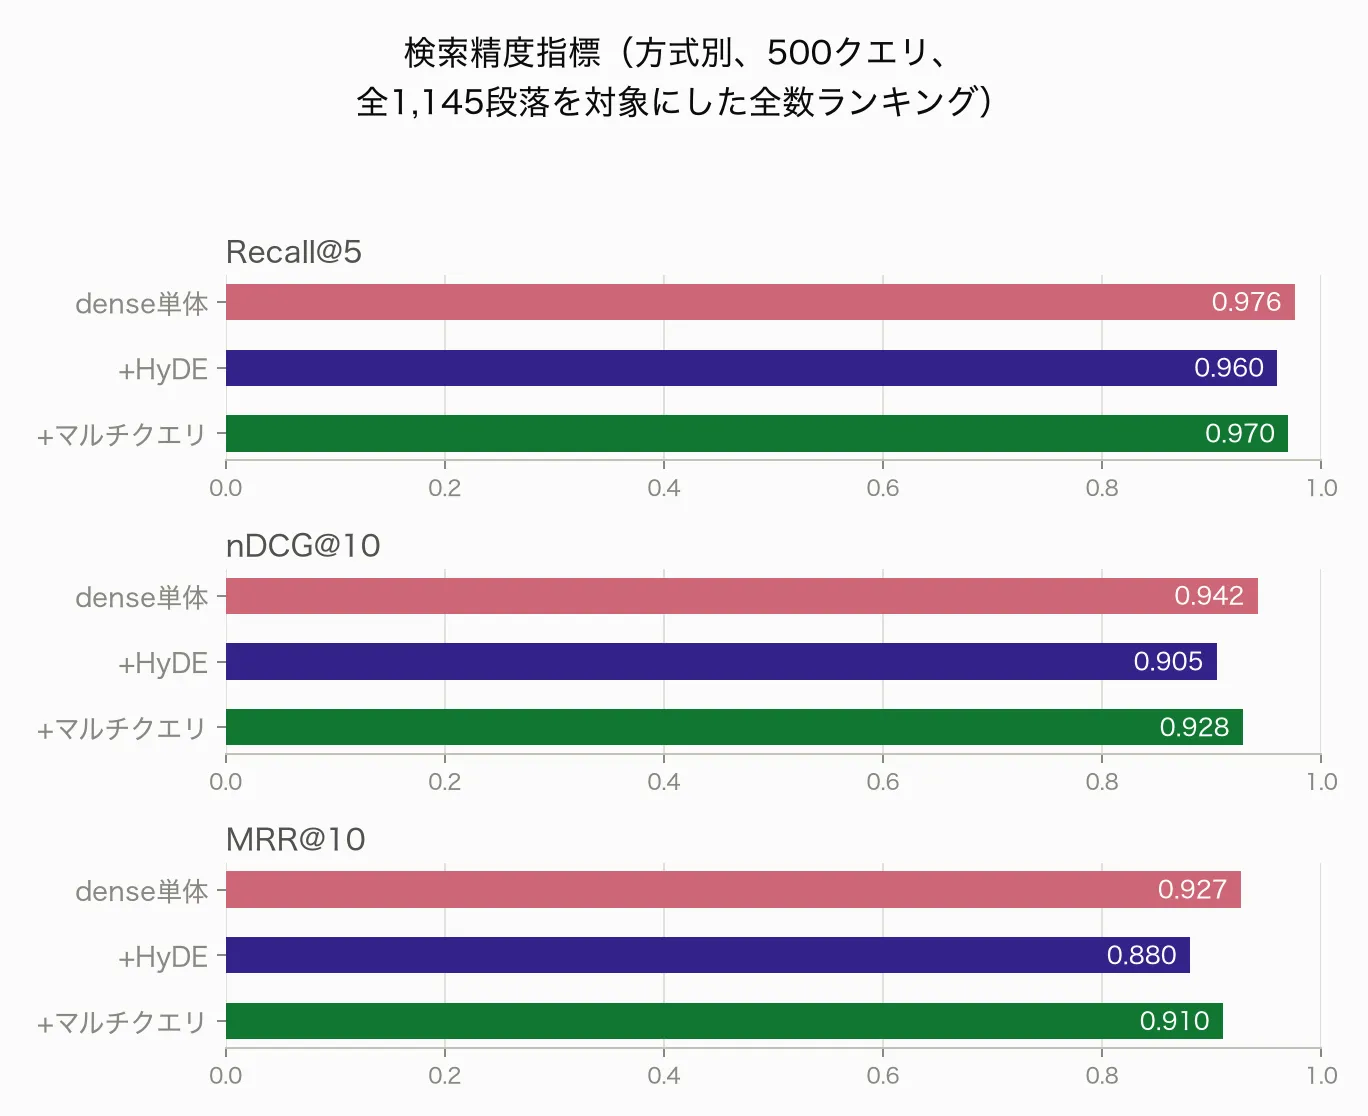
nDCG@10とMRR@10は、3ペア(dense対HyDE・dense対マルチクエリ・HyDE対マルチクエリ)すべてで差が残りました。偶然のばらつきと、3ペアを同時に見比べることで生じる当たりを割り引いたうえでの判定です。順位品質はdense単体、マルチクエリ、HyDEの順です。 語彙のずれを埋めて検索を助けるはずの手法が、正解を上位へ押し上げる力をむしろ落としたことになります。
一方、Recall@5はdense単体0.976、HyDE 0.960、マルチクエリ0.970でしたが、3ペアとも差は残りませんでした。同等と確かめたのではなく、この500問では見分けが付かなかったということです。
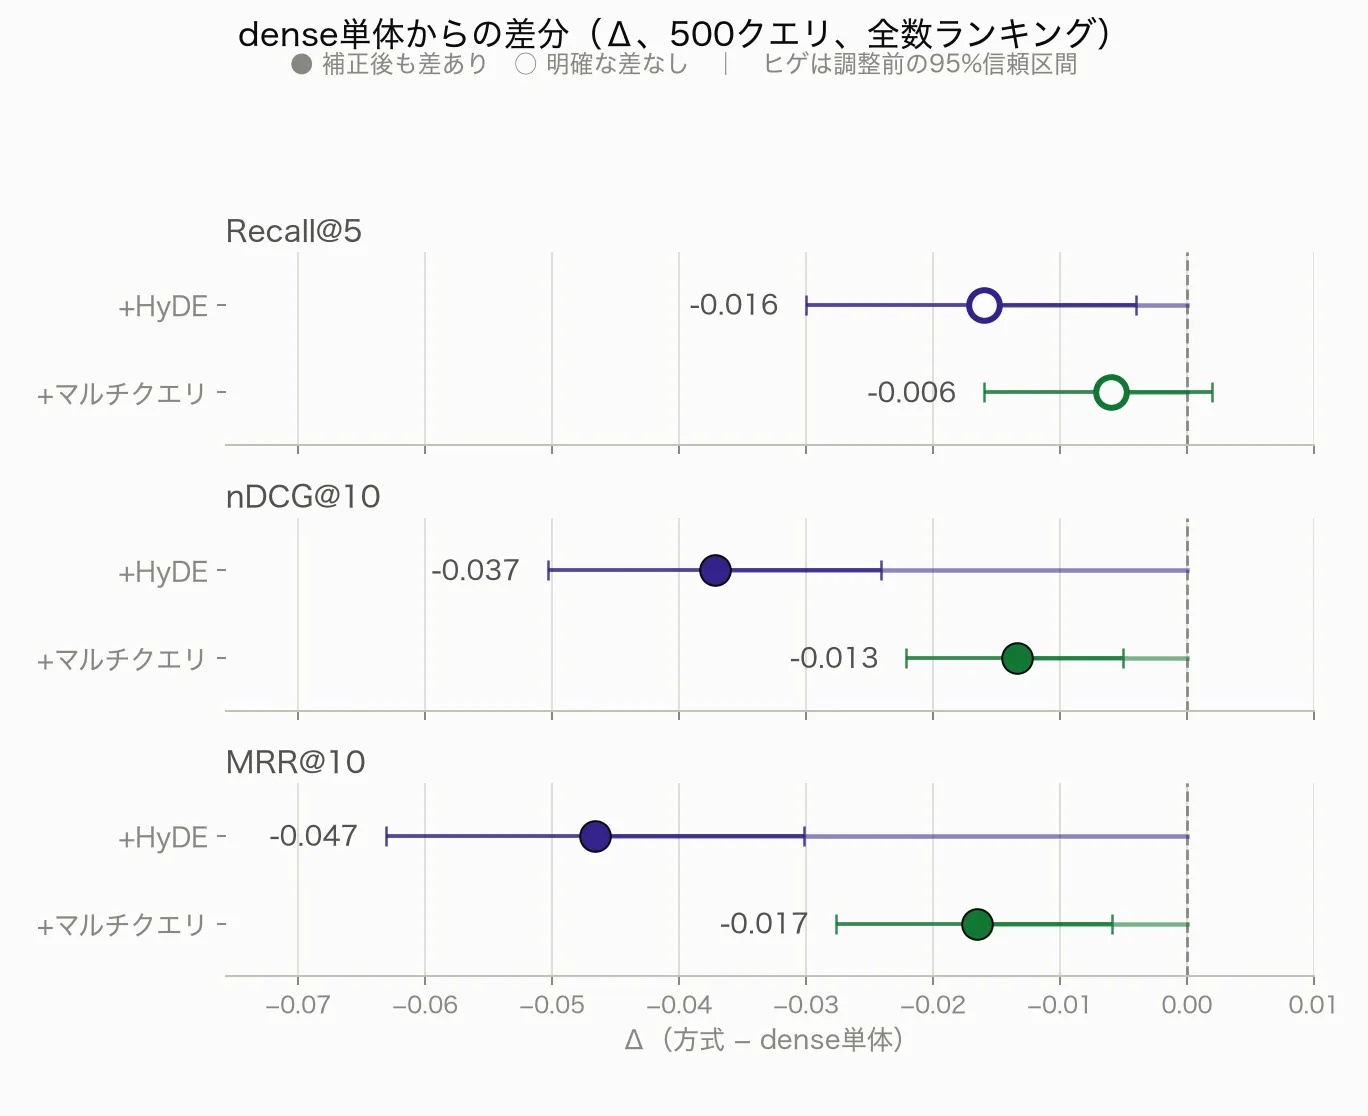
悪化の幅は一律ではありません。マルチクエリの低下はHyDEより浅く、両者の差もnDCG@10・MRR@10で確認できました。試す順番を決めるときは、この差が手がかりになります。
順位が下がった理由は3つ考えられるが、切り分けていない
もっとも構造的に効いていそうなのは、埋め込みの向きの違いです。dense単体とマルチクエリは質問をクエリとして扱いますが、HyDEだけは生成した仮想文書を「文書」として扱い、文書対文書で照らします。土台のruri-v3-130mはクエリ対文書のマッチングに最適化されたモデルなので、この違いがHyDEをより不利にした一因になりえます。
そこへ、生成が誤った文脈に引っ張られる問題が重なります。曖昧で短い質問では、的外れな仮想文書が書かれたり、言い換えが元の曖昧さを引きずったりして、埋め込みが正解から離れます。HyDEの落ち込みが深いのは、生成した1本がそのまま検索ベクトルになり、外したときの影響を直接受けるからかもしれません。マルチクエリは言い換え3件の順位を束ねるので、1件が的外れでも残り2件が効きます。
土俵そのものの相性も無視できません。JSQuADは質問と正解段落の語彙がもともと重なりやすく、語彙ギャップを埋める設計の手法が活きにくいデータです。加えてdense単体のRecall@5がすでに0.976と高く、伸びしろの小さいところへ生成由来のノイズが乗った、という見方もできます。いずれも結果からの推測で、この実験では確かめていません。
生成を挟むと、1問23ミリ秒が秒単位になった
精度が上向かなかった一方で、時間ははっきり増えました。HyDE・マルチクエリは埋め込みとランキングに加えて、1問ごとにLLM推論を挟むためです。dense単体の約23.3msに対し、HyDEは6.1〜15.1秒、マルチクエリは6.4〜39.7秒かかりました。
| 方式 | 冷えた状態(パイロット) | 本計測500問連続 | 3時間負荷+15分休止後 |
|---|---|---|---|
| +HyDE | 6114ms(262倍) | 9040ms(387倍) | 15051ms(645倍) |
| +マルチクエリ | 6445ms(276倍) | 21576ms(924倍) | 39704ms(1701倍) |
倍率はdense単体(23.34ms/問)比です。
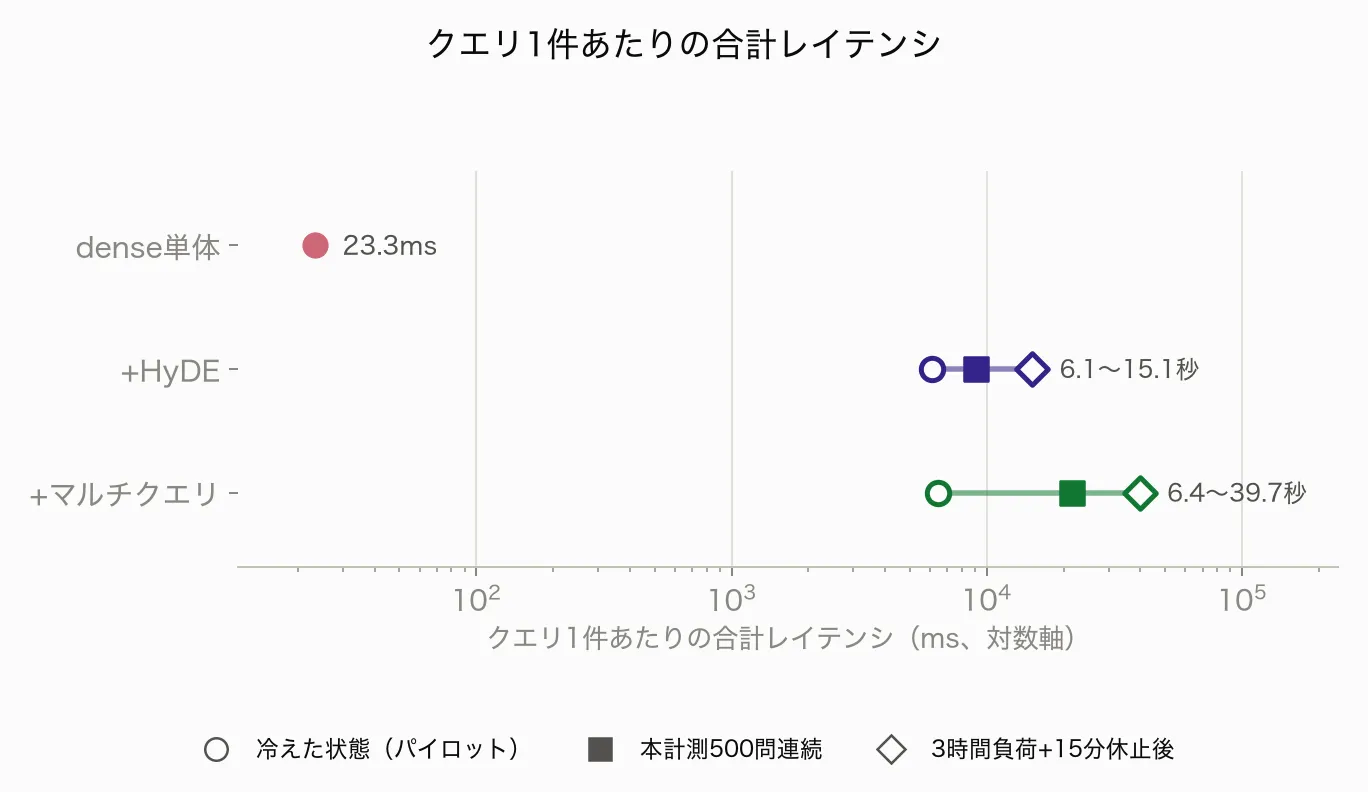
3系統を並べたのには理由があります。当初は「3時間ほど連続で負荷をかけたあと15分休ませれば通常状態に戻る」と考え、その値を代表値に使うつもりでした。ところが実際に測ると、15分休止後が3系統の中で最も遅かったのです。ファンレスのM1では、長時間の連続負荷のあと15分では冷え切らなかったとみられます。逆に最も速かったのは、そのセッションで最初に生成をかけたパイロット計測でした。さらに一度は、深夜の連続生成中にmacOSがスリープしてプロセスが落ち、最初からやり直しています。
そこで単一の代表値を選ぶのはやめ、3系統をそのまま併記しました。桁で見ればdense単体比でおおむね250〜1700倍のレンジで、直前の負荷が大きいほど遅くなる傾向はあります。ただ、どれかを「真の代表値」と決められるものではありません。
なお温度0の決定的な生成なので、遅くなっても出力テキストは変わりません。発熱が影響したのはレイテンシの実測値だけで、精度指標は動いていません。
「定数1」の質問で、生成文が何をしたか
平均値だけでは、どの質問で拡張が裏目に出たのかが見えません。そこで方式ごとに、dense単体からの正解順位の変化が最大だった質問を1件ずつ取り出しました。結果を見る前に決めた抽出ルールによるもので、目視で選んではいません。
まず全体の内訳です。HyDEは改善20件・悪化69件・変化なし411件、マルチクエリは改善14件・悪化34件・変化なし452件でした。順位が動いた質問自体が2割に満たず、動いた分では悪化が改善を上回っています。 平均の小さな低下は、少数の大きく沈んだ質問から出ていることになります。
これから挙げるのは全順位での変化なので、nDCG@10・MRR@10の低下をそのまま説明するものではありません。両者をつなぐ数え方は「詳しい検証条件」に置きました。ここで見たいのは、生成が検索の向きをどう誤らせるかです。
HyDE・マルチクエリで共通して最悪だったのが、冒頭の「定数1とは何か?」でした。正解段落は日本共産党の選挙戦術を説明する文章で、「定数1(小選挙区…)」という選挙制度の語を含みます。ただし、正解が遠ざかった経路は方式で違いました。
HyDEの仮想文書は、選挙制度ではなく数学や物理の定数として「定数1」を説明していました。
定数1は、数学や物理学などで使用される基本的な定数の一つで、常に1の値を保持します。この定数は、方程式の解の初期値設定や、様々な計算において基本的な単位や基準値として用いられます。
一方マルチクエリの言い換え3件は「定数1とはどのようなものでしょうか?」「定数1は何か説明していただけますか?」「定数1の定義を教えていただけますか?」で、分野を絞る語が一つも増えていません。数学と解釈した形跡は生成物には無く、確認できるのは、文脈を補えないままの3件を束ねた結果として57位から119位へ下がったという事実だけです。なぜ下がったかは切り分けていません。
改善した例が無いわけではありません。HyDEでは「ブラジルの南西に位置し、サッカーでも有名な南アメリカ有数の大国は。」で仮想文書がアルゼンチンだと言い当て、正解順位が158位から145位へ上がりました。マルチクエリでも「より大きなデータを取り扱うことが可能になってきたのは何が確立されたから?」で、言い換えが具体化して25位から15位へ改善しています。
ただしどちらも10位以内には届いていません。順位は上がっても、実務で参照される範囲には入らないということです。こうした当たりは少数派で、平均を押し上げるには至りませんでした。
実務なら、クエリ拡張は最初の一手にしない
クエリ拡張を後回しにする理由は、この記事の実測そのものです。 シリーズで1工程ずつ測ってきた中で、順位品質を下げたうえに処理時間まで増やしたのはクエリ拡張だけでした。悪い方へ動く可能性がある手を、最初の一手には置きません。
先に触る候補は、各回が実際に測った向きで選びます。チャンク分割は、段落構造を壊す切り方をすると正解が検索前に脱落し、順位品質にも差が出ました。リランカーとハイブリッド検索は、いずれも上位5件へ入る割合ではなく順位の側を動かす手です。埋め込みモデルの選定は、上げ幅を狙うより、極端に振るわない構成を避ける意味合いが強い結果でした。工程どうしの優劣は、条件をそろえて並べていないので比べていません。
応答時間が要件に入るなら、今回のM1環境でクエリ拡張を選ぶ理由は見つかりませんでした。約23msが秒単位へ跳ね上がり、機体の発熱状態でもさらに数倍動きます。精度側の改善を確認できていない以上、この規模の増加を正当化する材料が今回のデータにはありません。
それでも試すなら、悪化幅の浅かったマルチクエリからです。 採用を決めるのは、語彙ギャップの大きい自分の質問集合で検索順位と生成時間を測り直したあとにしてください。ハイブリッド検索と組み合わせた場合の効果は、今回測っていません。
詳しい検証条件
3方式の中身は次のとおりです。土台のdense検索を固定し、クエリ拡張を足した差だけを見ています。
-
dense単体(baseline): 質問を
cl-nagoya/ruri-v3-130mで埋め込み、全1,145段落とのコサイン類似度で順位づけします(候補プールは設けず、毎回全段落を並べ替える全数ランキング)。第1〜4弾と同じ方式です。 -
+HyDE: 質問からLLMに仮想文書を1回生成させ、その文を検索に使います。生成器は
Qwen2.5-7B-InstructのQ4_K_M量子化版で、プロンプトは次のものです。次の質問に対する回答が書かれていそうな、Wikipedia記事の一節のような説明文を150字程度で書いてください。 質問に直接答える内容にしてください。 質問: {query}原論文(Gao et al., arXiv:2212.10496)の複数サンプル平均版ではなく、単一生成の簡略版です。
-
+マルチクエリ: 同じ生成器に質問を3通りへ言い換えさせ、それぞれで検索した結果をRRF(k=60はハイブリッド検索の回と同一)で統合します。プロンプトは次のものです。
次の質問を、同じ意図を保ったまま3通りの異なる言い方で言い換えてください。
それぞれ1文で、次の形式でちょうど3件出力してください。

1. (言い換え1)
2. (言い換え2)
3. (言い換え3)

質問: {query}
3件そろわなかった場合は不足分を元クエリで埋めます(500問中1問、0.2%で発生)。逆にいうと、残り499問で融合しているのは言い換え3件の順位だけで、元クエリ自体の検索結果は融合に入れていません。元クエリの順位も足す構成では挙動が変わりえます。
評価に使った500問はseed 42で固定して抽出したものです。チャンク分割を比べた回だけは分割方法を比べる都合でコーパスもクエリの抽出手順も異なり、同じ500問ではありません。その回の数値と本記事の数値は直接は比べられません。
本文の数値は、3方式を実行した際に保存したログを後から集計したものです。dense単体の再計算値が埋め込みモデル比較の回の公表値と完全に一致することを確認したうえで、3方式の差をペアで統計評価しました。生成はtemperature=0, top_k=1, seed=42の決定的設定で、同じ質問なら毎回同じ文が出ます。
全順位の変化と@10指標のつながり: 正解が10位以内から圏外へ落ちた質問はHyDEで6件・マルチクエリで3件、逆に圏外から10位以内へ入った質問はどちらも1件でした。ただし、この出入りだけでは@10の低下を説明しきれません。10位以内から圏外へ落ちた6件がすべて1位からの転落だったと最大に見積もっても、MRR@10の低下として説明できるのは0.012(6件÷500問)までで、実測の低下0.0466には届かないからです。残りは、10位以内にとどまったまま正解の順位が下がった質問から出ています。
読み飛ばし可: prefixの扱い・統計手法・全ペア検定・再現用パラメータ
- 埋め込みの向き: dense単体・マルチクエリは質問をクエリ用prefix(
検索クエリ:)で、HyDEは仮想文書を文書用prefix(検索文書:)でエンコードします。ruri-v3-130mはクエリ対文書の非対称なマッチングに最適化されたモデルで、HyDEだけ文書対文書の類似度になる点は結果の解釈に関わります。 - 生成の詳細: HyDEは平均68トークン、マルチクエリは平均80トークンを生成。生成はllama-server(llama.cpp)経由でMetalオフロードして実行しました。長時間の連続生成ではmacOSのアイドルスリープでプロセスが中断することがあるため、
caffeinate -iでの実行を推奨します。 - dense単体の再現一致: 再計算値はRecall@5=0.976、nDCG@10=0.9419、MRR@10=0.9268で、埋め込みモデル比較の回の公表値と一致しました(数値は丸めて表記)。MPSで計算し、CPUとのコサイン類似度の最大絶対差は1e-3以内です。
- 統計手法: ブートストラップ95%信頼区間(評価に使った500問を再標本化した推定の不確実性、B=10,000・seed=42・paired)と、Recall@5に対するMcNemar検定(対応のあるexact両側検定)。3ペア×3指標の同時比較のため、指標ごとに3ペアを1家族とするBonferroni補正(α=0.05/3≈0.0167)を適用し、Holm法でも算出して一致を確認しました。3ペア×3指標=9検定を1家族とするより保守的な代替でも判定は変わりません(差分0件)。
| ペア(A vs B) | ΔRecall@5 [95%CI] | ΔnDCG@10 [95%CI] | ΔMRR@10 [95%CI] |
|---|---|---|---|
| dense単体 vs +HyDE | +0.0160 [+0.0040, +0.0300] | +0.0372 [+0.0241, +0.0503]‡ | +0.0466 [+0.0302, +0.0631]‡ |
| dense単体 vs +マルチクエリ | +0.0060 [-0.0020, +0.0160] | +0.0134 [+0.0050, +0.0221]‡ | +0.0165 [+0.0059, +0.0276]‡ |
| +HyDE vs +マルチクエリ | -0.0100 [-0.0220, +0.0000] | -0.0238 [-0.0369, -0.0111]‡ | -0.0301 [-0.0465, -0.0140]‡ |
‡: 補正後も差を確認(指標ごと3家族、α=0.05/3≈0.0167)。Recall@5はいずれのペアも補正後に差を確認できませんでした。
適用範囲と限界
- JSQuADという1データセットでの結果です。 Wikipedia由来で質問と正解段落の語彙が重なりやすく、型番や製品コードのように語の完全一致がものを言う検索を代表しているとは限りません。語彙ギャップが大きいデータではクエリ拡張の損得が変わりえます。
- 生成器・設定を1本に絞った実験です。 生成器はQwen2.5-7B-Instruct Q4_K_Mのみ、HyDEは単一生成の簡略版、マルチクエリはN=3固定で、融合するのは言い換え3件の順位だけです(元クエリの順位は融合に含めていません)。元クエリも融合に足す構成や、Nを変えた場合の損得は測っていません。生成器の選定は量子化記事の分類タスクの知見を生成へ外挿した設計判断で、それ自体を検証したわけではありません。
- 段落単位の検索という条件での結果です。 チャンク分割の違い(チャンク分割を比べた回)との組み合わせは検証していません。
- ハイブリッド検索(BM25・dense・RRFを比べた回)との組み合わせは未検証です。 baselineをdense単体に固定しており、BM25やRRF融合と併せた場合の効果は測っていません。
- 下流の回答品質は測っていません。 検索順位の差が最終的な回答の正しさにどうつながるかは、検索から回答生成までを通した別の評価が必要で、今回の対象外です。
- レイテンシはApple M1固有の値です。 HyDE・マルチクエリは発熱状態違いで3系統計測した一方、dense単体は1系統のみで、発熱状態間の変動は検証していません。GPU搭載機やAPI型のLLMでは絶対値も揺れ幅も変わりえます。
HyDEの動きを8文書・1問で見る最小コード
「HyDEはLLMに仮の回答を書かせ、それを検索クエリの代わりに使う」という仕組みを、8文書・1問の最小構成で確認できます。dense単体とHyDEの順位を全件並べて見比べる構成です。あらかじめllama-server(llama.cpp)をローカルで起動しておいてください。
brew install llama.cpp
llama-server -hf bartowski/Qwen2.5-7B-Instruct-GGUF:Q4_K_M -ngl 99 -c 2048 --port 8091transformersはバージョン4.57.6に固定してください。固定しないとdenseの出力スコアの桁がずれることがあります。以下をquickstart_hyde.pyとして保存します。
"""dense単体と+HyDEの順位を8文書・1問で見比べる最小デモ。"""

import requests
from sentence_transformers import SentenceTransformer
import numpy as np

DEVICE = "cpu"  # 掲載した出力と一致させるため固定
LLAMA_SERVER_URL = "http://127.0.0.1:8091/v1/chat/completions"

HYDE_PROMPT_TEMPLATE = (
    "次の質問に対する回答が書かれていそうな、Wikipedia記事の一節のような説明文を"
    "150字程度で書いてください。\n"
    "質問に直接答える内容にしてください。\n\n"
    "質問: {query}"
)

# 以下は自分のデータに置き換えて使う
DOCUMENTS = [
    "有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに行う。",
    "経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行う。",
    "社内VPNへの接続には接続機器VPN-2024-003が必要で、情報システム部に貸出申請を行う。",
    "本番環境へのデプロイは、プルリクエストが2名以上のレビュー承認を得た後にのみ実行できる。",
    "リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求められる。",
    "問い合わせ対応の一次窓口はサポートチームで、営業時間は平日9時から18時までである。",
    "半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映される。",
    "有給休暇の買い取りは原則禁止だが、退職時に限り未消化分を精算できる場合がある。",
]

QUERIES = [
    "有給はいつから取れますか?",  # dense単体が意味の近い別文書に引っ張られやすい質問
]


def generate_hyde_doc(query: str) -> str:
    payload = {
        "model": "qwen",
        "messages": [{"role": "user", "content": HYDE_PROMPT_TEMPLATE.format(query=query)}],
        "temperature": 0.0,
        "top_k": 1,
        "max_tokens": 200,
        "seed": 42,
    }
    r = requests.post(LLAMA_SERVER_URL, json=payload, timeout=120)
    r.raise_for_status()
    return r.json()["choices"][0]["message"]["content"].strip()


def main() -> None:
    print(f"device: {DEVICE}")

    embed_model = SentenceTransformer("cl-nagoya/ruri-v3-130m", device=DEVICE)
    doc_embeddings = embed_model.encode(
        ["検索文書: " + d for d in DOCUMENTS], normalize_embeddings=True, convert_to_numpy=True,
    )

    for query in QUERIES:
        print(f"\nクエリ: {query}")

        # dense単体: 質問文をそのままクエリ用prefixでエンコード
        q_emb = embed_model.encode(
            "検索クエリ: " + query, normalize_embeddings=True, convert_to_numpy=True,
        )
        dense_scores = doc_embeddings @ q_emb
        dense_order = np.argsort(-dense_scores, kind="stable")

        # +HyDE: LLMに仮想文書を生成させ、それを文書用prefixでエンコードして検索
        hyde_text = generate_hyde_doc(query)
        print(f"  生成された仮想文書: {hyde_text}")
        hyde_emb = embed_model.encode(
            "検索文書: " + hyde_text, normalize_embeddings=True, convert_to_numpy=True,
        )
        hyde_scores = doc_embeddings @ hyde_emb
        hyde_order = np.argsort(-hyde_scores, kind="stable")

        print("  [dense単体]  1位:", DOCUMENTS[dense_order[0]])
        print("  [+HyDE]      1位:", DOCUMENTS[hyde_order[0]])

        print("  順位一覧(doc, dense順位, +HyDE順位):")
        for i, doc in enumerate(DOCUMENTS):
            d_rank = int(np.where(dense_order == i)[0][0]) + 1
            h_rank = int(np.where(hyde_order == i)[0][0]) + 1
            print(f"    dense={d_rank:>2} hyde={h_rank:>2}  {doc[:40]}")


if __name__ == "__main__":
    main()
依存を入れて実行します。
# uv を使う場合(推奨)
uv venv --python 3.12
uv pip install sentence-transformers "transformers==4.57.6" sentencepiece protobuf requests
uv run --no-project python quickstart_hyde.py--no-projectが要るのは、保存先の親ディレクトリに別のpyproject.tomlがあると、素のuv runがそちらの環境を掴んでしまうためです。
実行結果(実際のstdout)
device: cpu

クエリ: 有給はいつから取れますか?
  生成された仮想文書: 有給休暇は、通常、社員が6ヶ月以上勤務した後から取得が可能です。ただし、各企業の定める規定により異なる場合があります。
  [dense単体]  1位: 半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映される。
  [+HyDE]      1位: 半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映される。
  順位一覧(doc, dense順位, +HyDE順位):
    dense= 2 hyde= 2  有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに
    dense= 5 hyde= 5  経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行
    dense= 8 hyde= 7  社内VPNへの接続には接続機器VPN-2024-003が必要で、情報システム部に
    dense= 7 hyde= 8  本番環境へのデプロイは、プルリクエストが2名以上のレビュー承認を得た後にのみ実行
    dense= 4 hyde= 4  リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求め
    dense= 6 hyde= 6  問い合わせ対応の一次窓口はサポートチームで、営業時間は平日9時から18時までであ
    dense= 1 hyde= 1  半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映
    dense= 3 hyde= 3  有給休暇の買い取りは原則禁止だが、退職時に限り未消化分を精算できる場合がある。
この小さなデモでは、dense単体もHyDEも「半休(0.5日単位の有給)」の文書を1位にし、下位2件(VPN機器とデプロイ承認の文書)が入れ替わる程度の違いにとどまりました。文書が8件しかないと方式差ははっきり出ません。入出力の形を体感するための最小例であって、本文の500問で見た結論とは別物として扱ってください。
足す前に、dense単体が外している質問を数える
日本語RAGにHyDEやマルチクエリを足しても、この500問では正解の順位が上がらず、むしろ下がりました。順位が動いた質問自体が少なく、その中でも改善より悪化が多く、代わりに生成時間だけがミリ秒から秒単位へ増えています。既定で足す手法として扱う根拠は、今回のデータからは出ませんでした。
意外だったのは、レイテンシの方が単一の値に収まらなかったことです。3時間の連続負荷から15分休ませれば通常状態に戻ると見込んでいたのに、そこが3系統で最も遅く、代表値を選ぶ計画そのものを取り下げました。ノートPC1台で秒単位の処理を測るときは、機体の状態まで書き残しておく必要があります。
とはいえJSQuADは、質問と正解段落の語がもともと重なりやすいデータです。語彙ギャップの大きい実務データ、別の生成器、元クエリも融合に含めた構成では、損得が変わる余地があります。次に確かめるとしたら、dense単体が外している質問だけを集め、その集合で改善と悪化を数え直すところからです。
どの工程から手を付けるかを数字で決めたいときは、入口記事「RAGの検索精度を上げる方法」に診断の手順があります。
出典: 評価データ JGLUE(JSQuAD): Kurihara et al., “JGLUE: Japanese General Language Understanding Evaluation”, LREC 2022 / yahoojapan/JGLUE(CC BY-SA 4.0)。一次検索モデル: cl-nagoya/ruri-v3-130m(Tsukagoshi & Sasano, arXiv:2409.07737、Apache-2.0)。HyDE手法: Gao, Ma, Lin & Callan, “Precise Zero-Shot Dense Retrieval without Relevance Labels”, arXiv:2212.10496。生成モデル: Qwen2.5-7B-Instruct(Apache-2.0)、GGUF量子化版はbartowski/Qwen2.5-7B-Instruct-GGUFから取得し、llama.cpp(MIT)で実行しました。