
回答に使う文書を上位5件だけに絞ると、6位に沈んだ正解は無かったことと同じになります。だから検索の側では、正解をどれだけ上位へ持ち上げられるかが問題になります。そこで後段に足すのが、最初の検索が集めた候補をもう一度採点し直して並べ替える専用のモデルです。リランカーと呼ばれ、日本語で使えるものも複数公開されています。
並び順を直せる代わりに、モデルをもう一つ動かす時間とメモリが増えます。「入れると精度が上がる」だけでは、その追加コストを払う判断ができません。知りたいのは、取りこぼしが減るのか、すでに見つけた正解が上へ動くのか、そして1クエリに何秒増えるのかです。
日本語で使える5モデルを、最初の検索(以降は一次検索と呼びます)が返した候補20件へ通しました。4モデルで正解の順位は上がり、それでも正解が上位5件に入る割合は改善を確認できませんでした。 同じ検索結果を見ているのに、精度をどの指標で測るかによって答えが分かれます。
先に結論
- 正解が上位5件に入る割合(Recall@5)の改善は、5種類のどれを足しても確認できなかった。一次検索だけで0.976あり、候補20件の上限0.99まで7問分しか残っていない。
- 正解をより上位へ押し上げる力(nDCG@10とMRR@10。正解が上位にあるほど1へ近づく指標)は、5種類中4種類で改善。
- 精度と速度の釣り合いで最初に置くならhotchpotchの日本語リランカー。測定値が最も高いruri-v3-reranker-310mとの差は区別できず、並べ替えだけにかかる時間(追加レイテンシ)は310mの約37%で済む。
- 射程は、日本語の質問応答データJSQuAD由来の1,145段落・500問。一次検索は1モデルに固定し、候補は上位20件。
同じ検索結果でも、3つの指標は違うところを見ている
この記事の数値は3つの指標で語ります。どれも「正解が上位に来たか」を測るものですが、見ている角度が違います。Recall@5が数えるのは上位5件に正解が入った質問の割合だけで、5件の中の順番は問いません。nDCG@10とMRR@10はその正解が何位だったかまで採点するので、1位と5位を区別できます。以降、この2つをまとめて順位品質と呼びます。
文書を検索して生成AIに答えさせる仕組みをRAGと呼びます。リランカーが受け持つのは、RAGで精度が落ちる4つの場所のうち「正解は候補にあるが上位へ来ない」段階です。候補に入らなかった正解を拾い直す工程ではないため、取りこぼしが問題なら見直す場所が変わります。
一次検索と候補を固定し、並べ替えだけを6通りに変えた
評価には、JGLUE(JSQuAD)のvalidation splitから作った日本語QAを使いました。コーパスは1,145段落、クエリはseed 42で固定した500問です。各質問に付いた正解段落と一致したかを、全設定・全指標で同じように判定します。
比べたのは、リランカーなしのbaselineと5モデルの計6設定です。3指標に加えて、候補20件を並べ替える時間を測りました。一次検索モデル(ruri-v3-130m)、コーパス、500問は固定してあるので、設定間で動いているのは並べ替えだけです。
結果を読む前に、天井の話を一つだけ。リランカーは一次検索が絞った上位20件(候補プール、K=20)の中しか並べ替えられないので、プールに正解が入っていなければ救えません。今回のデータで正解が上位20件に入る質問の割合は0.99、しかも一次検索だけでRecall@5がすでに0.976ありました。この2つの数字が、後半の結果の読み方を決めます。
対象にした5種はいずれもHugging Faceから無料で入手でき、ライセンスは商用利用できるMITまたはApache-2.0です。名前の似た ruri-reranker-small・ruri-reranker-base と ruri-v3-reranker-310m は、ベースのアーキテクチャ世代が違います。
| リランカー | ライセンス | パラメータ(実ロード値) | 系列(ベース) |
|---|---|---|---|
| cl-nagoya/ruri-reranker-small | Apache-2.0 | 68.7M | tohoku-nlp/bert-base-japanese-v3系 |
| cl-nagoya/ruri-reranker-base | Apache-2.0 | 111.2M | tohoku-nlp/bert-base-japanese-v3系 |
| cl-nagoya/ruri-v3-reranker-310m | Apache-2.0 | 315.2M | ModernBERT-Ja系(cl-nagoya/ruri-v3-pt-310m) |
| hotchpotch/japanese-reranker-cross-encoder-base-v1 | MIT | 111.2M | BERT系(Ruriとは別系列) |
| BAAI/bge-reranker-v2-m3 | Apache-2.0 | 567.8M | bge-m3系 |
以降は組織名を省いた短縮名(ruri-small・ruri-base・hotchpotch・bge-v2-m3・ruri-v3-reranker-310m)で表記します。
測っているのは検索の並べ替えまでで、回答生成の品質や候補プールのサイズを変えた場合は対象外です。何が言えないかは、記事末の適用範囲と限界にまとめました。
以降の「改善を確認できた」は、偶然のばらつきと、多数のペアを見比べることで生まれる見かけの差を割り引いてなお残ったものだけです。反対に「明確な差を確認できなかった」は性能が同じという結論ではなく、この500問では判別できなかったことを表します。
取りこぼしは変わらず、正解の順位は4種類で上がった
3指標をbaselineとの差で並べると、動いた指標と動かなかった指標がはっきり分かれました。Recall@5はどの設定でも原点近くに張り付き、順位品質のnDCG@10とMRR@10だけがプラス側へ動きました。
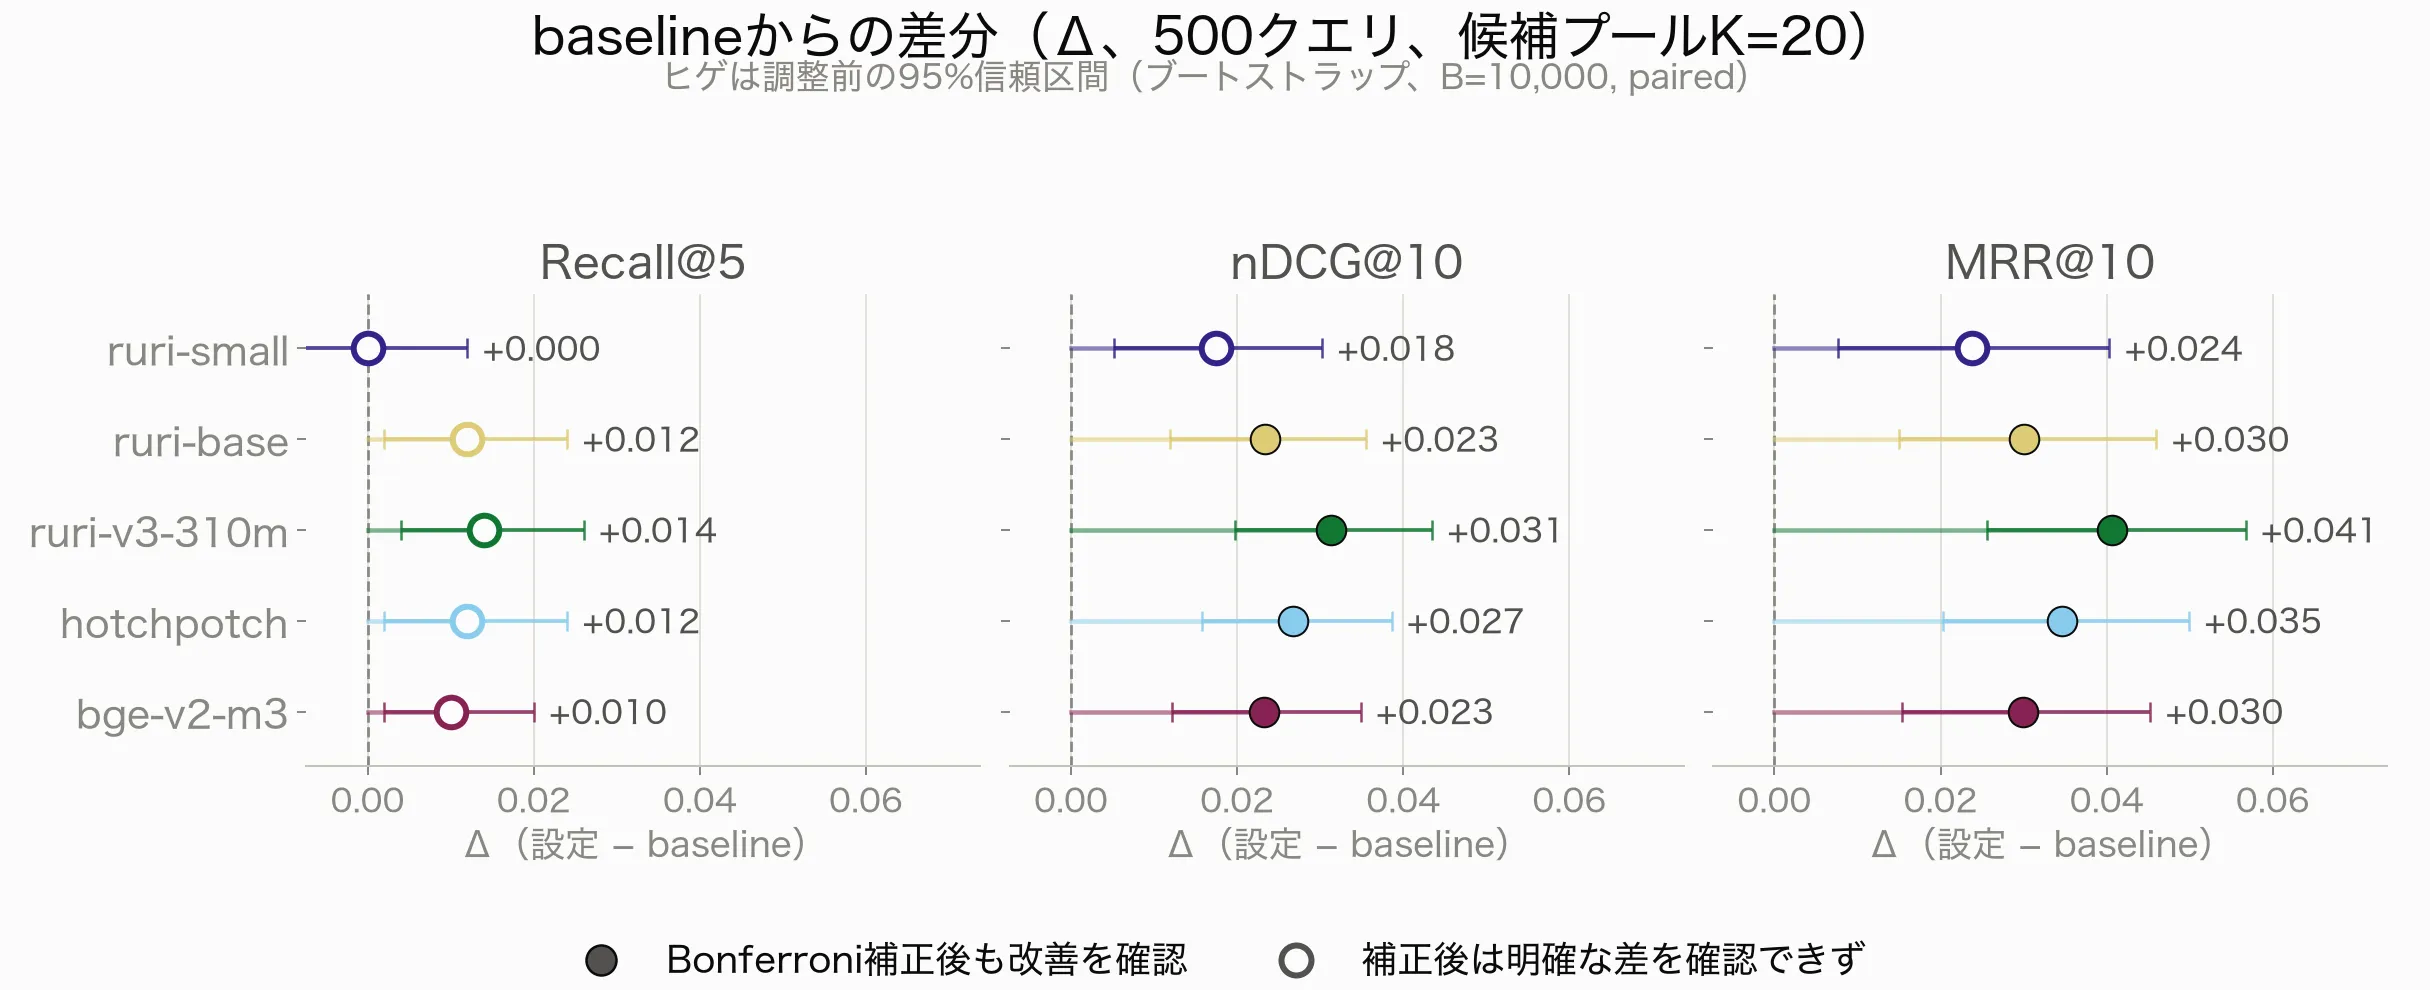
Recall@5は動いたが、一次検索が天井に近く差は残らなかった
上位5件に正解を入れられるかどうかは、リランカーを足しても変わりませんでした。つまり、取りこぼしの少なさを目的に足すなら、今回の条件では効果を確認できません。baselineのRecall@5は0.976で、5種類のどれを足しても差は最大+0.014でした。
質問数に直すと、値そのものは動いています。baselineが上位5件に正解を入れられなかったのは500問中12問で、測定値が最も高かったruri-v3-reranker-310mでは5問でした。内訳は、baselineが取りこぼした12問のうち7問を310mが上位5件へ入れ、逆に上位5件から落とした質問は0問です。
動く余地がそこで尽きるのは、リランカーが候補プールの中しか並べ替えられないからです。正解が上位20件に入っている割合(Recall@20)は0.99で、残る5問は500問のうちどのリランカーでも上位に出せない質問でした。310mのRecall@5=0.990は、正解が候補プールに入っている495問という上限とちょうど一致します。そのうえ一次検索だけでRecall@5が0.976あるので、上位5件に入れるという目的でリランカーが働ける余白は、最初から7問分しかなかったことになります。
6設定の総当たり15ペアを見比べる分を割り引くと差が残らなかったのも、動かせる余白が最大7問しかなく、この標本では拾いきれないためです。効果が無いことを確かめた結果ではありません。
ただしこれは一次検索の質が高い今回の条件での話です。その高さには、評価に使ったJSQuADが一次検索モデルの学習データにもデータ源として含まれることが効いている可能性があります(適用範囲と限界)。一次検索がもっと弱く、正解が上位5件からこぼれる質問が多ければ、リランカーの出番はここでも変わってきます。
順位品質(nDCG@10・MRR@10)は4種類で改善
正解を「5件に入れる」のではなく「より上位へ押し上げる」力を見ると、様子が変わります。nDCG@10・MRR@10は、5種類中4種類で改善を確認できました。 差の大きさはnDCG@10で+0.023〜+0.031、MRR@10では+0.030〜+0.041です。
同じ並べ替えなのにRecall@5と結果が分かれるのは、指標が測っている「良さ」の定義が違うからです。正解がすでに上位5件に入っていても、その中で順位を1つ2つ上げれば、nDCG@10・MRR@10は得点が増えます。Recall@5では拾えない改善を、こちらの2指標は拾えるわけです。
差が残らなかったのはruri-small1種類だけでした。測定値はbaselineより高い(nDCG@10で+0.018)ものの割り引くと差が消え、いちばん軽いモデルではこの条件で効果を読み切れませんでした。
精度は上位で横並び、待ち時間だけが6.7倍開いた
測定値の最高はruri-v3-reranker-310m、ただし上位どうしは区別できない
6設定を精度で並べると次のとおりです。太字は列内の測定値の最良値で、他の設定と明確な差があるとは限りません。
| 設定 | Recall@5 | nDCG@10 | MRR@10 |
|---|---|---|---|
| baseline | 0.976 | 0.9419 | 0.9268 |
| ruri-small | 0.976 | 0.9594 | 0.9506 |
| ruri-base | 0.988 | 0.9652 | 0.9569 |
| ruri-v3-reranker-310m | 0.990 | 0.9731 | 0.9674 |
| hotchpotch | 0.988 | 0.9686 | 0.9614 |
| bge-v2-m3 | 0.986 | 0.9651 | 0.9567 |
ruri-v3-reranker-310mがリランカー同士で差を検出できたのは、ruri-smallとの対だけでした。ruri-base・hotchpotch・bge-v2-m3との間では、この標本で差を区別できていません。つまり「最高精度」といっても、他の上位勢との差はノイズに紛れる程度だと考えてください。
精度がここまで拮抗すると、選択を分けるもう一つの軸は、並べ替えに支払う時間です。
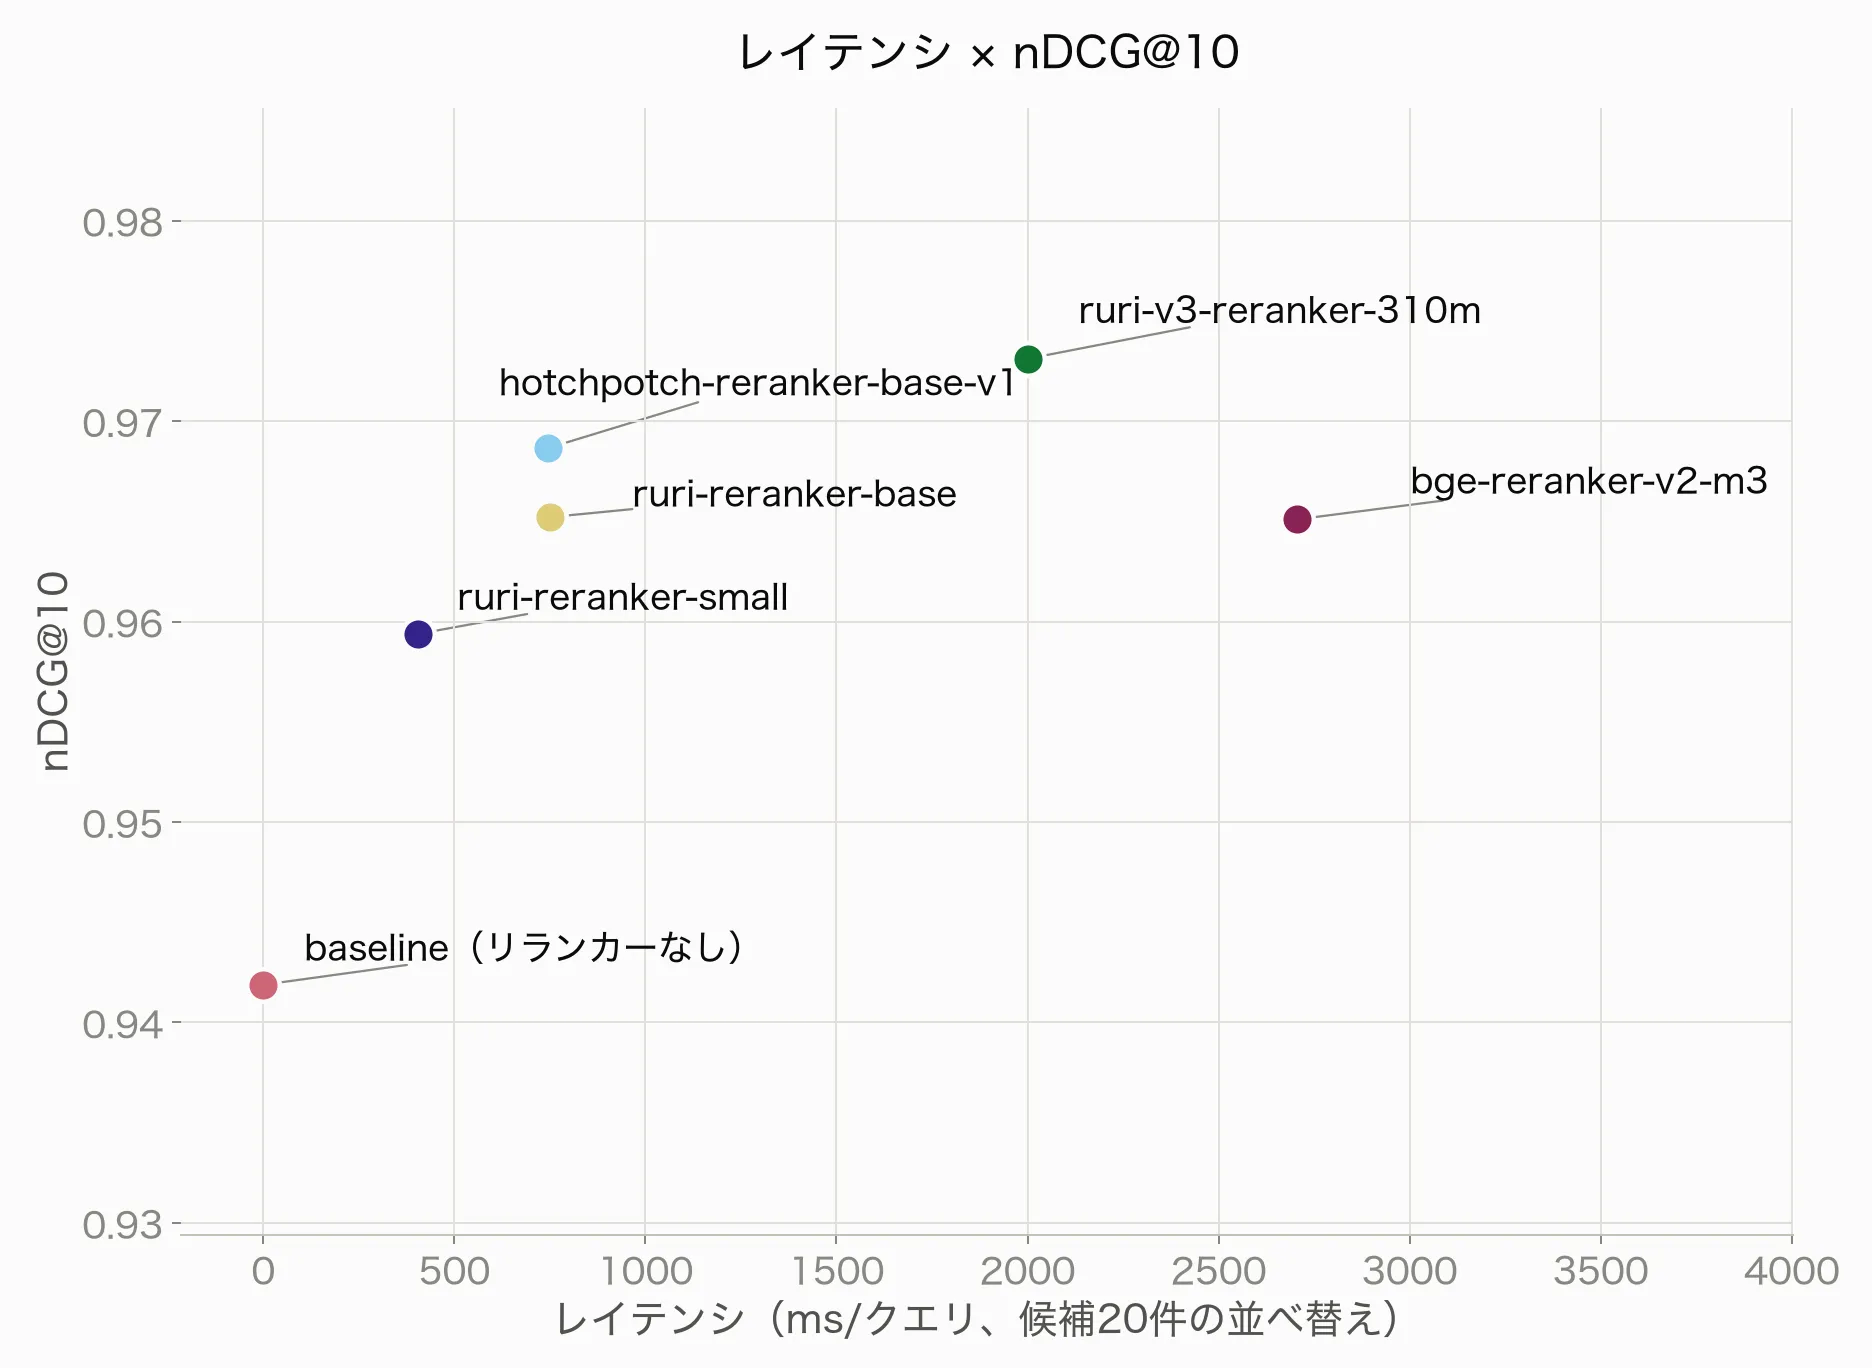
追加レイテンシは406msから2704msまで開いた
ここでの追加レイテンシは、リランキング処理だけにかかる1クエリ当たりの時間です。一次検索に必要な時間は含みません。
| 設定 | 追加レイテンシ(ms/クエリ) | パラメータ(実ロード値) | 重み(MB) |
|---|---|---|---|
| baseline | 0 | - | - |
| ruri-small | 406 | 68.7M | 274.7 |
| ruri-base | 750 | 111.2M | 444.9 |
| ruri-v3-reranker-310m | 2002 | 315.2M | 1,260.8 |
| hotchpotch | 745 | 111.2M | 444.9 |
| bge-v2-m3 | 2704 | 567.8M | 2,271.1 |
最速のruri-smallから最重のbge-v2-m3まで、約6.7倍の開きがありました。精度がほぼ横並びなのにコストがここまで違うので、選択は結局「どこまでレイテンシを払えるか」で決まります。
平均が同じでも、質問ごとの当たり外れは別物だった
集計値の差は、1つ1つの質問ではどう表れるのでしょうか。次の2件は、一次検索では6位以下だった正解を上位5件へ入れたリランカーの数が最大の質問(改善側)と、一次検索では上位5件にあった正解を6位以下へ落としたリランカーの数が最大の質問(悪化側)を、それぞれ1件ずつ機械的に取り出したものです(同数なら質問の並び順が先のもの)。目視の選定ではありません。
救った例は「梅雨の期間はだいたいどれぐらいか?」です。一次検索での正解は6位でした。ここでは5種類のリランカーすべてが正解を2位まで押し上げていて、500問の中でも5設定が揃って改善した稀な質問です。
悪化させた例は「生命の起源を提唱したのは」です。一次検索での正解は3位でしたが、リランク後は設定によって大きく割れました。
| 設定 | 正解のランク |
|---|---|
| baseline | 3位 |
| ruri-small | 7位 |
| ruri-base | 6位 |
| ruri-v3-reranker-310m | 3位 |
| hotchpotch | 10位 |
| bge-v2-m3 | 4位 |
small・base・hotchpotchの3設定が正解を6位以下に落としました。集計指標で区別できなかった310mとhotchpotchも、この質問では正反対に動いています。 310mは順位を維持し、hotchpotchは6設定中で最も悪化させました。平均が同じ高さに見えても、質問ごとの当たり外れは別物です。
順位を整えるならhotchpotchから、取りこぼしなら別の工程を見る
今回動いたのは、候補20件の中にすでにあった正解の順位です。一次検索が候補へ入れられなかった5問は、どのリランカーでも救えませんでした。取りこぼしを減らしたいのか、回答生成へ渡す先頭候補を整えたいのかで、導入価値は変わります。
順位品質を上げるのが目的なら、最初に置くのはhotchpotchです。 測定値が最も高いruri-v3-reranker-310mとの差は、この500問では区別できませんでした。点推定の開きもnDCG@10で0.0045です。それでいて追加レイテンシは約745msと、310mの約2002msに対して37%に収まります。まず中間のコストで質問ごとの順位変化を見て、必要なら上へ動かします。
測定値をそのまま採るならruri-v3-reranker-310m。 nDCG@10は6設定中で最高の0.9731でした。ただし1クエリに約2秒増えるため、精度の最後の一押しがその待ち時間に見合い、回答体験を変えるかを合わせて見ます。
レイテンシの予算がなければ、リランカーを足さない選択も残ります。 速度側の端はruri-smallの約406msですが、順位品質の上乗せは、この500問では区別できませんでした。一次検索だけで上位5件の取りこぼしが12問という状態なら、なおさらです。
多言語対応を理由にbge-v2-m3を選ぶなら、日本語の測定だけでは決められません。 追加レイテンシ約2704msを日本語側の結果で正当化できないため、多言語側の評価を別に用意して決める必要があります。
どのモデルを選ぶにしても、平均指標だけでなく、自分の運用で重要な質問を悪化させていないかを採用前に確かめます。固定長チャンクや回答生成まで含めた効果は未測定です。
詳しい検証条件
一次検索の ruri-v3-130m は埋め込みモデル9種を比べた回の実測で検索3指標が首位だったモデルで、コーパスとクエリ集合もその回と同一です。精度もレイテンシも、6設定の評価を実際に回したときのログに残った値だけを集計して載せています。
レイテンシは、候補20件を採点して並べ替える処理をウォームアップ後に3回実行し、総処理時間の中央値を500クエリで割った値です。
読み飛ばし可: 候補プール・正解判定・prefix・レイテンシ計測などの詳細
- 候補プール: 一次検索
ruri-v3-130mが返す上位20件(K=20)を全設定で共通に使い回します。設定間で変わるのは並べ替えのみです。 - Recall@5: リランキング後の上位5件に正解が入っていれば成功。baselineは一次検索そのままの上位5件です。
- nDCG@10・MRR@10: リランキング後の上位10件で判定します。正解が候補プールに含まれない質問は寄与を0として扱います。
- 一次検索の候補プール上限(Recall@20): 正解が上位20件に入っている質問の割合。全設定共通で0.99(500問中495問)でした。
- リランカーの呼び出し: 5モデルすべて
sentence_transformers.CrossEncoder経由、(query, passage)のタプル入力で統一。prefixは付与しません(各モデルの公式仕様に準拠)。 - デバイス・バッチ: 全設定でMPS・
batch_size=20に統一しています。 - 報告方針: 全6設定×全指標を報告しています(都合の悪い結果も含みます)。
- baselineは一次検索の順位をそのまま採用する対照群のため、上のリランカー一覧には含めていません。埋め込みモデル比較の回で扱った
ruri-v3-310mとは別モデルのため、310mだけはrerankerを省略しません。 - 使用データJGLUE(JSQuAD)はCC BY-SA 4.0で公開されています。一次検索の再計算値が、埋め込みモデル比較の回の公表値と一致することは確認済みです。
読み飛ばし可: 統計手法・全15ペアの検定結果
6設定はすべて同じ500問を通しているので、対応のある比較として扱い、設定を多数見比べる影響も割り引いて判定しました。差の幅は、同じ500問を対で再標本化するブートストラップ95%信頼区間(B=10,000・seed=42・paired。評価クエリに対する推定の不確実性で、実行時間の測定ばらつきではありません)で見ています。Recall@5だけは成功・失敗の2値なので、対応のあるexact両側のMcNemar検定を併用しました。全15ペア×3指標の同時比較のため、指標ごとに15ペアの検定族を分けてBonferroni補正(α=0.05/15≈0.0033)を適用しています。全指標をまとめた45検定を1家族とするより保守的な代替でも算出しており、判定が変わったのは1件(baseline対ruri-smallのMRR@10、Holm法のみ)だけでした。
指標ごとに、素の信頼区間で差が0を含まなかったペア数と、補正後も差が残ったペア数は次のとおりです。
| 指標 | 補正前のCIで差が0を含まないペア | 補正後も差が残ったペア |
|---|---|---|
| Recall@5 | 7/15 | 0/15 |
| nDCG@10 | 9/15 | 5/15 |
| MRR@10 | 9/15 | 5/15 |
baselineと各リランカーの5ペアでは、nDCG@10・MRR@10はruri-base・ruri-v3-reranker-310m・hotchpotch・bge-v2-m3の4設定で補正後も差が残り、Recall@5は5ペアとも残りませんでした。baselineに対して差が残った4設定の大きさは、nDCG@10で+0.0232〜+0.0312、MRR@10で+0.0299〜+0.0406です。Recall@5はbaselineとの5比較で最小の生p値(baseline対ruri-v3-reranker-310m、0.0156)でも補正基準0.0033に届きませんでした。
| ペア (A vs B) | ΔRecall@5 [95%CI] | ΔnDCG@10 [95%CI] | ΔMRR@10 [95%CI] | McNemar p (R@5) |
|---|---|---|---|---|
| baseline vs ruri-small | +0.0000 [-0.0120, +0.0120] | -0.0175 [-0.0302, -0.0052]† | -0.0238 [-0.0403, -0.0076]† | 1.0000 |
| baseline vs ruri-base | -0.0120 [-0.0240, -0.0020]† | -0.0233 [-0.0355, -0.0119]‡ | -0.0301 [-0.0460, -0.0150]‡ | 0.0703 |
| baseline vs ruri-v3-reranker-310m | -0.0140 [-0.0260, -0.0040]† | -0.0312 [-0.0435, -0.0198]‡ | -0.0406 [-0.0567, -0.0256]‡ | 0.0156 |
| baseline vs hotchpotch | -0.0120 [-0.0240, -0.0020]† | -0.0268 [-0.0386, -0.0157]‡ | -0.0346 [-0.0499, -0.0203]‡ | 0.0703 |
| baseline vs bge-v2-m3 | -0.0100 [-0.0200, -0.0020]† | -0.0232 [-0.0349, -0.0121]‡ | -0.0299 [-0.0452, -0.0154]‡ | 0.0625 |
| ruri-small vs ruri-base | -0.0120 [-0.0220, -0.0040]† | -0.0058 [-0.0141, +0.0021] | -0.0063 [-0.0169, +0.0038] | 0.0312 |
| ruri-small vs ruri-v3-reranker-310m | -0.0140 [-0.0240, -0.0040]† | -0.0137 [-0.0222, -0.0060]‡ | -0.0168 [-0.0277, -0.0069]‡ | 0.0156 |
| ruri-small vs hotchpotch | -0.0120 [-0.0220, -0.0040]† | -0.0093 [-0.0182, -0.0008]† | -0.0109 [-0.0222, -0.0002]† | 0.0312 |
| ruri-small vs bge-v2-m3 | -0.0100 [-0.0200, +0.0000] | -0.0057 [-0.0136, +0.0016] | -0.0062 [-0.0161, +0.0029] | 0.1250 |
| ruri-base vs ruri-v3-reranker-310m | -0.0020 [-0.0060, +0.0000] | -0.0079 [-0.0149, -0.0013]† | -0.0105 [-0.0198, -0.0017]† | 1.0000 |
| ruri-base vs hotchpotch | +0.0000 [+0.0000, +0.0000] | -0.0034 [-0.0099, +0.0028] | -0.0046 [-0.0132, +0.0038] | 1.0000 |
| ruri-base vs bge-v2-m3 | +0.0020 [-0.0040, +0.0100] | +0.0001 [-0.0073, +0.0077] | +0.0001 [-0.0098, +0.0102] | 1.0000 |
| ruri-v3-reranker-310m vs hotchpotch | +0.0020 [+0.0000, +0.0060] | +0.0045 [-0.0016, +0.0108] | +0.0060 [-0.0022, +0.0144] | 1.0000 |
| ruri-v3-reranker-310m vs bge-v2-m3 | +0.0040 [+0.0000, +0.0100] | +0.0080 [+0.0017, +0.0148]† | +0.0107 [+0.0022, +0.0197]† | 0.5000 |
| hotchpotch vs bge-v2-m3 | +0.0020 [-0.0040, +0.0100] | +0.0036 [-0.0020, +0.0095] | +0.0047 [-0.0028, +0.0126] | 1.0000 |
‡: Bonferroni補正後(指標ごと15家族、α=0.05/15≈0.0033)も有意。†: 補正前の95%CIは0を含まないものの、15ペア分を割り引くと有意とは言えなくなるもの(探索的な手がかりとして載せています)。記号なし: 補正前の95%CIの段階で0をまたいでいるペアです。より緩やかなHolm法ではbaseline対ruri-smallのMRR@10のみ補正後も有意となりますが、本記事は保守的なBonferroni法を基準に統一しています。なお、AとBの間、BとCの間で差を区別できなくても、AとCの間にだけ差が残ることがあります。ペアごとの判定は「差を区別できない者同士をつなげば全員が同じ」という推移的な性質を持たないためで、矛盾ではありません。
適用範囲と限界
- 一次検索モデルとデータを固定した条件: JSQuAD valid・M1単一環境で、一次検索はruri-v3-130mに固定しています。一次検索を変えると、リランカーの効き方が同じ傾向になるとは限りません。
- 評価データと学習データの重なりを検査していない: 評価に使ったJSQuADは、一次検索のruri-v3-130mとruri-v3-reranker-310mの公開学習データ(ruri-v3-dataset-ft・ruri-v3-dataset-reranker)にもデータ源として含まれています。学習側はいずれもtrain split、今回の評価はvalidation splitですが、両者の質問や段落がどれだけ重なるかは検査していません。一次検索のRecall@5=0.976という高さも、モデル間の順位も、この影響を切り分けられていない値です。hotchpotchとbge-v2-m3については同じ確認をしていないため、この点で全モデルが対等な条件だとも言い切れません。
- 候補プールK=20固定: Kを変えれば天井(Recall@20)自体が動き、リランカーの効果もレイテンシとの兼ね合いも変わり得ます。本実験はK=20だけを対象にしています。
- 回答生成は測っていない: 対象は検索の並べ替えまでです。並べ替えた候補を渡した後、最終的な回答がどれだけ良くなるかは評価していません。
- 「差を区別できなかった」は「同等」ではない: リランカー同士の多くの対で差を検出できませんでしたが、これは同じ性能の証明ではありません。個別クエリでは挙動が分かれます(具体例を参照)。
- 段落単位の検索という条件: 固定長チャンクへの再分割は行っておらず、チャンク戦略とリランカーの交互作用は未検証です。
- レイテンシの絶対値: 計測順は無作為化していないため絶対値は環境で前後し得ますが、設定間の速い遅いの順位には影響しないと考えています。
- 未計測のリランカー: Qwen3-Reranker・jina-reranker-v3などは今回計測していません。次回の計測候補です。
手元のPythonで並べ替えを動かす
起点に挙げたhotchpotchで、実際に並べ替えを動かします。どちらのコードもGPU不要でCPUだけで完結します。
日本語のリランカーはMeCab辞書(fugashi・unidic-lite)を必要とします。下記の依存に含めてありますが、計測のときはこれを入れるまで5モデル中3モデルがモデルの読み込みで止まりました。トークナイザを認識できないというエラーで、主因は形態素解析の依存が抜けていたことでした(3モデルのうち1つは、独自トークナイザを読むための trust_remote_code=True も必要でした)。デバイス側の非互換ではありません。
もう一つ注意点として、transformers はバージョン 4.57.6 に固定してください。固定しないとリランカーの出力スコアが変わり、下記の実行結果と一致しなくなることを確認しています。
最小デモ: リランカー単体で並べ替える
リランカーにクエリと各文書のペアを渡して採点し、高い順に並べ替えるだけのコードです。一次検索は省略しているので、これ単体でそのまま動きます。
from sentence_transformers import CrossEncoder

# hotchpotch は MeCab(fugashi + unidic-lite)を使うので両パッケージが必要
reranker = CrossEncoder("hotchpotch/japanese-reranker-cross-encoder-base-v1", device="cpu")

query = "有給はいつから取れますか?"
documents = [
    "有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに行う。",
    "経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行う。",
    "半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映される。",
]

# クエリと各文書のペアにスコアを付け、高い順に並べ替える
scores = reranker.predict([(query, d) for d in documents])
for i in sorted(range(len(documents)), key=lambda i: -scores[i]):
    print(f"{scores[i]:.4f}  {documents[i]}")
完全版: 一次検索から並べ替えまで通す
一次検索を cl-nagoya/ruri-v3-130m のコサイン類似度で行い、上位6件を候補プールとして取り、その中をリランカーで並べ替えます。手元のApple M1 CPUで約12.8秒でした(モデルがキャッシュ済みの状態。初回はモデルのダウンロード計約0.98GBが加わります)。以下を quickstart_reranker.py として保存します。
from sentence_transformers import CrossEncoder, SentenceTransformer

DEVICE = "cpu"  # 掲載出力と一致させるため固定

# 以下は自分のデータに置き換えて使う
DOCUMENTS = [
    "有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに行う。",
    "経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行う。",
    "社内VPNに接続するには、多要素認証アプリでワンタイムパスワードを生成する必要がある。",
    "本番環境へのデプロイは、プルリクエストが2名以上のレビュー承認を得た後にのみ実行できる。",
    "リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求められる。",
    "問い合わせ対応の一次窓口はサポートチームで、営業時間は平日9時から18時までである。",
    "半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映される。",
    "有給休暇の買い取りは原則禁止だが、退職時に限り未消化分を精算できる場合がある。",
]

QUERIES = [
    "有給はいつから取れますか?",
    "本番にデプロイする条件は?",
]

TOP_K_POOL = 6  # 一次検索で取る候補数(リランキングはこの範囲内で並べ替える)


def main() -> None:
    print(f"device: {DEVICE}")

    embed_model = SentenceTransformer("cl-nagoya/ruri-v3-130m", device=DEVICE)
    # 検索では "検索文書: " prefix が必須
    doc_embeddings = embed_model.encode(
        ["検索文書: " + d for d in DOCUMENTS],
        normalize_embeddings=True,
        convert_to_numpy=True,
    )

    # hotchpotch は MeCab(fugashi + unidic-lite)を使うトークナイザなので両パッケージが必要
    reranker = CrossEncoder("hotchpotch/japanese-reranker-cross-encoder-base-v1", device=DEVICE)

    for query in QUERIES:
        # クエリ側は "検索クエリ: " prefix
        query_embedding = embed_model.encode(
            "検索クエリ: " + query,
            normalize_embeddings=True,
            convert_to_numpy=True,
        )
        scores = doc_embeddings @ query_embedding  # 正規化済みなのでコサイン類似度
        pool_order = scores.argsort()[::-1][:TOP_K_POOL]

        print(f"\nクエリ: {query}")
        print("  [一次検索の順位(before)]")
        for rank, idx in enumerate(pool_order, start=1):
            print(f"    {rank}. score={scores[idx]:.4f}  {DOCUMENTS[idx]}")

        # 一次検索の上位候補だけをリランカーに通す(候補プールの外は救えない)
        pairs = [(query, DOCUMENTS[idx]) for idx in pool_order]
        rerank_scores = reranker.predict(pairs)
        rerank_order = sorted(range(len(pool_order)), key=lambda i: -rerank_scores[i])

        print("  [リランク後の順位(after)]")
        for rank, i in enumerate(rerank_order, start=1):
            idx = pool_order[i]
            primary_rank = i + 1
            moved = " (順位変動なし)" if primary_rank == rank else f" (一次検索では{primary_rank}位)"
            print(f"    {rank}. score={rerank_scores[i]:.4f}  {DOCUMENTS[idx]}{moved}")


if __name__ == "__main__":
    main()
依存の導入から実行までは、次のとおりです。
# uv を使う場合(推奨)
uv venv --python 3.12
uv pip install sentence-transformers "transformers==4.57.6" sentencepiece protobuf fugashi unidic-lite
uv run --no-project python quickstart_reranker.py

# pip を使う場合
python3.12 -m venv .venv
source .venv/bin/activate        # Windows は .venv\Scripts\activate
pip install sentence-transformers "transformers==4.57.6" sentencepiece protobuf fugashi unidic-lite
python quickstart_reranker.pyfugashi・unidic-lite はhotchpotchが使うMeCab形態素解析トークナイザに必要です。sentencepiece・protobuf は cl-nagoya/ruri-v3-130m のトークナイザ読み込みに使います。--no-project は、保存先の親ディレクトリに別の pyproject.toml があると素の uv run がそちらの環境を掴んでしまうのを避けるためです。
実行結果の全文
device: cpu

クエリ: 有給はいつから取れますか?
  [一次検索の順位(before)]
    1. score=0.9115  半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映される。
    2. score=0.8733  有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに行う。
    3. score=0.8635  有給休暇の買い取りは原則禁止だが、退職時に限り未消化分を精算できる場合がある。
    4. score=0.8332  リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求められる。
    5. score=0.8231  経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行う。
    6. score=0.7939  問い合わせ対応の一次窓口はサポートチームで、営業時間は平日9時から18時までである。
  [リランク後の順位(after)]
    1. score=0.7114  有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに行う。 (一次検索では2位)
    2. score=0.2538  半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映される。 (一次検索では1位)
    3. score=0.0636  有給休暇の買い取りは原則禁止だが、退職時に限り未消化分を精算できる場合がある。 (順位変動なし)
    4. score=0.0522  経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行う。 (一次検索では5位)
    5. score=0.0161  リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求められる。 (一次検索では4位)
    6. score=0.0093  問い合わせ対応の一次窓口はサポートチームで、営業時間は平日9時から18時までである。 (順位変動なし)

クエリ: 本番にデプロイする条件は?
  [一次検索の順位(before)]
    1. score=0.9212  本番環境へのデプロイは、プルリクエストが2名以上のレビュー承認を得た後にのみ実行できる。
    2. score=0.8329  社内VPNに接続するには、多要素認証アプリでワンタイムパスワードを生成する必要がある。
    3. score=0.8297  リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求められる。
    4. score=0.7912  半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映される。
    5. score=0.7827  問い合わせ対応の一次窓口はサポートチームで、営業時間は平日9時から18時までである。
    6. score=0.7772  経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行う。
  [リランク後の順位(after)]
    1. score=0.9193  本番環境へのデプロイは、プルリクエストが2名以上のレビュー承認を得た後にのみ実行できる。 (順位変動なし)
    2. score=0.0212  半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映される。 (一次検索では4位)
    3. score=0.0176  リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求められる。 (順位変動なし)
    4. score=0.0176  経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行う。 (一次検索では6位)
    5. score=0.0168  社内VPNに接続するには、多要素認証アプリでワンタイムパスワードを生成する必要がある。 (一次検索では2位)
    6. score=0.0067  問い合わせ対応の一次窓口はサポートチームで、営業時間は平日9時から18時までである。 (一次検索では5位)
「有給はいつから取れますか?」では、一次検索で1位だった「半休」の文書に代わり、リランク後は本来の正解「有給休暇は入社6か月後から10日付与」が1位に入れ替わりました。一次検索のスコア(コサイン類似度)とリランカーのスコアは尺度が違うため、比べられるのは値そのものではなく、それぞれの中での順位だけです。候補プール(このデモでは上位6件)の外にある文書は、リランカーがどれだけ優秀でも上位には出てきません。
リランカーを足す前に、どこで詰まっているかを見る
今回の設定では、リランカーの選び方より一次検索の出来のほうが結果を左右していました。一次検索は1モデルに固定しているので、モデル間で比べた話ではありません。候補20件の中に正解が入っていない質問は、どのモデルを後ろに足しても動かない、という構造の話です。足すかどうかを決める前に、正解が候補に入っているのか、それとも入っているのに下に沈んでいるのかを、自分のデータで数えるのが先になります。
平均だけを見て入れ替えると、質問1件ごとの動きは見えません。同じ集計値に見えるモデルどうしでも、1問の中では順位が反対方向へ動くことがあります。
次に確かめたいのは、一次検索が弱い条件でも同じ結論になるかです。今回は検索指標で首位だったモデルに固定したため、リランカーに残された余白が最初から狭い状態で測っています。今回入れられなかったリランカーも残っており、そちらは記事末の限界に挙げたとおりです。
リランカーの手前にあるチャンク・一次検索・RRFも含め、どの工程から見直すべきか迷っている場合は、入口記事「RAGの検索精度を上げる方法」で順を追って確認できます。
出典: 評価データ JGLUE(JSQuAD): Kurihara et al., “JGLUE: Japanese General Language Understanding Evaluation”, LREC 2022 / yahoojapan/JGLUE(CC BY-SA 4.0)。一次検索モデル: cl-nagoya/ruri-v3-130m(Tsukagoshi & Sasano, arXiv:2409.07737、Apache-2.0)。各リランカーのライセンスと使用方法はHugging Face上のモデルカードで確認しました。