
「燃料を入れるところは」という質問の正解の段落に書いてあるのは、「ガソリンスタンド」でした。質問文と重なる語がひとつもありません。語がどれだけ一致するかで順位を付ける古典的な検索は、検索対象にした1,145段落のうち917位までこの段落を落としました。文章を数値の並びへ変換して意味の近さで探す方式なら、同じ段落が10位です。外し方が、方式によって正反対になります。
意味の近さで探す方式は、言い回しが違っても正解を引き当ててくれます。ただし、探している語が正解の中にそのまま書いてある質問で、かえって沈むことがあります。
「定数1とは何か?」がその例です。正解の段落に「定数1」と書いてあるのに、意味で探すと57位、語の一致で探すと10位でした。
得意分野が正反対なら、両方を走らせて結果を混ぜればいい。ハイブリッド検索と呼ばれるこの考え方は自然ですが、索引を2種類持ち、検索を2本走らせる運用が増えます。平均の点数が少し上がっただけでは、その手間に見合うのかも、大事な質問が悪くなっていないのかも分かりません。そこで3方式に同じ500問を通しました。
先に結論
- BM25(キーワード検索)とdense(意味検索)は、単体どうしでは検索3指標に区別できる差が出なかった。片方をもう片方へ置き換える根拠は今回の実測にない。
- 2つの検索結果を混ぜるRRF融合は、正解を上位へ置けたかを見る順位品質(nDCG@10・MRR@10)でdense単体を+0.013・+0.017上回った。ただしBM25単体を基準にすると、この差は確認できていない。
- 取りこぼしの少なさ(Recall@5)は、改善を確認できなかった。RRF融合が効いたのは取りこぼしを減らす側ではなく、すでに見つけた正解の順位を整える側。
- dense検索がすでに動いているなら、増えるのはBM25の索引と検索1本ぶん。1,145段落の索引は1秒かからずに作れる。
- 射程は、Wikipedia由来の日本語QAデータ(JSQuAD)から作った1,145段落と500問。埋め込みモデルは1種類、順位を足すときの重み係数k(RRFの統合パラメータ)は60に固定。
語で探す方式、意味で探す方式、その2つを混ぜる方式
質問に関係しそうな文書を、大量の候補から絞り込む工程を一次検索と呼びます。検索した文書を生成AIへ渡して答えさせる仕組み(RAG)のうち、この記事が触るのはここだけです。RAGで精度が落ちる4つの場所で言えば、正解が候補に入るかどうかと、入った正解が上位へ来るかどうかの2段階にまたがる工程で、今回動いたのは後者でした。その手前、文書を切り分けた時点で根拠が分断されている場合は、ここを直しても届きません。
検索エンジンを自作した経験は要りません。2つの方式が何をしているかと点数の読み方、そしてその2つを混ぜるRRFの仕組みだけ押さえれば先へ進めます。
- BM25: 質問と文書で語がどれだけ一致するかを見て順位を付けます。索引は語の出現統計だけで作れます。
- dense: 文章をベクトル(数値の並び)へ変換し、意味の近さで順位を付けます。変換には日本語向けの埋め込みモデル
cl-nagoya/ruri-v3-130m(以降ruri-v3-130m)を使いました。 - Recall@5: 上位5件のどこかに正解の段落が入っていた質問の割合です。何位かは問いません。
- nDCG@10・MRR@10: 上位10件の中で正解が何位にいたかを点数にしたもので、上にあるほど1へ近づきます。この記事では2つをまとめて順位品質と呼びます。
RRF(Reciprocal Rank Fusion)とは
RRFは、denseとBM25が出した順位「だけ」を足し合わせ、1本の順位にまとめる融合方式です。各文書の順位を1/(k+順位)へ変換してから2方式ぶんを足すので、スコアの大きさは使わず、尺度の違う2方式をそのまま混ぜられます。統合パラメータkは60に固定して測っています。
同じコーパスと同じ500問へ、3方式をそのまま通した
評価に使ったのは、日本語の質問応答データJGLUE(JSQuAD)由来の1,145段落と500問です。埋め込みモデル比較の回とリランカーの回で使ったコーパスと、seed 42で固定した同じクエリをそのまま再利用しています(チャンク分割の回だけは、文書の作り方もクエリの抽出手順も別です)。JSQuADはWikipedia由来の一般知識QAなので、型番や製品コードの完全一致がものを言う検索とは性格が違います。
3方式とも1,145段落を最後まで順位づけし、JSQuADが各質問に付けた正解段落のラベルでRecall@5・nDCG@10・MRR@10を計算します。候補を絞ってから比べる近似検索は使っていません。RRFは2方式のスコアではなく順位を足し合わせ、統合パラメータkは60に固定しました。
dense単体の数値は、埋め込みモデル9種を比べた回で得た値とビット単位で一致することを確認しています。掲載した数値は、3方式の検索を実際に実行しながら保存したログが出どころです。差の判定は、同じ500問に3方式を通した対応のある比較で行いました。測っていない条件は記事の終盤にまとめてあります。
単体どうしは区別できず、混ぜるとdense単体より上へ来た
3方式の測定値です。差はどれも0.02未満に収まり、並びは3指標ともRRF融合が最も高くなりました。
| 方式 | Recall@5 | nDCG@10 | MRR@10 |
|---|---|---|---|
| dense単体 | 0.976 | 0.9419 | 0.9268 |
| BM25単体 | 0.972 | 0.9467 | 0.9356 |
| RRF融合 | 0.984 | 0.9550 | 0.9433 |
太字は各指標の最良値です。数値は丸めて表記しています。
片方をもう片方へ置き換える根拠は出てこなかった
測定値の並びだけを見ると、順位品質はdense単体よりBM25単体がわずかに上です。ただし3ペアを同時に比べる影響まで割り引くと、3指標のどれでも差は残りません。同等だと確かめたのではなく、この500問では白黒が付かなかったということです。
意味検索を丸ごとキーワード検索へ置き換える根拠も、その逆の根拠も、今回の実測にはありません。 ここが出発点になります。BM25の強みが表に出るのは平均値ではなく、語が完全に一致する個別のクエリの側で、その様子は後半で1件ずつ見ます。
混ぜて上がったのは順位、取りこぼしの改善は確認できなかった
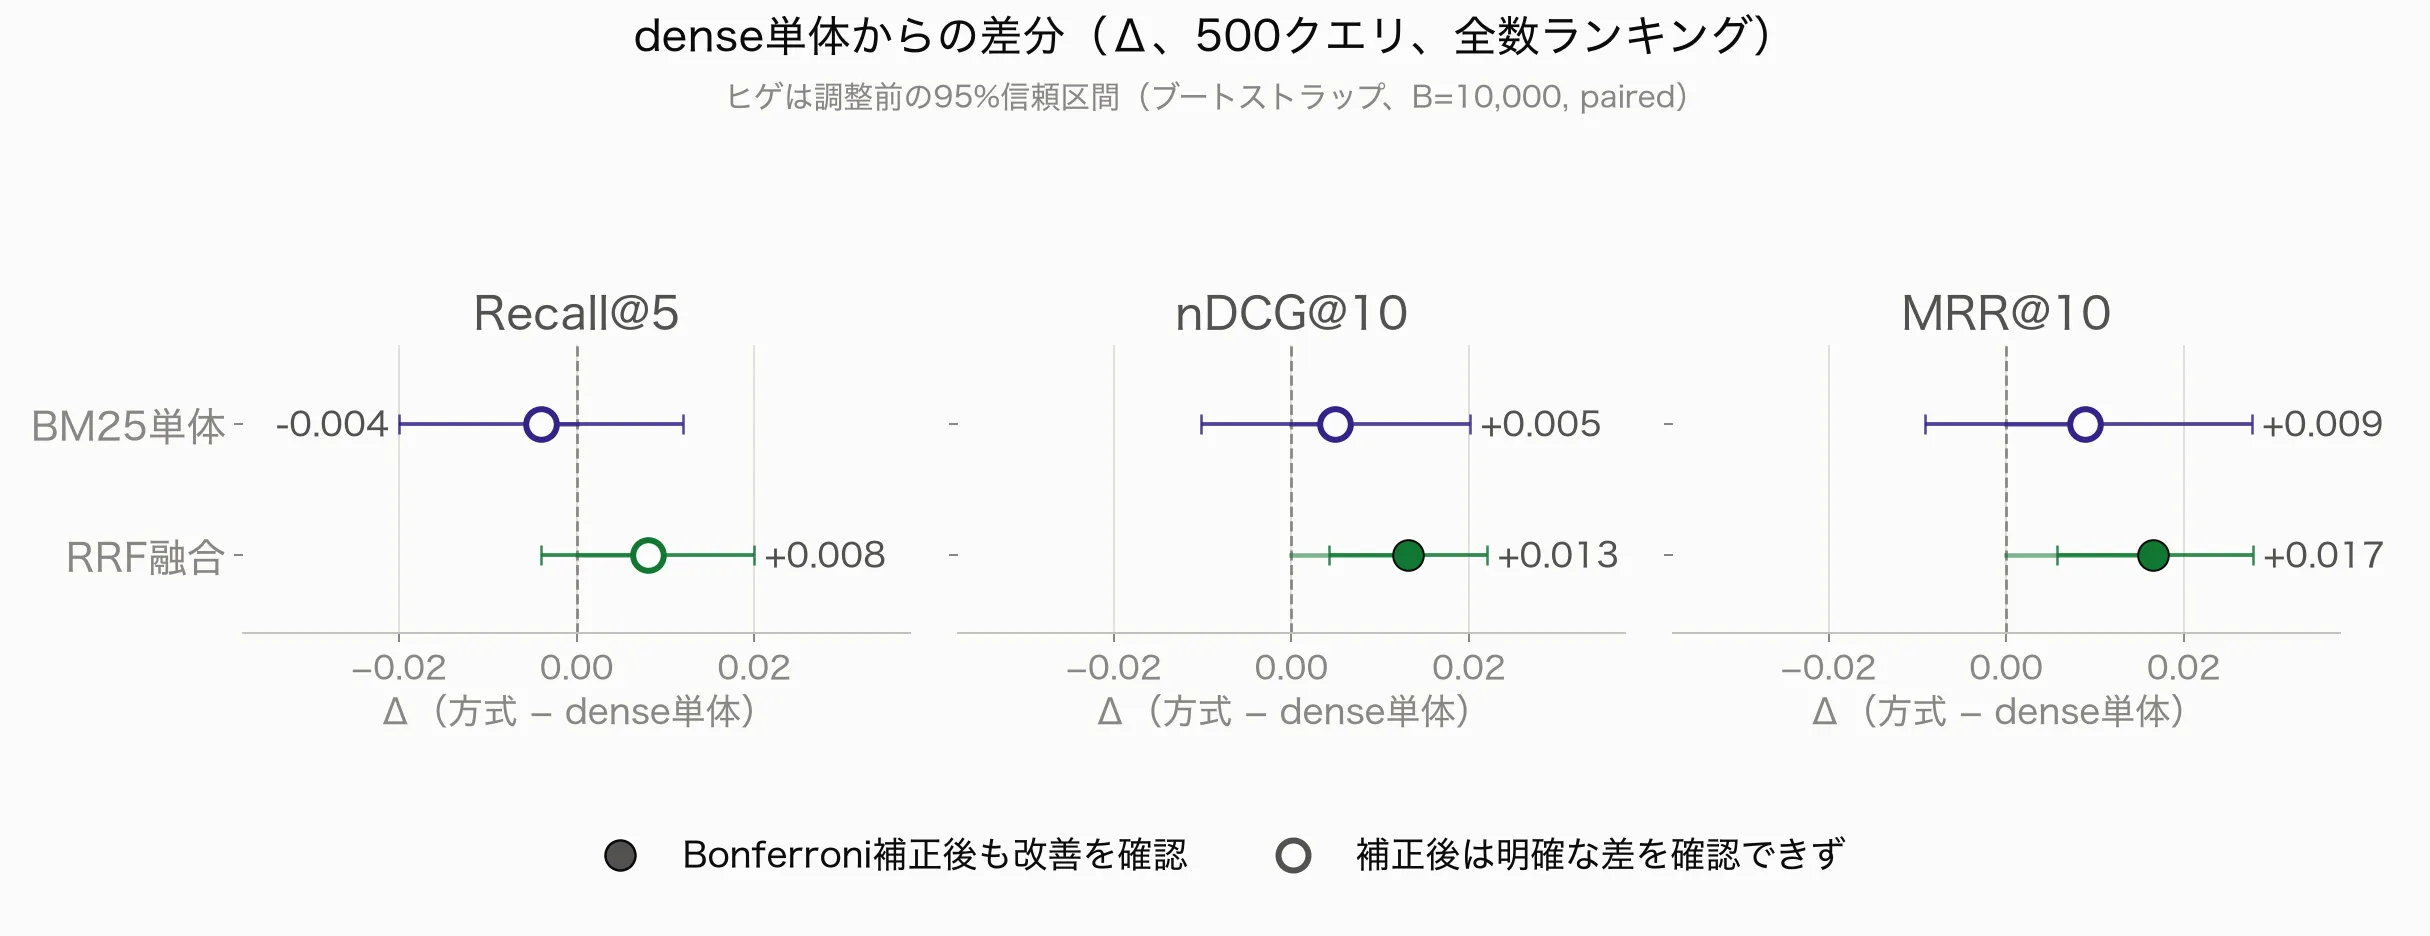
RRF融合はdense単体に対し、nDCG@10で+0.013、MRR@10で+0.017の改善を確認できました。 同じ正解を見つけていても、それを何位に置けるかが上がった、ということです。
ただしこれは基準がdense単体のときの話です。BM25単体に対する差は同じ評価では確認できていません。測定値はnDCG@10・MRR@10とも+0.008ですが、偶然のばらつきを割り引くと差は残りませんでした。つまりこの伸びのうち、どこまでが2つの順位を混ぜたこと自体の効果で、どこからがBM25側の順位が持ち込んだ分なのかは、今回の実測では切り分けられていません。
一方、Recall@5はRRF融合でも明確な差を確認できませんでした。dense単体の時点で0.976と天井に近く、上位5件に入る正解をこれ以上増やす余地がほとんど残っていないためです。混ぜても取りこぼしは減らないと読むより、この500問には減らせる取りこぼしがほとんど残っていなかった、と読む方が正確です。
RRFは、各文書の順位を1/(k+順位)へ変換してから足します。denseとBM25で尺度の違うスコアを直接比べず、どちらかが上位に置いた文書を持ち上げられる仕組みです。この仕組みは今回の改善と整合しますが、どの質問でどちらの寄与が効いたかを全件で分解したわけではありません。片方が大きく外すと、融合後の順位を引き下げる場合もあります。
索引も検索もBM25が桁違いに軽い
精度が僅差になる一方で、索引の作りやすさと検索の速さはBM25が明確に有利です。
| 方式 | 索引構築(1,145段落、秒) | クエリ1件あたりのレイテンシ(ms) |
|---|---|---|
| dense単体 | 26.29 | 23.5 |
| BM25単体 | 0.22 | 1.5 |
| RRF融合 | 索引を再利用(単独計測なし) | 25.1 |
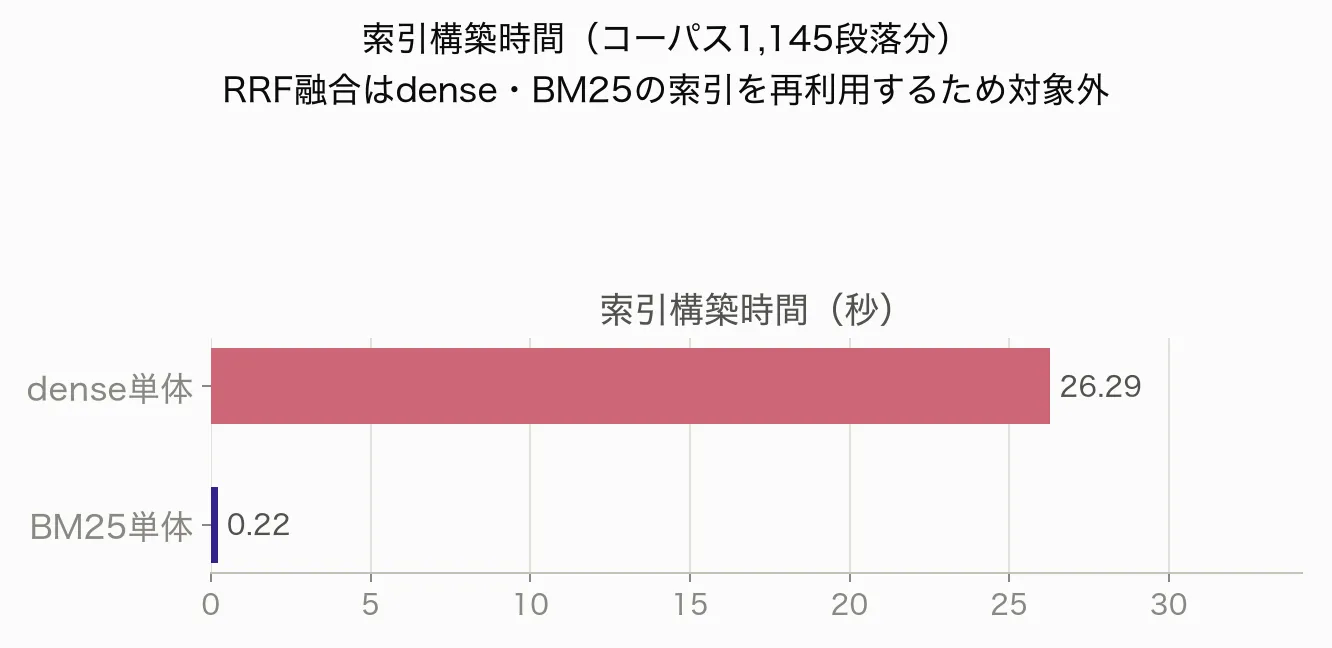
索引構築はBM25がdenseのおよそ120倍速く、1,145段落でも1秒かかりません。
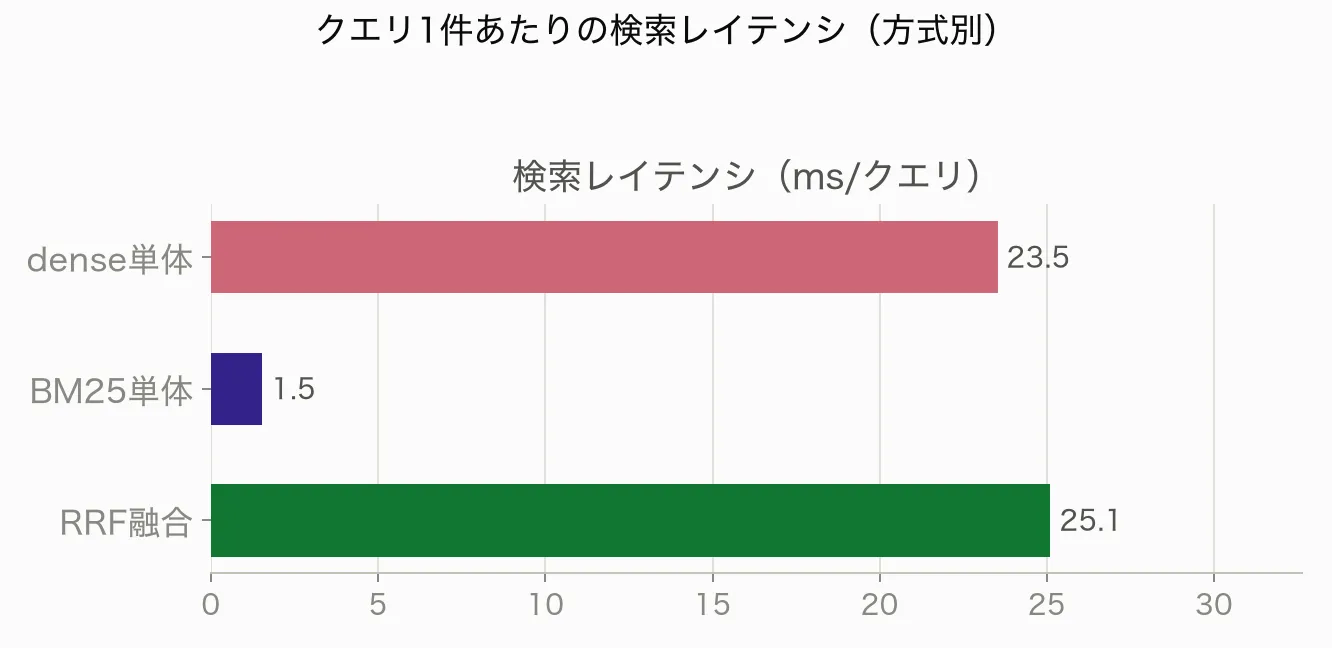
RRF融合はdenseとBM25の両方を走らせてから順位を統合するので、レイテンシは両者の合計になります。融合そのものの計算は約0.05msで無視できる水準です。つまりハイブリッド検索の追加コストは、実質「BM25の検索をもう1本足す」だけです。
この時間はApple M1・全数検索での実測値で、絶対値はハードウェアが変われば動きますが、大小関係(BM25が最も軽く、次にdense、RRF融合は両者の合計)は他の環境でも移りやすいと見ています。
平均では見えない、救われた質問と引きずられた質問
冒頭で挙げた2件は、実データから機械的に抜いたものです。抽出ルールは「dense単体からの順位変化が最大だった質問を、改善・悪化それぞれ1件ずつ」で、結果を見る前に決めました。質問文はJSQuADの実際の設問の原文です。
BM25が救ったのは、冒頭の「定数1とは何か?」でした。正解段落に「定数1」がそのまま出てくるため、語の完全一致に強いBM25が効きます。dense単体で57位だった正解を、BM25単体は10位、RRF融合は9位に置いています。 この質問で順位を持ち上げたのはBM25側で、融合はその順位をほぼそのまま引き継いだ形です。
救えなかったのが「燃料を入れるところは」です。BM25が917位まで落とした影響は融合後にも残り、RRF融合は39位まで戻したものの、dense単体の10位には届きませんでした。語彙が一致しないクエリでは、BM25側の失敗がRRFの順位を引きずり下げます。
いま動いている方式で、試す順番が変わる
dense検索がすでに動いているなら、BM25を足す側から試せます。 順位品質はdense単体より上がり、追加で払うのはBM25検索ぶんの約1.5msです。融合の計算そのものは、前節のとおり無視できる水準にとどまります。自分のデータで確かめるときは、正解ラベルを付けた質問を用意して、融合の前後で正解の順位がどう動いたかを見ます。
反対にBM25単体で運用しているなら、dense索引を足す価値は今回の実測では確認できていません。 順位品質の測定値は上がるものの、偶然のばらつきを割り引くと差が残りません。dense索引の構築と、クエリ1件あたり約23.5msの追加に見合うかは、この結果から判断できません。
RRFは質問ごとに良い方式を選び分けてくれません。 「定数1とは何か?」のようにBM25が救う質問が多ければ別索引を持つ理由になりますが、「燃料を入れるところは」では融合後の順位がdense単体より悪化しました。採用前に見るのは、平均指標だけでなく、重要な質問が融合後に落ちていないかです。
別索引の管理を増やしたくないなら、dense単体のままにする選択も残ります。 運用をひとつ増やすほどの差かどうかは、平均の上積み、個別質問での悪化、運用コストの3つを並べて決めることになります。RRFのkやリランカーとの組み合わせは、この判断材料には入っていません。
詳しい検証条件と、測り方の決め事
評価の細部は、開いたときだけ見えるようにまとめました。順に、3方式の索引の作り方、統計の手法、正解判定とレイテンシの定義です。
読み飛ばし可: 3方式の索引方法・prefix規約とデータの出所
検索対象は埋め込みモデル比較の回・リランカーの回と同一のコーパス・クエリで、JSQuAD由来の1,145段落と、seed=42で固定した500クエリを取得し直さずそのまま再利用しています(チャンク分割の回は、段落を連結した擬似長文書を切り直す設計のため、コーパスもクエリの抽出手順も別系統です)。
- dense単体: ruri-v3-130m(Apache-2.0)で、prefix付き(
検索クエリ:/検索文書:)の正規化埋め込みのコサイン類似度により全1,145段落を全数ランキングします。埋め込みモデル比較の回と同一方式です。 - BM25単体:
fugashiで分かち書きした後、rank_bm25のBM25Okapi(既定パラメータk1=1.5, b=0.75)で全段落を全数ランキングします。BM25にprefixは不要です。 - RRF融合: 上記2方式の全順位を
RRF_score(d) = 1/(k + rank_dense(d)) + 1/(k + rank_bm25(d))で統合します。k=60固定です。全1,145段落の順位を融合に使い、上位何件かに切り出してから融合する設計にはしていません(切り出し深さという2つ目のパラメータを増やさずに済むためです)。
データはJGLUE(JSQuAD)のvalidation splitで、CC BY-SA 4.0で公開されています。
読み飛ばし可: 検定手法・多重比較補正・全3ペアの検定結果
差の大きさとその不確実性は、500問を対で再標本化するブートストラップ(B=10,000、seed=42)の95%信頼区間で見ています。この区間は評価クエリの選び方による推定の揺れで、実行時間の測定ばらつきではありません。Recall@5については、成功・失敗の対応関係に対するexact両側のMcNemar検定も併用しました。
比較は3ペア×3指標なので、指標ごとに3ペアを1つの検定族としてBonferroni補正(α=0.05/3≈0.0167)をかけています。9検定すべてを1家族とする、より保守的な見方でも採用版と判定が変わったペアはありませんでした。Holm法でも判定は同じです。
| ペア (A vs B) | ΔRecall@5 [95%CI] | ΔnDCG@10 [95%CI] | ΔMRR@10 [95%CI] | McNemar p (R@5) |
|---|---|---|---|---|
| dense単体 vs BM25単体 | +0.0040 [-0.0120, +0.0200] | -0.0049 [-0.0201, +0.0102] | -0.0088 [-0.0277, +0.0092] | 0.8036 |
| dense単体 vs RRF融合 | -0.0080 [-0.0200, +0.0040] | -0.0131 [-0.0221, -0.0043]‡ | -0.0165 [-0.0278, -0.0057]‡ | 0.3438 |
| BM25単体 vs RRF融合 | -0.0120 [-0.0220, -0.0040]† | -0.0083 [-0.0180, +0.0012] | -0.0077 [-0.0198, +0.0043] | 0.0312 |
‡: 指標ごとに3ペアを1家族としたBonferroni補正(α=0.05/3≈0.0167)の後も有意。†: 補正前の95%CIは0を含まないものの、補正後は有意とまでは言えない(探索的な扱い)。マークなし: 補正前のCIも0を含む。McNemar pはRecall@5の補正前の値です。
読み飛ばし可: 正解判定・prefix・デバイス統一などの詳細
- 正解判定: JSQuADが各質問に付与している正解段落のラベルと一致するかで判定します。全方式・全指標で共通です。
[SEP]の前処理: コーパスはタイトル [SEP] 本文形式です。BM25側は[SEP]をトークナイズ前に空白へ置換しています(全段落に一様に含まれる語のため順位への影響は小さいものです)。dense側は同じテキストをそのままエンコードしています。- デバイス: dense単体はMPS、BM25単体・RRF融合はCPUで計算しています(rank_bm25はGPUを使わないライブラリです)。
- レイテンシ: 全方式でウォームアップ1回+本計測3回の中央値です。dense・BM25のレイテンシはクエリ1件のエンコード(BM25はトークナイズ)から順位づけまでのend-to-end処理で、索引構築時間は含みません。RRF融合のレイテンシはdenseとBM25のレイテンシに融合オーバーヘッドを足した合計です。壁時計計測のため実行ごとに数%変動します。
- 索引構築時間: レイテンシとは別に、1回だけ計測した値です。ウォームアップも反復も中央値の算出も行っていません。壁時計計測のため実行ごとに変動し、別の実行ではdense 26.86秒・BM25 0.228秒でした。
- 報告方針: 3方式×全指標を報告しています(都合の悪い結果も含みます)。
出典: Kurihara et al., “JGLUE: Japanese General Language Understanding Evaluation”, LREC 2022 / yahoojapan/JGLUE(CC BY-SA 4.0)
適用範囲と限界
採用判断を変えうる制約だけ挙げます。
- 条件限定: JSQuAD valid・M1単一環境・埋め込みモデルruri-v3-130m固定での結果です。別の埋め込みモデルやBM25実装で同じ傾向になるとは限りません。
- JSQuADの性質: Wikipedia由来の一般知識QAで、型番・製品コードなど完全一致がものを言う検索を代表しているとは限りません。BM25が強みを出しやすいドメインでは結果が変わり得ます。
- コーパス規模: 1,145段落での結果です。これを超える規模のコーパスで同じ差が出るかは測っていません。
- RRFのk: 60に固定しており、他の値の効果は未検証です。
- 段落単位の検索: 埋め込みモデル比較の回と同じJSQuAD段落をそのまま検索対象にしており、チャンク分割を比べた回の固定長チャンクへの再分割は行っていません。チャンク戦略との交互作用は未検証です。
- リランカーとの組み合わせ: 一次検索をハイブリッド化した後に候補を並べ直すリランカーを足す効果は測っていません。次回の計測候補です。
3方式の順位を手元で並べてみる
「単体どうしでは差が出ないのに、混ぜると順位品質が伸びる」という構図の核は、RRFの融合式です。denseとBM25それぞれの順位(1始まり)だけを渡せば、この関数単体で融合順位を計算できます。
# RRF融合: dense・BM25それぞれの順位(1始まり)だけを使って統合する
RRF_K = 60


def rrf_fuse(dense_rank: dict[int, int], bm25_rank: dict[int, int]) -> list[int]:
    doc_ids = list(dense_rank.keys())
    # 各文書の順位を 1/(k+順位) に変換して2方式ぶんを足す
    score = {
        d: 1.0 / (RRF_K + dense_rank[d]) + 1.0 / (RRF_K + bm25_rank[d])
        for d in doc_ids
    }
    # スコアが高い順に文書IDを並べ替えて返す
return sorted(doc_ids, key=lambda d: score[d], reverse=True)手元で動かす完全版。8文書・2クエリの小さなコーパスで、dense単体・BM25単体・RRF融合の順位を並べます。型番のように完全一致が効く質問と、言い換えが効く質問とで、強みと弱みが入れ替わる様子がそのまま見えます。
GPU不要で、CPUだけなら数秒です。dense側のruri-v3-130mは初回ダウンロード約0.5GBが加わり、BM25側は外部モデルを使いません。transformersは4.57.6に固定してください(固定しないとdenseの出力スコアの桁がずれる可能性があります)。次のコードをquickstart_hybrid.pyとして保存します。
"""日本語RAGの「dense単体 → BM25単体 → RRF融合」を手元で試す最小デモ。

dense: cl-nagoya/ruri-v3-130m(コサイン類似度、prefix必須)
BM25: rank_bm25.BM25Okapi(fugashiで分かち書き、既定パラメータ k1=1.5, b=0.75)
RRF: RRF_score(d) = 1/(k + rank_dense(d)) + 1/(k + rank_bm25(d))    (k=60固定)
"""

import fugashi
import numpy as np
from rank_bm25 import BM25Okapi
from sentence_transformers import SentenceTransformer

DEVICE = "cpu"  # 掲載出力と一致させるため固定
RRF_K = 60

# 以下は自分のデータに置き換えて使う
DOCUMENTS = [
    "有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに行う。",
    "経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行う。",
    "社内VPNへの接続には接続機器VPN-2024-003が必要で、情報システム部に貸出申請を行う。",
    "本番環境へのデプロイは、プルリクエストが2名以上のレビュー承認を得た後にのみ実行できる。",
    "リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求められる。",
    "問い合わせ対応の一次窓口はサポートチームで、営業時間は平日9時から18時までである。",
    "半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映される。",
    "有給休暇の買い取りは原則禁止だが、退職時に限り未消化分を精算できる場合がある。",
]

QUERIES = [
    "VPN-2024-003は何に使う機器ですか?",  # 型番の完全一致が効きやすい質問
    "有給はいつから取れますか?",  # 言い換え・意味理解が効きやすい質問
]

_tagger = fugashi.Tagger()


def tokenize(text: str) -> list[str]:
    return [w.surface for w in _tagger(text)]


def main() -> None:
    print(f"device: {DEVICE}")

    # dense: 埋め込み検索の索引を構築
    embed_model = SentenceTransformer("cl-nagoya/ruri-v3-130m", device=DEVICE)
    doc_embeddings = embed_model.encode(
        ["検索文書: " + d for d in DOCUMENTS],
        normalize_embeddings=True,
        convert_to_numpy=True,
    )

    # BM25: 分かち書き後にBM25Okapiで索引を構築
    tokenized_docs = [tokenize(d) for d in DOCUMENTS]
    bm25 = BM25Okapi(tokenized_docs)

    for query in QUERIES:
        print(f"\nクエリ: {query}")

        # dense単体の順位
        query_embedding = embed_model.encode(
            "検索クエリ: " + query, normalize_embeddings=True, convert_to_numpy=True,
        )
        dense_scores = doc_embeddings @ query_embedding
        dense_order = np.argsort(-dense_scores, kind="stable")
        dense_rank = {idx: r + 1 for r, idx in enumerate(dense_order)}

        # BM25単体の順位
        bm25_scores = np.asarray(bm25.get_scores(tokenize(query)))
        bm25_order = np.argsort(-bm25_scores, kind="stable")
        bm25_rank = {idx: r + 1 for r, idx in enumerate(bm25_order)}

        # RRF融合(k=60固定、全件の順位を使う)
        fused_scores = np.array([
            1.0 / (RRF_K + dense_rank[i]) + 1.0 / (RRF_K + bm25_rank[i])
            for i in range(len(DOCUMENTS))
        ])
        rrf_order = np.argsort(-fused_scores, kind="stable")

        print("  [dense単体]  1位:", DOCUMENTS[dense_order[0]])
        print("  [BM25単体]   1位:", DOCUMENTS[bm25_order[0]])
        print("  [RRF融合]    1位:", DOCUMENTS[rrf_order[0]])

        print("  順位一覧(doc, dense順位, BM25順位, RRF順位):")
        for i, doc in enumerate(DOCUMENTS):
            rrf_pos = int(np.where(rrf_order == i)[0][0]) + 1
            print(f"    dense={dense_rank[i]:>2} bm25={bm25_rank[i]:>2} rrf={rrf_pos:>2}  {doc[:40]}")


if __name__ == "__main__":
    main()
denseとBM25の両方を動かすので、依存も2系統入ります。まとめて用意して実行します。
# uv を使う場合(推奨)
uv venv --python 3.12
uv pip install sentence-transformers "transformers==4.57.6" sentencepiece protobuf \
  fugashi unidic-lite rank-bm25
uv run --no-project python quickstart_hybrid.py

# pip を使う場合
python3.12 -m venv .venv
source .venv/bin/activate        # Windows は .venv\Scripts\activate
pip install sentence-transformers "transformers==4.57.6" sentencepiece protobuf \
  fugashi unidic-lite rank-bm25
python quickstart_hybrid.pyfugashi・unidic-liteはBM25の日本語分かち書き(MeCab)に、sentencepiece・protobufはruri-v3-130mのトークナイザ読み込みに使います。--no-projectは、保存先の親ディレクトリに別のpyproject.tomlがあると素のuv runがそちらの環境を掴むのを避けるためです。
実行すると、「VPN-2024-003は何に使う機器ですか?」という型番を含むクエリでは、3方式とも正解文書を1位にでき、方式差が出ません。
差がついたのは「有給はいつから取れますか?」という言い換え型のクエリです。dense単体だけが「半休(0.5日単位の有給)」を1位にしてしまい、本来探したい「有給休暇は入社6か月後から10日付与」が2位に沈みます。BM25単体とRRF融合は、どちらも正解文書を1位にしました。ただし8文書の小さいデモでの挙動で、本実験500クエリの結論とは別物です。
実行結果(全文)
device: cpu

クエリ: VPN-2024-003は何に使う機器ですか?
  [dense単体]  1位: 社内VPNへの接続には接続機器VPN-2024-003が必要で、情報システム部に貸出申請を行う。
  [BM25単体]   1位: 社内VPNへの接続には接続機器VPN-2024-003が必要で、情報システム部に貸出申請を行う。
  [RRF融合]    1位: 社内VPNへの接続には接続機器VPN-2024-003が必要で、情報システム部に貸出申請を行う。
  順位一覧(doc, dense順位, BM25順位, RRF順位):
    dense= 5 bm25= 2 rrf= 3  有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに
    dense= 6 bm25= 3 rrf= 4  経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行
    dense= 1 bm25= 1 rrf= 1  社内VPNへの接続には接続機器VPN-2024-003が必要で、情報システム部に
    dense= 3 bm25= 6 rrf= 5  本番環境へのデプロイは、プルリクエストが2名以上のレビュー承認を得た後にのみ実行
    dense= 2 bm25= 4 rrf= 2  リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求め
    dense= 4 bm25= 8 rrf= 6  問い合わせ対応の一次窓口はサポートチームで、営業時間は平日9時から18時までであ
    dense= 8 bm25= 7 rrf= 8  半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映
    dense= 7 bm25= 5 rrf= 7  有給休暇の買い取りは原則禁止だが、退職時に限り未消化分を精算できる場合がある。

クエリ: 有給はいつから取れますか?
  [dense単体]  1位: 半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映される。
  [BM25単体]   1位: 有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに行う。
  [RRF融合]    1位: 有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに行う。
  順位一覧(doc, dense順位, BM25順位, RRF順位):
    dense= 2 bm25= 1 rrf= 1  有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに
    dense= 5 bm25= 5 rrf= 6  経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行
    dense= 8 bm25= 8 rrf= 8  社内VPNへの接続には接続機器VPN-2024-003が必要で、情報システム部に
    dense= 7 bm25= 7 rrf= 7  本番環境へのデプロイは、プルリクエストが2名以上のレビュー承認を得た後にのみ実行
    dense= 4 bm25= 6 rrf= 5  リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求め
    dense= 6 bm25= 2 rrf= 4  問い合わせ対応の一次窓口はサポートチームで、営業時間は平日9時から18時までであ
    dense= 1 bm25= 4 rrf= 2  半休(0.5日単位の有給)は前日17時までの申請で取得でき、給与計算にも自動反映
    dense= 3 bm25= 3 rrf= 3  有給休暇の買い取りは原則禁止だが、退職時に限り未消化分を精算できる場合がある。
切り分けられなかったのは、混ぜること自体の効果
RRF融合が上回ったのは、dense単体を基準にしたときだけでした。BM25単体を基準にすると同じ差が出ないため、順位を混ぜる操作そのものに効果があるとは、この500問からは言えません。
残った宿題は2つです。kは60に固定したまま他の値を試しておらず、一次検索をハイブリッド化した後に候補を並べ直す効果も測っていません。順位品質をここからさらに動かせるのかは、この2つを測ってから判断できることになります。
一次検索のハイブリッド化だけでなく、チャンクやリランカーを含めた全体のどこから直すか迷うなら、入口記事「RAGの検索精度を上げる方法」が見取り図になります。
出典: 評価データ JGLUE(JSQuAD): Kurihara et al., “JGLUE: Japanese General Language Understanding Evaluation”, LREC 2022 / yahoojapan/JGLUE(CC BY-SA 4.0)。dense検索モデル: cl-nagoya/ruri-v3-130m(Tsukagoshi & Sasano, arXiv:2409.07737、Apache-2.0)。BM25実装: rank_bm25(Apache-2.0)。日本語トークナイザ: fugashi(MIT)。