
社内の文書を検索して、その内容をもとに生成AIへ答えさせる。この仕組みを作るとき最初に決めるのが、文章を数値の並びへ変換するモデルです。同じ系列で小・中・大とサイズ違いが公開されていることが多く、迷ったら大きい方にしておけば安心だと考えたくなります。
けれど大きいモデルには代償があります。文書をあらかじめ変換しておく処理にも、質問が来てからの変換にも時間がかかりますし、変換後の数値列が長くなれば、それを保存する検索用データベースの容量も増えます。その代償に見合う差が日本語の検索で本当に出るのか、確かめたくなりました。
9モデルをApple M1の同一条件で測ると、そうはなりませんでした。ruri-v3は30m、130m、310mと大きくしても、検索の測定値が最も高かったのは中間の130mです。 310mで増えたのはコストの方でした。重みファイルは2倍以上に膨らみ、段落を変換する速さは3分の1ほどまで落ちています。
先に結論: 大きいほど良いとは限らず、最良は中間の130m
日本語の短い文書を検索するなら、最初の候補はruri-v3-130mです。検索3指標の測定値が9モデル中で最も高く、310mへ大きくしても改善は確認できませんでした。上位5件に正解が入った割合は130mが0.976、310mが0.972でした(JSQuADの1,145段落・500クエリ)。
| 優先すること | 試す候補 | 選ぶ前に見ること |
|---|---|---|
| 日本語検索の精度 | ruri-v3-130m | 自分の文書と質問でも正解が上位に来るか |
| 処理速度・モデルの軽さ | ruri-v3-30m | 130mからの検索精度の低下を許容できるか |
| 多言語への対応 | multilingual-e5・BGE-M3も比較 | 今回は日本語のみの評価なので、多言語の順位は分からない |
この比較は検索部分の評価です。回答生成の品質や、長文・専門領域での優劣までは測っていません。
検索の良し悪しは、正解が上位に来たかで測る
埋め込みモデルは、文章を意味の近さが距離に表れる数百次元の数値列(ベクトル)へ変換するモデルです。語が違っても意味が近ければ、ベクトルどうしも近くなります。ベクトル検索を実装した経験は前提にしません。
検索の点数は3つです。Recall@5は、正解の段落が上位5件に入った割合。nDCG@10とMRR@10は、正解が上位にあるほど1へ近づく点数で、同じ「見つかった」でも1位と5位の違いまで拾えます。文どうしの意味の近さは別枠で、モデルが付けた近さの順番が人手評価とどれだけ一致するかを見るJSTS Spearman(1に近いほど一致)で測ります。
この記事で「差を確認できた」と書くときは、偶然のばらつきに加え、9モデルを同時に見比べることで生じる偶然の当たりも割り引いて、それでも残った差だけを指します。「明確な差を確認できなかった」は同じ性能という意味ではなく、今回の評価では見分けられなかった、というところまでの表現です。
なお、ここで測るのはRAG(質問に関係する文書を検索してLLMへ渡し、答えさせる仕組み)の工程のうち、検索に使う埋め込みモデルだけです。分割・検索・順位づけ・回答生成のどこで精度が落ちているかを切り分ける考え方は、RAGとは?検索・生成の仕組みと精度が落ちる4つの場所にまとめています。
変えたのはモデルだけ、9種を同じ条件で回した
問いは、「日本語の埋め込みモデルは、大きいほど検索精度が上がるのか」です。データ、前処理、デバイス、バッチサイズを固定し、パラメータ数が約33.6Mから568Mまで開いた9モデルだけを差し替えました。
評価データは2種類です。検索では、Wikipedia記事の段落に質問が付いたJSQuADから1,145段落と500クエリを使い、正解段落が上位に来たかを見ました。500問はseed 42で固定して抽出しています。文類似度では、人が2文の近さを評価したJSTSの1,457ペアを使いました。
各モデルには、モデルカードが指定する定型の接頭辞(prefix)を付けています。Ruri系なら文書側に検索文書: 、質問側に検索クエリ: といった具合で、これを付け忘れると不公平な比較になります。
9モデルについて、検索3指標、JSTS Spearman、文章をベクトルへ変換する速さ(エンコード速度)、重みファイルのサイズを比べます。検索と文類似度は別の仕事なので、一方で強いモデルがもう一方でも強いとは限りません。測っているのは日本語だけ、しかも短めの入力です。実務ドメインや長文、多言語で同じ順位になるかは分からないので、そこは記事末の「適用範囲と限界」にまとめました。
検索では130m、速度では30mが選びやすかった
検索3指標が最も高いのはruri-v3-130m
ruri-v3-130mのRecall@5は0.976でした。順位まで見る指標も最良で、nDCG@10が0.9419、MRR@10が0.9268です。残る8モデルの値と、文類似度のJSTS Spearmanも次の表に並べています。
| モデル | Recall@5 | nDCG@10 | MRR@10 | JSTS Spearman |
|---|---|---|---|---|
| multilingual-e5-small | 0.964 | 0.9118 | 0.8899 | 0.7892 |
| multilingual-e5-base | 0.956 | 0.9208 | 0.9021 | 0.7965 |
| ruri-v3-30m | 0.958 | 0.9149 | 0.8937 | 0.8296 |
| ruri-v3-130m | 0.976 | 0.9419 | 0.9268 | 0.8345 |
| GLuCoSE-base-ja-v2 | 0.966 | 0.9386 | 0.9244 | 0.8090 |
| static-embedding-japanese | 0.924 | 0.8580 | 0.8264 | 0.7781 |
| ruri-v3-310m | 0.972 | 0.9372 | 0.9217 | 0.8359 |
| multilingual-e5-large | 0.968 | 0.9274 | 0.9105 | 0.8185 |
| BGE-M3 | 0.964 | 0.9156 | 0.8948 | 0.8023 |
数値は丸めて表記しています。太字は各指標の最良値です。
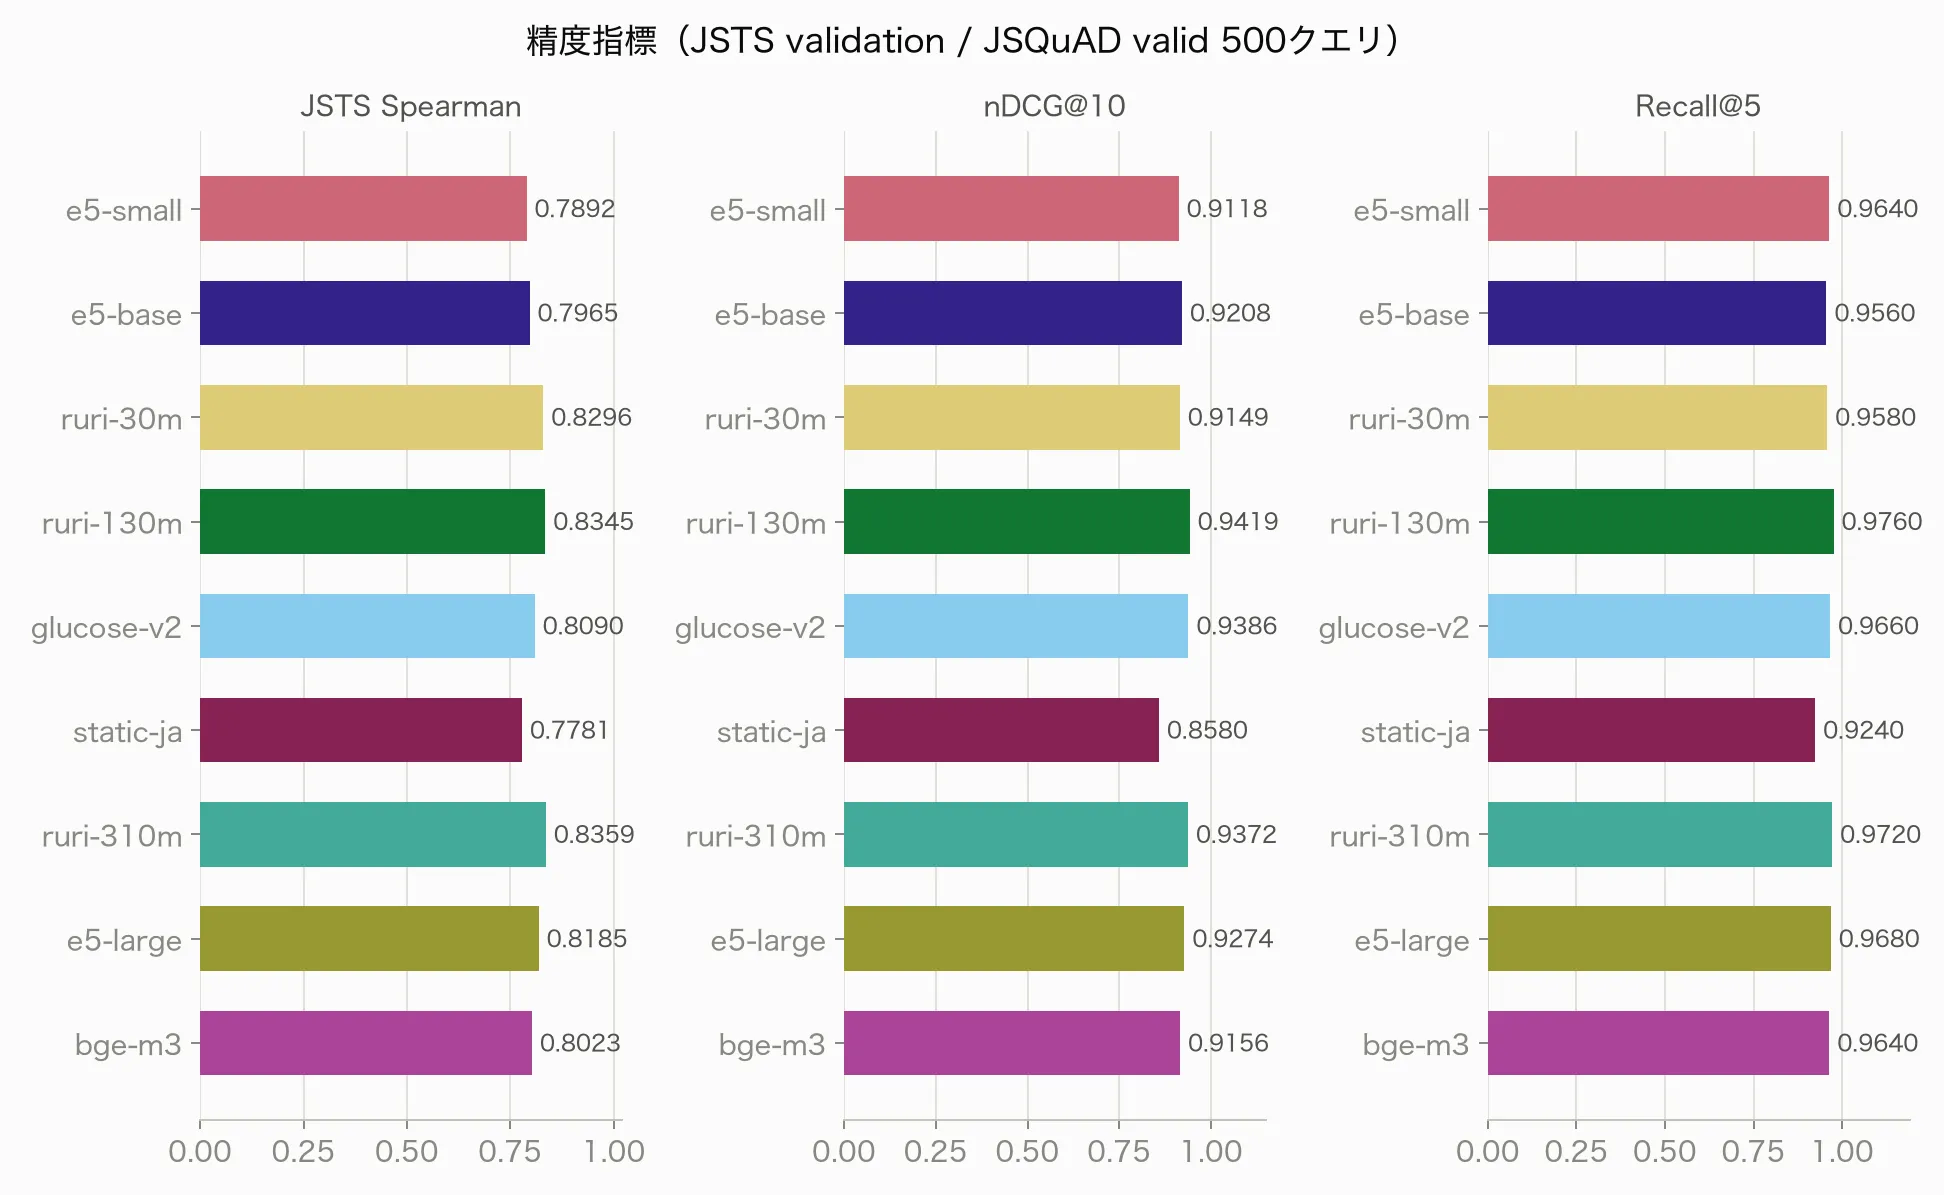
ただし上位は僅差です。130mとGLuCoSE-base-ja-v2は、検索3指標のどれもこの500クエリでは明確な差が残りませんでした。つまり検索の点数だけを見ているかぎり、この2つは選び分けられません。
両者を分けるのは文類似度と、ベクトルを保存する側のコストです。JSTSでは130mがGLuCoSEを0.0255上回り、この差は残りました。埋め込み次元も130mが512、GLuCoSEが768と開きます。文類似度も使う場合や、1件あたりのベクトルを短くしたい場合は、130mが選びやすくなります。
パラメータ数と精度は、素直には比例しません。Transformer系で最小のruri-v3-30m(36.7M)が、約7.6倍あるmultilingual-e5-base(278.0M)を文類似度で上回りました。JSTS Spearmanは0.8296対0.7965で、この差は補正後も残っています。大きさは、選定の手がかりとしてあまり働かないということです。
速度はstatic-embedding-japaneseが桁違い、Transformer系ではruri-v3-30mが最速
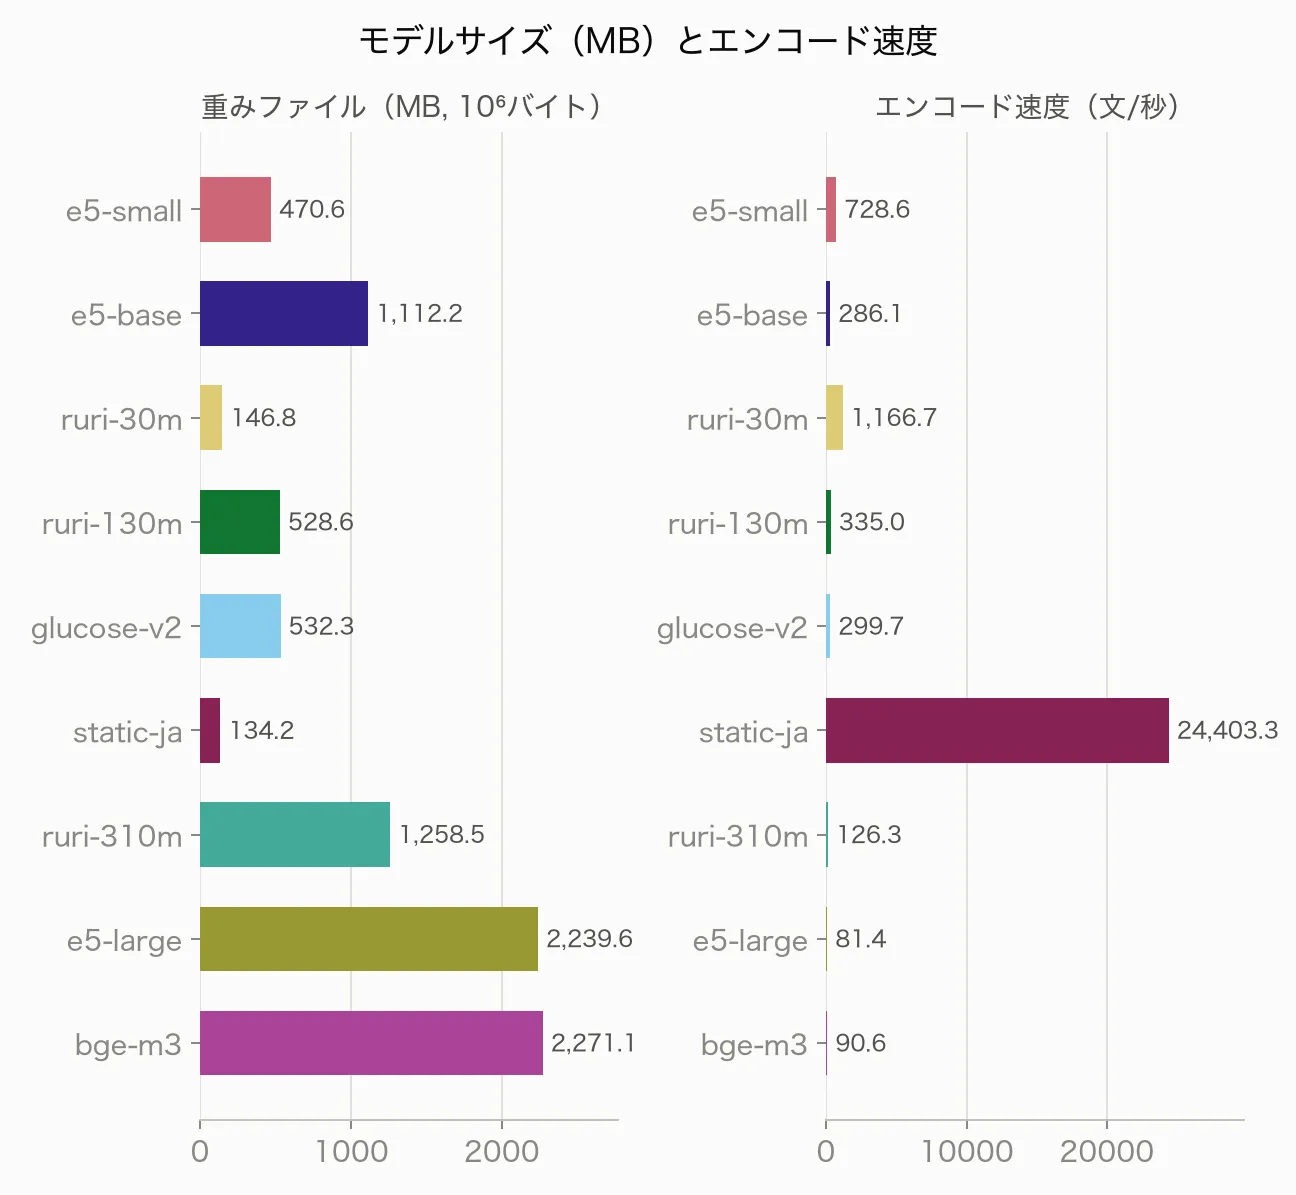
精度の差が小数第2位の話だったのに対し、エンコード速度の差は桁で開きます。選択に効くのはむしろこちらです。
段落では、static-embedding-japaneseが10,967.9件/秒でした。Transformer系で最も速いのはruri-v3-30mで、短文なら1,166.7文/秒です。
| モデル | 短文速度(文/秒) | 段落速度(段落/秒) | 重み(MB) | 次元 |
|---|---|---|---|---|
| multilingual-e5-small | 728.6 | 166.0 | 470.6 | 384 |
| multilingual-e5-base | 286.1 | 54.3 | 1,112.2 | 768 |
| ruri-v3-30m | 1,166.7 | 209.2 | 146.8 | 256 |
| ruri-v3-130m | 335.0 | 46.9 | 528.6 | 512 |
| GLuCoSE-base-ja-v2 | 299.7 | 50.3 | 532.3 | 768 |
| static-embedding-japanese | 24,403.3 | 10,967.9 | 134.2 | 1024 |
| ruri-v3-310m | 126.3 | 15.8 | 1,258.5 | 768 |
| multilingual-e5-large | 81.4 | 14.0 | 2,239.6 | 1024 |
| BGE-M3 | 90.6 | 14.3 | 2,271.1 | 1024 |
数値は丸めて表記しています。速度は列内の最大値、重みは最小値が太字です。次元は指標ではないため強調していません。重みは実際にロードされる重みファイルのサイズ(MB, 10⁶バイト)です。
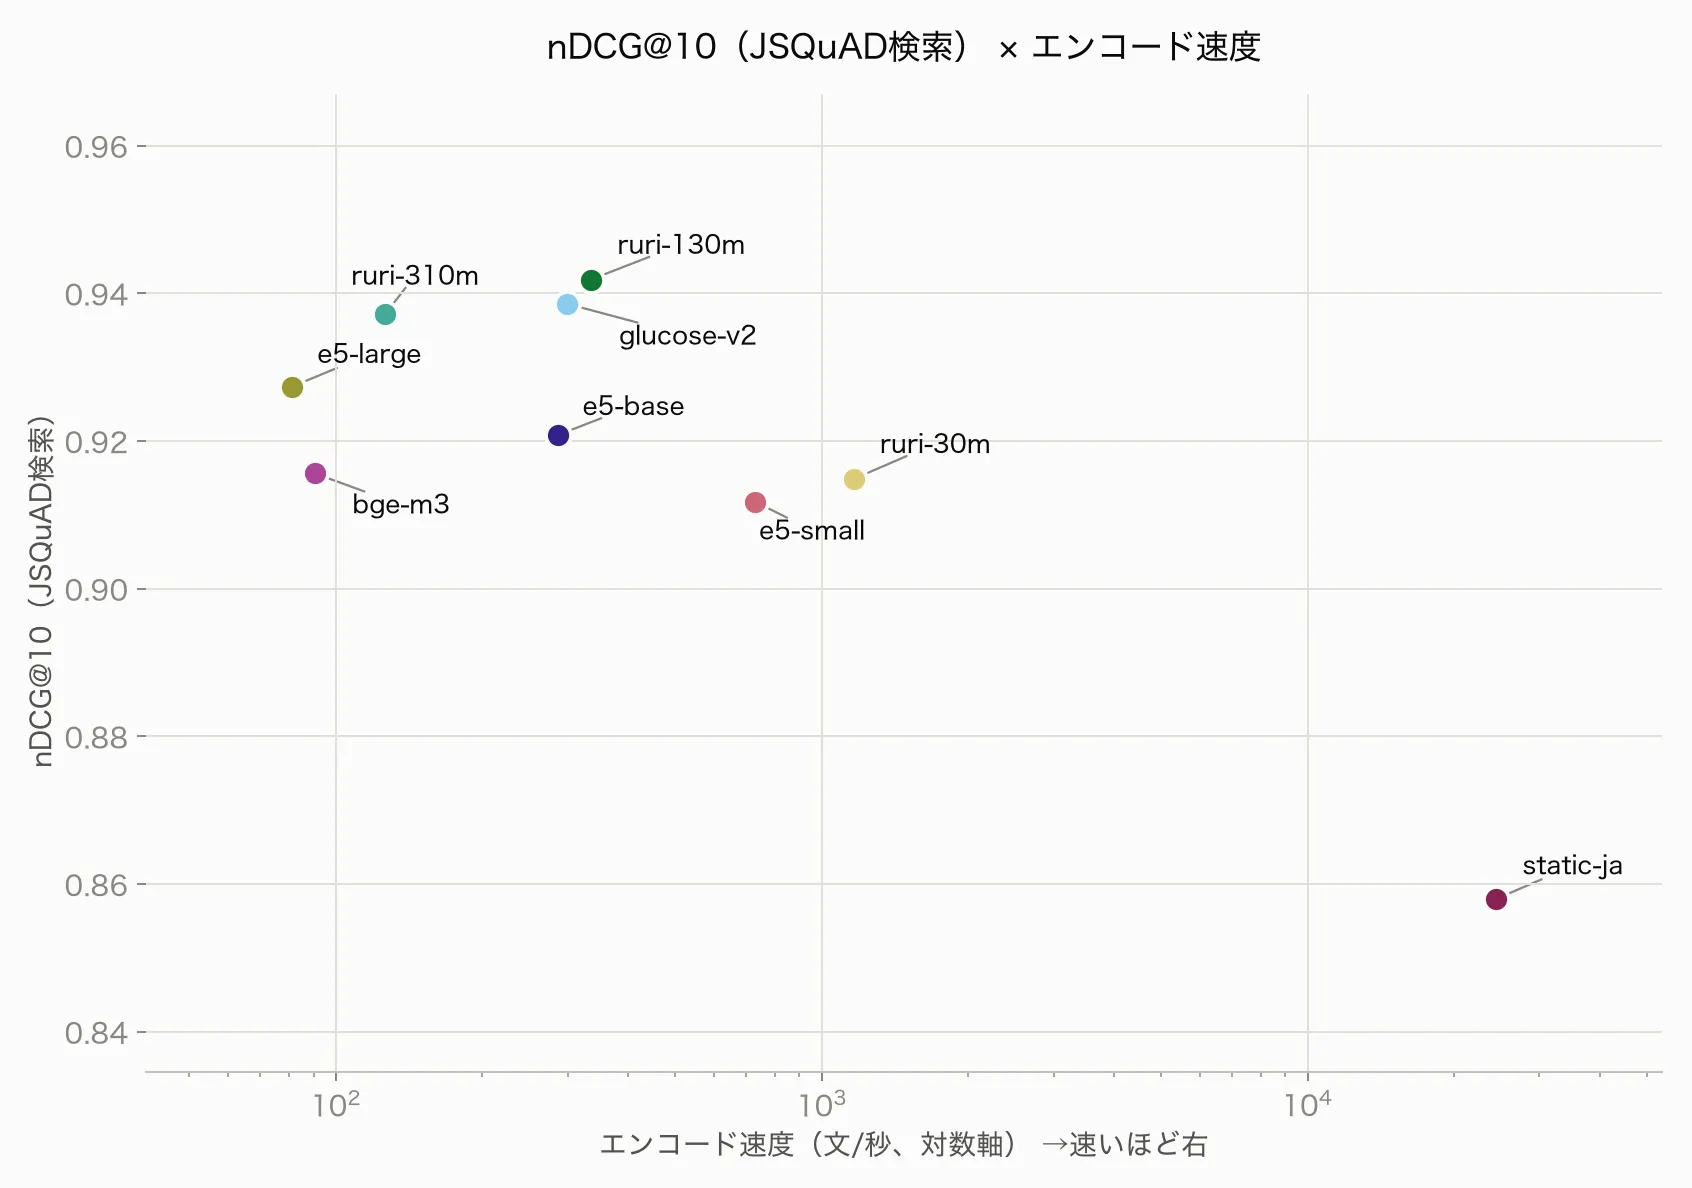
精度とエンコード速度のトレードオフは、散布図にすると見通せます。右上へ行くほど「速くて精度が高い」領域です。ruri-v3-30mは上位陣に近い精度を保ったまま、右(高速側)に位置します。static-embedding-japaneseは突出して速いものの、精度は最下位まで離れています。
この速度値は、一度取り直しています。3モデルを追加した際、単発計測を同じプロセス内で二重に実行するバグを入れてしまいました。生ログに同じモデルのJSONが2つ続けて出ていたため気づき、二重呼び出しを削除して、3モデルをそれぞれ独立したプロセスで再計測しています。
採用しなかった2回目の値は、ruri-v3-310mで1回目より約17%低下していました。再計測後もセッションをまたぐと最大で約20%動いたため、ノートPC1台で測った速度は細かな差より桁を見る方が安全です。表の絶対値はこの揺れを含むものとして読んでください。
軽いruri-v3-30mは検索品質で130mに一歩譲る
速度と省メモリで有利なruri-v3-30mですが、検索品質では130mに一歩譲ります。順位まで見る2指標が下がり、nDCG@10とMRR@10は130mよりそれぞれ0.0270・0.0331低く、この差は残りました。正解を見つけてはいても、上位へ押し上げる力が130mより弱い、という形です。
一方でRecall@5(0.958)とJSTS(0.8296)は、130mとの明確な差が残りませんでした。上位5件に入るかどうかだけを見るなら、この条件では区別が付きません。検索品質を最後まで詰めるなら130m、エンコード速度とサイズを優先するなら30m。選択はそこで分かれます。
大きくしても検索精度の改善は確認できなかった
ruri-v3-310mは130mの約2.4倍のパラメータを持ちますが、文類似度でも検索3指標でも、この条件では明確な差が残りませんでした。 増えたのはコストの方です。重みファイルは529MBから1,259MBへ、段落のエンコード速度は46.9件/秒から15.8件/秒へと動いています。
同じ傾向はe5系にもあります。multilingual-e5-largeがbaseから改善を確認できたのはJSTSだけで、検索3指標はほとんど伸びませんでした。サイズを上げる判断は、系列をまたいでも支持されていません。
BGE-M3は別系列なので、サイズ効果の比較材料にはしません。ただ今回評価したdense embeddingでは、nDCG@10・MRR@10・JSTSがそれぞれ130mより0.0263・0.0320・0.0322低い結果でした。
なぜ大きくしても伸びなかったのか、機序までは切り分けていません。考えられるのは、JSQuADの検索が上位モデルにとって既に上限近く(Recall@5は上位で0.97前後)で、パラメータを増やす余地が小さかった可能性です。ただしこれは推測で、この実験では確かめていません。
具体例: 「団体行動の代表例は何」という質問での順位
集計指標の僅差が、個別クエリでは大きな順位差として出ることがあります。クエリ「団体行動の代表例は何」の正解は、「団体行動の代表例であるストライキ」という記述を、長い労働争議の議論に埋め込んだ段落です。
このとき上位モデルは正解段落をほぼ的中させました。ruri-v3-310mが1,145段落中1位、ruri-v3-130mが2位です。一方で下位は大きく沈み、ruri-v3-30mは33位、static-embedding-japaneseは86位、multilingual-e5-smallは92位まで落ちました。
ただしこれは「130mが上位3位以内・比較モデルが上位5位を外す」という条件に当てはまった33件(500問の6.6%)の一例で、130m有利のケースを狙って抽出したものです。全クエリでこの幅が出るわけではありません。
実務ならどれを選ぶか
最初の1本はruri-v3-130m。 検索3指標の測定値が9モデル中で最も高く、2倍以上のパラメータを積んだ310mへ上げても改善は確認できませんでした。最大モデルから入るより、130mで手元の検索品質と処理時間を測る方が判断しやすくなります。測定値が最も高かったモデルを起点にすれば、比較する組み合わせも増えません。
下げ先はruri-v3-30m。エンコード速度かモデルの重さが詰まってからでよい。 Transformer系では短文のエンコード速度が最速で、重みファイルも最軽量でした。代わりにnDCG@10は130mより0.0270低く、MRR@10も同様に下がります。その落ち込みを自分の正解データで許容できるかを、切り替える前に確かめてください。
文書量が多いなら、精度の僅差より埋め込み次元。 GLuCoSE-base-ja-v2は検索3指標で130mと区別できなかった候補ですが、次元は768で、130mの512よりベクトル1件が長くなります。大量の文書を抱えるなら、この差が僅差の精度より先に効く可能性があります。ここで見るのは重みファイルの大きさではありません。重みが最も軽いstatic-embedding-japaneseは次元1024、次元が最も短い30mは256と、順序が入れ替わります。
多言語が要るなら、この順位はいったん保留。 multilingual-e5系とBGE-M3が候補に戻ります(今回は日本語しか測っていません)。ただしBGE-M3は重みが2,271MBと9モデル中で最大だったため、日本語検索だけを目的にする最初の候補からは外しました。
エンコード速度が最優先のときだけstatic-embedding-japanese。 段落10,967.9件/秒という桁違いの速さの一方で、検索3指標は9モデル中の最下位でした。用途を限定して、この落差を受け入れられるときに選ぶモデルです。
検索結果に必要な文書はあるのに順位が低い場合は、リランカーによる並べ替えの比較が次の判断材料になります。必要な文書が候補に入っているか分からない場合は、RAGの検索品質を診断する手順から確認できます。
詳しい検証条件
9モデル分の精度・速度・サイズは、いずれも本実験の実行時に書き出した計測ログを集計した値です。エンコード速度はウォームアップ後に3回測った中央値で、prefixを付けた入力での実測なので、prefix長の差もこの値に含まれます。
読み飛ばし可: 統計手法・prefix対応表・9モデルのHugging Face ID
検索評価にはJSQuAD validation split由来の1,145段落と、seed 42で固定した500クエリを使いました。近似検索は使わず、全段落とのコサイン類似度を計算しています。文類似度にはJGLUEのJSTS validation split 1,457ペアを使い、埋め込み間のコサイン類似度と人手評価ラベルとの一致度をSpearman相関として測りました。速度計測は、短文がJSTSの2,914文、段落がJSQuAD由来の1,145段落を、batch size 32で処理した実測です。
主要指標にはブートストラップ95%信頼区間とMcNemar検定を付けています。この信頼区間は評価サンプルに対する推定の不確実性であって、実行時間の測定ばらつきではありません。複数モデルを比べると偶然でも差が出やすくなるので、その分を割り引く多重比較補正(Bonferroni法、有意水準0.05)も適用しました。本文で「確認できた」と書いた差は、この補正後も残ったものです。
| モデル | 検索クエリ | 検索文書 | 文類似度 |
|---|---|---|---|
| multilingual-e5系 | query: | passage: | query: |
| Ruri系 | 検索クエリ: | 検索文書: | なし |
| GLuCoSE-base-ja-v2 | query: | passage: | query: |
| static-embedding-japanese / BGE-M3 | なし | なし | なし |
BGE-M3にprefixを付けていないのは、公式FAQで検索時のinstruction(prefix)は不要とされているためです。
| モデル | ライセンス | パラメータ(実ロード値) |
|---|---|---|
| intfloat/multilingual-e5-small | MIT | 117.7M |
| intfloat/multilingual-e5-base | MIT | 278.0M |
| intfloat/multilingual-e5-large | MIT | 559.9M |
| cl-nagoya/ruri-v3-30m | Apache-2.0 | 36.7M |
| cl-nagoya/ruri-v3-130m | Apache-2.0 | 132.1M |
| cl-nagoya/ruri-v3-310m | Apache-2.0 | 314.6M |
| pkshatech/GLuCoSE-base-ja-v2 | Apache-2.0 | 133.1M |
| hotchpotch/static-embedding-japanese | MIT | 33.6M |
| BAAI/bge-m3 | MIT | 567.8M |
cl-nagoya/ruri-v3-310mは本記事(埋め込みモデル)専用の表記です。リランカー5種を比べた回で扱うcl-nagoya/ruri-v3-reranker-310mとは別モデルなので、混同しないでください。
読み飛ばし可: 多重比較補正の詳細と生存ペア数
評価サンプルに対する不確実性は、対で再標本化するpercentile bootstrap(B=10,000、seed=42)で算出しました。Recall@5にはexact両側のMcNemar検定も使っています。36ペア×4指標の同時比較のため、指標ごとに36ペアの検定族を分けてBonferroni法(有意水準0.05)で補正しました。
指標ごとの生存数(補正の前後で、差が残ったペアの数)は次のとおりです。
| 指標 | 補正前のCIで差が0を含まないペア | Bonferroni調整後も差が残ったペア |
|---|---|---|
| Recall@5 | 10/36 | 6/36 |
| nDCG@10 | 23/36 | 17/36 |
| MRR@10 | 23/36 | 17/36 |
| JSTS Spearman | 26/36 | 18/36 |
全指標をまとめた144検定を1家族とする、より保守的な代替でも算出しており、判定が変わるペアがあります。たとえばruri-130m対BGE-M3のMRR@10は、指標ごとの家族(採用版)では有意ですが、144検定をまとめた家族では有意ではありません。
評価データはJGLUE v1.1のvalidation splitです。
出典: Kurihara et al., “JGLUE: Japanese General Language Understanding Evaluation”, LREC 2022 / yahoojapan/JGLUE(CC BY-SA 4.0)
適用範囲と限界
- JSTS・JSQuADという単一データセットでの結果です。社内文書やEC商品、コード検索など実務ドメインで同じ順位になる保証はありません。
- JSTS・JSQuADは日本語特化モデルの開発側が性能確認に使う定番でもあります。特化モデルの優位が未知ドメインで同じ幅で出るかは別問題です。
- 検索コーパスは1,145段落と小さく、Recall@5は全モデル0.924以上でした。大規模コーパスへそのまま外挿できません。
- 入力はいずれも短めで、切り捨てはほぼ起きていません。Ruri系・BGE-M3の最大系列長8,192が活きる長文入力での性能は未検証です。
- 速度はApple M1、MPS、batch size 32での値で、ラン間で±20%程度の変動がありえます。CUDA GPUでは絶対値と相対関係が変わり得ます。
- 多言語性能、API型モデル、量子化、ONNXとの組み合わせは未計測です。BGE-M3はdense embeddingのみを評価し、sparse・ColBERT方式は測っていません。
130mで検索部分だけを動かす最小コード
推奨モデルのruri-v3-130mひとつで、日本語RAGの「検索」部分だけを再現できます。Ruri系は検索用途でprefixが必須なので、文書には検索文書: 、クエリには検索クエリ: を必ず前置してください。埋め込みはnormalize_embeddings=Trueで正規化し、その内積をコサイン類似度として使います。この扱いはベンチマーク計測と同じです。
以下をquickstart_rag.pyとして保存すれば、そのまま動きます。依存はsentence-transformersひとつで、GPUは不要です。
"""日本語RAG検索の最小デモ(cl-nagoya/ruri-v3-130m)。"""

import torch
from sentence_transformers import SentenceTransformer

DEVICE = "cpu"  # 掲載出力と一致させるため固定

# 以下は自分のデータに置き換えて使う
DOCUMENTS = [
    "有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに行う。",
    "経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行う。",
    "社内VPNに接続するには、多要素認証アプリでワンタイムパスワードを生成する必要がある。",
    "本番環境へのデプロイは、プルリクエストが2名以上のレビュー承認を得た後にのみ実行できる。",
    "リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求められる。",
    "問い合わせ対応の一次窓口はサポートチームで、営業時間は平日9時から18時までである。",
]

QUERIES = [
    "有給はいつから取れますか?",
    "本番にデプロイする条件は?",
]

TOP_K = 3


def main() -> None:
    device = DEVICE
    print(f"device: {device}")

    model = SentenceTransformer("cl-nagoya/ruri-v3-130m", device=device)

    # 検索では「検索文書: 」prefix が必須(文類似度の用途では不要)
    doc_embeddings = model.encode(
        ["検索文書: " + d for d in DOCUMENTS],
        normalize_embeddings=True,
        convert_to_tensor=True,
    )

    for query in QUERIES:
        # クエリ側は「検索クエリ: 」prefix
        query_embedding = model.encode(
            "検索クエリ: " + query,
            normalize_embeddings=True,
            convert_to_tensor=True,
        )
        scores = doc_embeddings @ query_embedding  # 正規化済みなのでコサイン類似度
        top = torch.topk(scores, k=min(TOP_K, len(DOCUMENTS)))

        print(f"\nクエリ: {query}")
        for rank, (score, idx) in enumerate(zip(top.values, top.indices), start=1):
            print(f"  {rank}. score={score.item():.4f}  {DOCUMENTS[idx]}")


if __name__ == "__main__":
main()インストールと実行は次のとおりです。transformersのバージョンは、検証環境とスコアを揃えるために固定しています。
# uv を使う場合(推奨)
uv venv --python 3.12
uv pip install sentence-transformers "transformers==4.57.6" sentencepiece protobuf
uv run --no-project python quickstart_rag.py

# pip を使う場合
python3.12 -m venv .venv
source .venv/bin/activate        # Windows は .venv\Scripts\activate
pip install sentence-transformers "transformers==4.57.6" sentencepiece protobuf
python quickstart_rag.pysentencepiece・protobufはtransformers==4.57.6でトークナイザを読み込むのに必要です。うまく引けないときは、まずprefixの付け忘れとnormalize_embeddings=Trueを疑ってください。手元のApple M1では約11秒で終わりました(初回はモデルのダウンロード約0.5GBが加わります)。
実行結果(長い出力)
両クエリとも、正解の文書が1位で返り、スコアも2位以下とはっきり差が付きます。
device: cpu

クエリ: 有給はいつから取れますか?
  1. score=0.8733  有給休暇は入社6か月後から10日付与され、申請は勤怠システムから3営業日前までに行う。
  2. score=0.8332  リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求められる。
  3. score=0.8231  経費精算は毎月末締めで、領収書を添付して翌月5日までに申請する。承認は部門長が行う。

クエリ: 本番にデプロイする条件は?
  1. score=0.9212  本番環境へのデプロイは、プルリクエストが2名以上のレビュー承認を得た後にのみ実行できる。
  2. score=0.8329  社内VPNに接続するには、多要素認証アプリでワンタイムパスワードを生成する必要がある。
  3. score=0.8297  リモートワークは週3日まで可能で、事前にカレンダーへ在宅予定を登録することが求められる。
まとめ
意外だったのは、Transformer系で最小の30mが、7倍以上のパラメータを持つmultilingual-e5-baseを文類似度で上回ったことでした。なぜ大きくしても伸びなかったのかは、上位モデルには既に上限が近かったのではないかという推測どまりで、機序は切り分けられていません。
この順位はJSTS・JSQuADの短い日本語入力でのものです。実務ドメイン、長文、多言語では測れていません。採用を決める前には、実際の文書と質問で測り直すのが確実です。
埋め込みモデルの入れ替えは、RAG検索の見直しどころの一つにすぎません。チャンク・一次検索・RRF・リランカーのどれから手を付けるか迷うときは、入口記事「RAGの検索精度を上げる方法」がその順序を整理しています。
出典: 評価データ JGLUE(JSTS / JSQuAD): Kurihara et al., “JGLUE: Japanese General Language Understanding Evaluation”, LREC 2022 / yahoojapan/JGLUE(CC BY-SA 4.0)。各モデルのライセンスと使用方法はHugging Face上のモデルカードで確認しました。