
社内の規程やマニュアルから答えを探させる仕組みでは、長い文書をそのまま検索に使いません。あらかじめ短い断片へ切り分けておき、質問に近い断片だけを取り出して回答の材料にします。検索が見ているのは元の文書ではなく断片なので、どこで切るかによって、そもそも取り出せる情報が変わります。
100文字ずつ、重なりを作らずに切る。この設定では、500問中20問の正解が検索前に消えていました。 検索モデルが外したのではありません。「寒帯ジェット気流」という正解が「寒帯ジェッ」と「ト気流」に分かれ、正解全体を含む断片が一つも作られていなかったのです。
取り出す候補の中に答えが存在しないので、後ろの工程をどれだけ磨いても取り返せません。文書を検索してから生成AIに答えさせる仕組みをRAGと呼びますが、この失敗はRAGで精度が落ちる4つの場所のうち最初の段階にあたります。
社内の規程やマニュアルには、元から見出しも段落もあります。その区切りを残すのか、無視して文字数で切り直すのか。文字数で切るなら、何文字にして、隣り合う断片をどれだけ重ねるのか。この判断を実測から決めるために、区切り方だけを8通りに変えて同じ500問を流しました。
先に結論
- 段落や見出しが整っている文書は、元の区切りをそのまま使うのが順位品質(正解を上位へ置けたかを表す指標)で最も高い。nDCG@10で0.8947、固定長の最高は0.8515。取りこぼしの少なさでは、最下位の100文字・重なりなしを除き差が出なかった。文字数をそろえるために壊さない。
- 段落構造を信用できない文書は、200〜400文字・オーバーラップ20%(隣り合う断片と共有する重なり)が起点。
- 小さく切るなら、平均スコアを比べる前に正解が切れていないかを数える。100文字・重なりなしでは500問中20問が検索前に脱落。
- 射程は、JSQuAD由来の日本語文書59本・500問、埋め込みモデルは1種類。
この記事で使う言葉と、前提にしている知識
この先で使う言葉のうち、意味がぶれやすいものだけ先に決めておきます。Pythonで機械学習モデルを一度学習させたことがあれば、検索の評価指標やRAGの構成に詳しくなくても、ここまでで足ります。
- チャンク: 検索できるように文書を切り分けた断片です。この記事で切り方を変える対象がこれにあたります。
- チャンクサイズとオーバーラップ: 1つのチャンクの長さと、隣り合うチャンクを重ねる量です。100文字のチャンクでオーバーラップ20文字なら、末尾の20文字が次のチャンクの先頭にも入ります。
- 埋め込みモデル: 文章を数値の並びへ変換し、意味の近さで検索できるようにするモデルです。
- リランカー: 検索で集めた候補を、別のモデルで並べ直す後段の処理です。
- Recall@5: 正解のチャンクが上位5件に入った質問の割合です。1に近いほど取りこぼしが少ないことを表します。
- nDCG@10とMRR@10: 正解が上位にあるほど1へ近づく指標です。この記事では2つをまとめて順位品質と呼びます。
区切り方だけを8通りに変えて、同じ500問で測った
使ったのは、日本語の質問応答データJGLUE(JSQuAD)から作った59本の長い文書と、そこから抜き出した500問です。各質問には、答えの文字列が文書のどこにあるかを示す印が付いています。
変えたのはチャンクの区切り方だけです。固定長は100・200・400・800文字にオーバーラップ0%または20%を組み合わせた7構成(800文字は20%のみ)で、これに元の段落境界をそのまま使う構成を加えました。埋め込みモデル、質問、正解の判定は全構成で同じものを使っています。
正解と数えるのは、チャンクが答えの文字列を丸ごと含んでいる場合だけです。一部しか含まないチャンクは正解に数えません。
始める前の予想は2つありました。段落で切る構成が固定長より強いこと、そして800文字まで広げると精度が落ちること。当たったのは前者だけです。
段落の切れ目を残した構成が、順位で最も高かった
元の段落境界をそのまま使う構成は、正解を上位へ置く力が固定長7構成のどれよりも高く出ました。つまり、文字数をそろえるために既にある論理的な区切りを壊す理由は、今回の結果からは見つからなかった、ということです。
8構成の主要な数値です。構成名のsizeはチャンクの文字数、ovはオーバーラップの文字数で、ov20なら100文字チャンクの20%に当たります。
| 構成 | Recall@5 | nDCG@10 | MRR@10 | チャンク数 | エンコード時間 |
|---|---|---|---|---|---|
| baseline_paragraph(自然段落境界) | 0.924 | 0.8947 | 0.8732 | 1,145 | 24.6秒 |
| size100_ov0 | 0.838 | 0.7643 | 0.7286 | 1,989 | 25.1秒 |
| size100_ov20 | 0.888 | 0.8082 | 0.7684 | 2,467 | 29.7秒 |
| size200_ov0 | 0.892 | 0.8323 | 0.8014 | 1,009 | 21.6秒 |
| size200_ov40 | 0.916 | 0.8388 | 0.8046 | 1,243 | 26.2秒 |
| size400_ov0 | 0.898 | 0.8321 | 0.7952 | 518 | 21.2秒 |
| size400_ov80 | 0.926 | 0.8515 | 0.8164 | 632 | 26.3秒 |
| size800_ov160 | 0.898 | 0.8220 | 0.7829 | 326 | 25.3秒 |
太字は各指標の最高値です。最高値でも、他の構成との差が残るとは限りません。数値は丸めて表記しています。エンコード時間は8構成とも30秒未満に収まっているので、この規模では構成選びの材料になりません。
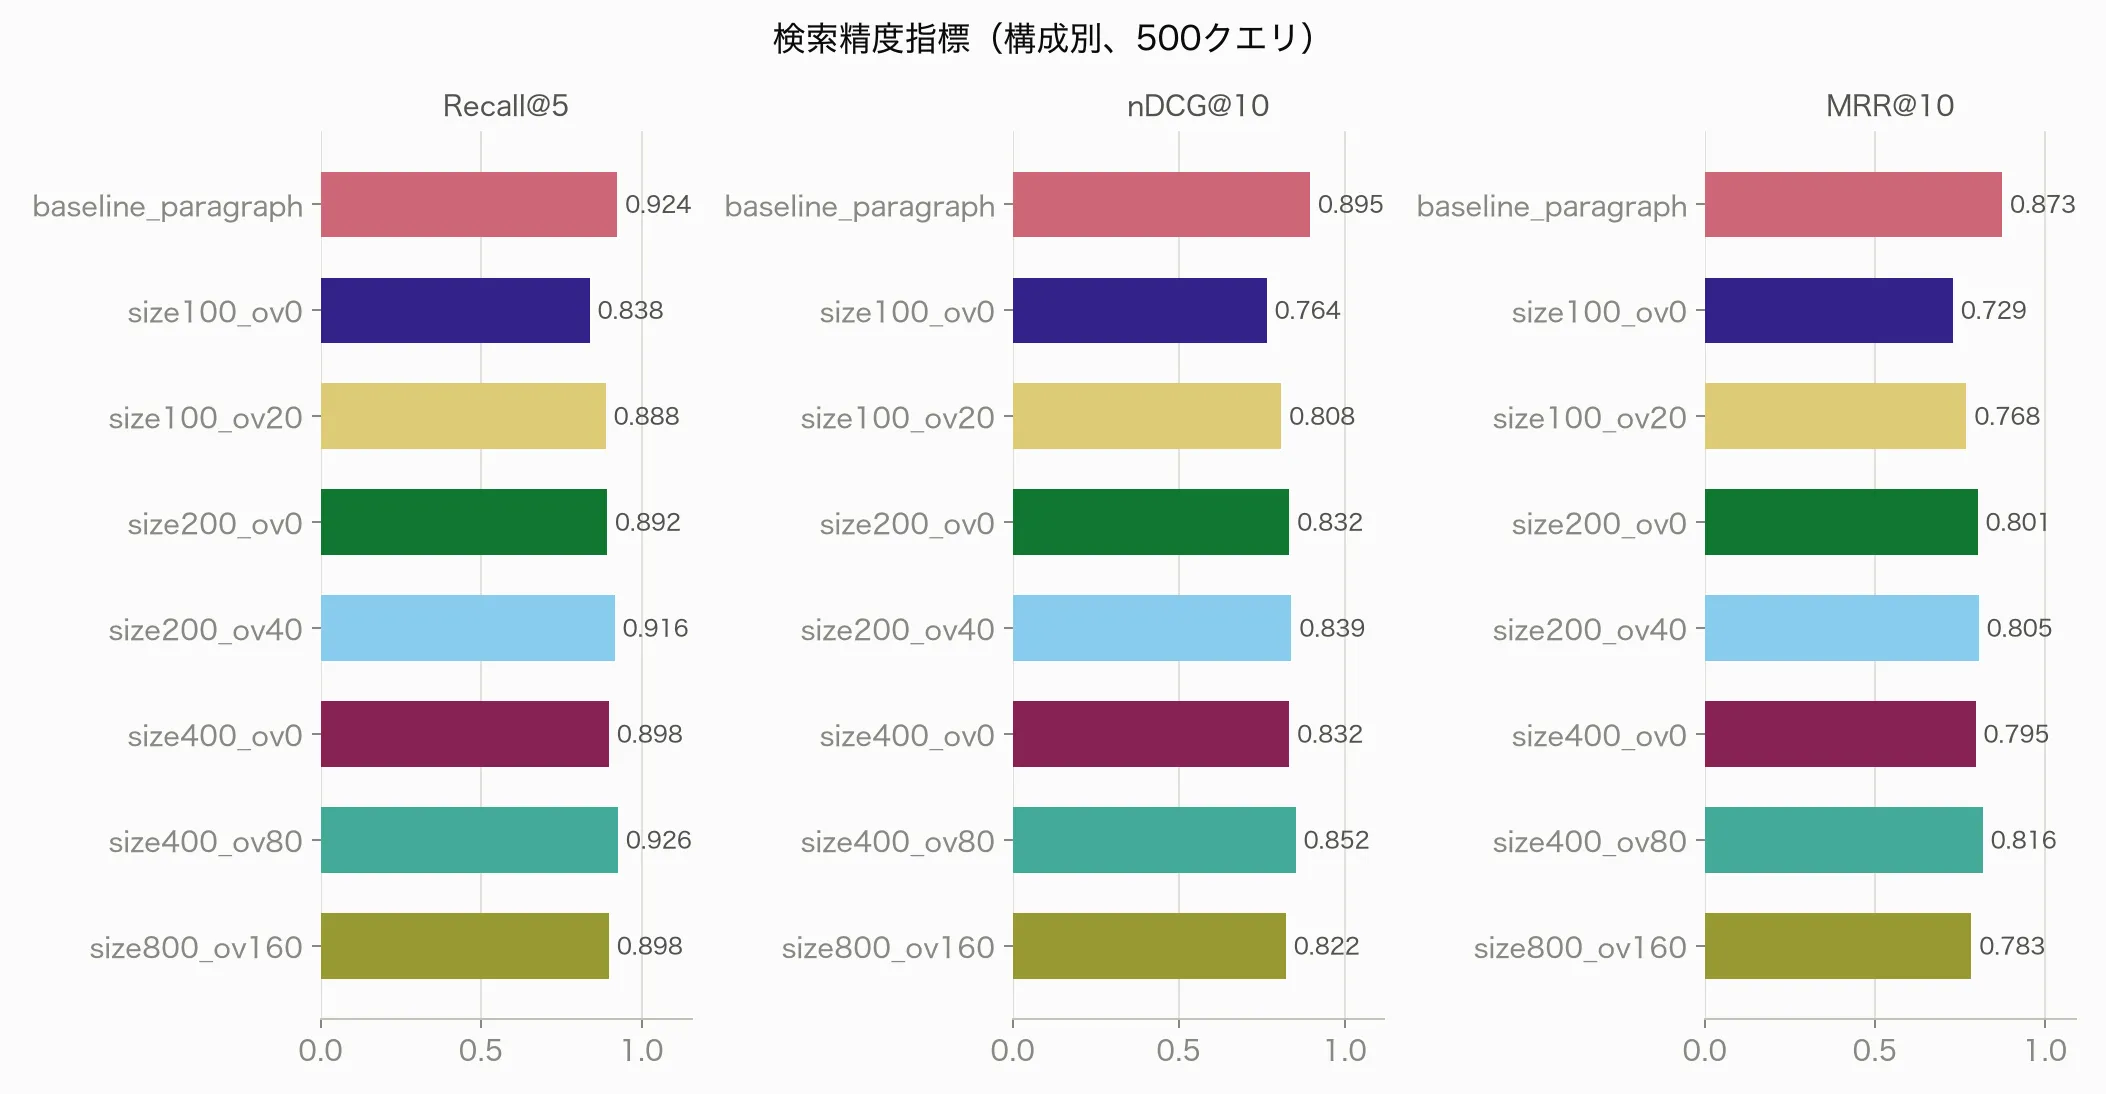
自然段落分割の順位品質は、固定長7構成のどれと比べても、偶然のばらつきを割り引いた後まで差が残りました。一方、Recall@5の0.924は様子が違います。3指標とも最下位の100文字・重なりなしとの差を除くと、残る6構成との間に明確な差を確認できませんでした。
段落分割で効いたのは、正解を見つけられるかどうかではなく、見つけた正解を上位に置けるかどうかの側です。上位5件に入るかどうかだけを見ていると、この差は表に出てきません。
なお、nDCG@10とMRR@10は、1問に複数の正解チャンクがあるとき最上位の1つだけを採点します。重なりを付けて正解候補が増える構成には、この採点方法が有利に働きます。それでも自然分割が上回ったため、今回の順位品質は、オーバーラップで候補が増えたことだけでは説明できません。寄与の大きさまでは定量化していません。
自然段落分割がいつでも最良とは限らない点だけ、先に断っておきます。今回の段落は人間が整えた文章に由来し、ログやOCR出力のように構造が壊れた文書は対象外です。
100文字で重なりを作らないと、20問は正解チャンクすら作れなかった
100文字・重なりなしは3指標とも最下位でした。自然段落分割・200文字・400文字の各構成との差は、割り引いても残っています。ただし、この低さを検索の失敗として読むと対処を間違えます。
正解を丸ごと含むチャンクが存在しない質問では、埋め込みモデルを替えても、候補を並べ直すリランカーを足しても、何位まで見ても拾えません。冒頭で挙げた質問がこれに当たります。
同じことは他の構成でも起きますが、件数が違います。取りこぼしが出たのはオーバーラップなしの3構成だけで、200文字・重なりなしが5問、400文字・重なりなしが3問。突出しているのは100文字・重なりなしの20問です。
オーバーラップ20%の4構成(100・200・400・800文字)と自然段落分割は、いずれも0問でした。自然段落分割のチャンクは元の1,145段落と1対1なので、今回の500問では正解が段落境界をまたいで分断された例はなかったことになります。
同じ100文字でも、20文字のオーバーラップを足すと取りこぼしは0問になりました。冒頭の質問も、正解全体を含むチャンクが生成されて検索2位で拾えています。
ただし、100文字どうしでオーバーラップの有無を比べた3指標の差は、割り引くと残っていません。ここで根拠にすべきなのは指標の差ではなく、正解チャンクを作れたかどうかという数え上げの側です。 平均スコアは、拾えるはずのない20問を含んだまま計算されています。
数え上げにモデルの実行は要りません。手元の正解データと分割器があれば、オーバーラップを足す前後で正解チャンクの数がどう変わるかを比べられます。
800文字まで広げても、落ちるという予想は確かめられなかった
外したのは800文字の予想でした。広げれば精度が落ちると見込んでいたのに、実測は落ちたとも落ちなかったとも判定できません。予想が外れたというより、この500問では答えが出なかった、というのが正確なところです。
オーバーラップ20%どうしで比べると、400文字側が3指標とも高い測定値でした。差はRecall@5で0.0280、nDCG@10で0.0296、MRR@10で0.0335でした。向きは予想と同じです。ただし割り引くと、3指標とも明確な差を確認できません。オーバーラップなしの400文字と比べても同じで、Recall@5の差はちょうど0.0000でした。
予想は確かめられませんでした。 同時に、「落ちなかった」ことを示したわけでもありません。差を区別できないことと、性能が同じであることは別で、後者を主張するには等価性を別に検証する必要があります。
なぜ伸びないのかも切り分けていません。1つのチャンクに複数の話題が混ざって類似度がぼやけた可能性はありますが、今回の設計ではチャンクサイズを変えると候補チャンク数も同時に動くため、長さが効いたのか候補数が効いたのかを分離できていません。 原因についてはここまでです。
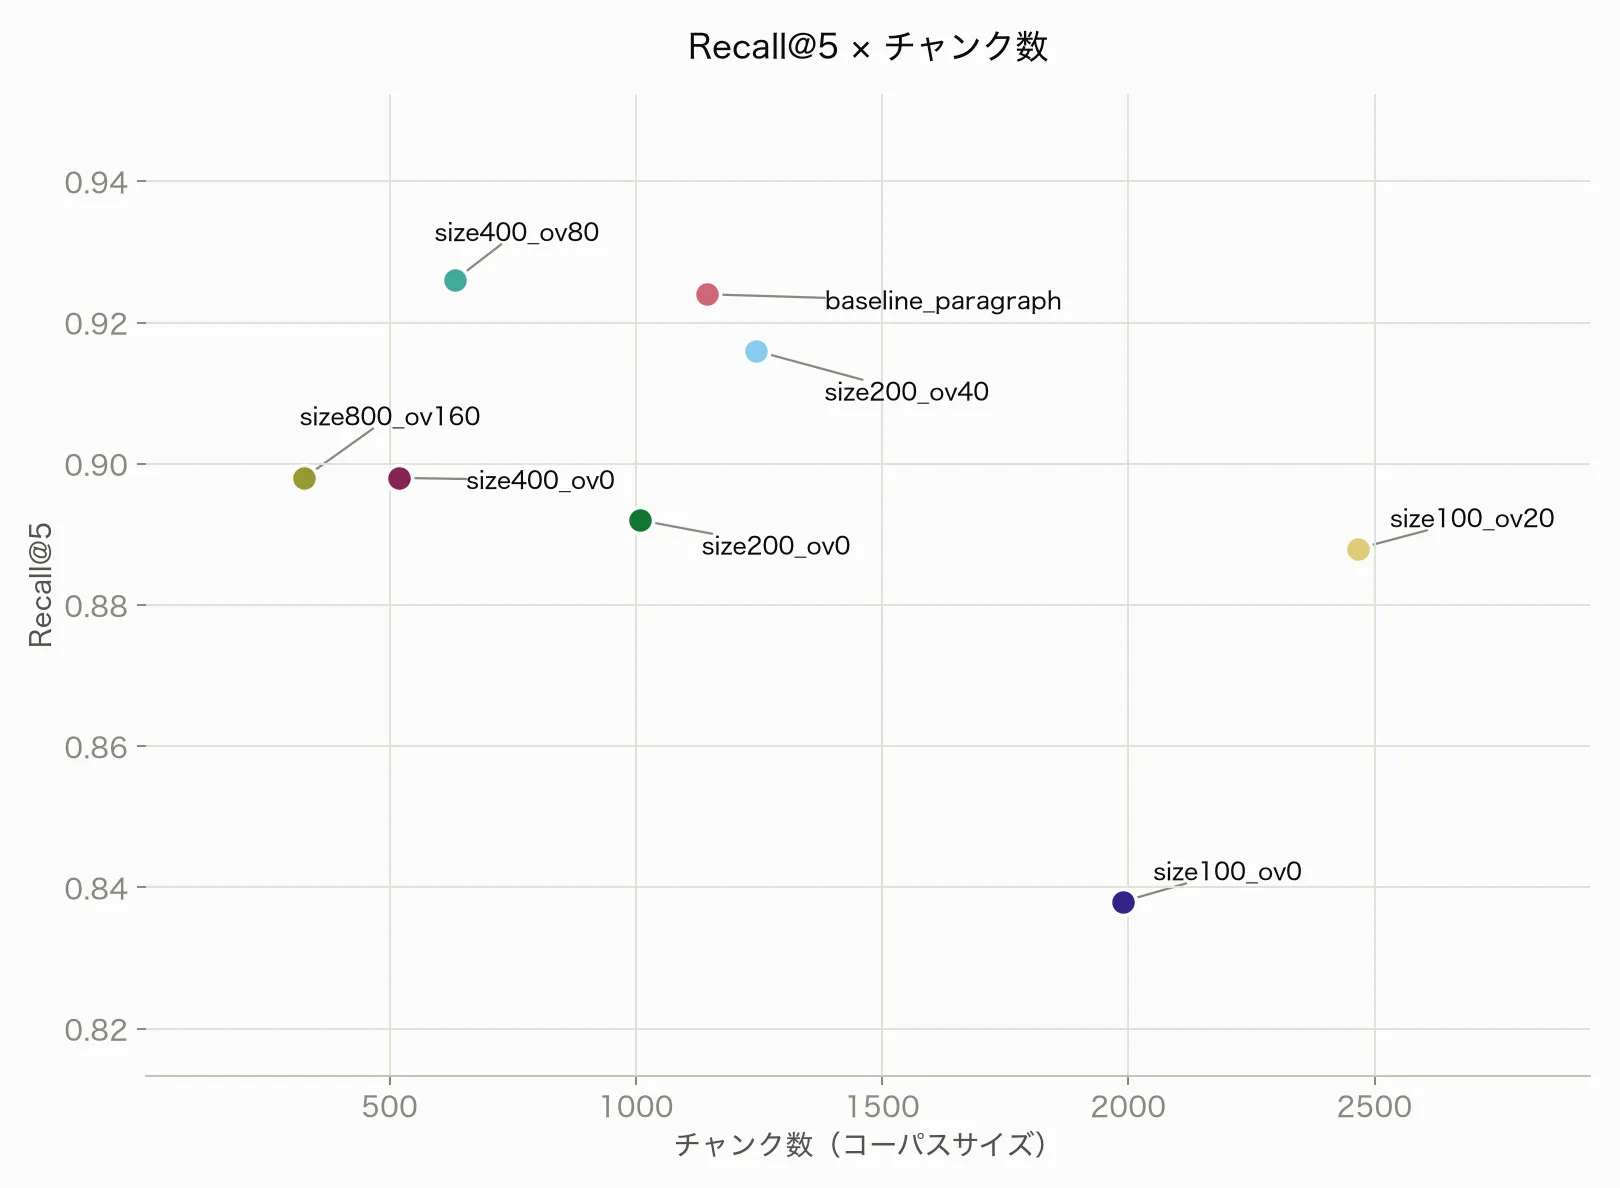
判定を保留したうえで、実務に効く事実がひとつ残ります。候補チャンク数は632件から326件へおよそ半分に減っているのに、精度の改善は見えませんでした。 点推定は400文字側が高いので、800文字が有利になったとまでは言えません。それでも、保存するベクトルを半分にしても判定できるほどの精度差は出なかった、という読み方はできます。
段落が使えるなら残し、使えないなら200〜400文字から始める
元の文書に段落や見出しがあるなら、まずその境界を使います。 文字数をそろえるために既存の区切りを壊す根拠は、今回の8構成の中には出てきませんでした。ここが実務で最初に効く分岐点です。
ログやOCR出力など、境界を信用できない文書は200〜400文字・オーバーラップ20%が起点になります。 この帯は順位品質が中位以上に収まり、100文字・重なりなしのような落ち込みがありません。ベクトル数を抑えたい場合は400文字寄りです。
800文字は、点推定が400文字より下で、差も確認できませんでした。積極的に選ぶ根拠は今回の結果に無く、保存するベクトルの本数を半分にしたい事情があるときの候補にとどまります。
チャンク数と精度の位置関係は、次の散布図で見えてきます。上の表で言えば、400文字・オーバーラップ20%が、少ないチャンク数のままRecall@5の最高値を取った構成です。
小さいチャンクを選ぶなら、平均スコアを見る前に数え上げます。 正解全体を含むチャンクが作れているかは、前の節のとおり、重なりを足す前後で件数が変わります。自分の文書とクエリでも、同じ数え方が使えます。
測り方の細部と、固定した条件
評価に使ったのは、JSQuAD(日本語の抽出型QA)から作った59本の擬似長文書です。同じ記事タイトルの段落を元の順に連結したもので、全体で1,145段落・約19.6万字、文書長の中央値は1,464文字です。各質問には、答えの文字列が文書のどこにあるかを示す正解スパンが付いています。
文書を復元する段階で一度つまずきました。生JSONの段落配列は文字列の辞書順で、番号順ではありません。そのまま連結すると文章の順序が崩れるのに、文字オフセットの整合性は保たれるため、検証用のassertは通ってしまいます。59記事すべてで並びを確認し、番号を数値としてソートしてから連結しました。
固定長の構成は、開始位置をstride(=チャンクサイズ−オーバーラップ)ずつずらすスライディングウィンドウで作りました。長さはPythonのlen()で数えた文字数で、トークン数ではありません。
段落を連結するときの区切り文字は入れていません。末尾チャンクが短くなっても、最小文字数のしきい値は設けていません。どちらも、判断すべき設計パラメータをこれ以上増やしたくなかったためです。
検索文書には検索文書: 、検索クエリには検索クエリ: のprefixを付け、500クエリで全チャンクとのコサイン類似度を計算しています。本文の数値は、この処理を実際に走らせて保存した計測ログから集計したものです。
測ったのは短答QA検索だけで、埋め込みモデルもcl-nagoya/ruri-v3-130mの1種類です。ここから外れる条件で何が言えないかは、記事末の適用範囲と限界にまとめました。
「改善を確認できた」という言い方は、偶然のばらつきと、28ペアを同時に比べる影響を差し引いた後も残った差に限って使っています。差し引いた結果「明確な差を確認できなかった」構成どうしは、同等だと分かったのではなく、この評価では区別が付かなかったという意味です。
読み飛ばし可: データの取得元・クエリ抽出・統計手法・全ペア検定の内訳
質問は記事→段落→設問の決定的な順で並べ、random.Random(42)で500問を抽出しました。抽出前に、正解スパンが記事タイトル部分にかかる469問を母集団から除いています。JSQuADのanswer_startはタイトル込みの本文を基準にしており、タイトルを外した文書には該当する正解が存在しないためです。残る3,973問が有効プールになります。オーバーラップで複数の正解チャンクがあるときは、nDCG@10とMRR@10で最も順位が高い正解を採用しました。
段落配列の並びはp0, p1, p10, p11, ..., p2, p20という文字列の辞書順でした。本文で触れたソートは、この並びを段落番号の数値順へ直す処理です。
同じ500クエリを使った対応のある比較を行い、複数の構成を同時に比べる影響も割り引きました。比較の組み合わせが多いほど偶然でも差が出やすくなるため、その分を差し引いて判定しています。評価サンプルに対する推定の不確実性は対のあるブートストラップ(B=10,000、seed=42)で見積もり、Recall@5にはMcNemar検定も併用しました。28ペア×3指標を、指標ごとに28ペアの検定族としてBonferroni補正(有意水準0.05)しています。
指標ごとに、補正の前後で差が残ったペアの数は次のとおりです。
| 指標 | 補正前に差が0を含まないペア | Bonferroni調整後も残ったペア |
|---|---|---|
| Recall@5 | 14/28 | 5/28 |
| nDCG@10 | 17/28 | 12/28 |
| MRR@10 | 17/28 | 11/28 |
全指標をまとめた84検定を1つの家族とする、より保守的な代替でも算出しており、判定が変わるペアがあります。例えば100文字・重なりなしと800文字・オーバーラップ20%のnDCG@10は、指標ごとの家族では調整後も残りましたが、まとめた家族では残りませんでした。
出典: Kurihara et al., “JGLUE: Japanese General Language Understanding Evaluation”, LREC 2022 / yahoojapan/JGLUE(CC BY-SA 4.0)。
適用範囲と限界
- 短答QA検索の結果です。要約、多段推論、複数箇所の情報を集める検索には、そのまま適用できません。
- JSQuAD由来の擬似長文書と単一の埋め込みモデルで測りました。実際の文書構造やモデルが変われば、結果も変わり得ます。
- 段落境界の利点は、人間が整えた段落を前提にしています。ログやOCR出力のように構造が壊れた文書では、同じ結果を期待できません。
- 大きいチャンクは候補の総数そのものを減らします。長さが効いたのか候補数が効いたのかは、分けて測れていません。
- 正解と判定するのは、解答スパンをチャンクが丸ごと含む場合だけです。一部だけ含むチャンクは不正解扱いで、結論はこの定義に依存します。
- 解答が記事タイトル部分にかかる469問を除いた3,973問から、500問を抽出しました。JSQuAD全体をそのまま代表する標本ではありません。
- 埋め込みモデル9種を比べた回のRecall@5=0.976と、本記事の自然段落分割のRecall@5=0.924は、同じruri-v3-130mを使っていますが、クエリ標本と正解判定の基準が異なるため直接比較できません。
- 100・200・400・800は文字数です。「512トークン」とは比較できません。
手元の文書で試す最小のコード
チャンク分割の核は、文字数ベースのスライディングウィンドウです。開始位置をstrideずつずらしてchunk_size分を切り出し、文書末尾に達したら止めます。末尾チャンクはchunk_sizeより短くなるのを許容します。
以下は、cl-nagoya/ruri-v3-130m(Apache-2.0)ひとつで分割から検索までを再現する、動く最小デモです。デモ文書が短いので、分割の様子が見えるようチャンクサイズは50文字にしています。
自分のデータで動かすときは、DOCUMENTを手元の長文に差し替え、CHUNK_SIZE・OVERLAPを200〜400文字・オーバーラップ20%あたりから動かしてみてください。検索文書: と検索クエリ: のprefixは外さないでください。外すとこの記事の精度は再現できません。
"""日本語RAGのチャンク分割を手元で試す最小デモ(cl-nagoya/ruri-v3-130m)。"""

from sentence_transformers import SentenceTransformer

DEVICE = "cpu"  # 掲載出力と一致させるため固定

# 以下は自分の長文ドキュメントに置き換えて使う
DOCUMENT = (
    "有給休暇は入社6か月後から10日付与され、勤続年数に応じて最大20日まで増加する。"
    "申請は勤怠システムから3営業日前までに行うこと。取得単位は1日または半日で、"
    "時間単位の取得は現時点では対応していない。経費精算は毎月末締めで、領収書を添付して"
    "翌月5日までに申請する。承認は部門長が行い、10万円を超える経費は追加で経理部の承認が"
    "必要になる。社内VPNに接続するには、多要素認証アプリでワンタイムパスワードを生成する"
    "必要がある。初回接続時はIT部門への申請が必要で、承認まで1営業日ほどかかる。"
)

QUERY = "経費精算の締め日はいつですか?"

CHUNK_SIZE = 50  # 文字数
OVERLAP = 10  # 文字数(20%相当)
TOP_K = 3


def sliding_window_chunks(text: str, chunk_size: int, overlap: int) -> list[str]:
    """文字数ベースのスライディングウィンドウで分割する。末尾は短いまま許容。"""
    stride = chunk_size - overlap
    assert stride >= 1, "overlap は chunk_size 未満にすること"
    chunks = []
    start = 0
    n = len(text)
    while start < n:
        end = min(start + chunk_size, n)
        chunks.append(text[start:end])
        if end == n:
            break
        start += stride
    return chunks


def main() -> None:
    chunks = sliding_window_chunks(DOCUMENT, CHUNK_SIZE, OVERLAP)
    print(f"チャンク数: {len(chunks)}(chunk_size={CHUNK_SIZE}, overlap={OVERLAP})")
    for i, c in enumerate(chunks):
        print(f"  [{i}] ({len(c)}文字) {c}")

    model = SentenceTransformer("cl-nagoya/ruri-v3-130m", device=DEVICE)

    # 検索では "検索文書: " prefix が必須
    doc_embeddings = model.encode(
        ["検索文書: " + c for c in chunks],
        normalize_embeddings=True,
        convert_to_numpy=True,
    )
    query_embedding = model.encode(
        "検索クエリ: " + QUERY,
        normalize_embeddings=True,
        convert_to_numpy=True,
    )
    scores = doc_embeddings @ query_embedding
    top_idx = scores.argsort()[::-1][:TOP_K]

    print(f"\nクエリ: {QUERY}")
    for rank, idx in enumerate(top_idx, start=1):
        print(f"  {rank}. score={scores[idx]:.4f}  [{idx}] {chunks[idx]}")


if __name__ == "__main__":
main()上のコードをquickstart_chunking.pyとして保存し、次のように環境を作って走らせます。
# uv を使う場合(推奨)
uv venv --python 3.12
uv pip install sentence-transformers "transformers==4.57.6" sentencepiece protobuf
uv run --no-project python quickstart_chunking.py

# pip を使う場合
python3.12 -m venv .venv
source .venv/bin/activate        # Windows は .venv\Scripts\activate
pip install sentence-transformers "transformers==4.57.6" sentencepiece protobuf
python quickstart_chunking.pysentencepiece・protobufは、transformers==4.57.6でcl-nagoya/ruri-v3-130mのトークナイザを読み込むのに必要です。--no-projectを付けているのは、保存先の親ディレクトリに別のpyproject.tomlがあると素のuv runがそちらの環境を掴み、直前に作った.venvが無視されるためです。
上のスクリプトをそのまま実行すると、次の出力が得られます。
実行結果(クエリに対する検索順位)
チャンク数: 6(chunk_size=50, overlap=10)
  [0] (50文字) 有給休暇は入社6か月後から10日付与され、勤続年数に応じて最大20日まで増加する。申請は勤怠システム
  [1] (50文字) 。申請は勤怠システムから3営業日前までに行うこと。取得単位は1日または半日で、時間単位の取得は現時点
  [2] (50文字) 間単位の取得は現時点では対応していない。経費精算は毎月末締めで、領収書を添付して翌月5日までに申請す
  [3] (50文字) 翌月5日までに申請する。承認は部門長が行い、10万円を超える経費は追加で経理部の承認が必要になる。社
  [4] (50文字) 承認が必要になる。社内VPNに接続するには、多要素認証アプリでワンタイムパスワードを生成する必要があ
  [5] (45文字) ドを生成する必要がある。初回接続時はIT部門への申請が必要で、承認まで1営業日ほどかかる。

クエリ: 経費精算の締め日はいつですか?
  1. score=0.9240  [2] 間単位の取得は現時点では対応していない。経費精算は毎月末締めで、領収書を添付して翌月5日までに申請す
  2. score=0.8854  [3] 翌月5日までに申請する。承認は部門長が行い、10万円を超える経費は追加で経理部の承認が必要になる。社
  3. score=0.8226  [1] 。申請は勤怠システムから3営業日前までに行うこと。取得単位は1日または半日で、時間単位の取得は現時点
クエリ「経費精算の締め日はいつですか?」に対し、経費精算に触れる[2]番のチャンクが0.9240で1位に来ています。末尾の[5]が45文字と短いのは、最小文字数のしきい値を設けずそのまま許容しているためです。
段落を壊さず、小さく切るなら数えてから比べる
段落で切るか文字数で切るか。この問いへの答えは、段落構造が信頼できるなら段落です。今回の自然段落分割は、順位品質の2指標で固定長7構成を上回りました。この記事から持ち帰ってほしいことの、まず一つは、既にある段落境界を壊さないことです。
もうひとつ残ったのは、平均スコアだけを眺めていては気づけない失敗がある、という事実です。正解が境界でちぎれた質問は、検索モデルを替えても取り戻せません。分割の設定をいじったら、スコアより先に、作られたチャンクの側を見ます。
次に確かめたいのは、埋め込みモデルを変えても段落分割の優位が残るのかです。今回は1つのモデルに固定しているため、この問いには答えが出せていません。段落分割が効いた理由の大きさや、チャンクサイズと候補数それぞれの影響も、まだ切り分けられていません。
チャンク分割の先には、候補を集める一次検索、複数の検索結果を混ぜるRRF、候補を並べ直すリランカーが続きます。どこから改善するか迷っている場合は、入口記事「RAGの検索精度を上げる方法」に見直しの順番をまとめてあります。
出典: 評価データ JGLUE(JSQuAD): Kurihara et al., “JGLUE: Japanese General Language Understanding Evaluation”, LREC 2022 / yahoojapan/JGLUE(CC BY-SA 4.0)。埋め込みモデル: cl-nagoya/ruri-v3-130m(Tsukagoshi & Sasano, arXiv:2409.07737、Apache-2.0)。