
A/Bテストを回していると、結果は毎日ダッシュボードに出ます。差が開いてきたら嬉しくなって、その時点で「勝ちが確定した」と判断して打ち切る。逆に差が縮んだら、もう少しサンプルを貯めようと待つ。どちらも自然な行動です。
この運用がまずいことは、知識としてはかなり広まりました。「途中で何度も見ると、本当は差が無いのに差があると判定しやすくなる」という注意書きは、A/Bテストの解説記事にたいてい載っています。
ただ、どれくらい増えるのかを数字で言えるでしょうか。5%が6%になるのか、それとも30%になるのか。ここが分からないと、実務の判断が変わりません。20回見て5.5%になるだけなら、意思決定の速さと引き換えに許容できる話です。逆に25%なら、それは意思決定ではなく偶然を採用しているだけになります。
補正の話も同じで、「Bonferroni 補正をかければよい」という助言はよく見ますが、その代償は書かれていません。誤って「差がある」と言う回数を減らせば、本物の差も見逃しやすくなります。どれだけ見逃すようになるのかを知らないまま補正を入れると、今度は効いている施策を捨てることになります。
そこで、真の差がまったくゼロの環境をシミュレーションして、覗き見の回数ごとに誤判定の割合を数えました。50回覗いた条件では、3回に1回が「差があった」と判定されます。
先に結論: 5回覗くだけで、誤判定は名目の約2.8倍
- 真の差がゼロでも、途中経過を覗いて「有意になったら止める」と、差が無いのに「差がある」と判定する割合(偽陽性率)は膨らむ。覗き見50回で 0.3167、名目 5% の約6.3倍
- 5回でも 0.1400 で既に約2.8倍。よくある「毎日ダッシュボードを見る」運用はこの範囲に入る
- 覗いた回数で割る補正(Bonferroni 補正)は効きすぎる。50回の条件では偽陽性率が 0.0113 まで下がる一方、検出力(本当に差があるときに気づける割合)は 0.0763 で、覗かずに1回だけ判定する場合の 0.3150 を大きく下回る
- 事前に較正した一定の境界(差がゼロの状態を先に回して境界値を決めておくやり方)は、全条件で偽陽性率 0.0478〜0.0523 を保った。検出力は50回で 0.1943 と、回数で割る補正の2.5倍。ただし1回だけ判定する場合の 0.3145 からは4割落ちる
- この2.5倍は、真の差を相対10%改善に置いた検出力の低い設計での大きさ。改善幅を +20%・+30% に上げると、50回での比は 1.4605 倍・1.0889 倍まで縮む
- 適用条件: 比率の指標・片群最大4,000件・変換率0.10・両側5%・等間隔で早い時点から見る覗き見(50回条件では初回が片群80件)。実データではなくシミュレーション
偽陽性率と検出力で採点し、境界の決め方を比べる
偽陽性率は、A群とB群に本当は差が無いのに「差がある」と判定してしまった割合です。判定の基準を5%に置くというのは、この割合が5%に収まるつもりで運用するという意味で、低いほど良い点数になります。もう1つの検出力は向きが逆で、本当に差があるときにそれを見つけられた割合。こちらは高いほど良い値です。補正の議論は偽陽性率だけで語られがちなので、この記事では2つを必ず並べて出します。
判定を左右するのが境界値です。各時点で群間の差の大きさを統計量にして、「ここを超えたら差があるとみなす」というラインと比べます。基準を厳しくするというのは、この境界値を上げることにあたります。
比べたのは、その境界値の決め方が違う3つのやり方です。
- naive(補正なし): 毎回そのまま 5% の基準で判断し、超えたら止める
- 回数で割る補正(Bonferroni 補正): 覗き見の回数で 5% を割り、厳しくした基準を毎回使う。以下では「回数で割る補正」と呼びます
- 較正した一定境界: 全体で 5% に収まるように、境界の値を事前にシミュレーションで求めて使う(Pocock 型)
有意水準5%や p 値という言葉はそのまま使いますが、逐次検定の理論には立ち入りません。
差がゼロの状態を6,000回作り、覗き見の回数だけを変えた
使ったのはシミュレーションです。ベースラインの変換率を 0.10 とし、A群とB群にまったく同じ変換率を与えました。真の差はゼロなので、「差がある」と判定されたら必ず誤りです。片群あたり最大 4,000件まで観測を貯めていきます。
覗き見の回数は6水準です。1回・2回・5回・10回・20回・50回で、タイミングは等間隔にしました。1回は「途中で見ずに最後だけ見る」通常の運用にあたり、これが基準になります。各時点で2標本の比率を比べ、一度でも境界を超えたらそこで止めるという運用を再現しています。
採点は6,000回の反復で数えました。検出力を測る側だけは、B群の変換率を相対で10%上げた環境を使っています。
実測前に置いていた見立ては、「覗く回数が増えるほど偽陽性率は膨らむ。補正すれば抑えられるが、検出力を失う」というものでした。膨らむ量も失う量も、大きさまでは書いていません。
なお、実データではなく合成のシミュレーションで、指標も比率だけです。連続値の指標や不規則な覗き見など、測っていない条件は記事末の「適用範囲と限界」に、乱数の分け方や健全性の確認は「詳しい検証条件」にまとめました。
覗き見50回で、偽陽性率は31.7%に達した
真の差がゼロのテストでも、途中経過を見て「有意になったら止める」運用にすると、「差があった」と判定される割合が跳ね上がりました。実務で先に見てほしいのは、たぶん50回の行ではなく途中の行です。
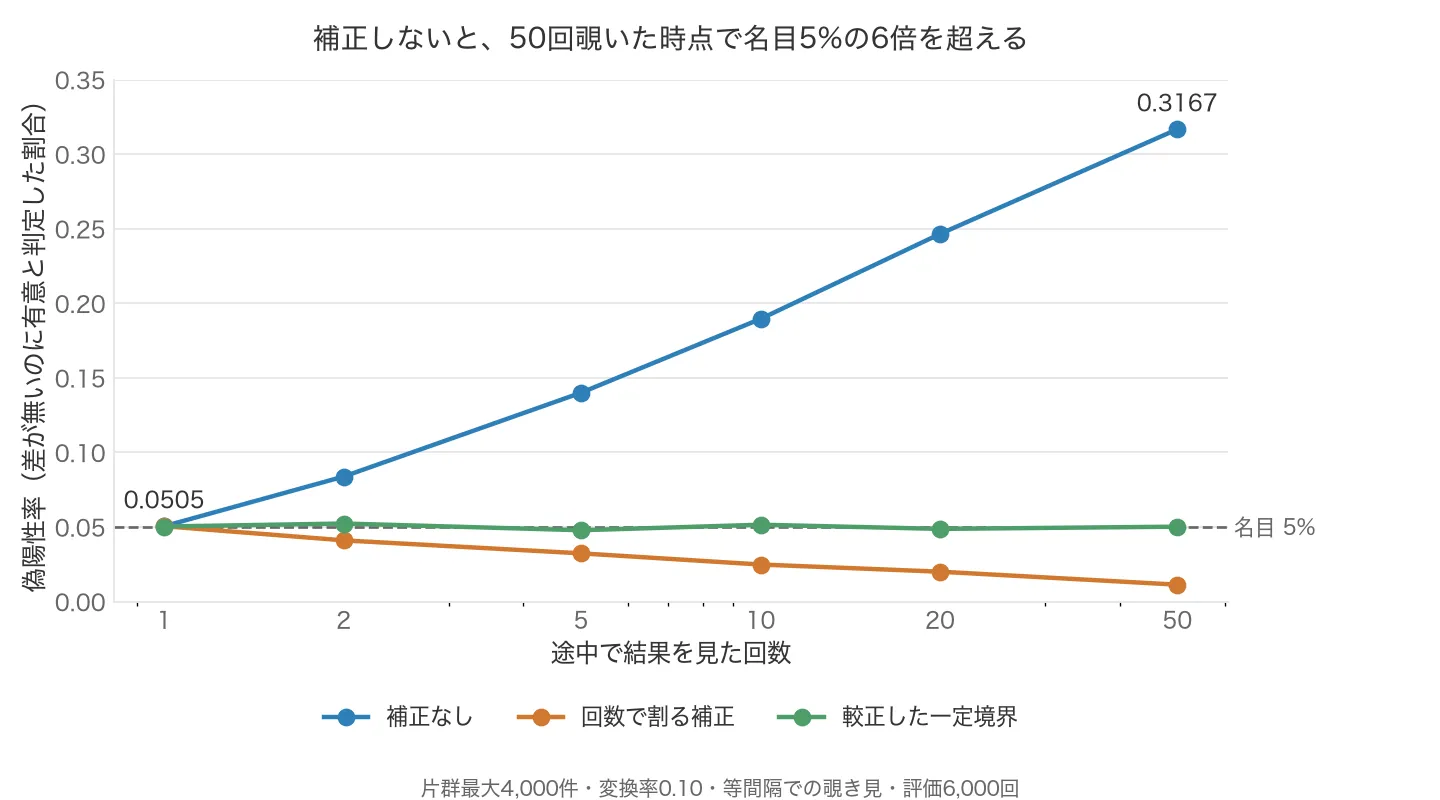
| 覗き見の回数 | naive | 回数で割る補正 | 較正した一定境界 |
|---|---|---|---|
| 1 | 0.0505 | 0.0505 | 0.0503 |
| 2 | 0.0838 | 0.0410 | 0.0523 |
| 5 | 0.1400 | 0.0323 | 0.0478 |
| 10 | 0.1895 | 0.0248 | 0.0515 |
| 20 | 0.2465 | 0.0200 | 0.0487 |
| 50 | 0.3167 | 0.0113 | 0.0502 |
補正なしの偽陽性率は覗き見の回数とともに単調に増え、50回では真の差がまったく無いテストの3回に1回が「有意」と判定される水準に達します。2週間のテストを毎週見れば2回、平日に毎日見れば10回。10回の 0.1895 は、5回に1回は偶然を拾うという意味です。「毎日ダッシュボードを確認して、良さそうなら早めに切り上げる」という、多くの現場でごく普通に行われている運用が、この範囲にそのまま入ります。
増える理由は単純で、判定の機会が増えれば、そのどこかで境界を超える確率も上がります。1回の判定で誤る確率が5%でも、50回試せばどこかで超える確率はずっと高くなります。
ただし、増え方は「50回ぶん」ほどではありません。 もし50回の判定が互いに独立なら、少なくとも1回超える確率は 92.3% になります(0.95 を50回かけた残りです)。実測はその3分の1でした。途中経過を繰り返し見るというのは、ほとんど同じデータを何度も見ることなので、判定どうしが強く相関しています。相関しているぶん、独立な場合より膨らみ方は小さくなります。この「重なり」が、あとで補正のやり方を分ける鍵になります。
回数で割る補正は、抑えるが抑えすぎる
回数で割る補正をかけると、誤判定はきちんと止まります。50回で偽陽性率 0.0113、名目 5% の約4分の1です。問題は代償の方でした。真の差があるとき(相対10%の改善)に、それを見つけられた割合が次の表です。
| 覗き見の回数 | naive | 回数で割る補正 | 較正した一定境界 |
|---|---|---|---|
| 1 | 0.3150 | 0.3150 | 0.3145 |
| 2 | 0.3590 | 0.2525 | 0.2798 |
| 5 | 0.4297 | 0.1925 | 0.2447 |
| 10 | 0.4780 | 0.1513 | 0.2302 |
| 20 | 0.5270 | 0.1127 | 0.2080 |
| 50 | 0.5828 | 0.0763 | 0.1943 |
50回での 0.0763 は、本当に10%改善する施策を試しても13回に1回しか気づけないという水準です。しかも覗き見1回のとき、つまり補正しないときの 0.3150 を大幅に下回ります。途中で覗くために補正を入れた結果、途中で覗かない場合よりも本物を見つけられなくなっています。
失うだろうとは見立てていましたが、どこまで失うかがこの数字でした。覗き見を増やすほど検出力が下がるのは、割る数が増えて基準が厳しくなるためです。50回なら 5% を50で割った水準を毎回使うので、境界は相当高くなります。偽陽性を確実に抑える代わりに、本物も一緒に弾いている状態です。
較正した一定の境界なら、検出力の犠牲は小さくできた
3つ目のやり方は、事前のシミュレーションで「全体として 5% に収まる境界」を求め、それを毎回使うものです。偽陽性率を名目の近くに置けたのは3つのうちこれだけで、途中で止める判断をしたいなら既定の候補になります。
偽陽性率は全条件で 0.0478 から 0.0523 に収まりました。検出力は50回で 0.1943 と、回数で割る補正の2.5倍以上です。
差が出るのは、抑えている量が同じではないからです。どちらも名目 5% を狙っているのに、回数で割る補正は 0.0113 まで過剰に抑えていて、使い残したその余裕を検出力で払っています。較正した境界の方は 0.0502 で名目のところに止まっているので、許された余裕を使い切れています。
なぜ過剰になるのか。回数で割るやり方は、判定どうしの関係を問わず成り立つ補正です。「判定が独立なときの補正」と説明されることがありますが、実際はどれだけ重なっていても確率を足し上げて上から押さえる作りになっています。ただし成り立たせるために余裕を多めに取るので、判定が強く相関しているほど厳しくしすぎます。この実験がまさにその状況で、前節のとおり実測の膨らみは独立な場合の3分の1でした。較正はシミュレーションで重なりを直接測るぶん、必要なだけ境界を上げられます。
ただし犠牲がないわけではありません。同じ較正境界でも、覗き見1回なら 0.3145 だった検出力が、50回覗くと4割落ちます。覗く回数を増やすこと自体に代償があり、較正はそれを小さくするだけです。「較正すれば何回覗いてもただ」ではありません。
2.5倍という差は、検出力が低い設計だから大きい
この2.5倍を、そのまま持ち帰れる一般の数字として読まないでください。ここまでの検出力は、真の差を相対10%改善に置いた場合の値です。この設定では途中で覗かなくても検出力が 0.3150 しかありません。2.5倍がこの低い水準に固有のものなのかを見るため、設計も乱数の種も据え置いて、改善幅だけを上げて測り直しました。
| 真の差(相対) | 1回だけ判定したときの検出力 | 較正 ÷ 回数で割る補正(10回) | 同(50回) |
|---|---|---|---|
| +10%(上の表と同じ条件) | 0.3150 | 1.5215 | 2.5465 |
| +20% | 0.8210 | 1.1566 | 1.4605 |
| +30% | 0.9877 | 1.0244 | 1.0889 |
較正した境界の方が検出力が高いという向きは、3条件すべてで変わりませんでした。変わるのは差の大きさです。+30% では50回覗いても 1.0889 倍で、実際の値は 0.9530 対 0.8752。どちらを使ってもほぼ同じところに着きます。+20% の50回でも 1.4605 倍で、+10% とはだいぶ違う話になります。
測ったのは3点だけなので、そのあいだで比がどう動くかは分かりません。3点で単調に縮んだことから言えるのは、2.5倍は検出力が低い設計だから大きく出た値だということです。見つけたい改善幅が大きく検出力に余裕のある設計なら、較正の手間に見合う差は小さくなります。逆に検出力が足りていない設計ほど、どちらを選ぶかが結果を左右します。
補正なしの「検出力の高さ」を長所として読まない
検出力の表では、naive の列がすべて最も高くなっていました。50回で 0.5828、較正した境界の3倍です。ここだけを取り出すと補正なしが最良に見えますが、そう読むと判断を誤ります。
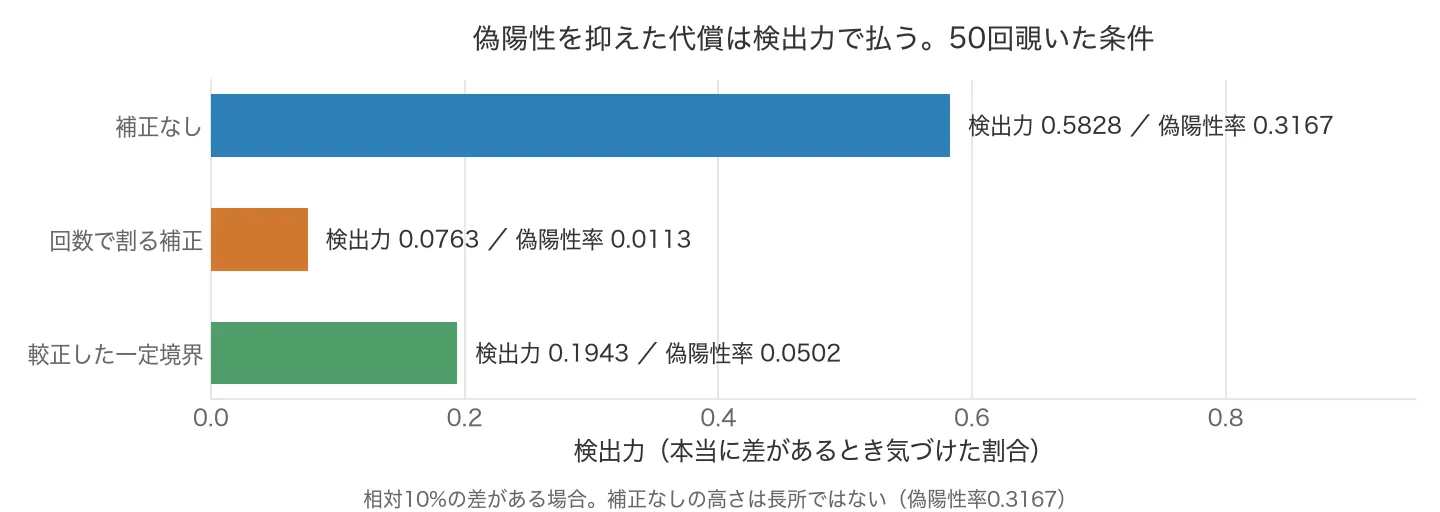
同じ運用が、真の差がゼロの環境では名目の6倍を超える割合を「有意」と呼んでいました。覗き見を増やせば「差がある」と言いやすくなるのは当然で、本物のときも偶然のときも同じように言いやすくなっているだけです。検出力と偽陽性率は同じ挙動の裏表なので、片方だけを取り出して評価することはできません。
偽陽性率と検出力を1枚に並べる意味はここにあります。補正を入れない選択肢の見かけ上の強さも、補正の代償と同じ理屈から出ていることが、2つを並べると見えます。
実務での選び方: まず「判断に使う覗き見」を数える
迷ったらサンプルサイズを事前に決めて、途中で判断しない: 覗き見1回なら補正も要りません。偽陽性率は 0.0505 で、名目のとおりでした。自分の運用では、まず「何回見て、そのうち何回で止める判断をしうるか」を数えてください。判断に使わない閲覧は覗き見に数えません。
途中で止めたいなら、較正した一定境界を自分の設定で作る: 全条件で偽陽性率が名目5%の近くに収まり、検出力の犠牲も回数で割る補正よりずっと小さいやり方です。境界は片群4,000件・変換率0.10・等間隔という今回の設計に対して求めた値なので、そのまま定数として持ち出せません。自分の設定でシミュレーションして求め直してください。その優位の大きさも、相対10%改善という検出力の低い設定で測ったもので、検出力に余裕のある設計ではどちらを選んでも着地はあまり変わりません(改善幅を振った表)。
すでに覗き見ありで運用しているなら、過去の「有意」を割り引いて読む: 今回と同じように早い時点から等間隔で10回見て、途中で止める判断をしている運用なら、効果が本当はゼロの施策でもおよそ2割の割合で「差がある」と判定します。最低サンプル数を決めてから見始めている運用なら、この値より小さくなるはずですが、そちらは測っていません。判定は両側なので、B が勝って見えるのはそのうちおよそ半分です。過去の勝ち判定のうちどれだけが偶然かは、試した施策に本物の効果がどれだけあったかに依るためこの数字だけでは決まりませんが、重要な勝ち判定は再テストする価値があります。
回数で割る補正は、覗き見が数回までの保険: 使うなら数回までです。2回なら較正した境界との検出力の差は 0.03 に届きません。回数が増えるほど不利になり、10回を超えると差が開きます。
詳しい検証条件
較正に使ったデータで評価すると、自分で合わせた基準を自分で採点することになり、実力より良く見えます。ここを分けたのが設計の要点です。較正は4,000回、評価は6,000回の反復で、検出力の測定にはさらに別の系列を使いました。
結果を読む前に、健全性を確認しています。覗き見1回のとき、3手法とも偽陽性率は 0.0503 から 0.0505 でした。名目 5% とほぼ一致しているので、シミュレーションと判定のコードが正しく較正されていることを確かめたうえで、以降の結果を読んでいます。
検出力を測るために置いた相対10%という改善幅は、検出力としては低めの設計です。途中で覗かず1回だけ判断する場合でも検出力は 0.3150 で、本当に10%改善している施策の3回に2回を見逃します。手法どうしの差がこの水準に固定されていないかを見るために、設計と乱数の種はそのままにして、改善幅だけを相対 +20%・+30% に上げた条件も測りました(この追加分の実測は 2026-08-17)。
覗き見のタイミングは、片群4,000件までを等分した位置です。回数が多い条件ほど1回目が早く来る作りで、50回条件では最初の判定が片群80件で起きます。
数値はすべて、実行して保存したログから拾っています。乱数の種は固定してあり、本文の表と、記事末に載せた実行結果は同じ18行です。
適用範囲と限界
- 比率の指標に限定した結果です。売上や滞在時間のような連続値、とくに分散が大きく歪んだ指標では膨らみ方が変わりえます
- 等間隔の覗き見だけを測っています。「気になったときに見る」という不規則な覗き見は未検証で、こちらの方が実務では一般的です
- 覗き見をかなり早い時点から始めています。50回の条件では最初の判定が片群80件(最終の2%)で起きます。早い時点の判定ほど偽陽性の膨張に効いていると考えられ、「片群何件貯まるまでは見ない」と最低サンプル数を決めてから覗く運用なら今回の値より小さくなるはずですが、開始位置を変えた条件は測っていません
- 較正した境界の値はこの設計専用です。片群4,000件・変換率0.10・等間隔で求めたもので、他の設定へ定数として持ち出せません
- 比較対象は3つだけです。後半ほど基準を緩める境界(O’Brien-Fleming 型)や、いつ見ても妥当な p 値(always-valid p-value)・信頼列といった、より新しい手法は比較していません。実務ではそちらの方が扱いやすい場面があります
- 主要な表の検出力は相対10%改善という1条件のもので、1回だけ判定する場合でも 0.3150 という低い水準の設計です。改善幅を変えると手法間の比も変わります。 +20%・+30% の測り直しでは較正の優位が大きく縮みました(本文の表)。向きは変わりませんが「何倍得か」は設計しだいで、測ったのは3点だけなのでそのあいだの動きは分かりません
サンプル実装
覗き見の回数ごとに、3つのやり方の境界値・偽陽性率・検出力をまとめて出します。
"""A/Bテストを途中で何度も見て「有意になったら止める」と偽陽性はどこまで増えるか。

真の差がゼロの環境で、覗き見の回数ごとに「一度でも有意になった割合」を数える。
較正用と評価用で乱数系列を分ける(較正データで採点すると自分の基準を自分で甘く採点する)。
実行: python sample_peek.py (numpy / scipy / pandas だけ。所要 1 分程度)
"""

import numpy as np
import pandas as pd
from scipy.stats import norm

P_BASE = 0.10      # ベースラインの変換率
LIFT = 0.10        # 検出力を測るときの相対リフト(+10%)
N_MAX = 4000       # 片群あたりの最終サンプル数
LOOKS = [1, 2, 5, 10, 20, 50]
N_SIM, N_CALIB = 6000, 4000
ALPHA, SEED, BATCH = 0.05, 20260807, 500

# 覗き見のタイミング(等間隔)と、全タイミングの通し位置
look_idx = {k: np.unique(np.linspace(N_MAX / k, N_MAX, k).astype(int)) for k in LOOKS}
all_idx = np.unique(np.concatenate(list(look_idx.values())))
pos = {n: i for i, n in enumerate(all_idx)}


def z_trajectory(pa, pb, nsim, rng):
    """各覗き見時点での2標本比率のz統計量。形状 (nsim, len(all_idx))。"""
    out = np.empty((nsim, len(all_idx)))
    done = 0
    while done < nsim:
        b = min(BATCH, nsim - done)
        ca = np.cumsum(rng.binomial(1, pa, size=(b, N_MAX)), axis=1)[:, all_idx - 1]
        cc = np.cumsum(rng.binomial(1, pb, size=(b, N_MAX)), axis=1)[:, all_idx - 1]
        n = all_idx.astype(float)
        pool = (ca + cc) / (2 * n)
        se = np.sqrt(np.maximum(pool * (1 - pool) * (2.0 / n), 1e-12))
        out[done : done + b] = (ca / n - cc / n) / se
        done += b
    return out


def crossed(z, k, crit):
    """覗き見 k 回で、一度でも境界を超えたか。"""
    return (np.abs(z[:, [pos[n] for n in look_idx[k]]]) > crit).any(axis=1)


# 較正・評価・検出力で乱数系列を分ける
z_cal = z_trajectory(P_BASE, P_BASE, N_CALIB, np.random.default_rng(SEED))
z_eval = z_trajectory(P_BASE, P_BASE, N_SIM, np.random.default_rng(SEED + 1))
z_pow = z_trajectory(P_BASE, P_BASE * (1 + LIFT), N_SIM, np.random.default_rng(SEED + 2))

rows = []
for k in LOOKS:
    n_looks = len(look_idx[k])
    # 較正: 帰無データでの「最大 |z|」の 95 パーセンタイルを境界にする
    mx = np.abs(z_cal[:, [pos[n] for n in look_idx[k]]]).max(axis=1)
    crits = {
        "naive": float(norm.ppf(1 - ALPHA / 2)),
        "bonferroni": float(norm.ppf(1 - (ALPHA / n_looks) / 2)),
        "pocock(較正済み)": float(np.quantile(mx, 1 - ALPHA)),
    }
    for name, crit in crits.items():
        rows.append(
            {
                "覗き見": n_looks,
                "手法": name,
                "境界値": crit,
                "偽陽性率": crossed(z_eval, k, crit).mean(),
                "検出力": crossed(z_pow, k, crit).mean(),
            }
        )

print(f"片群{N_MAX}件 / 変換率{P_BASE} / 評価{N_SIM}回 / 名目の偽陽性率 {ALPHA}")
print(pd.DataFrame(rows).round(4).to_string(index=False))
z_cal と z_eval を別の種で作っているところは変えないでください。 同じデータで境界を決めて同じデータで採点すると、較正した境界の偽陽性率がちょうど 5% に見えるのは当たり前になり、何も確かめたことになりません。
本文の表は検証環境(Intel Xeon / Linux)での実測で、以下の実行結果は別のマシン(Apple M1 / macOS / Python 3.11.15)で回したものです。環境を変えても同じ値になるかを確かめる意味があります。
実行結果
片群4000件 / 変換率0.1 / 評価6000回 / 名目の偽陽性率 0.05
 覗き見           手法    境界値   偽陽性率    検出力
   1        naive 1.9600 0.0505 0.3150
   1   bonferroni 1.9600 0.0505 0.3150
   1 pocock(較正済み) 1.9622 0.0503 0.3145
   2        naive 1.9600 0.0838 0.3590
   2   bonferroni 2.2414 0.0410 0.2525
   2 pocock(較正済み) 2.1596 0.0523 0.2798
   5        naive 1.9600 0.1400 0.4297
   5   bonferroni 2.5758 0.0323 0.1925
   5 pocock(較正済み) 2.4103 0.0478 0.2447
  10        naive 1.9600 0.1895 0.4780
  10   bonferroni 2.8070 0.0248 0.1513
  10 pocock(較正済み) 2.5473 0.0515 0.2302
  20        naive 1.9600 0.2465 0.5270
  20   bonferroni 3.0233 0.0200 0.1127
  20 pocock(較正済み) 2.6892 0.0487 0.2080
  50        naive 1.9600 0.3167 0.5828
  50   bonferroni 3.2905 0.0113 0.0763
  50 pocock(較正済み) 2.8021 0.0502 0.1943
上の2つの表の全18行と、偽陽性率・検出力が完全に一致します。乱数の種を固定してあるので、手元で実行しても同じ値が出ます。境界値の列は記事の表には載せていませんが、Bonferroni が50回で 3.2905 まで上がるのに対し、較正した境界は 2.8021 で止まっている点が、検出力の差の出どころです。
まとめ
途中で覗くと誤判定がどこまで増えるかは、覗いた回数と境界の決め方で決まりました。回数を減らせない運用なら、境界を自分の設計で較正するのが、名目を守りながら検出力の犠牲を最も小さくできる選び方です。得られる量は自分の設計の検出力しだいで、余裕のある設計ならどちらを選んでも着地はあまり変わりません。
次に測るなら、実務でよくある「差が開いたときに見る」不規則な覗き見と、いつ見ても妥当な p 値を使う手法との比較です。前者は、見るタイミングが結果に依存するぶん等間隔で測った今回より悪化する可能性が高いと考えていますが、確かめていないので推測です。後者なら較正なしで途中経過を見られるはずで、実務での使い勝手はそちらの方が良いかもしれません。
名目どおりのはずの統計が実際にはずれる話は、同じシリーズのLLM自動評価の平均と信頼区間を測った検証でも扱っています。あちらで区間を壊したのは覗き見ではなく、モデル採点の平均の偏りでした。