
時系列予測を扱った入門書やライブラリのドキュメントで、私が読んだものには「まずナイーブなベースラインと比べなさい」と書かれていました。前の値をそのままコピーする、あるいは1年前の同じ月をコピーする。そういう予測とも言えないような予測に勝てなければ、複雑なモデルを持ち込む意味がないからです。
助言としては正しいのですが、実際にどうなるかを数字で見た記事は、私が日本語で探した範囲では見つかりませんでした。「ARIMAよりナイーブの方が強いことがある」という言い方も見かけますが、どのくらいの割合のデータでそうなるのかまで書いたものには行き当たっていません。
つまり、手元のデータで古典手法を回して、それが本当に割に合っているのかを判断する材料がない状態です。そこで、時系列予測のベンチマークとして広く使われている M4 コンペティションのデータで、実際に数えてみることにしました。
先に結論
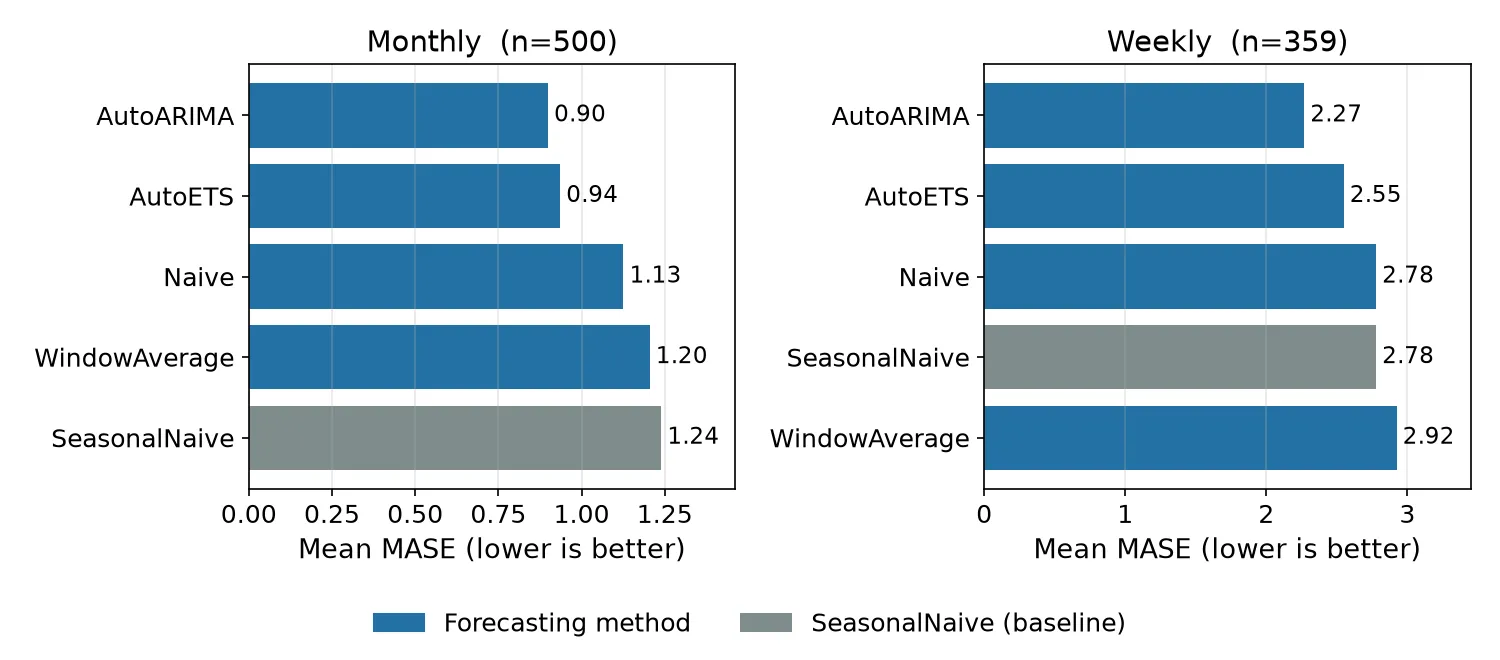
- 既定設定のまま回すと、平均誤差では古典手法が素朴なベースラインに勝つ。月次の平均 MASE(予測の誤差を、学習期間に1周期前をコピーしたときの誤差で割った比。小さいほど良い)は AutoARIMA 0.8988 に対し、1周期前をコピーする季節ナイーブが 1.2391
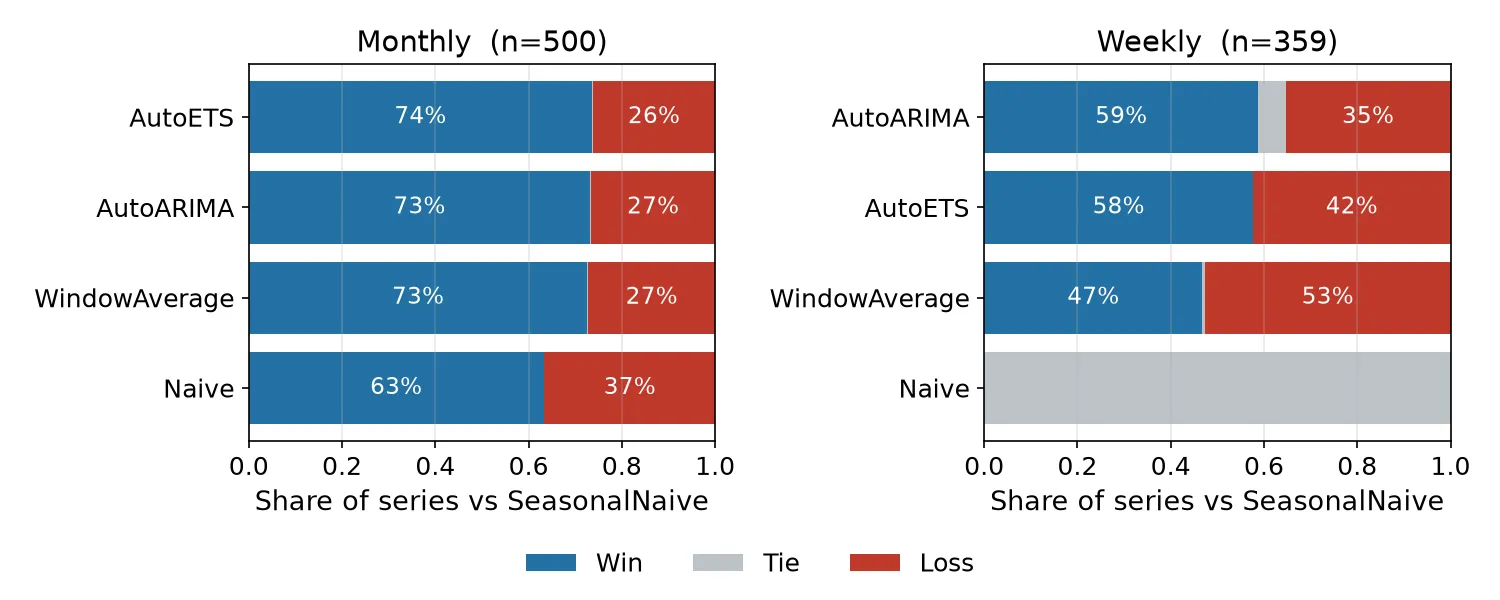
- ただし勝ったのは平均の話。系列を1本ずつ数えると、週次で AutoARIMA が勝てたのは 58.8%。負けが 35.4%、引き分けが 5.9% で、4割の系列では「前の値のコピー」に勝てていない
- 月次で最下位だったのは季節ナイーブ。素の「前の値のコピー」が 63.2% の系列でこれを上回る
- 手法を選ぶ前に、素朴なベースラインと並べて勝率まで数える。平均値だけでは勝てていない4割が見えない
- 適用条件: M4 の週次359系列・月次500系列(1系列=1本の時系列データ)、statsforecast 2.1.1 の既定設定、週次13期先・月次18期先の予測、指標は MASE と sMAPE(誤差を百分率で見る指標)
比べた5手法と、勝ち負けの数え方
この先の表は、5つの手法名と MASE という比の指標で書かれています。どちらも中身を知らないと順位しか読めないので、まず表の語から片づけます。
比較したのは次の5手法です。前の3つが「素朴なベースライン」にあたり、学習らしい学習は何もしていません。
Naive: 直前の値をそのままコピーするSeasonalNaive: 1周期前の値をコピーする(月次なら去年の同じ月)。比較の基準に置いた手法WindowAverage: 直近の値の移動平均AutoETS: 指数平滑。新しい値ほど重く見て過去を平均する系統の手法で、重みの付け方は自動選択AutoARIMA: ARIMA。過去の値と、過去に外した幅から次の値を組み立てる古典的な統計モデル。次数は自動選択
評価指標は MASE を主に使いました。これは誤差そのものではなく比です。予測の平均絶対誤差を、学習期間に季節ナイーブを当てたときの平均絶対誤差で割ります。単位もスケールも違う系列を横断して平均できるのが利点です。あわせて sMAPE(対称平均絶対パーセント誤差。誤差を百分率で見る指標で、小さいほど良い)も記録しました。
平均に加えて測っているのが「勝率」です。系列を1本ずつ見て、その手法の MASE が季節ナイーブの MASE より小さかった割合を指します。平均値は少数の大外れに引きずられるので、平均だけでは「どのくらいの系列で勝っているか」が見えません。この記事の主結果はここから出ています。
M4 の859系列を、既定設定のまま5手法で回した
使ったデータは M4 コンペティションの公開データです。さまざまな業種・分野の実データを匿名化して集めたもので、時系列予測の手法比較では定番のベンチマークになっています。今回は週次の全 359 系列と、月次 48,000 系列から固定シードで抽出した 500 系列、あわせて 859 系列を対象にしました。
手法はチューニングしていません。WindowAverage の窓幅だけを指定し、あとはライブラリの既定のまま回しています。ここで見えるのは、既定設定のまま導入したときにベースラインを上回れるかどうかまでです。
測る前に立てた予想は「古典手法の多くは素朴なベースラインに勝てていないだろう」というものでしたが、これは外れました。 面白いのはその先で、平均が勝っていることと、個々の系列で勝てていることは、まったく別の話でした。
なお予測区間とそのカバレッジは測っていません(点予測の誤差だけを見ています)。予測期間・季節周期・抽出シードといった設定は後半の「詳しい検証条件」に、適用外の条件は「適用範囲と限界」にまとめました。
平均誤差では、AutoARIMA も AutoETS もベースラインに勝った
既定設定で回しただけの AutoARIMA と AutoETS が、素朴なコピーより小さい誤差を出しました。「ARIMA や指数平滑はナイーブに負けている」という筋書きは、少なくともこの2周波数では成り立ちません。検証前の予想を外したのはこの点です。
表を読むときの注意が1つあります。ここでの 1 は合格ラインではありません。MASE は分母が学習期間の1周期前との誤差、分子が予測期間の誤差で、見ている先が違うためです。基準に置いた季節ナイーブ自身の MASE が、月次 1.2391・週次 2.7773 になります。 手法どうしの優劣は、同じ表の中での大小と、右端の勝率の列で読んでください。
| 手法(月次500系列) | 平均MASE | 中央値MASE | 平均sMAPE | 季節ナイーブへの勝率 |
|---|---|---|---|---|
| AutoARIMA | 0.8988 | 0.7399 | 13.0653 | 0.7320 |
| AutoETS | 0.9353 | 0.7498 | 13.4622 | 0.7360 |
| Naive | 1.1256 | 0.8672 | 14.2217 | 0.6320 |
| WindowAverage | 1.2045 | 0.9338 | 14.6810 | 0.7260 |
| SeasonalNaive | 1.2391 | 1.0234 | 16.0294 | (基準) |
週次の全 359 系列では、上位2手法が AutoARIMA・AutoETS の順に並ぶところまでは同じでしたが、ベースライン側の順位は入れ替わりました。
| 手法(週次359系列) | 平均MASE | 中央値MASE | 平均sMAPE | 季節ナイーブへの勝率 |
|---|---|---|---|---|
| AutoARIMA | 2.2678 | 1.6409 | 8.4311 | 0.5877 |
| AutoETS | 2.5479 | 1.7395 | 8.7061 | 0.5766 |
| Naive | 2.7773 | 1.9384 | 9.1613 | (基準と同一) |
| SeasonalNaive | 2.7773 | 1.9384 | 9.1613 | (基準) |
| WindowAverage | 2.9229 | 1.9794 | 9.8251 | 0.4680 |
週次の MASE は全手法が 2 を超えていますが、これを「週次データが難しい」とも「ベースラインより悪い」とも読めません。分母も予測期間も違う週次と月次のあいだで、MASE の水準を比べることもできません。実際、上の2つの表の平均 sMAPE は週次が 8.4311〜9.8251、月次が 13.0653〜16.0294 で、大小が逆になっています。
平均で勝っていても、週次では4割の系列で勝てていない
同じ表の右端の列が、この記事でいちばん伝えたい数字です。週次で AutoARIMA が季節ナイーブに勝ったのは 58.8% の系列にとどまります。 裏を返すと、残り4割強では「前の値をそのままコピーする」方に勝てていません。内訳は負けが 35.4%、引き分けが 5.9% です(勝率は MASE が厳密に小さい割合なので、引き分けは勝ちに数えていません)。月次でも勝率 73.2% で、4系列に1本は勝てていません。
平均 MASE では季節ナイーブより2割近く良いのに、系列単位では6割弱しか勝てない。つまり、平均の差の大きさからは、勝てる系列の割合を読めないということです。勝ったときと負けたときで差の大きさがどう違うかは今回集計していないので、負けた3割強でどれだけ悪くなるかは、この結果からは分かりません。
この記事で使った M4 の週次は 359 系列ありますが、そのうち 127 系列では AutoARIMA が季節ナイーブに負けています。手法の平均スコアだけを見て「この手法が優れている」と結論すると、勝てていない4割が見えなくなります。 自分のデータが偶然その負けた側に入っていれば、手間をかけて導入した予測は素朴なコピーより悪いまま動き続けます。系列ごとの勝敗は、平均と並べて出しておくのが安全です。
月次でいちばん弱いベースラインは、季節ナイーブだった
月次の表をもう一度見ると、平均 MASE が最も悪いのは季節ナイーブの 1.2391 で、素の Naive(1.1256)より下です。系列単位では、単純に前の値をコピーする方が去年の同じ月をコピーするより 63.2% の系列で良い予測でした。
これは月次データを扱うときの既定の感覚と逆です。月次なら季節性があるはずだから季節ナイーブを基準に置こう、という判断はごく自然ですが、少なくとも M4 の月次系列ではそれが最も弱いベースラインになっていました。1年前の値は、直近の値より単純に古いぶん、系列の水準が動いていれば外れます。季節変動の大きさより水準の移動の方が効く系列で季節ナイーブが不利になっているのだろうと見ています。系列ごとに水準の移動と季節変動の大きさを分けて測ってはいません。
比較の基準をどれにするかで、手法の見え方は変わります。もし季節ナイーブだけを基準に置いていたら、どの手法も立派に勝っているように見えたはずです。ベースラインは1本ではなく、素のナイーブと季節ナイーブの両方を並べておくべきでした。
移動平均は月次で健闘し、週次では最下位だった
WindowAverage は月次では季節ナイーブへの勝率 72.6% と健闘しますが、週次では 46.8% と基準を下回り、平均 MASE も 2.9229 で全手法中の最下位でした。
月次の勝率だけを見ると 72.6% で、AutoARIMA の 73.2%・AutoETS の 73.6% とほとんど並びます。ところが平均 MASE は 1.2045 で、上位2手法の 0.9 前後とは大きく離れています。勝率が並んでいるのに平均が離れるのは、負けた系列で大きく外しているか、少数の系列が平均を押し上げているかのどちらかです。系列ごとの差の大きさは集計していないので、この2列からはどちらとも決められません。確かなのは、勝率だけで決めると移動平均で十分に見えてしまうということです。
ただしこの比較は、周波数と窓幅が同時に変わっています。 窓幅は季節周期に合わせており、月次は 12、週次は 4 です(週次の季節周期は M4 公式設定で 1 なので、そのままでは移動平均にならず 4 を当てました)。つまり「週次だから悪い」のか「窓幅4だから悪い」のかを、この実験は分けていません。週次で窓幅を変えて測っていないので、移動平均という手法そのものが週次に向かないとは言えません。ここで言えるのは、既定に近い設定で回したときにこの結果になった、というところまでです。
AutoARIMA と AutoETS の優劣は決められなかった
月次の平均 MASE では AutoARIMA がわずかに良く、AutoETS は 0.9353 でこれに続きます。ところが勝率はむしろ AutoETS の方が高くなっています(0.7360 対 0.7320)。ただし週次と月次それぞれで4指標を見た8つの測定値のうち、順位が入れ替わったのはこの月次の勝率だけです。残る7つ、つまり週次の4指標すべてと、月次の平均 MASE・中央値 MASE・平均 sMAPE では AutoARIMA が上でした。しかも月次の勝率の差は、500 系列のうち2本ぶんにあたります。
後述するサンプル実装を手元の Mac で回したときも、AutoARIMA だけ平均 MASE が 2.2678 から 2.2736 へ、勝率が 0.5877 から 0.5822 へわずかに動きました。他の4手法は同じ値を再現しているので、AutoARIMA の次数探索が環境によって別のモデルを選んだのだろうと見ています。ただし選ばれた次数を保存していないので、確かめられていません。
月次で勝率が入れ替わった差は、この揺れよりも小さい。一方で平均 MASE の差は、月次でも週次でも揺れよりずっと大きい値です。2手法の差がまるごと環境の揺れだとは言えませんが、どちらが上かを確定できるだけの材料も、この実験にはありませんでした。
実務での判断: 手法の順位より先に、自分のデータの勝率を出す
迷ったら: AutoARIMA と AutoETS のどちらから始めても構いません。前の節のとおり、この実験では優劣を決められませんでした。手法の順位を突き詰めるより、後述のコードで自分のデータの勝率を出す方が判断材料になります。なお実行時間を手法ごとに分けて測っていないので、この結果からは速度で選べません。別に試した時間単位の設定では5手法をまとめた実行が完了せず打ち切っているので(「詳しい検証条件」の折りたたみ参照)、季節周期や予測期間が長いデータでは計算コストも選択の材料になりえます。
予測する系列が数十本しかないなら、勝率より勝敗の本数: 平均値は当てになりません。勝ち負けの本数を直接数えて、負けた系列を個別に見てください。今回の週次のように負けが3割半ばの状況なら、系列が20本で7本前後が該当します。
季節性があるデータでも、基準は素のナイーブと季節ナイーブの2本: 月次の実測では、季節ナイーブが素のナイーブに6割超の系列で負けていました。ベースラインが弱いと、導入した手法の効果を過大評価します。
週次の移動平均で先に疑うのは、窓幅: 今回の週次は窓幅4の1通りだけで、勝率も平均 MASE も最下位でした。窓幅を変えれば結果が変わる可能性が残っているので、1つの窓幅の結果だけで移動平均を捨てないでください。
詳しい検証条件
MASE の式では、季節ナイーブが二役を持ちます。分母になるのは、学習期間の中で1周期前と比べたときの誤差です。勝率で対戦相手になるのは、予測期間の先まで出した季節ナイーブの予測の方。月次なら分母が12期ぶんのラグ誤差で分子は18期先までの予測誤差、週次は季節周期が1(季節性なしとして扱う設定)なので分母が1期ぶんで分子が13期先です。分子の方が先を見ているぶん、季節ナイーブ自身の MASE が 1 になりません。
なお分母は系列ごとに全手法で共通です。そのため勝率は分母の取り方に左右されません(同じ系列内での誤差の大小そのものです)。
予測期間と季節周期は M4 公式の設定に合わせ、週次は 13 期先・季節周期 1、月次は 18 期先・季節周期 12 としました。このため週次では SeasonalNaive が Naive と同じ計算になり、結果も完全に同じ値になります。WindowAverage の窓幅だけは既定がないため指定しました(月次12・週次4)。
数値はすべて、実際に実行して保存したログを集計したものです。月次の抽出シードは 42 で固定し、予測にかかった時間は週次 100.9 秒・月次 495.8 秒でした。
読み飛ばし可: データの日付の扱いと、取りやめた条件
M4 の系列は匿名化されており、公開されている実日付をそのまま信頼できません。そのため正しい観測間隔をもつ日付を合成して割り当てています。季節性の推定に効くのは観測の間隔であって暦上の日付そのものではないため、この置き換えは結果を歪めません。
時間単位(Hourly)のデータは実行時間の都合で取りやめました。季節周期 24・予測期間 48 期先の設定では、5手法をまとめた実行が全 414 系列で 25 分以上、150 系列に減らしても 16 分以上かかって完了しませんでした(打ち切った時点までの経過時間で、完了までの所要ではありません)。手法別に時間を測ってはいないので、どの手法が重かったのかはこの実験からは分かりません。打ち切った以上「時間単位では測っていない」という限定つきの結果として扱います。
適用範囲と限界
- 適用範囲は M4 の週次と月次です。 時間単位・年次・四半期・日次では測っていません。とくに時間単位は実行時間の都合で取りやめており、季節周期が長いデータでの挙動は分かりません
- 月次は 48,000 系列から 500 系列を抽出した結果です。全数ではないため、勝率の値には抽出による揺れが含まれます
- Prophet は含めていません。「Prophet はナイーブに負ける」という言い方を見かけますが、この実験はそれについて何も言えません
WindowAverageの窓幅を除き、各手法は既定設定のみです。チューニングすれば古典手法側がさらに伸びる余地があり、勝率の水準はその意味で下限に近い可能性がありますWindowAverageの窓幅は周波数ごとに1通りずつです(月次12・週次4)。月次と週次の差は、周波数の違いと窓幅の違いが混ざっており、分離していません- AutoARIMA と AutoETS の優劣は決めていません。差は 500 系列中2本ぶんで、環境による揺れと分離できていません
- 勝てる系列と勝てない系列の違いは分析していません。「どういう系列なら手法を導入する価値があるか」は今回の結果からは判断できず、勝率までしか出せていません
サンプル実装
M4 の週次データを取得して、5手法の平均 MASE と季節ナイーブへの勝率を出すところまでを1本にまとめました。データは自動で取得されます。手元の環境では、取得を終えたあとの計算が 37.3 秒でした(取得にかかる時間は測っていません)。
月次で試すときは4箇所を変えます。
load()のWeeklyをMonthlyにH, M = 13, 1を18, 12にWindowAverage(window_size=4)をwindow_size=12にfreq="W"の2箇所(pd.date_rangeとStatsForecast)を"MS"に
ただし月次は 48,000 系列あるので、このコードのまま回すと本記事の測定(固定シードで 500 系列を抽出)とは規模が2桁違います。所要時間は測っていません。
"""M4 Weekly で古典手法が素朴ベースラインに勝てているかを測る。

平均誤差だけでなく「系列ごとにどちらが勝ったか」の勝率まで出す。
実行: python sample_ts.py (M4 Weekly を自動取得)
"""

import csv
import urllib.request
from pathlib import Path

import numpy as np
import pandas as pd
from statsforecast import StatsForecast
from statsforecast.models import (
    AutoARIMA,
    AutoETS,
    Naive,
    SeasonalNaive,
    WindowAverage,
)

BASE = "https://raw.githubusercontent.com/Mcompetitions/M4-methods/master/Dataset"
H, M = 13, 1  # M4 公式の Weekly 予測期間と季節周期


def load(kind):
    """M4 の Train/Test CSV を取得して {系列ID: 値の配列} で返す。"""
    path = Path(f"Weekly-{kind}.csv")
    if not path.exists():
        urllib.request.urlretrieve(f"{BASE}/{kind.capitalize()}/{path.name}", path)
    out = {}
    with path.open(newline="") as f:
        reader = csv.reader(f)
        next(reader)  # ヘッダを捨てる
        for row in reader:
            out[row[0]] = np.array([float(v) for v in row[1:] if v != ""])
    return out


def main():
    train, test = load("train"), load("test")

    # M4 の系列は匿名化されており実日付は使えないので、
    # 正しい観測間隔をもつ日付を合成する(間隔だけが季節性に効く)
    long_df = pd.concat(
        [
            pd.DataFrame(
                {
                    "unique_id": sid,
                    "ds": pd.date_range("2000-01-02", periods=len(y), freq="W"),
                    "y": y,
                }
            )
            for sid, y in train.items()
        ],
        ignore_index=True,
    )

    models = [
        Naive(),
        SeasonalNaive(season_length=M),
        WindowAverage(window_size=4),
        AutoETS(season_length=M),
        AutoARIMA(season_length=M),
    ]
    fcst = StatsForecast(models=models, freq="W", n_jobs=-1).forecast(df=long_df, h=H)
    model_cols = [c for c in fcst.columns if c not in ("unique_id", "ds")]

    rows = []
    for sid, ytr in train.items():
        yte = test[sid][:H]
        # MASE の分母: 学習系列に対する季節ナイーブの平均絶対誤差
        scale = np.mean(np.abs(ytr[M:] - ytr[:-M]))
        sub = fcst[fcst["unique_id"] == sid].sort_values("ds")
        for col in model_cols:
            pred = sub[col].to_numpy(dtype=float)
            rows.append(
                {
                    "unique_id": sid,
                    "model": col,
                    "mase": np.mean(np.abs(yte - pred)) / scale,
                }
            )

    per = pd.DataFrame(rows)

    # 系列ごとに SeasonalNaive と突き合わせ、勝った割合を出す
    base = per[per.model == "SeasonalNaive"].set_index("unique_id")["mase"]
    per["base"] = per["unique_id"].map(base)

    summary = per.groupby("model").apply(
        lambda g: pd.Series(
            {"平均MASE": g.mase.mean(), "勝率": (g.mase < g.base).mean()}
        ),
        include_groups=False,
    )
    print(f"系列数 {len(train)} / h={H} / m={M}")
    print(summary.sort_values("平均MASE").round(4).to_string())


if __name__ == "__main__":  # n_jobs=-1 の並列実行に必要
    main()
このコードを Apple M1 の Mac(Python 3.11.15・statsforecast 2.1.1)で実行した結果です。
実行結果
系列数 359 / h=13 / m=1
               平均MASE      勝率
model
AutoARIMA      2.2736  0.5822
AutoETS        2.5479  0.5766
Naive          2.7773  0.0000
SeasonalNaive  2.7773  0.0000
WindowAverage  2.9229  0.4680
このコードが出す平均 MASE と勝率について言うと、AutoETS・Naive・SeasonalNaive・WindowAverage の4手法は上の週次の表と同じ値になります。AutoARIMA だけ 2.2678 から 2.2736 へずれました。理由の見立ては「AutoARIMA と AutoETS の優劣」の節に書いたとおり、次数の自動探索が環境で揺れたのだろうというものです。なお Naive と SeasonalNaive の勝率が 0 と出るのは、自分自身との比較になり、引き分けを勝ちに数えないためです。上の表の「基準と同一」と同じ状態を指しています。
まとめ
ARIMA や指数平滑は、「前の値をコピーするだけ」の予測に勝てていました。平均誤差で見るかぎり、自動選択つきの手法を既定設定で回すだけでベースラインを上回ります。
数字として大きいのはその先です。平均で2割近く勝っている AutoARIMA でも、週次で勝てた系列は6割弱にとどまります。平均値と勝率は同じ実験の同じデータから出るのに、読み取れる話がここまで違います。そしてもう一つ、月次でいちばん弱いベースラインが季節ナイーブだったこと。基準の置き方ひとつで手法の評価が変わるという、比較の設計そのものに関わる話です。同じ時系列を扱った変化点検知でrupturesの3手法とペナルティを比べた検証でも、結果を大きく動かしたのは手法の選択よりペナルティという設定でした。手法名を比べる前に確かめることがある、という点で地続きの結果です。
手元のデータでまずやることは、手法を1つ足すより、素のナイーブと季節ナイーブを並べて勝率を数えるところです。上のコードで勝率まで出しても、増えるのは数行。次に測るなら、勝てなかった4割の系列がどういう性質を持っているかを層別してみたいところです。そこが分かれば、手法を導入する前に「自分のデータは勝てる側か」を見積もれるようになります。
確信をもって言えるのは、M4 の週次と月次について、既定設定の範囲まで。時間単位は5手法をまとめた実行が完了せず打ち切っており、Prophet も入れていません。平均スコアの裏で何割勝てていないかは、それぞれのデータで数えてみるまで分かりません。