
明日のパンは、何個焼けばいいだろう。先週はよく売れた。でも明日は雨の予報で、近くでは催しがある。予約も少し入っている。
過去の売上の線を、そのまま一日先へ伸ばすだけでは心もとない。明日の予定を知っているなら、その情報も使って見通しを立てたい。
こういう悩みを思い浮かべながら読むと、Mistralが2026年10月15日に発表したTimestralがぐっと身近になる。時間順に並んだ数値を扱う、時系列の基盤モデルだ。
気になるのは、予測に幅を持たせ、あらかじめ分かる予定も材料にできることだ。明日のパンを何個用意するか。その判断に、どう使えるだろう。
予測が一つの数字で終わらない
公式リポジトリによれば、Timestralは各時点について21の分位点を出力する。分位点とは、予測される値を低い側から見たときの区切りだ。中央付近だけでなく、少なめ、多めに振れた側まで見る手掛かりになる。
パン屋の話は、ここから先も筆者が考えた仮想例だ。売れ残りを減らしたい日と、予約客に確実に渡したい日では、同じ需要予測を見ても準備のしかたは違うだろう。中央値を一つ受け取るより、需要が上振れする可能性まで見えるほうが、考える材料は増える。
もちろん、線が何本も出れば正確になるわけではない。たとえば下側と上側の分位点で作った区間が、実際の売上をどの程度含んだかは、過去のデータで確かめる必要がある。広すぎて何も決められない予測も、狭すぎて何度も外れる予測も困る。
この確かめ方は、LightGBMの予測区間で、値を含む割合と区間幅を測った記事にまとめている。Timestralの性能を測ったものではないが、予測の幅を評価するときの参考になる。
予測の幅を見ながら、「多めに仕込む分は冷凍できるか」「追加で焼く時間を残せるか」と考える。予測が出たあとに、こうした準備を選べるかが気になる。
明日の予定を、今日の予測へ
Timestralは、予測対象と一緒に動く補助的なデータも使える。公式リポジトリには、過去の値だけが分かる補助変数と、予測する期間まで値を用意できる補助変数を分けて渡す仕組みがある。
たとえば、曜日や営業予定は先の分まで分かる。予約数は、予測を作る時点で届いている分なら使える。天気も材料にするなら、その時点で入手できた予報を渡す。実際に降った雨の量を後から混ぜると、当時は知らなかった未来を使って採点してしまう。
ここが、現場で予測を使う面白さであり、手間でもある。「何が分かっているか」は日々変わる。前日の夜に立てる仕込み計画と、当日の朝に追加分を決める判断では、使える情報も違う。同じモデルでも、問いを置く時刻が変わる。
Mistralは、既知の将来情報を参照しつつ、予測対象の未来の値は見ないようにモデル内部を設計したと説明している。ただ、その設計だけで入力データの作り間違いまで防げるわけではない。予測の時点に戻って材料をそろえる作業が、使う側にも必要だ。
CPUで動かせるなら、予測を置く場所も変わる
Timestralには500万、2,800万、1億2,300万、2億900万パラメータの4サイズがある。公式実装はCPUとGPUでの実行に対応している。大型の生成AIを常時呼び出す姿だけを思い浮かべていると、この小ささは新鮮だ。
サイズを選べると、予測を置く場所の想像も変わる。店ごと、商品ごと、時間帯ごとに繰り返し計算する。新しい予約が入ったら、もう一度見直す。CPU対応という性質は、そんな地道な繰り返しと相性がよさそうだ。ただし、手元の環境での速度や費用は、今回確認していない。
Mistralは、最大モデルがGIFT-Eval、TIME、fev-benchで、事前学習済み・ゼロショットモデルの比較において首位だったと報告している。ここでのゼロショットは、対象データで追加学習せずに予測することを指す。未知の系列へ、まず予測を返せる出発点があるのはうれしい。
一方で、発表時点では詳細な技術報告は今後公開予定とされている。公開ベンチマークの好成績を、そのまま個々の店の売上へ移すことはできない。祝日、欠品、改装、メニュー変更。目の前の系列には、その場所ならではの事情がある。
「売れた数」と「欲しかった数」の間
パン屋の例でもう一つ考えたいのが、売上の意味だ。夕方までに完売した日は、売れた数より多くの人が買いたかったかもしれない。数字の上では売上が横ばいでも、棚が空だった時間には記録されない需要がある。
そのまま売上だけを学ばせれば、少なく焼いた日の数字が次の仕込みを抑える材料になるかもしれない。これはTimestralで確認した現象ではなく、予測の使い方についての注意点だ。欠品した時刻や営業時間も一緒に残しておくと、後から予測を読み解きやすくなる。
最初に試すなら、当時の情報だけで過去の一日を予測し直し、「先週の同じ曜日と同じ数」という簡単な方法とも比べたい。ARIMA・指数平滑をナイーブ予測と比べた検証では、平均で勝っていても、系列ごとに見ると負ける例が残った。Timestralを試すときも平均的な誤差に加え、忙しい日に足りなかったのか、静かな日に余らせたのかまで見る。準備に役立つ違いがあったかを知るためだ。
利用時には配布物の区別も確認したい。公式リポジトリのコードはApache 2.0、モデル重みは別のModified MITライセンスで公開されている。詳しい条件は、それぞれの配布元で確認できる。
何個売れるか、から何個用意するかへ
Timestralは数値を予測するモデルなので、売上の列を渡すだけで「明日は催しがあるから増えます」と根拠のある物語まで説明してくれるものではない。数値の予測と、予定や現場の事情を読み解く仕事をどうつなぐかが、これからの工夫になる。
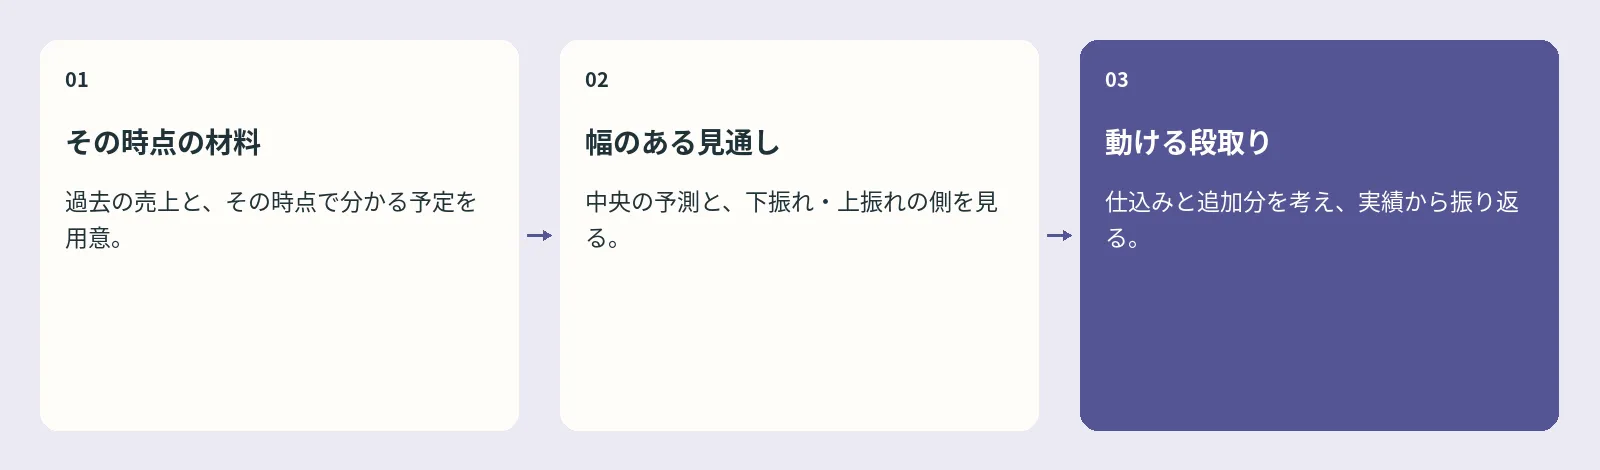
明日は何個売れるか。その問いに続けて、何個なら今夜仕込み、何個なら朝に追加し、どこからは予約で受けるか。予測の幅を、動ける段取りへ変えていく。
予測が高精度でも、前夜の仕込みを決める頃に必要な情報がそろわなければ使いづらい。Timestralを試すなら、予測を出す時刻と、そのあと変更できる段取りをセットで考えたい。
公開資料をもとにした紹介・考察です。パン屋の例は筆者による仮想の活用案で、導入事例や実機検証ではありません。仕様・提供状況は2026年10月17日確認時点。